Databricks RADAR:用异常检测捕获灰色故障
DataHot 速览
Databricks 介绍其系统 RADAR,利用异常检测捕获“灰色故障”。这类故障表面健康检查正常,但部分客户静默失败,导致用户和收入流失。文章以一次 checkout 流程 bug 为例,从 9:30 到 16:00 近七小时才修复,期间每 20 个信用卡支付客户有 1 个失败。内容面向 SRE、平台与数据工程师、on-call 人员,说明如何为关键指标构建异常检测。
为什么值得关注:Databricks 第一方可靠性工程实践,展示如何用异常检测发现监控盲区,对数据平台和 SRE 团队构建生产监控有参考价值。
本文目录 9 节
译文
AI 逐段翻译一些最具破坏性的故障,恰恰是你的监控永远不会标记出来的那些:一部分客户悄无声息地失败,而所有健康检查仍然显示正常。这些“灰色故障”会在任何人把事情联系起来之前,持续数小时地流失用户和收入。本文讲的是如何通过异常检测尽早发现它们——我们在 Databricks 如何用一个名为 RADAR 的系统做到这一点,以及你如何为对你业务最重要的任何指标构建同样的东西。本文面向负责服务可靠性的人:SRE、平台和数据工程师、待命响应人员,以及他们所汇报的工程负责人。
当一切显示绿色,实际上却一切都不好
想象一个普通的周三。保障一个面向客户的服务可靠是你的工作,而你墙上的每一块仪表盘都是绿色的——CPU 健康、延迟正常、服务器在线、数据库已连接。按照你团队关注的每一个信号,系统看起来完美无缺。
但并非如此。
- 9:30——一次例行部署在你的结账流程中埋入了一个微妙的 bug。
- 9:35——每二十个用信用卡支付的客户中就有一个悄无声息地失败。在几次重试之后,他们放弃并离开。
- 12:40——第一张支持工单到来。它看起来只是又一个输错卡号的情况,所以没人多看一眼。
- 14:20——又有两张关于同一问题的工单到达。
- 14:25——你的支持主管发现了这个模式并上报。
- 16:00——工程师定位到这个 bug 并发布了修复。
在将近七个小时里,你的监控一直坚称一切正常,而客户在流失,收入在泄漏。
什么是灰色故障?
那个周三就是一个教科书式的灰色故障。表面上一切看起来都很健康;但在底下,某个特定的部分已经悄无声息地停止工作——它在伤害客户,却从未触发任何告警。
有两件事让灰色故障如此隐蔽:
- 它们是局部的。不是所有人,只是一个切片,比如某一种信用卡。没有服务器崩溃能让你立刻发现,只有一个混乱的中间地带:大多数用户没事,而某一群人一直在失败。
- 它们会扩大。最初只是少数受影响客户,随后蔓延开来。如果放任不管,越来越多的人会撞上同一堵墙。
把它想象成墙后的烟雾。从外面看,房子看起来没问题,但里面损害正在蔓延——你等得越久,爆炸半径就越大。研究人员也为这个底层问题起了个名字:微软的《灰色故障:云规模系统的阿喀琉斯之踵》将其称为差异化可观测性——即使你的用户明显察觉到了问题,你的故障检测器却注意不到。
为什么等待客户报告会失败
大多数团队处理灰色故障的方式,正是那个周三所上演的:他们等待客户来告诉他们。客户报告很重要——那是真实的人类痛苦——但你的客户不应该成为你的监控系统。仅仅依赖报告有三个问题:
- 它是手动的。必须有人在一堆工单中注意到相同的投诉。这很容易被漏掉。
- 它是延迟的。等到足够多的人抱怨、有人能把事情联系起来时,几个小时或几天已经过去了。
- 它是无声的。大多数受影响的客户根本不会提交工单。他们直接离开。
解决办法不是停止阅读工单——继续这样做。而是要增加始终运行的自动检测,捕捉人们漏掉的东西。具体来说,你需要某种东西,在远多于平常的客户开始同时遇到同一问题时立即触发。
| 仅靠客户报告 | 增加自动检测 |
|---|---|
| 手动——容易漏掉 | 捕捉人们漏掉的东西 |
| 延迟——几天后才注意到 | 快速——实时注意到 |
| 客户默默承受痛苦 | 标记尖峰——许多用户同时出现 |
认识 RADAR
这就是RADAR背后的理念——可靠性异常检测、告警和根因分析。我们在 Databricks 构建了它,以便在几分钟内而非几小时内捕捉灰色故障。这个名字很贴切:当能见度很低时,你不要等到什么东西撞上你——你要尽早扫描微弱信号。
下面是我们如何将它对准一个特别有用的信号:用户错误。
灰色故障常常表现为看起来像是用户过错的错误突然激增。想象一下,某个区域的一群用户突然无法启动某种类型的集群。每个请求都以 INVALID_ARGUMENT 失败——这个错误礼貌地在说:“这是你自己的问题。”
但当许多用户在同一时刻遇到同一个“你的过错”错误时,它就不再是他们的过错了。它是我们的。这种激增正是 RADAR 旨在捕捉的模式。
RADAR 的四个阶段
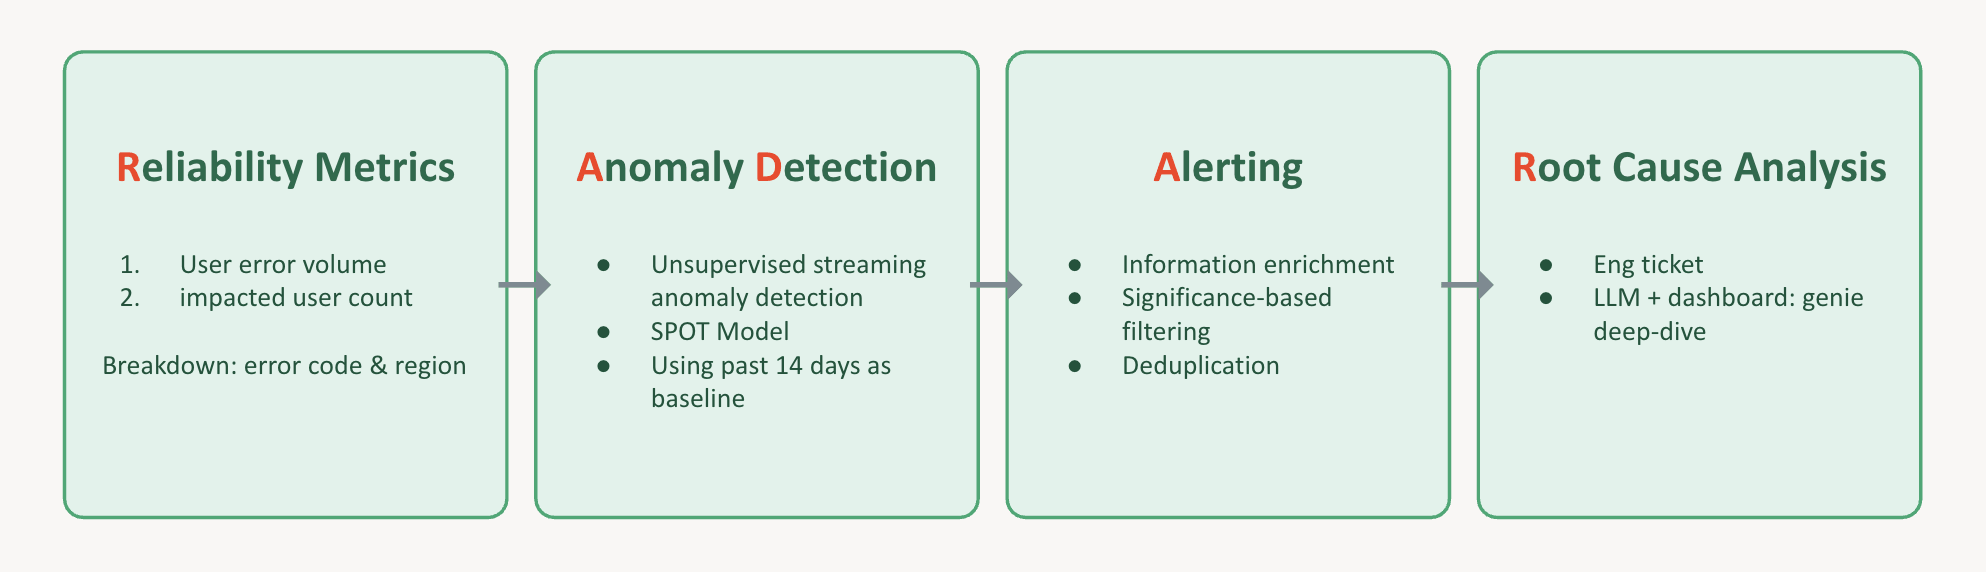
RADAR 将这种直觉转化为一个包含四个阶段的流水线:
- 可靠性指标。在每个时间点,记录两件事:正在发生多少错误,以及有多少不同用户遇到了每一个错误。按错误代码和区域细分。现在你就有了一组丰富的时间序列,描述你服务的健康状况。
- 异常检测。对每一个这些序列运行异常检测,让系统标记任何看起来不对劲的东西——而无需你手动调整一堆阈值。我们使用一个名为 SPOT 的无监督流式模型,它从过去 14 天中学习“正常”是什么样子,并且只需要一个风险参数,而不是手动设定的截止值。(SPOT 来自 Siffer 等人的《用极值理论进行流中的异常检测》,KDD 2017。)
- 告警。当某个东西触发时,告警层接管。它丰富告警的上下文,过滤掉不重要的内容,并去重,这样待命人员就不会被同一件事的副本淹没。然后它提交一张工单,路由到负责该错误的正确工程团队。
- 根因分析。每张工单都附带异常深入分析细节,以及一个由 AI 助手AI/BI Genie支持的仪表盘链接。待命人员可以直接着手弄清到底哪里坏了,尽可能用最少的时间。
我们取得了什么成果
在我们自己身上运行 RADAR 改变了这些事件的样子。以前,我们等待客户工单来发现此类事件,导致数天的延迟。有了 RADAR,我们实现了事件发现时间减少 95%,在精确率超过 90%,无需人工来发现模式。因此,我们能够将灰色故障的影响范围控制在有限范围内。
将 RADAR 指向任何指标
以下是对你最重要的部分:RADAR 不在乎指标是什么。 我们碰巧将它指向用户错误,但同样的模式适用于任何数字可能悄悄出错的地方:
- 金融服务 — 支付和交易失败、计费异常、欺诈信号
- 零售和电子商务 — 结账转化率、购物车错误、配送时间
- 医疗健康和生命科学 — 患者吞吐量、理赔处理
- 任何 AI 产品 — 在模型明显崩溃之前就已显现的模型性能和数据分布漂移
这是不同设置下的同一模式。任何可能存在悄悄出错的地方,RADAR 都适用。
在 Databricks 上自行构建
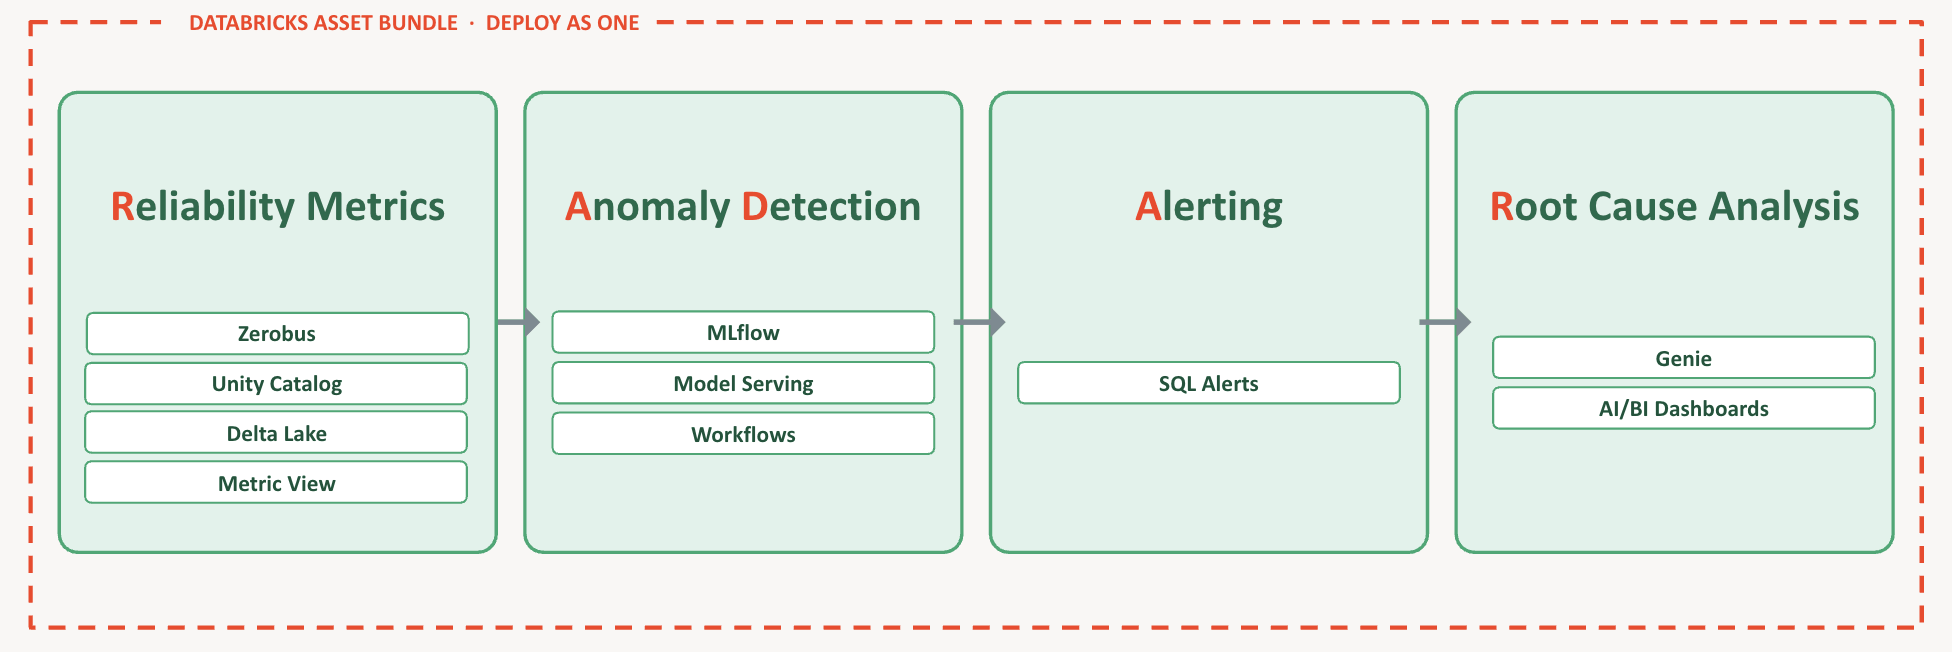
最好的消息是:你需要的每一个组件都已在 Databricks 上。将四个阶段映射到平台,看起来是这样的:
- 可靠性指标 — 用于低延迟摄入的 Zerobus、用于治理的 Unity Catalog 和 Metric View、用于存储的 Delta Lake
- 异常检测 — 用于模型训练的 MLflow、用于交付模型端点的 Model Serving,以及用于编排周期性作业的 Workflows
- 告警 — 用于触发告警的 Databricks SQL Alerts
- 根因分析 — AI/BI Genie 和 AI/BI Dashboards
而且整个系统通过一个 声明式资产包(DAB) 作为单个单元进行部署。
手动将所有这些部分连接在一起是最烦人的部分——所以我们把它去掉了。我们将整个内部 RADAR 系统提炼成一个单一的脚手架:一个像配方一样工作的 markdown 文件,将 RADAR 的每个部分映射到特定的 Databricks 组件(收集和存储 → 一个 Delta 表;检测异常 → 一个作业;告警和去重 → 一个工单;可视化 → 一个仪表板)。
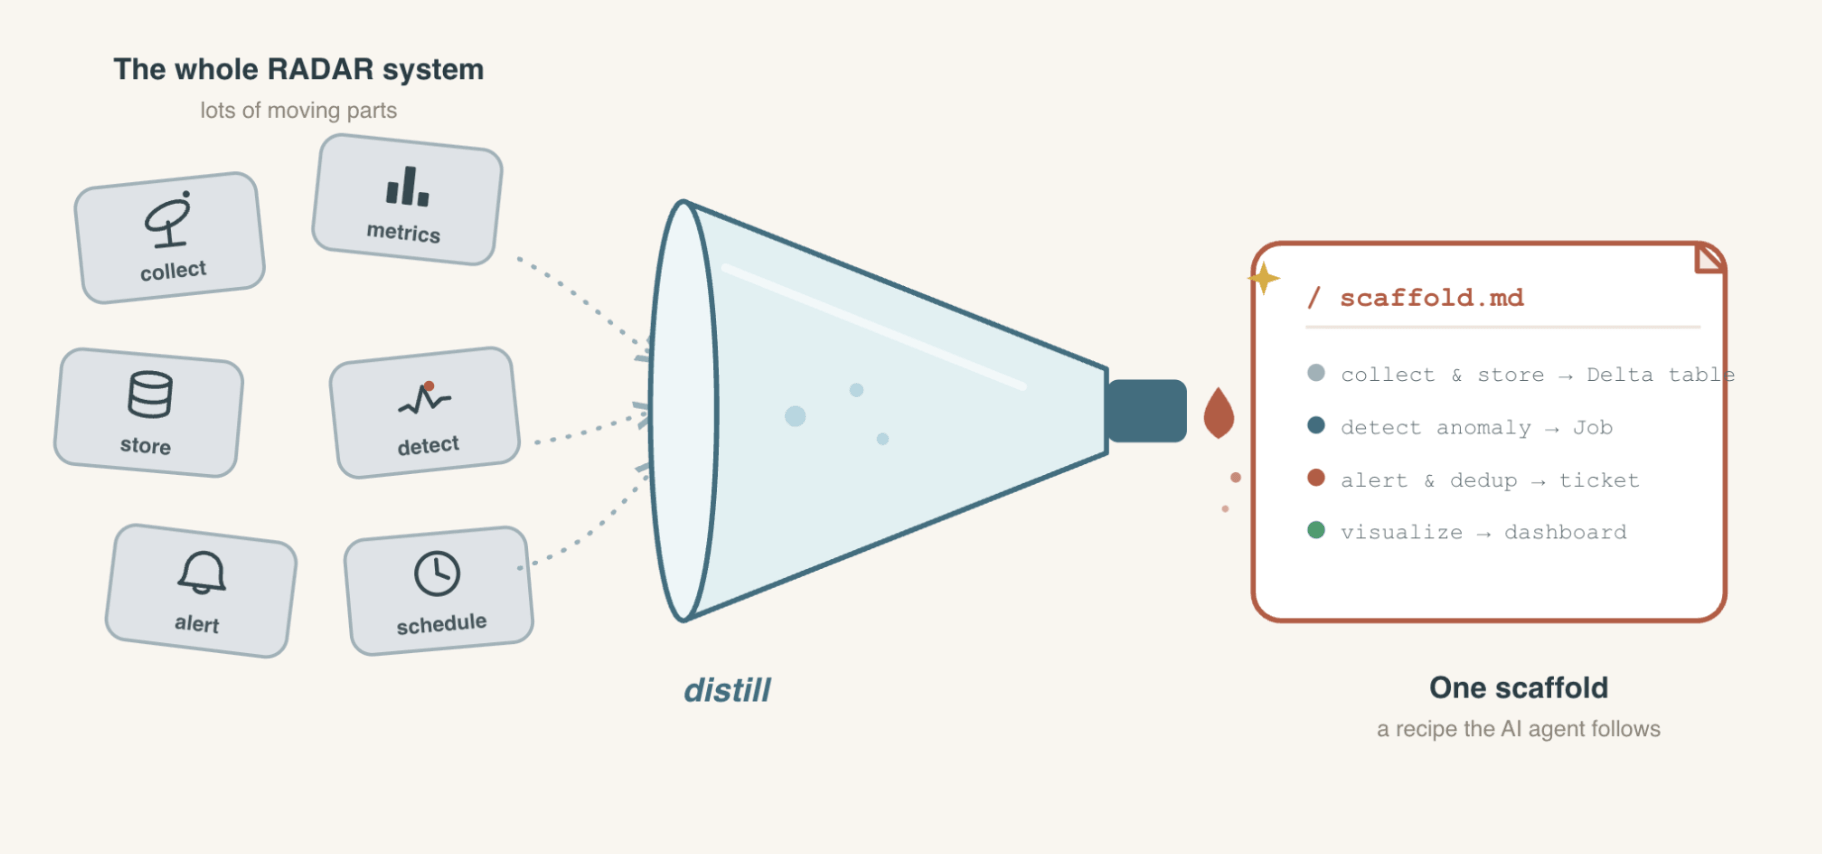
接下来就是回报。你带上自己的指标——无论你的信号在哪里——并将该指标、脚手架和一段简短的提示词交给一个 AI 智能体。它就会在 Databricks 上实时为你构建整个 RADAR 系统。你可以按照 Github 说明 了解如何从一个提示词开始构建。
要点
带走两件事:
- 在灰色故障升级之前将其捕获。 绿色仪表板并不能证明客户一切正常。添加实时异常检测,让局部、静默的故障在几分钟内而非几天内浮现出来。
- 在 Databricks 上为你关心的任何指标构建 RADAR。 脚手架、演示和提示词都是公开的——从它们开始。
因为最好的结果不是更快地响应愤怒的客户——而是你的客户永远不必替你发现你的故障。
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏