DuckDB v2.0递归CTE性能提升42.6倍
DataHot 速览
DuckDB官方博客详解v2.0中递归CTE执行引擎的重构:将可复用执行状态提升到查询计划生命周期,使迭代间复用管道调度、操作符和哈希构建,避免每次迭代重复支付执行开销。在一百万条边的可达性查询中,中位运行时间从v1.5.5的4.051秒降至v2.0预览版的0.095秒,获得42.6倍加速。同时介绍了USING KEY语义变化,以及内联执行与调度执行的选择策略。
为什么值得关注:递归CTE是复杂分析查询中的常见性能瓶颈,DuckDB通过状态生命周期拆分实现数量级加速,对数据平台引擎开发者和高性能分析实践者有直接参考价值。
本文目录 17 节
译文
AI 逐段翻译当我在2020年实现DuckDB的第一个递归CTE算子时,正确性决定了设计:先评估非递归项一次,然后评估递归项直到下一个工作表为空。这确立了正确的语义契约,但可复用的运行时状态范围过窄。在迭代之间,递归输入发生变化,而评估它的大部分机制仍然可以复用。然而,实现将每次迭代几乎当作一个新查询,反复付出流水线调度、算子设置、执行和拆除的代价。从那时起,我一直想消除这种不匹配。
在即将到来的DuckDB v2.0中,我们明确分配了这些作用域。查询计划拥有物理算子树、预计算的流水线调度以及可复用的流水线执行器池。每次递归调用从该池中借用执行器,并拥有累积的递归状态和保留的物化结果,其生命周期跨越整个不动点计算,而每次迭代只拥有依赖于前端的(frontier-dependent)状态。这种分离实现了保留的哈希构建、每次迭代在内联执行和调度执行之间的选择,以及对键控状态的直接探测。物理执行的改变伴随着一个语义变化:对于USING KEY,UNION现在使新键和最终载荷已更改的键对下一次迭代可见。
为了说明性能影响,我们在一个小型可达性查询上比较原始引擎和新引擎。该表包含100,000个节点上的一百万条边。每个源节点有十条相同的边,从节点0开始跟随这些边会访问20,000个节点:
CREATETABLEedgesASSELECT(range%100_000)::INTEGERASsrc,((range*13+7)%100_000)::INTEGERASdstFROMrange(1_000_000);WITHRECURSIVEreachable(node)AS(SELECT0UNIONSELECTdstFROMedges,reachableWHEREsrc=node)SELECTcount(*)FROMreachable;通过下面描述的优化,中位运行时间从DuckDB v1.5.5的4.051秒降至DuckDB v2.0预览版的0.095秒,在不改变SQL的情况下实现了42.6倍的加速。
可复用执行状态比前端更持久
递归CTE执行位于查询计划生命周期内。物理算子树属于该计划,不可变的调度投影在物理流水线构建期间构建。在计划内,一次调用跨越一次完整的不动点计算,而一次 epoch 跨越递归项的一次评估。原始查询计划已经保留了递归物理算子,但它的运行时将每个 epoch 视为一次新的执行:它重新创建事件和执行器,重建算子状态,并重复调度工作。
在流水线构建期间,DuckDB 推导出流水线依赖调度的不可变视图,包括在第一次执行后省略调用保留的构建流水线的形式。我们将这些视图称为调度投影。因此,运行时可以选择所需的依赖调度,而无需为每个 epoch 重新推导。
前端限定递归输入
每次递归epoch替换工作表,通常称为前端,而查询保持不变。锚定项产生第一个前端。递归项读取它并产生下一个前端的候选。使用常规UNION,DuckDB拒绝已见过的行;幸存者形成下一个前端,并贡献给逻辑并集表。当没有幸存行时,评估停止。
并集表属于语义范畴。DuckDB不需要物化它:结果块可以流式向下游传输,而引擎保留当前前端,对于常规UNION,还需要用于去重的哈希状态。只有当递归项访问recurring.cte_name时,它才累积完整副本。
对于单调、线性的递归项,这种前端纪律是半朴素评估的操作核心:一个 epoch 只读取前一个增量,而不是从到目前为止看到的每一行重新评估递归项。原始算子已经保持了这一语义不变式;剩余的不匹配涉及评估该前端的物理机制的生命周期。
Epoch不变状态属于调用
前端扫描,在REC_CTE_SCAN中显示为EXPLAIN计划,必须在 epoch 边界后读取新输入,并且每个依赖于该输入的算子的运行时状态必须重置。查询计划拥有的调度投影保持有效。为调用检出的执行器和调用拥有的缓冲区可以被重置以重用,而仅对递归无关的基础表进行构建可以保留其物化状态,如果重复构建会产生相同的可观察结果。旧运行时未能区分调用范围的物化状态与前端相关状态:其有效性跨越递归调用的物化状态不能由一个 epoch 拥有。
当一个操作的输入不依赖于当前前端,并且重新评估它将产生相同的可观察结果时,该操作是epoch不变的。扫描稳定的基表并从中构建哈希表是典型的例子。递归运行时遵循与循环不变代码外提相同的所有权区分:不变的构建属于 epoch 循环之外,而用变化的前端探测它则在其内部。
所有权不变式首先在递归运行时中失败。DuckDB将查询作为流水线图执行。尽管旧的物理算子保留了其递归元流水线,但每个 epoch 都重新创建事件和执行器,调度流水线并重建其状态。因此,epoch不变的流水线会重复读取相同的静态输入并重建相同的状态。
大的 epoch 可以将固定的调度和设置成本分摊到许多前端行上。重建不变状态仍然与静态输入大小成比例,并且可能比用变化的前端探测它花费更多。
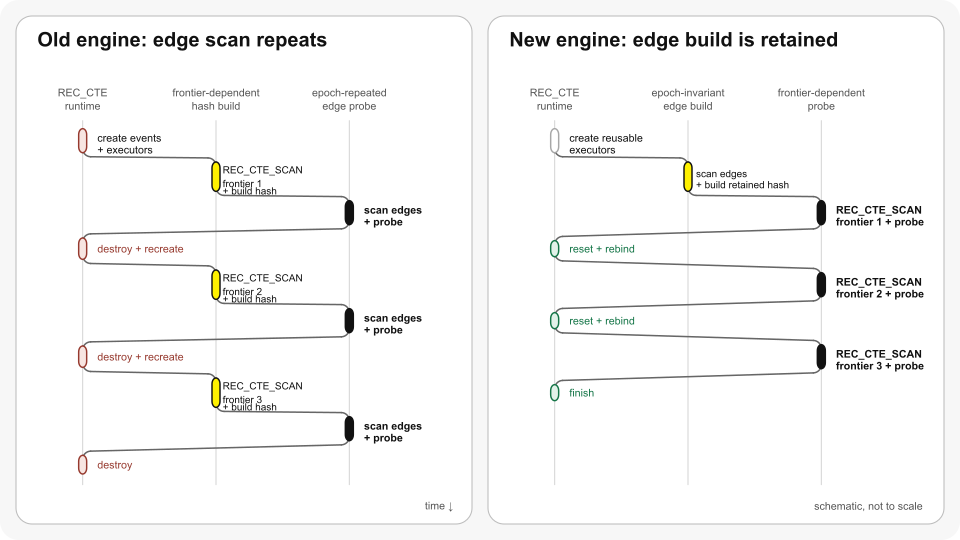
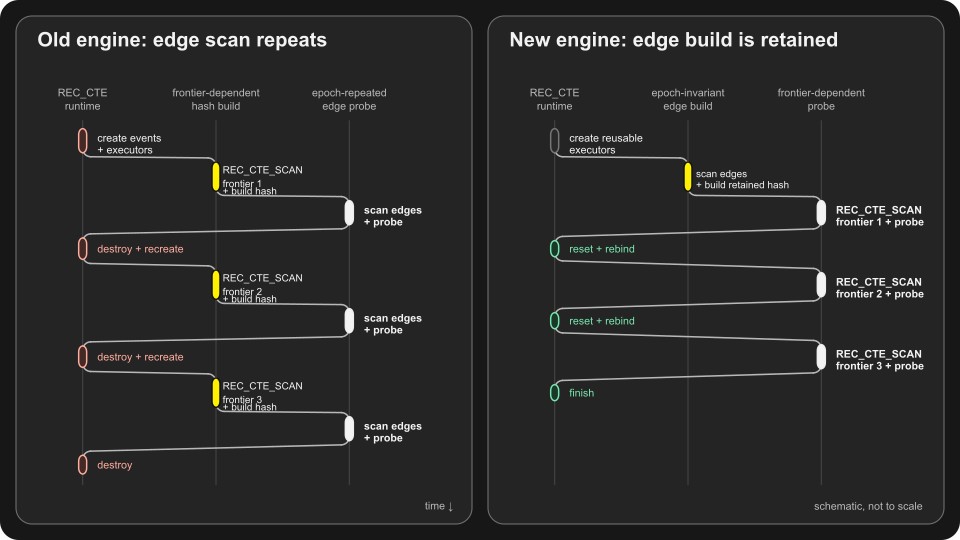
DuckDB v1.5.5从每个前沿重建哈希表,并重新访问边作为探测输入。新引擎反转连接,仅构建一次边哈希表,并用每个前沿探测它。
产生的所有权边界是:
| 状态 | 拥有范围 | 纪元边界动作 |
|---|---|---|
| 物理运算符树和不可变的调度投影 | 查询计划 | 保留 |
| 可复用的管道执行器池 | 查询计划 | 保留 |
| 执行器检出、块和集合容量 | 递归调用 | 重置内容以供重用 |
| 累积的重复消除或有键状态 | 递归调用 | 保留 |
| 可重复、独立于递归的构建 | 递归调用 | 保留物化状态 |
| 易变、有副作用或未知的构建 | 纪元 | 重建 |
| 递归扫描 | 纪元 | 重新绑定到当前递归状态 |
| 候选输出 | 纪元 | 清除或合并 |
起始查询中的哈希连接需要连接重定向和保留状态。DuckDB v1.5.5从当前的可达前沿构建哈希表,并在每个纪元中扫描边作为探测输入。新的规划器将独立于递归的边关系放在构建侧,如果有效。第一个纪元扫描边并构建哈希表;后续纪元重新绑定可达作为探测并重用该表。
EXPLAIN (ANALYZE, FORMAT JSON)使得避免的输入工作具体化。两个版本都返回预期的20,000个节点。DuckDB v1.5.5报告operator_rows_scanned: 19,718,328,320在边扫描上,相当于约19,718次完整扫描的行量,而DuckDB v2.0预览版报告表的一百万行只扫描一次。动态过滤跳过了一些v1.5.5边扫描的部分,但无法防止基础关系在每个纪元中被重新访问。
保留需要可重复性证明
仅当构建的可观察结果是可重复的时,我们才保留它。递归独立性建立了一个要求。可重复性增加了另一个:有种子样本可以保留;无种子样本、易变表达式如nextval()、DML、有副作用运算符或未知扩展运算符必须重建。可重复性分类器拥有该决策,并在无法证明安全时拒绝保留。这种保守的选择可能放弃重用,同时保持查询语义。
完全物化的CTE生产者遵循相同的所有权规则:独立于递归的结果可以存活,而每个消费者扫描被重置。我们不保留流式或混合生产者,因为其消费状态不具有相同的生命周期。早期源终止是另一个边界情况。保留的管道不得仅为了填充向量而扣留部分输出,因为这可能阻止下游LIMIT提前停止递归执行。因此重用保留了该终止契约。
精确基数使执行自适应
纪元边界提供了普通查询规划期间不可用的信息。到纪元结束时,DuckDB已完整生成下一个前沿,因此确切知道其行和块计数。这些观察到的基数决定递归运行时如何执行下一个纪元;优化器估计不再需要替代它们。
每个纪元选择自己的模式
一旦起始查询构建并保留了边哈希表,一个纪元将一个可达节点带入一个探测。通过并行调度器发送该工作会创建比有用工作更多的协调。前沿扩展到多个块的遍历具有相反的形状:在单个线程上执行会使独立的管道工作闲置。为整个查询选择的静态模式无法同时服务两种情况,并且单个查询可能在其前沿增长和收缩时在它们之间移动。
当精确的前沿和物理工作形状不证明任务调度合理时,纪元以内联方式运行。内联。一个线程遍历选定的不可变调度投影并直接驱动其运算符,而不创建任务或进入通用调度器。当工作分类器找到足够的独立工作时,调度执行调度执行实例化相应的递归事件图,并在有界数量的工作线程之间分配工作。两种模式使用相同的查询计划拥有的调度投影。为调用检出的执行器和调用拥有的缓冲区被重置以供重用;只有纪元级执行策略改变。
仅行数不决定有用的并行性。策略还考虑前沿块、递归引用数量、独立源任务、配置的线程和实际执行的管道。相同的前沿可以馈送多个管道,而独立源可以暴露前沿行未表示的工作。相反,工作线程本地输出和边界组合引入自身成本。因此,我们通过递归输入和物理工作单元来限制工作线程,仅对宽正则使用私有输出UNION ALL和重复消除UNION纪元,其中其合并成本可以摊销。
冻结的有键状态启用直接探测
Torsten Grust和Björn Bamberg解释了原始的USING KEY功能及其应用在他们的“USING KEY在递归CTE中的博客文章中。语义上,USING KEY将联合表作为有键状态操作:声明的键列标识一行,而其余负载列由声明的聚合或默认的last聚合维护。DuckDB在聚合哈希表中物理表示此状态。因此递归项可以直接探测选定的键,而不是扫描完整的循环状态。
每个纪元读取冻结的有键状态
直接访问必须保持一个语义不变量:通过recurring.cte_name在纪元i期间的每次访问观察到相同的有键状态Sᵢ。该纪元有三个有序阶段:读取Sᵢ,缓冲其候选集,并提交这些候选以获得Sᵢ₊₁在进行读取阶段时,让候选者可见会导致同一时期的另一个候选者观察到它,并使结果依赖于工作者到达顺序。这三个阶段保持了逐状态的一次性转换,同时探测并发执行。
原始实现通过将带有键的状态物化为集合以进行重复状态读取,从而保持了不变性。这种表示使得每次访问都有广泛的物理路径:触及几个键的时期也可能复制或扫描包含数百万个键的状态。
带有键的状态所有者现在强制执行这些阶段。当递归管道执行时,recurring.cte_name读取冻结的聚合哈希表,候选者则单独累积。所有者仅在时期边界提交它们。探测无法观察到应用了一半的更新,并且哈希表的增长无法使并发读者持有的地址失效。递归结束后,源会一次性耗尽最终的键控状态。
探测资格遵循连接形状
冻结表示支持专门的物理查找,同时保持语义视图。对于将每个声明的键与=或IS NOT DISTINCT FROM进行比较的内连接,可以使用递归键连接,在EXPLAIN中显示为RECURSIVE_KEY_JOIN,并直接探测聚合哈希表。在复合键的适当子集上进行的此类比较可以通过RECURSIVE_PARTIAL_KEY_JOIN使用时期稳定的二级哈希索引。新的完整键仅在其地址稳定后扩展索引;仅载荷更新不需要索引维护。
我们仅为针对直接重复状态扫描(REC_REC_CTE_SCAN)的内连接选择完整键专用化,且每个声明的键都有直接的、精确类型的标量=或IS NOT DISTINCT FROM比较。残留谓词、包装扫描、类型不匹配、嵌套键和其他连接类型使用常规路径。普通递归引用也不符合条件,因为它表示前沿;累积的键控状态可通过重复引用获得。将这两种身份视为可互换将改变查询。
稀疏工作应避免全状态扫描
下面的工作负载保留一百万个键,并通过20个时期推进其中的1,000个:
WITHRECURSIVEstate(key,value)USINGKEY(key)AS(SELECTkey,CASEWHENkey<1_000THEN0ELSE100ENDFROMrange(1_000_000)keys(key)UNIONALLSELECTfrontier.key,recurring_state.value+1FROMstateASfrontierJOINrecurring.stateASrecurring_stateUSING(key)WHEREfrontier.value<20)SELECTcount(*)ASkeys,sum(value)::BIGINTASvalue_sumFROMstate;在直接探测之前,连接反复扫描recurring.state。运行时指标统计了约2000万行全状态扫描,产生20,000个有用匹配。专用计划用20,000次直接探测替换它们,检查的重复状态行减少了1,000倍。在直接探测工作之前和之后的构建比较中,中位运行时间从0.401秒降至0.040秒。新路径还移除了以前用于物化完整键控状态的每时期集合。
候选者可以保持键控状态不变
即使键控状态没有变化,候选包也可能非空。如果候选者自动成为下一个前沿,递归可能在查询可见状态收敛后继续。保留执行状态并高效探测它无法修复这种语义不匹配。
USING KEY ... UNION现在赋予这种区别SQL级语义。我们的“A Fix for the Fixation on Fixpoints” CIDR论文和“How DuckDB is USING KEY to Unlock Recursive Query Performance” SIGMOD论文都描述了原始的候选者前沿设计,其中无论键控状态是否变化,候选包都成为下一个工作台。两者都没有定义改变的键增量。据我们所知,DuckDB是第一个、目前也是唯一个在UNION下区分改变的键递归与在UNION ALL下的候选者前沿递归的数据库系统。
最终状态属于提交层
在此更改之前,DuckDB遵循原始设计,并将USING KEY ... UNION和USING KEY ... UNION ALL同等对待。递归项产生的每个候选者都成为下一个时期的输入,即使应用它使重复表保持不变。由于普通的UNION与UNION ALL具有相同的候选者前沿行为,DuckDB v1.5为USING KEY弃用了它。这里引入的改变的键语义赋予两个关键字不同的含义,因此即将到来的v2.0保留两者。键的可观察聚合结果仅在该时期的每个候选者应用后才确定。因此,时期提交层拥有决定键是否改变的所有权。
最短路径的示例证明了为什么候选者不能自行决定。多条路线可能到达同一节点,并且每条路线都必须参与min(distance)。只有最终的最小值在键控状态中可观察。转发每条次优路线会倍增下一个时期的工作量;转发未改变的最小值可能在状态收敛后仍使候选者产生继续。
考虑键控状态{A:8, B:7}具有min载荷和候选者[A:9, A:5, B:7]。应用完整的候选包产生{A:5, B:7}。候选者A:9不影响最终的最小值,而B:7重复现有值。UNION ALL仍然转发所有三个候选者。UNION仅转发最终的行A:5因为它是唯一可观察的状态变化。
UNION和UNION ALL暴露不同的前沿
设Cᵢ为时期i产生的候选包,Sᵢ为那一时期可见的键控状态,以及Wᵢ₊₁为下一个工作台。设update(Sᵢ, Cᵢ)应用包中的所有候选者并最终确定每个受影响的载荷聚合,并设keys(Sᵢ)表示更新前存在的键。我们定义两种形式如下:
USING KEY ... UNION ALL
Sᵢ₊₁ = update(Sᵢ, Cᵢ)
Wᵢ₊₁ = Cᵢ

USING KEY ... UNION
Sᵢ₊₁ = update(Sᵢ, Cᵢ)
Wᵢ₊₁ = { Sᵢ₊₁[k] | k ∉ keys(Sᵢ) OR Sᵢ₊₁[k] IS DISTINCT FROM Sᵢ[k] }
对于相同的输入状态和候选包,两种形式计算相同的下一个键控状态。它们的不同之处在于什么变得递归可见:UNION ALL原样转发包,而UNION为每个新键或可观察改变的键转发一个最终行的。因此,在USING KEY ... UNION下的递归在键控状态停止改变时停止。
epoch-commit 层通过记录键先前是否存在,并在键首次被接触时对预先存在的键的 epoch 前最终化负载进行快照,来实现该规则。然后它在最终化并比较每个被接触的键之前应用每个候选。重复的候选和失败的min 或 max 输入仍然参与聚合评估,但它们自身不会成为递归工作。
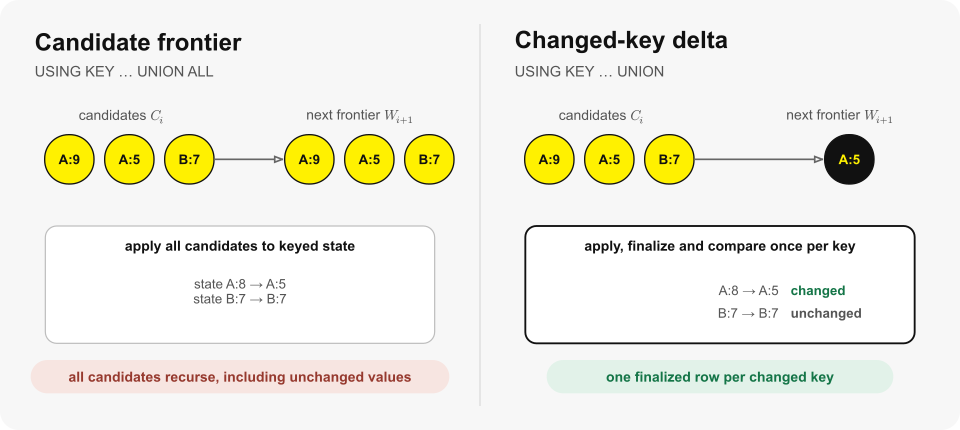
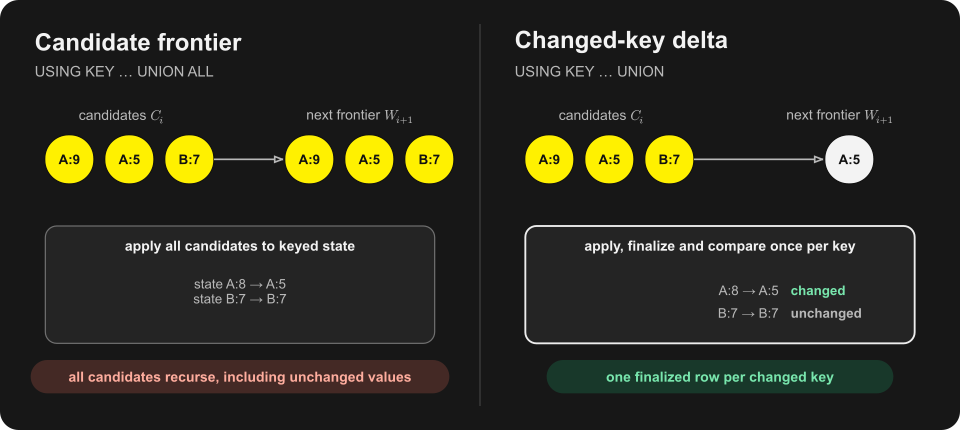
对于相同的键控状态和候选集,两种形式计算相同的状态更新;下一个前沿要么是该候选集,要么是变化键的增量。
我们使用 SQL 语义比较最终化值,包括 NULL 和排序规则。键身份使用与 GROUP BY 相同的规范化,并且排序的标量键仍然符合直接和部分键探测的条件。该实现还涵盖多列和嵌套负载、NaN 和带符号零。
两个前沿也有不同的类型。UNION ALL 前沿包含原始候选行,因此其负载列使用聚合输入类型。UNION 前沿包含最终化的键控行,因此其负载列使用聚合结果类型。这种区别通过 SQL 契约可见,并限制了内部表示。因为关键字选择前沿的内容、类型和终止条件,我们绝不会将一种形式推断为另一种形式作为优化。
变化键增量仍需支付候选工作
变化键增量仅在所有候选被应用后才减少下一个前沿。因此,即使最终只有少数键发生变化,数百万个重复候选仍可能使频繁的哈希表更新变得昂贵。对于符合条件且重复繁多的 epoch,我们首先在临时键控哈希表中组合候选,然后将这些聚合状态组合到递归状态中。
预聚合需要可组合的聚合状态
早期组合必须在观察上等同于直接应用候选。仅当每个负载聚合提供状态合并操作且没有顺序依赖时,我们才启用预聚合。因此,默认的 last 聚合和没有合并回调的扩展聚合保持在直接更新路径上。没有合并操作,预聚合缺乏有效的状态转换。对于顺序依赖的聚合,它可能改变观察到的输入顺序,从而改变结果。
基数证据管理预聚合
资格确定正确性;观察到的基数决定有效的转换是否值得。小于一个标准向量的 epoch 跳过分类,非扩展 epoch 的候选数不超过前一个前沿的也跳过。较大的合格 epoch 在候选键上构建 HyperLogLog 草图。仅当草图的误差膨胀基数估计低于候选数的四分之一时,我们才进行预聚合,并且一旦不同的键证据足以拒绝额外的哈希表,就提前停止草图。因此,决策适应每个 epoch 中观察到的重复情况。
证明值不变的成本限制了这一策略。对于具有 102,400 个唯一现有键更新的宽工作负载,在新 UNION 语义下,中位运行时间增加 0.913 毫秒,即 6%。执行器必须比较最终化值,而以前的实现转发候选而不证明变化。针对 min 和 max 的聚合特定快捷方式会将聚合语义放入递归执行器,因此我们不使用它们。聚合级别的变化报告契约可以将该责任放在聚合接口中。当前接口不提供此类契约。
大型激励工作负载是一个 LDBC SF100 路径查找查询。它生成约 2100 万个聚合候选,但 epoch 级聚合仅产生 370 万个可观察的键控结果。自适应路径预聚合了 1700 万个候选。在变化键工作前后立即匹配的 Release 构建上,查询时间从中位数 19.319 秒降至 2.948 秒,加速 6.55 倍,而峰值驻留内存从 3.918 GB 降至 2.663 GB。
更广泛的回归套件限制了该结果。在同一构建比较中,63 个递归基准的几何平均值提高了 5.5%,并且 60 个在 ±2% 以内。重复扇入和重复繁重的预聚合显著改进;上面的宽唯一键案例是唯一稳定的损失。因此,我们按 epoch 分类工作,而不是将赢得激励查询的策略应用于每个工作负载。
递归 CTE 现在作为单个自适应计算执行
新引擎解决了我在实现 DuckDB 原始递归操作符后想要移除的生命周期不匹配问题。查询计划拥有物理操作符树、调度投影和可重用执行器池。在每次调用中,运行时检查执行器并跨 epoch 保留可证明可重复、与递归无关的状态,而每个 epoch 重新绑定和重置依赖前沿的状态。这种分离使保留的不变工作和每 epoch 执行策略兼容。键控递归使用 epoch 边界冻结递归状态以进行直接探测,然后提交候选,并且仅在 UNION 下将可观察的变化暴露为下一个前沿。该实现跨 #22211、#24031、#24565 和 #24647 落地。
这一点很重要,因为递归会放大每次循环内产生的所有物理开销。单独看来不算大的扫描、哈希构建或调度器操作,可能会被执行成千上万次。新引擎会在每次调用时仅支付一次符合条件的固定开销,当观察到的工作量不足以摊销调度成本时,会跳过调度器,并对展现出足够独立工作的epoch进行分配。符合条件的键控连接可以直接访问所需状态,而使用 KEY ... UNION递归会在该状态收敛时终止。这使得递归SQL成为图遍历、路径搜索和状态机更实用的执行模型,尤其是在边界保持小而静态输入大,或许多候选更新相同键的情况下。
下一步是将这一基础扩展到更多递归计划。未来的工作可以将调用范围的重用扩展到更多符合条件的算子状态,并利用epoch边界处观察到的基数进行进一步的执行决策。每个扩展都必须保留相同的边界和状态转换语义。我打算继续沿着这条边界努力:在保持递归SQL可预测的同时,降低迭代的物理成本。
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏