Amazon MSK 大型消费组扩展最佳实践
有效阅读仅保存在当前浏览器,用于「为你」推荐;暂停或清除记录。
DataHot 速览
Amazon MSK 上扩展大型 Kafka 消费组时,重平衡期间 GroupMetadata 记录会写入内部 __consumer_offsets topic,组过大时可能超过默认 1 MB 限制,触发 RecordTooLargeException 和重平衡重试循环。本文解释消费组元数据如何增长、如何估算大小,并给出提高 topic 级大小限制的分步操作。文章还补充拆分消费组、调整分区数量和优化命名等策略,并讨论容量规划、监控及 Apache Kafka 4.0 中 KIP-848 在协议层的改进。
为什么值得关注:该文面向 Kafka/MSK 数据基础设施的生产运维,提供消费组扩展的具体故障机理、参数配置、容量规划与监控方法,对维护流处理平台的团队有直接参考价值。
本文目录 12 节
译文
AI 逐段翻译在 Amazon Managed Streaming for Apache Kafka (Amazon MSK) 上扩展大型消费者组时,一个常见挑战是管理内部元数据记录的大小。在重平衡期间,Kafka 会将一条元数据记录持久化到内部 __consumer_offsets 主题。如果消费者组足够大,这条记录可能会超过默认的 1 MB 限制。这会导致 RecordTooLargeException 和重平衡重试循环。
在本文中,我们解释消费者组元数据如何增长,以及如何估算元数据大小。我们提供逐步操作指南,说明如何提高主题级大小限制(最常见的修复方法),并就三种互补策略提供指导:拆分消费者组、合理设置分区数量以及优化命名约定。我们还会讨论容量规划、监控,以及 Apache Kafka 4.0 中的 KIP-848 如何在协议层面解决这一限制。
先决条件:本文假设你熟悉 Apache Kafka 消费者组、重平衡协议和 Amazon MSK 集群配置。你应有权访问 kafka-configs.sh CLI 工具或 Amazon MSK 控制台。所描述的配置方法适用于使用标准代理的 Amazon MSK 预置集群。KIP-848 部分介绍 Apache Kafka 4.0 中适用于各种部署类型的前瞻性协议变更。
消费者组元数据如何增长
下图展示了重平衡期间消费者组元数据如何在系统中流转:
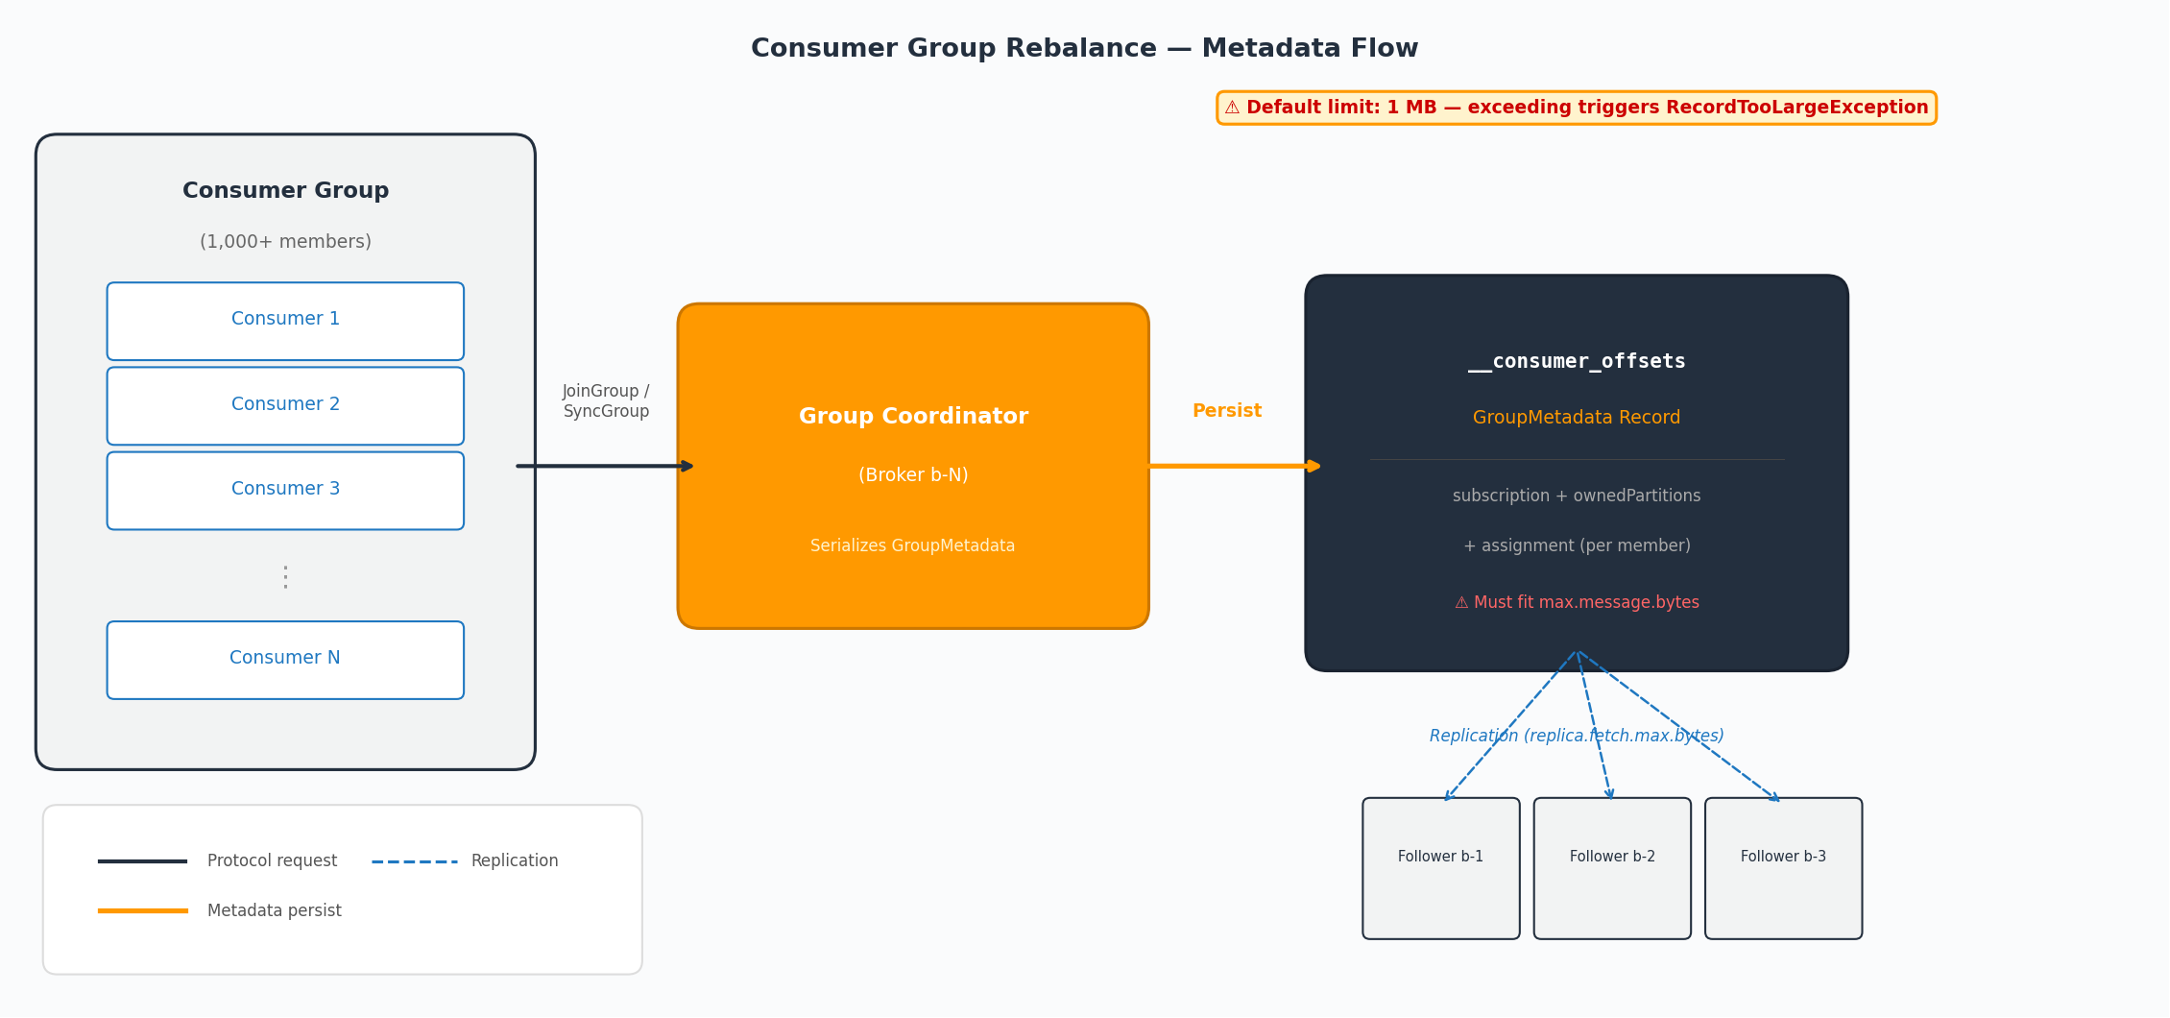
图 1:重平衡期间消费者组元数据流程
在重平衡期间,组协调器会序列化一条包含组内每个成员信息的 GroupMetadata 记录,并将其持久化到 __consumer_offsets 主题。这条记录必须符合该主题的 max.message.bytes 限制。跟随者代理也必须复制它,并受 replica.fetch.max.bytes 约束。对于每个成员,该记录包括:
- 订阅主题 – 该成员订阅的主题列表。
- 已拥有的分区 – 该成员当前持有的分区。
- 分配 – 重平衡后的新分区分配。
- 客户端 ID – 配置的
client.id。
Apache Kafka 的序列化格式会为每个成员多次重复主题名称:一次在订阅中,一次在 ownedPartitions 中,还有一次在分配中。client.id 还会增加每个成员的额外开销。代理将这些元数据记录以未压缩形式存储在 __consumer_offsets 中。
估算元数据记录大小
你可以使用以下公式近似计算消费者组的元数据记录大小:
record_size ≈ member_count × (3 × avg_topic_name_bytes + 2 × client_id_bytes + ~200 bytes overhead)
示例:一个拥有 1,000 个成员、主题名称为 50 字节、客户端 ID 为 40 字节的消费者组:
1,000 × (150 + 80 + 200) = ~430 KB
在相同参数下,1,500 个成员时:约 645 KB。如果订阅多个主题或命名约定更长,该记录可能在远不到 2,000 个成员时就超过 1 MB。
处理大型消费者组元数据的方法
以下各节介绍管理大型消费者组元数据的四种策略,首先从最直接的修复方法开始。
提高 __consumer_offsets 上的 max.message.bytes
如果你的消费者组元数据超过 1 MB,你可以提高内部主题上的最大记录大小。这是帮助解除已超出默认值扩展的消费者组阻塞的最直接路径。请注意,max.message.bytes 是主题级配置名称,而 message.max.bytes 是等效的代理级默认值。
1. 更新主题级配置:
kafka-configs.sh --bootstrap-server <bootstrap-server> \
    --entity-type topics \
    --entity-name __consumer_offsets \
    --alter \
    --add-config max.message.bytes=2097152 # topic-level config for max record size
2. 在集群级别更新 replica.fetch.max.bytes :
此代理级设置控制代理间复制的最大抓取大小。将其设置为等于或大于 max.message.bytes 在 __consumer_offsets 上的值,以便跟随者代理可以复制大型元数据记录。
replica.fetch.max.bytes=2097152你可以通过 Amazon MSK 控制台的集群配置应用此项,或使用 AWS Command Line Interface (AWS CLI) 的 update-cluster-configuration。
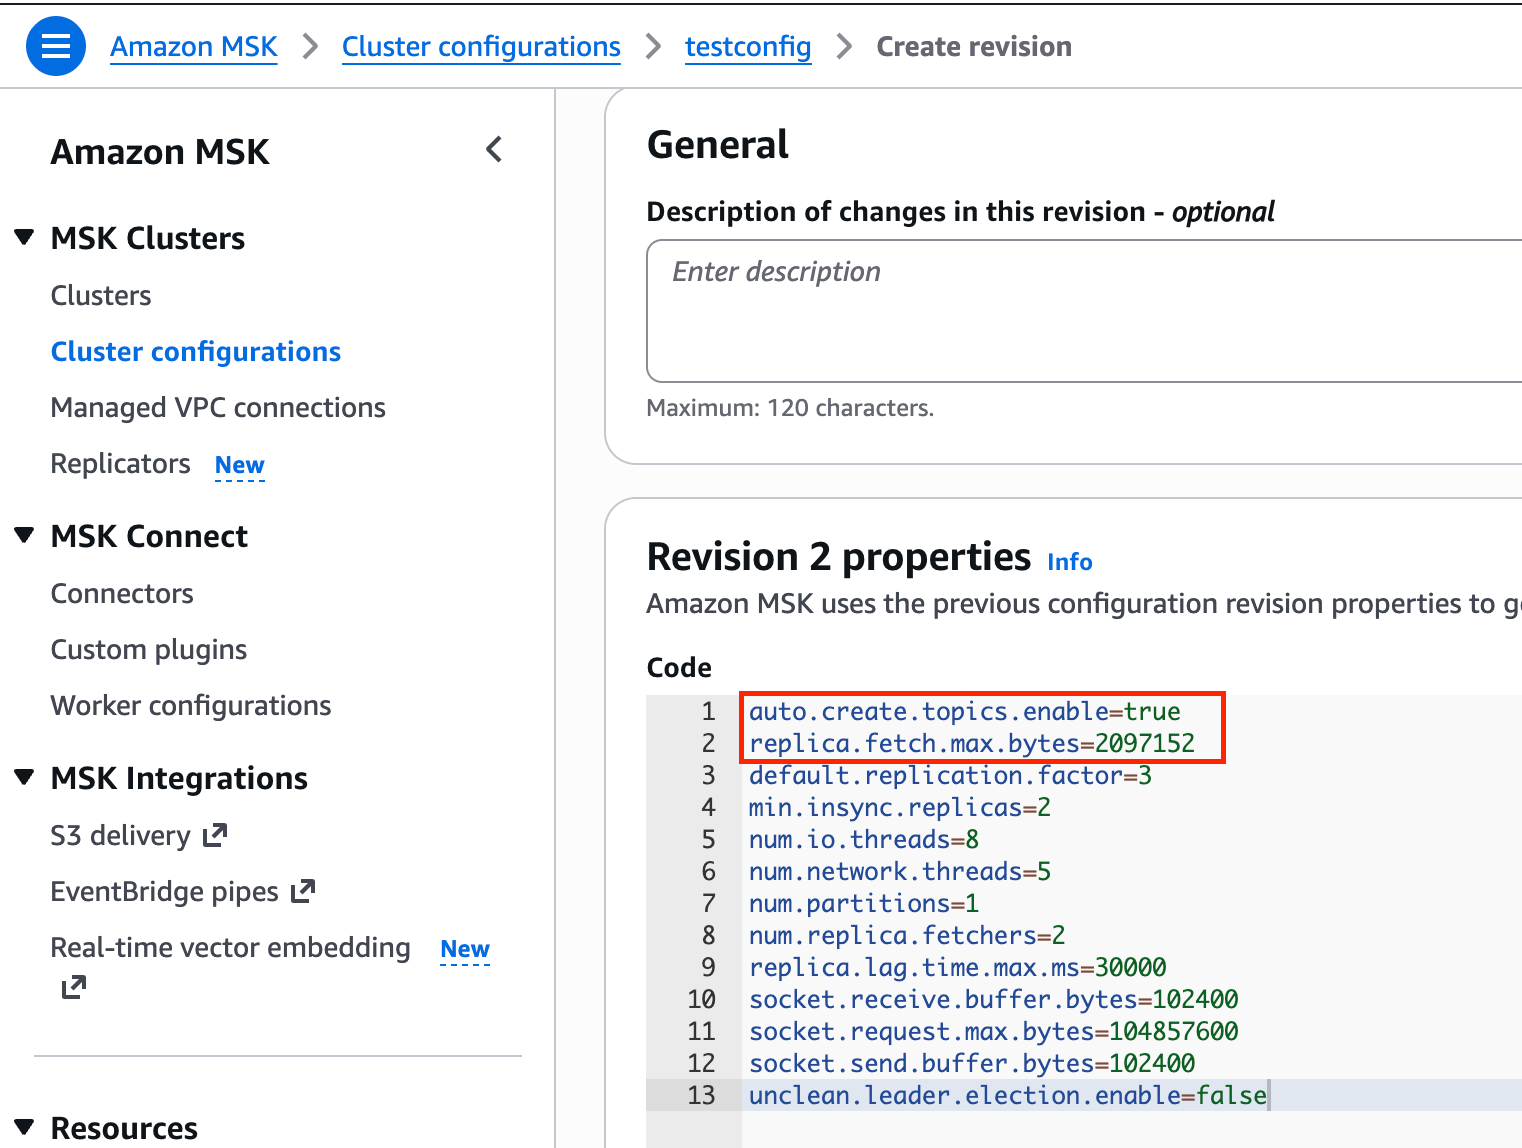
图 2:在 Amazon MSK 集群配置控制台中设置 replica.fetch.max.bytes
重要:始终确保 replica.fetch.max.bytes ≥ max.message.bytes 对于 __consumer_offsets。否则,你可能会在内部主题上观察到 UnderReplicatedPartitions。
3. 首先在非生产环境中测试:
- 触发消费者组重平衡(重启消费者或扩展消费者组)。
- 验证代理日志中没有
RecordTooLargeException。 - 确认代理堆使用量和复制延迟保持健康。
拆分大型消费者组
将单个大型消费者组拆分为多个较小的消费者组,可按比例减少每组元数据记录大小。要拆分消费者组,请部署多个连接器或消费者实例,每个实例使用不同的 group.id,订阅同一主题但从分区子集进行消费。系统会在每个子组内独立保留偏移量跟踪。
何时使用:消费者组成员通过 Auto Scaling 无限制增长,而你想在不修改内部主题配置的情况下,使每个组的元数据保持在限制范围内。
权衡:增加了运维复杂性。你需要监控和管理多个组,而不是一个。
合理设置分区数量和自动扩缩容边界
分区过多的主题需要更多消费者才能完全并行化,这会膨胀组成员数量。无限制的自动扩缩容策略可能会使消费者组增长到超出最初规划的程度。
- 检查你的主题分区数量是否与实际吞吐量需求匹配。
- 为自动扩缩容策略配置消费者副本数上限(例如,Amazon Elastic Kubernetes Service (Amazon EKS) 上的 Horizontal Pod Autoscaler)。
- 使分区数量与你打算支持的最大消费者数量保持一致。
这是一种主动措施,最好在主题设计和容量规划期间应用,以从一开始就防止元数据大小问题发生。
优化命名约定
消费者组名称和客户端 ID 会影响整体元数据大小。更短、标准化的命名可减少每个成员的开销。
注意事项:更改活跃消费者组的名称意味着新组从没有已提交偏移量开始,所有跟踪历史都将丢失。因此,命名优化对于新部署最为实用,而不是现有的生产组。
为更大的元数据记录进行容量规划
当你在 max.message.bytes 上增加 __consumer_offsets 时,更大的元数据记录会在再平衡处理期间消耗更多 broker 堆内存。适当的容量规划有助于你在遇到生产问题之前选择合适的 broker 实例类型和配置值。
规划步骤:
- 使用以下公式计算你当前的记录大小:member_count × (3 × topic_name_bytes + 2 × client_id_bytes + ~200)。
- 根据你的自动扩缩上限(最大消费者副本数 × 每个连接器的任务数,如果使用 Kafka Connect)来预测峰值成员数量
- 应用 2× 安全余量,以考虑协议开销、多主题订阅和突发扩缩事件。
- 从以下指导表中
选择你的 max.message.bytes值。 - 根据堆内存需求选择你的 broker 实例类型。更大的元数据记录会在再平衡期间增加堆内存压力。对于成员数超过 1,000 且元数据记录达到 2+ MB 的组,使用
kafka.m5.xlarge或更大规格,以提供足够的堆内存余量。 - 在非生产环境中验证,方法是在预测的峰值成员数量下运行消费者组,并在再平衡期间监控
HeapMemoryAfterGC。
下表根据消费者组大小提供规模指导:
| 消费者组大小 | 指导 |
| < 500 个成员 | 默认 1 MB 通常足够。kafka.m5.large 或更大规格。 |
| 500–1,000 个成员 | 监控元数据大小。考虑增加到 2 MB。kafka.m5.xlarge 或更大规格。 |
| 1,000–2,000 个成员 | 增加到 2–5 MB。kafka.m5.2xlarge 或更大规格,以获得足够的堆内存余量。 |
| > 2,000 个成员 | 将增加的限额与组拆分相结合。kafka.m5.2xlarge 为最低要求。考虑使用 kafka.m5.4xlarge 以应对高再平衡频率。 |
需要监控的关键指标
以下 Amazon CloudWatch 指标可帮助你跟踪消费者组元数据健康状况:
| 指标 | 它告诉你什么 |
HeapMemoryAfterGC(Amazon CloudWatch) | 垃圾回收后已使用堆内存的百分比。表明再平衡期间更大的元数据记录带来的内存压力。 |
UnderReplicatedPartitions(Amazon CloudWatch) | 复制健康状况。非零值可能表明 replica.fetch.max.bytes 太低。 |
| GC 暂停持续时间(broker 日志) | 长时间 GC 可能触发会话超时和级联再平衡。 |
| 消费者组再平衡速率 | 稳定的组在配置更改后不应频繁再平衡。 |
| 消费者延迟 | 确认消费者在再平衡完成后正在取得进展。 |
我们建议为 HeapMemoryAfterGC 创建两个 Amazon CloudWatch 告警。在 60% 设置警告告警,以指示潜在的性能下降。在 80% 设置严重告警,此时你应该扩展 broker 或减小消费者组大小。对于 UnderReplicatedPartitions,在任何值> 0 在配置更改后持续超过 5 分钟时告警。
展望未来:KIP-848 和 Apache Kafka 4.0
Apache Kafka 4.0(2025 年 3 月发布)采用 KIP-848 作为默认消费者协议。broker 现在在服务端计算分区分配,而不是委托给消费者组领导者。由于每个成员不再在网络上携带完整的订阅和分配数据,新协议减少了每个成员的元数据大小。有关实现这一减少的协议变更的详细信息,请参阅 KIP-848 设计文档。KIP-848 还引入了增量再平衡。
Amazon MSK 上较新的 Apache Kafka 版本默认带来更小的元数据记录。以下步骤可帮助你为采用 KIP-848 做好准备:
- 跟踪 Amazon MSK 对 Apache Kafka 4.0+ 的版本支持。
- 验证你的 Kafka 客户端库支持新的消费者协议。
- 在迁移生产消费者组之前,在非生产环境中测试新协议。
- 规划分阶段推出,从非关键消费者组开始。
结论
下表总结了何时应用每种方法。max.message.bytes 增加(前面已逐步介绍)是主要的补救措施。其他策略是你可以根据环境调整的补充指导:
| 情况 | 推荐方法 |
生产中已遇到 RecordTooLargeException在生产中 | 增加 max.message.bytes 在 __consumer_offsets 上 + 相应设置 replica.fetch.max.bytes相应地 |
| 为增长做规划 | 合理设置分区数量、设置自动扩缩上限、监控元数据大小 |
| 命名开销显著 | 为新部署优化命名约定 |
| 以非常大规模式运行(2,000+ 个成员) | 将增加的限额与消费者组拆分相结合 |
| 长期架构 | 规划迁移路径到 KIP-848(Apache Kafka 4.0) |
首先在非生产环境中测试配置更改,在再平衡期间和之后监控 broker 指标,并逐步扩展。有了这些实践,你就可以按照流式工作负载所需的规模来运行消费者组。
入门:
- 查看 Amazon MSK 开发人员指南 了解集群配置步骤。
- 使用本文中的规模计算公式来估算你当前的元数据记录大小。
- 在 Amazon CloudWatch 告警 上设置
HeapMemoryAfterGC,以主动监控 broker 健康状况。
相关资源
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏