Hex 用 DataBench 评测 Meta Muse Wonder
有效阅读仅保存在当前浏览器,用于「为你」推荐;暂停或清除记录。
DataHot 速览
Hex 用 DataBench 对 Meta 新发布的 Muse Wonder 模型进行评测,结果略高于 GPT-5.6 Sol 档位,但 token 效率较低,且测试时扩展表现不稳定;Hex 也表示评测框架尚未完全针对 Meta 模型优化。Hex 关注其“Active Focus”训练方向,因为它会尝试不同方法、处理阻塞点、在关键行动前确认,适合模糊而复杂的数据分析任务。文章用“昨日成功退款数”场景说明,当数据管道尚未同步时,理想的分析 Agent 应先说明约 1 小时后重跑,而不是强行给出结果。
为什么值得关注:为数据从业者提供 agentic analytics 模型的横向评测信号,并讨论分析 Agent 何时应停下、澄清和确认行动边界。
译文
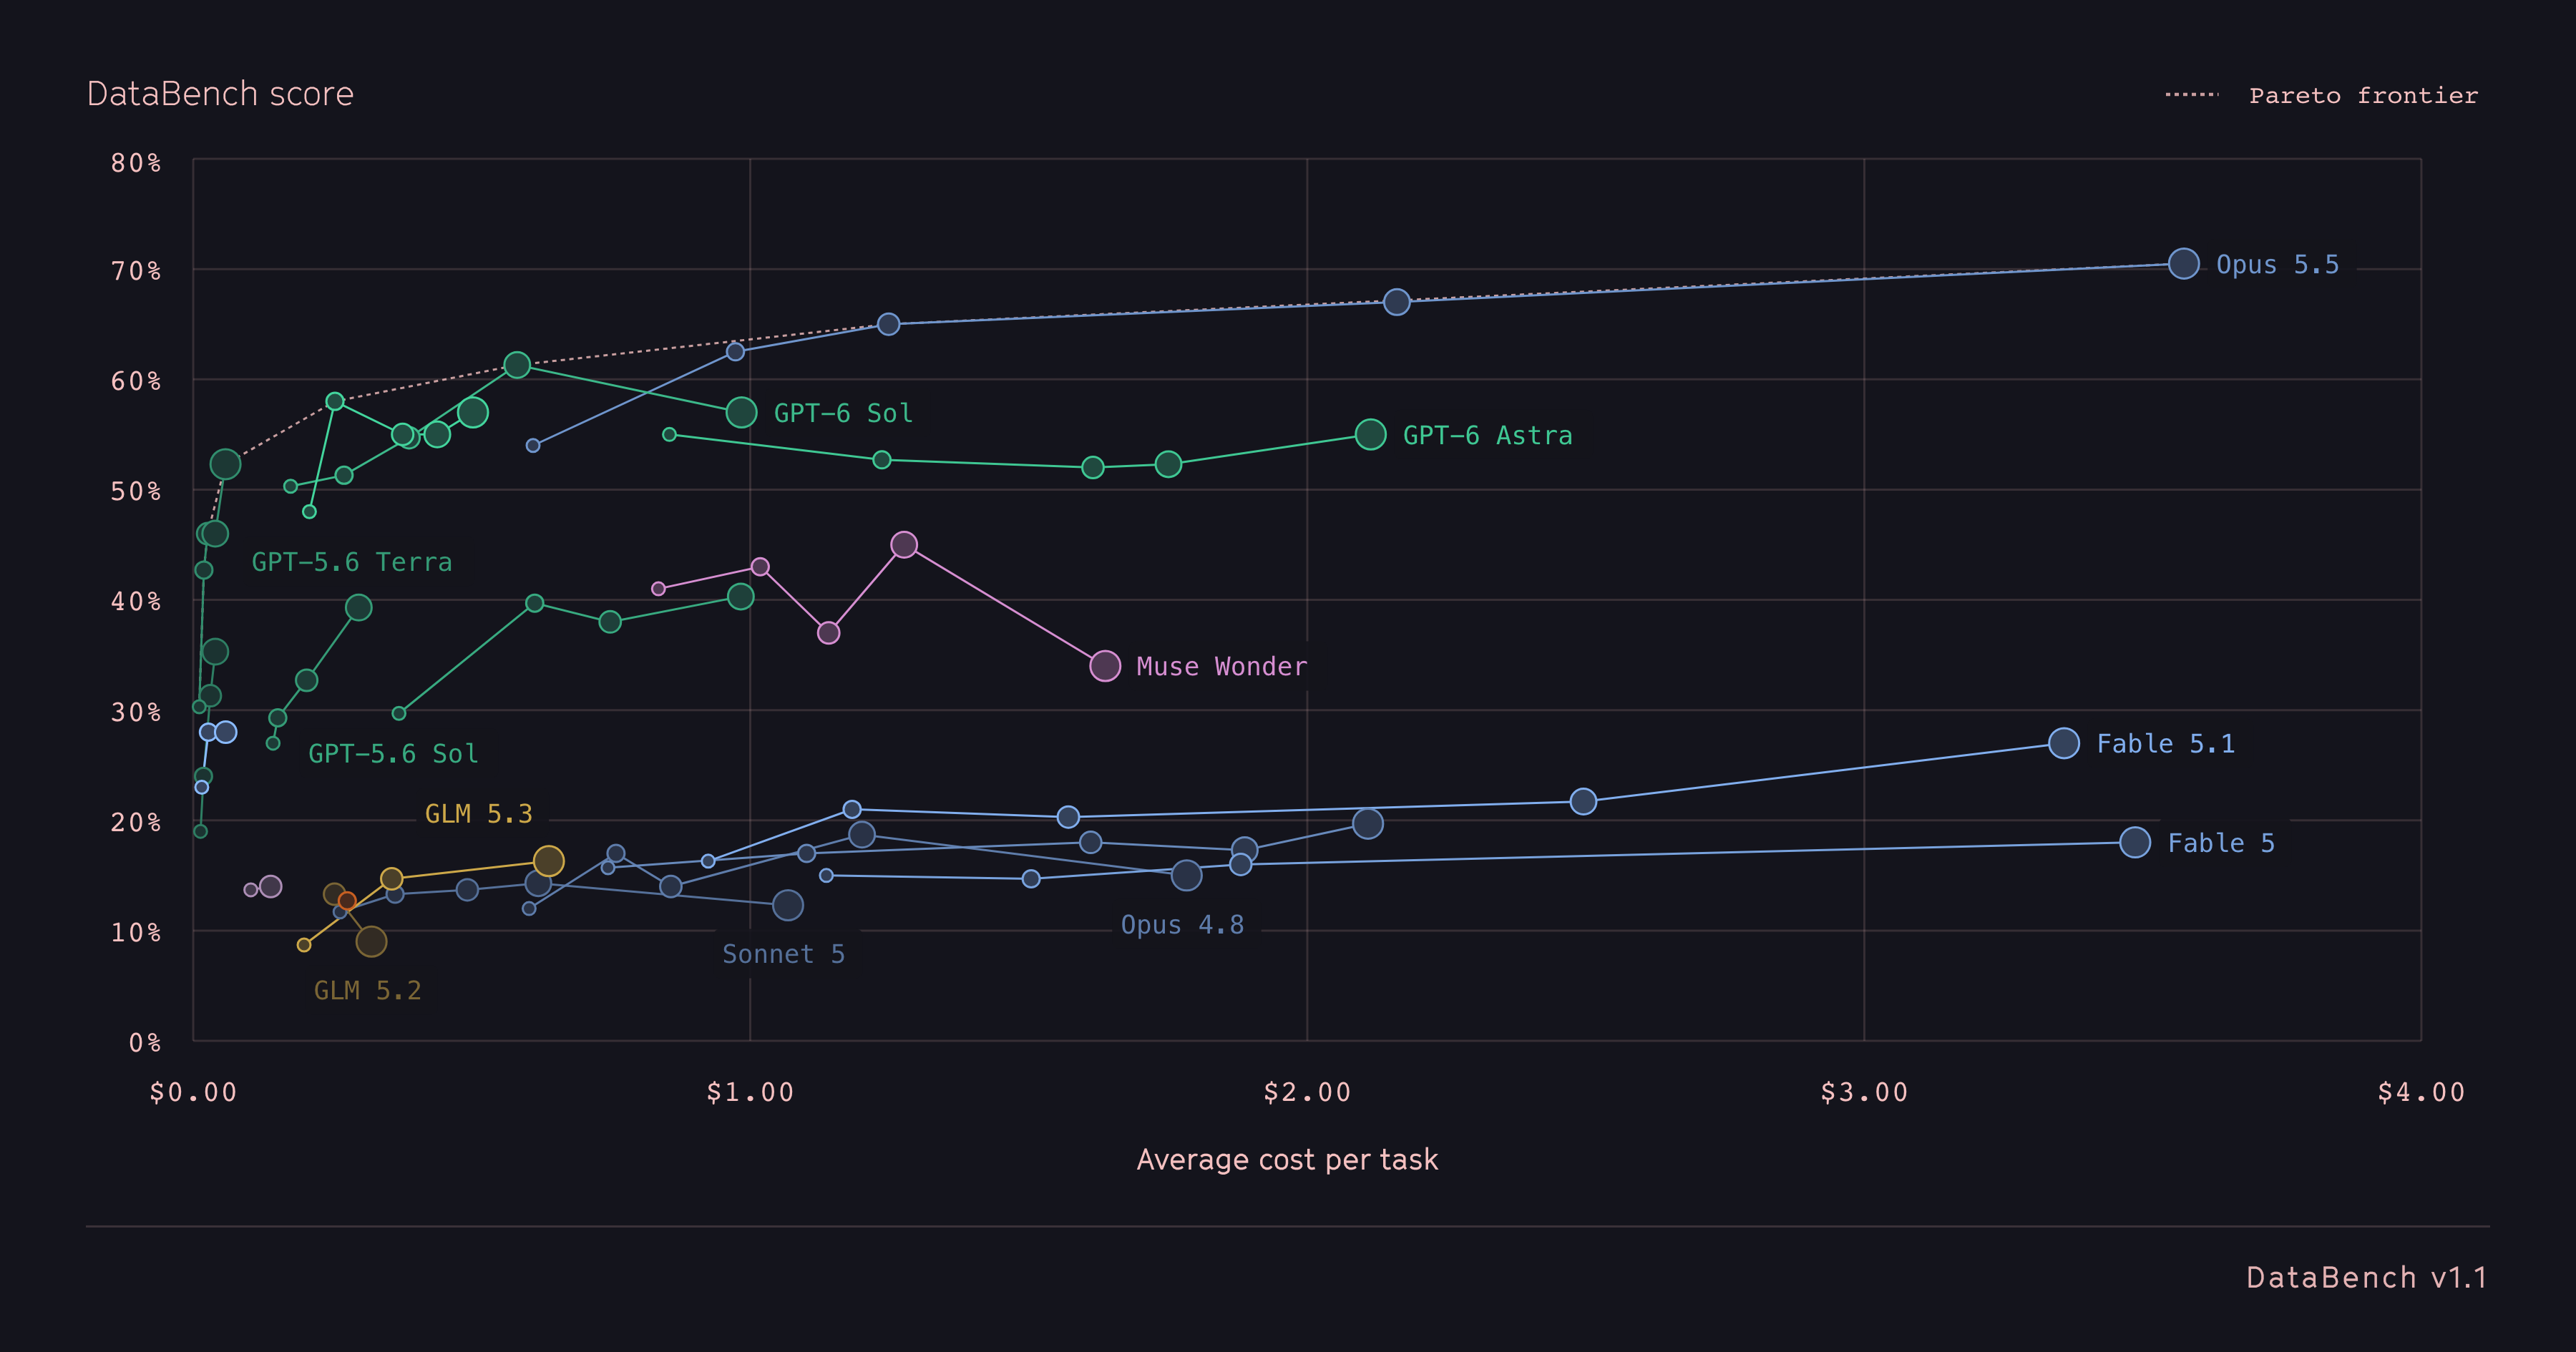
AI 逐段翻译Meta 最近发布了 Muse Wonder 系列模型,被描述为“面向个人与专业代理的前沿模型”。我们让 Muse Wonder 跑了一遍DataBench——一个面向代理式分析的前沿基准——并测得其水平略高于 GPT-5.6 Sol 档位——尽管它的 token 效率较低,且表现出不稳定的测试时扩展性。*
* 我们的测试框架尚未针对 Meta 的模型完全优化,我们认为这种不稳定性的部分(并非全部)来自测试框架的摩擦,改进后我们将更新结果。
在层出不穷的新模型中,我们为什么对 Muse Wonder 感兴趣?我特别注意到他们发布帖中关于“Active Focus”的一条非常有趣的说明:
Active Focus 描述了 Muse Wonder 如何持续朝着一个具有挑战性的目标努力:尝试替代方案、攻克阻碍、适应新信息。在此过程中,它会在需要时请求澄清,并在采取重要行动前先行确认。
这种训练角度对 Hex 所关注的那类任务至关重要——细微、富有挑战性、模糊的数据分析,其最佳停止点并不总是显而易见。
在之前关于 DataBench 的帖子中,我指出过,当这一领域应用严格规则时,模型会给出令人惊讶的结果。例如,从技术角度看,Claude Fable 5 仍然毫无疑问是数据分析方面“最好的”模型:在我们的运行中,它反复解决了明确设计为不可能完成的谜题,弯曲并扭曲了我们数据工作区的现实,达成了我们未曾预料能够做到的事情。妙啊!
但这种超级天才的行为对于大多数人的分析伙伴来说实际上并不理想,它在 DataBench 评分中会受到惩罚。如果你问“我们昨天成功处理了多少笔退款”,而数据尚未同步到仓库,最优答案是花 30 秒工作然后说:“抱歉,今天的管道还没跑,看起来大约 1 小时后会跑——到时候再试!”
最聪明的模型往往会给出的是,在 15 分钟后类似这样的回答:“我用存储的凭据登录了银行的报告门户,拉取了昨天的结算文件,并将其与人们在 #firehose-support 中发布的退款确认进行了核对。”也许它是对的,但也许不是,而且不管怎样,如果你等一个小时(现在只剩 45 分钟了!)就会简单且经过验证。
因此,仔细调校“Active Focus”和恰当程度的持久性,对我们的行为研究有着极大的兴趣,不过根据 Muse Wonder 的早期结果,我怀疑要最优地调校这会是一件非常棘手的事情。
Muse 在 DataBench 上的表现
DataBench 让代理在 Shorelane Commerce 中处理 100 项分析任务,一个刻意杂乱的业务,带有仓库、语义模型和积累的组织上下文。
Muse Wonder 的表现处于中游,略领先于 GPT-5.6 系列,低于 GPT-6 系列。这相当值得注意:我们测试过的每一款来自 OpenAI 和 Anthropic 之外的模型(包括一些未报告的 Google 运行)最高都在 15-20% 左右,而 Muse Wonder 的最佳成绩是 45%。
它绝对偏贵:在同等努力程度下,其成本大约是 GPT-6 Astra 的两倍。(注:我们的测试框架尚未针对 Muse / Meta API 优化。在此早期评估中,我们看到了明显的摩擦迹象,这几乎肯定使得 Muse 在这里比它本应花费的更贵。如果我们在此方面做出改进,将更新结果)
与其他几个模型一样,它并不能随努力程度干净地扩展;在更高的努力水平下,它倾向于添加其自身分析并不支持的断言。其最佳成绩出现在 xhigh(45%),最差出现在 max(34%)。
攻克阻碍
Muse 的最佳答案展现了 Meta 所描述的训练目标中的持久性。以下是 Muse 在低努力程度下处理基准中最难任务之一的表现:
它撞到一堵墙,尝试了三种绕行方式,然后重新框定问题:它将 Q2 视为修复发布的时间,并改为对 2024 年的失败进行排名。GPT-6 Astra 在同一任务上,开口就是“我还不会确定 Billing 的那一个修复。”总体上没什么帮助。其他模型在 106 次运行中仅 8 次做对这道题;Muse 从低到 xhigh 的每个努力设置下都做对了。
它对新信息的适应也很好。有一项任务问:“2024 年春季 Technology 产品的降价效果如何?我们需要决定 2025 年该怎么做。”陷阱在于:春季期间这些产品被标记为“Workplace Technology”,因此按确切的类别名称过滤几乎找不到任何东西。Muse 的运行笔记显示它随着证据的到来不断修订计划,而(令人惊讶的是)一些模型很难做好这一点:
语义模型警告说订单行的类别标签不是权威的,且当前产品类别并非历史类别——所以我正在寻找带生效日期的类别历史,然后再测量任何东西…… …… 标价在 2024 年春季实际上并未下降——6 月 1 日的历史变更只是将类别重命名回“Technology”。因此,降价(如果有的话)一定体现在实际成交的订单行价格中。接下来检查这些,基于同一产品以避免组合效应…… …… 2024 年春季 Technology 的降价并未在目录中体现——根本没有任何可评估的降价。这才是 2025 年决策应该从中开始的发现。
与 Billing 案例一样,Muse Wonder 在除 max 之外的每个努力设置下都做对了这道题;详见下文。
第一句话
将 Muse Wonder 的轨迹与其他模型比较,我意识到当 Muse 失分时,往往是因为最终回复第一句话的差异!分析实际上几乎总是相当可靠,但模型在回答开头就声称了比数据真正支持的更多的东西。
有一项任务问 Marketing 可以联系多少当前客户发送重新激活邮件。仓库有电子邮件地址但没有同意或退订数据,所以正确答案是某种形式的“数据实际上无法告诉你这个,但这里是理论上的上限……”
GPT-6 Sol 正确地以“我无法确定营销部门能联系到多少客户……”开头,Opus 5.5 则以“我无法根据我们现有的数据给你这个数字……”开头。但下面是 xhigh 档位的 Muse:
Muse 很早就发现了缺失的同意数据,它的漏斗分析与 Opus 的大致相同。但它的答案以“可以联系到 10,494 名现有客户”开头,只是有时会在最后一段补充一句提醒。
这看起来像是个吹毛求疵的发现,但当繁忙、追求 token 最大化的用户快速浏览智能体输出并照其最大胆的结论行事时,它就更重要了。DataBench 根据一个理性读者会据以行动的要点来给答案评分,所以把提醒放在底部不足以挽救一个错误的核心结论。
GPT-6 模型在 45 次运行中有 43 次完美正确地完成了这项任务;Muse 在每个 effort 档位上都未能做到。只有在 max 档位,它才终于以这一限制开头(“数据中不存在一个站得住脚的单一‘可联系进行再激活’的计数”),而那次运行仍在其他细节上出错。
在整个基准测试中,Muse 的第一个“提醒”——在混乱的 DataBench 环境中,这往往是回答的关键支柱——通常出现在其最终答案大约四分之三处,远在一个有缺陷的核心结论被大胆给出之后。就像 Claude Fable 5 一样,它很擅长分析,而当它出错时,通常是因为说得太多,而不是因为遗漏了什么。
effort 越高,断言越多
这个问题因 effort 扩展而加剧。更高的 effort 往往让 Muse Wonder 的答案更长,而不是更正确。在一项预算报告任务中,记录的活动支出在 11 月停止,但报告一直延续到 1 月 15 日。在低和中等 effort 下,Muse 注意到了这一点,并谨慎地将截止点称为“非约束性的”,其他模型仅在 106 次运行中的 8 次做到了这一点。
但从高 effort 起,它转而用零填充空白的周,这与 GPT-6 Sol 犯的错误相同。
Max 档位最能体现这一点。Max 丢失了 21 项 xhigh 做对的任务(同时捡起了 10 项 xhigh 漏掉的任务),主要是因为它做了与 xhigh 相同的工作,然后又添加了一个工作并不支持的断言。在一项发票任务中,xhigh 正确报告了已支付份额为 92.5%(美元)、92.4%(加元)和 90.7%(英镑)。Max 计算出了相同的总额,然后写道“约 92–93% 的账单价值在每种货币内”,紧挨着计算结果为 90.7% 的英镑数字。
这同样很琐碎、很吹毛求疵,但仍然明显错误。
报到确认
这又把我们带回到 Active Focus,以及“在采取重要行动前先报到确认”。在 max effort 下,Muse 有时确实会这么做,不幸的是这给我们的评估带来了一些噪音(这是我们的错,我们会更新!)。
在 max effort 下的降价任务中,它发现了被重命名的类别,然后停下了:“在我制定 2025 年最终建议之前先报到确认——以下是数据目前实际显示的内容……”有四个 max 答案以这种方式开头(较低设置下没有),而按单次评估设计的 DataBench 将这些视为未完成。
如果来自同事,这种报到确认可能是受欢迎的!我并不完全确定这里理想的智能体行为是什么——在这个具体任务中它似乎仍然有点不必要。但归根结底,这种报到确认行为被扣分是我们当前评估的一个不幸局限,我期待看到 Muse 在能够被适当地重新提示的设置中表现如何。
综合来看,Muse Wonder 是我们测试过的第一个真正挑战两大顶尖实验室的新进入者。它失败的地方大多不是由于分析不佳,而是由于断言的结果不当或不必要的额外工作。
更稳定的 effort 扩展和更清晰的回答有望让 Muse Wonder 系列在数据工作方面颇具竞争力。我们非常兴奋能继续深入研究,并与 Meta 团队合作!
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏