在 Amazon SageMaker Catalog 中用生成式 AI 查询非结构化数据
有效阅读仅保存在当前浏览器,用于「为你」推荐;暂停或清除记录。
DataHot 速览
这是系列文章第二部分,介绍非结构化数据消费侧流程。数据消费者登录 SageMaker Unified Studio,利用 AI 生成元数据关键词在 Amazon SageMaker Catalog 中搜索并订阅 S3 数据资产,经生产者审批后使用两种方式查询:面向分析师和业务用户的无代码聊天 Agent 自然语言查询,以及面向应用工程师的 Amazon Bedrock 模型推理编程访问。生产侧此前使用 Amazon Textract 和 Amazon Bedrock 上的 Anthropic Claude 提取并丰富元数据,目标是让组织更易发现并利用 PDF、图像、邮件等非结构化数据中的业务知识。
原收录理由(待核验):数据从业者可了解如何把数据目录、元数据增强、订阅审批与生成式 AI 查询串成可落地的非结构化数据消费链路,覆盖从业务分析到应用集成的两种模式。
译文
AI 逐段翻译每天,企业都会生成大量非结构化数据,例如 PDF、图像、电子邮件、客户反馈和医疗报告。但仅仅知道数据存在还不够。你需要快速找到它、访问它,并从中提取答案。在第 1 部分中,你了解了如何设置管道的生产端:使用Amazon Textract和 Amazon Bedrock上的 Anthropic Claude 来提取和丰富元数据,然后将这些丰富后的资产发布到 Amazon SageMaker Catalog,以便你的组织能够发现它们。
在本文中,你将迈出下一步:消费端。你以数据消费者的身份登录,搜索并订阅丰富后的非结构化数据资产,然后使用两种方法查询它们。第一种是用于自然语言查询的无代码聊天代理。第二种是用于程序化访问的 Amazon Bedrock 模型推理。读完本文后,你将了解如何释放非结构化数据中的业务知识,并使其可供分析师和应用程序工程师使用。
解决方案概述
本文延续这个由两部分组成的系列文章架构,其中 Amazon SageMaker Catalog 作为中心枢纽,通过发布-订阅模型连接数据生产者和消费者。
消费者工作流在生产端丰富并发布非结构化数据资产之后开始。作为消费者,你将:
- 登录你的 SageMaker Unified Studio消费者项目,并使用来自丰富后元数据 README 的关键词搜索目录。
- 订阅已发布的 Amazon Simple Storage Service(Amazon S3)资产,并获得生产者批准的订阅。
- 选项 1 – 用于自然语言查询(NLQ)的无代码聊天代理,非常适合数据分析师和业务用户。
- 选项 2 – 用于程序化 NLQ 集成的 Amazon Bedrock 模型推理,适合构建数据驱动应用程序的应用程序工程师。
下图说明了此解决方案中的消费者工作流。消费者(1)登录 SageMaker Unified Studio,(2)使用 AI 生成元数据中的关键词在 Amazon SageMaker Catalog 中搜索丰富后的非结构化数据资产,(3)订阅该 S3 数据资产并获得生产者批准,然后(4)使用 Amazon Bedrock 聊天代理应用(选项 1)或通过 Jupyter notebook 使用 Amazon Bedrock 模型推理(选项 2)查询数据。
通过无代码和程序化两种路径,不同角色的消费者,从分析师到工程师,都可以以适合其工作流的方式查询数据,同时 SageMaker Catalog 审批工作流始终维持受治理的访问。
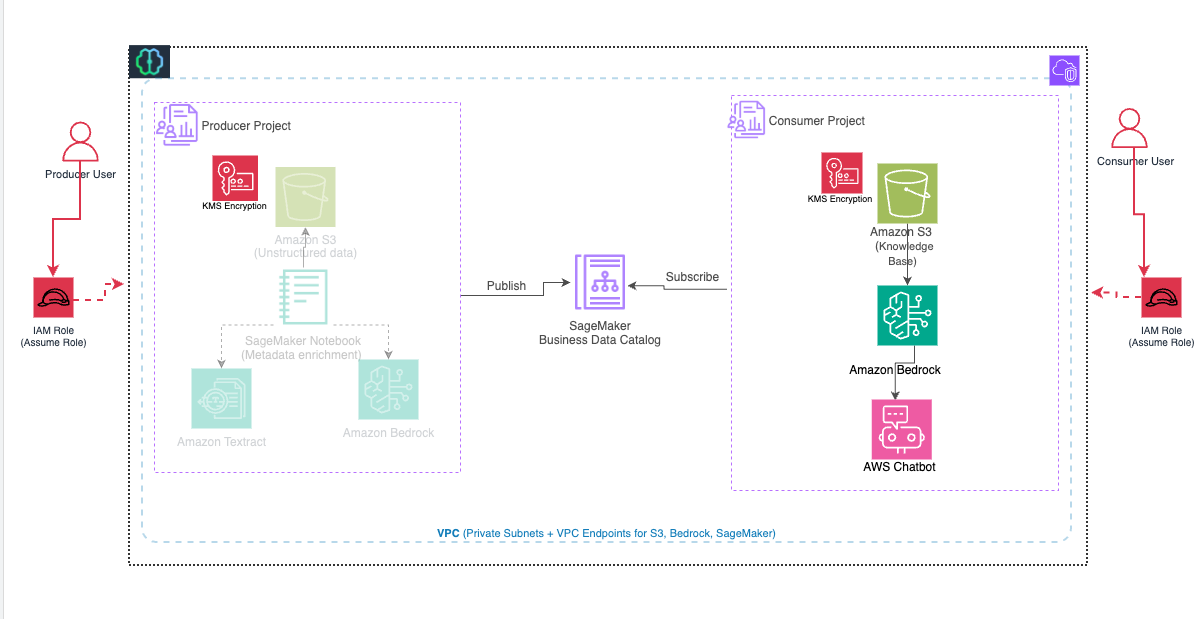
图 1:发布-订阅解决方案的消费者工作流
先决条件
在开始之前,请确保你已完成本系列第 1 部分中的所有步骤,包括:
- 一个 AWS 账户。
- 一个已上传丰富后文档和 Amazon Simple Storage Service(Amazon S3)存储桶,以及
results.txt文件。 - 生产者项目(
unstructured-producer-project)– 资产已发布到 SageMaker Catalog。 - 消费者项目(
unstructured-consumer-project)– 你将在其中订阅并查询数据。
注意: 你可以使用自定义蓝图来根据具体需求定制 Amazon SageMaker Unified Studio 项目环境。有关更多信息,请参阅 使用自定义蓝图按需定制 Amazon SageMaker Unified Studio 项目环境。
第 1 部分中添加到生产者项目角色的 AWS Identity and Access Management(IAM)权限。
从消费者项目消费已发布的数据
在本节中,你将在 SageMaker Unified Studio 消费者项目中以消费者用户身份登录。然后,你将通过搜索第 1 部分中发布的 README 中的关键词来订阅 S3 存储桶。
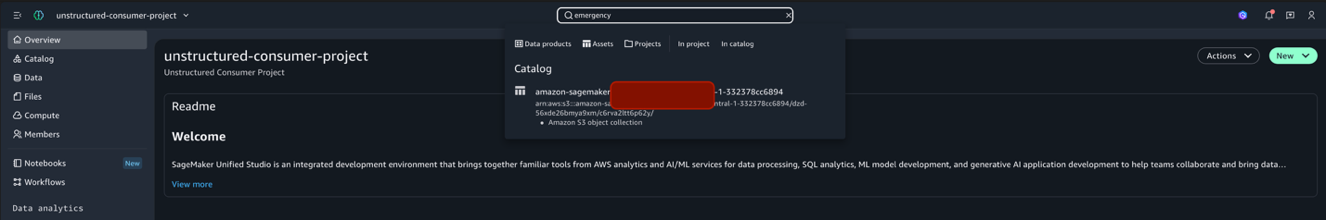
- 登录消费者项目并搜索关键词
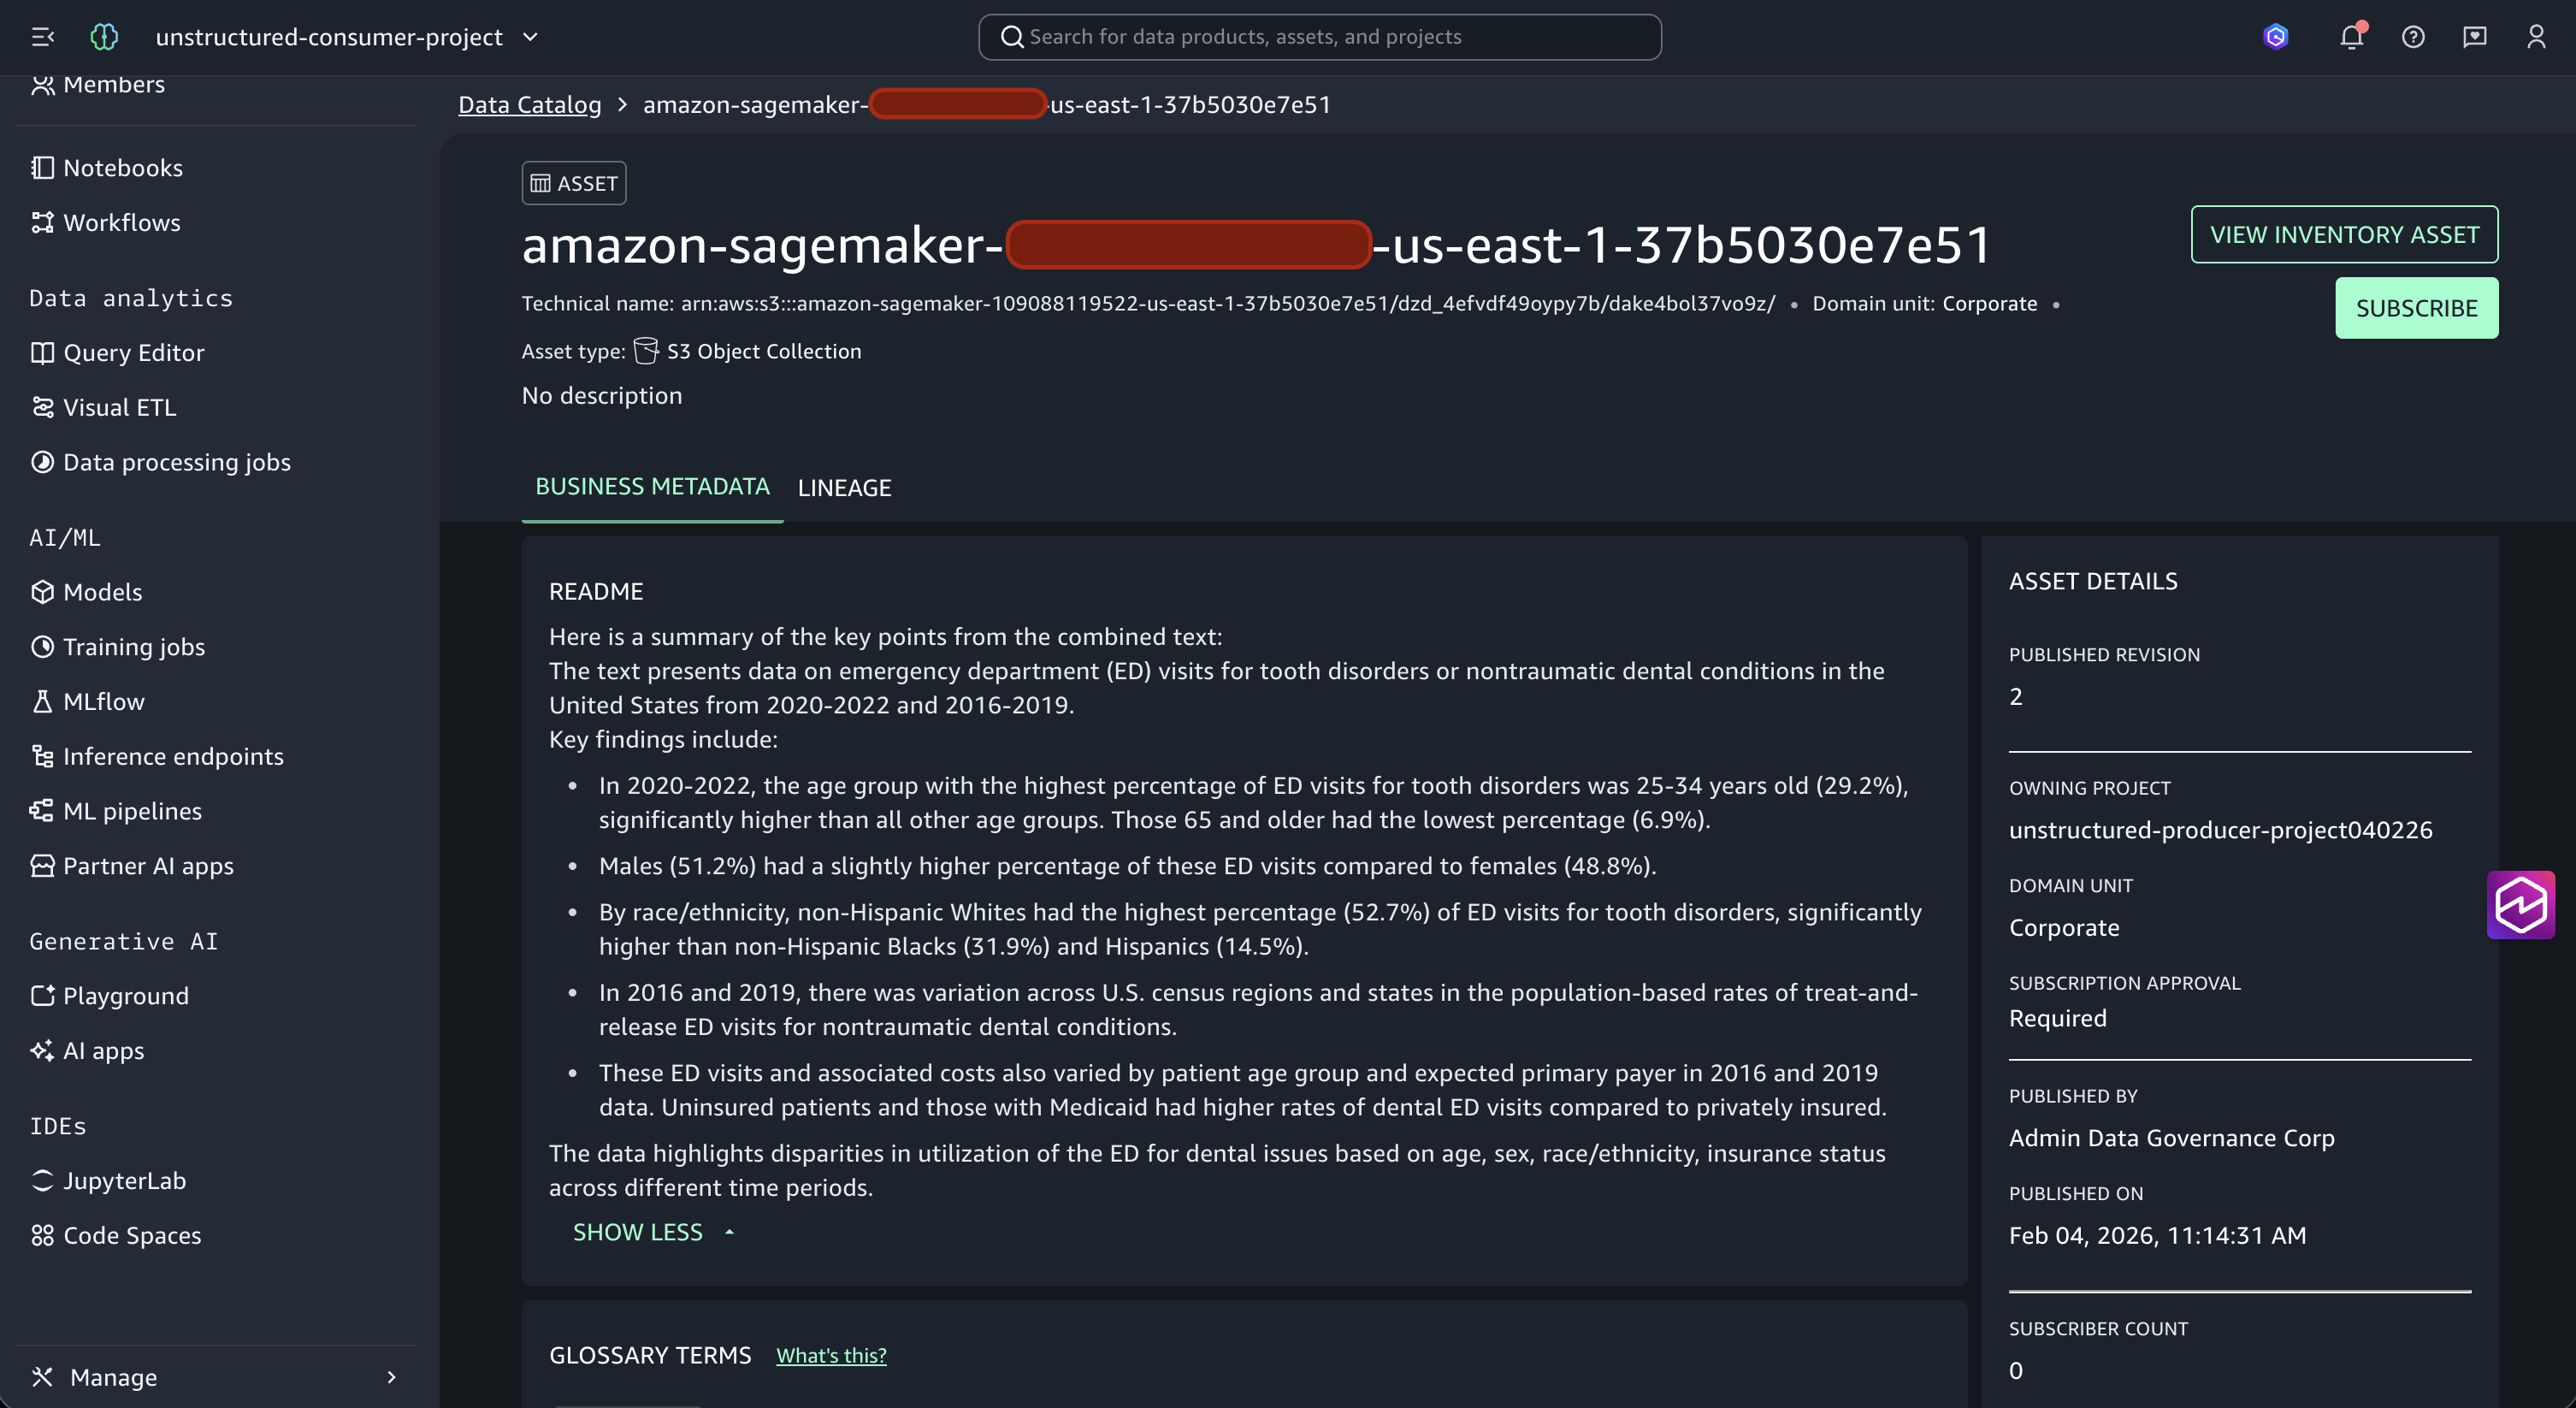
emergency,该关键词在发布期间已添加到 README 文件。搜索会返回生产者在第 1 部分中发布的丰富后资产。 图 2:emergency 关键词的目录搜索结果 - 从结果中选择该资产以查看其详情,包括 AI 生成的业务元数据、词汇表术语和 README 内容。然后选择 Subscribe。 图 3:带有 AI 生成元数据和 Subscribe 选项的资产详情
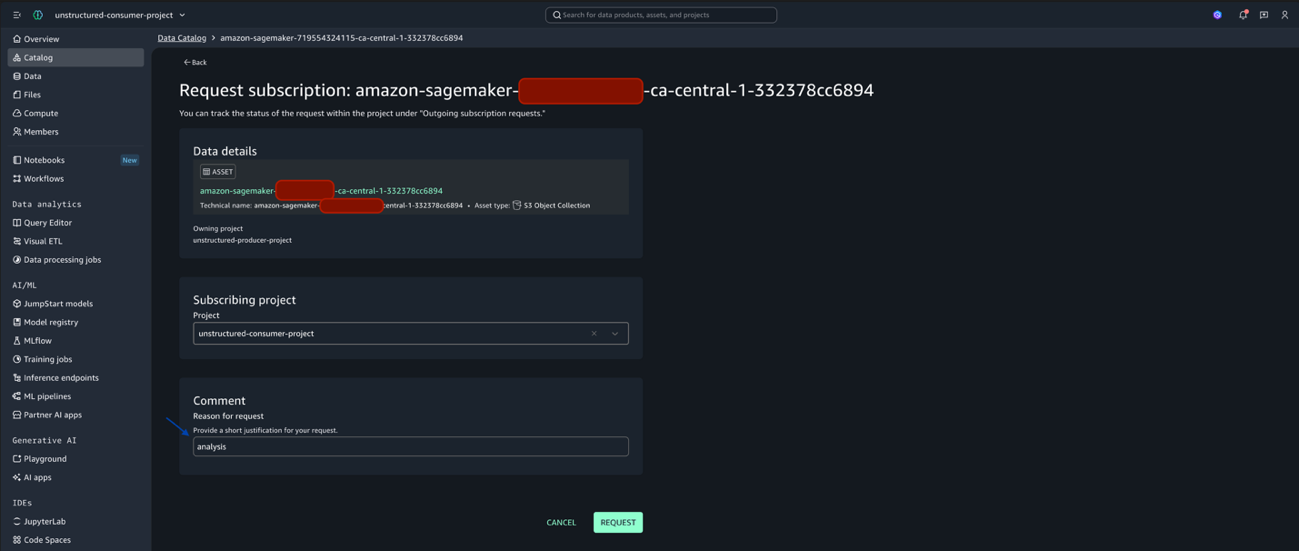
- 在
Comment部分的 Reason for request 中输入 analysis,然后选择 Request。 图 4:已输入请求原因的订阅请求 - 重新登录生产者项目(
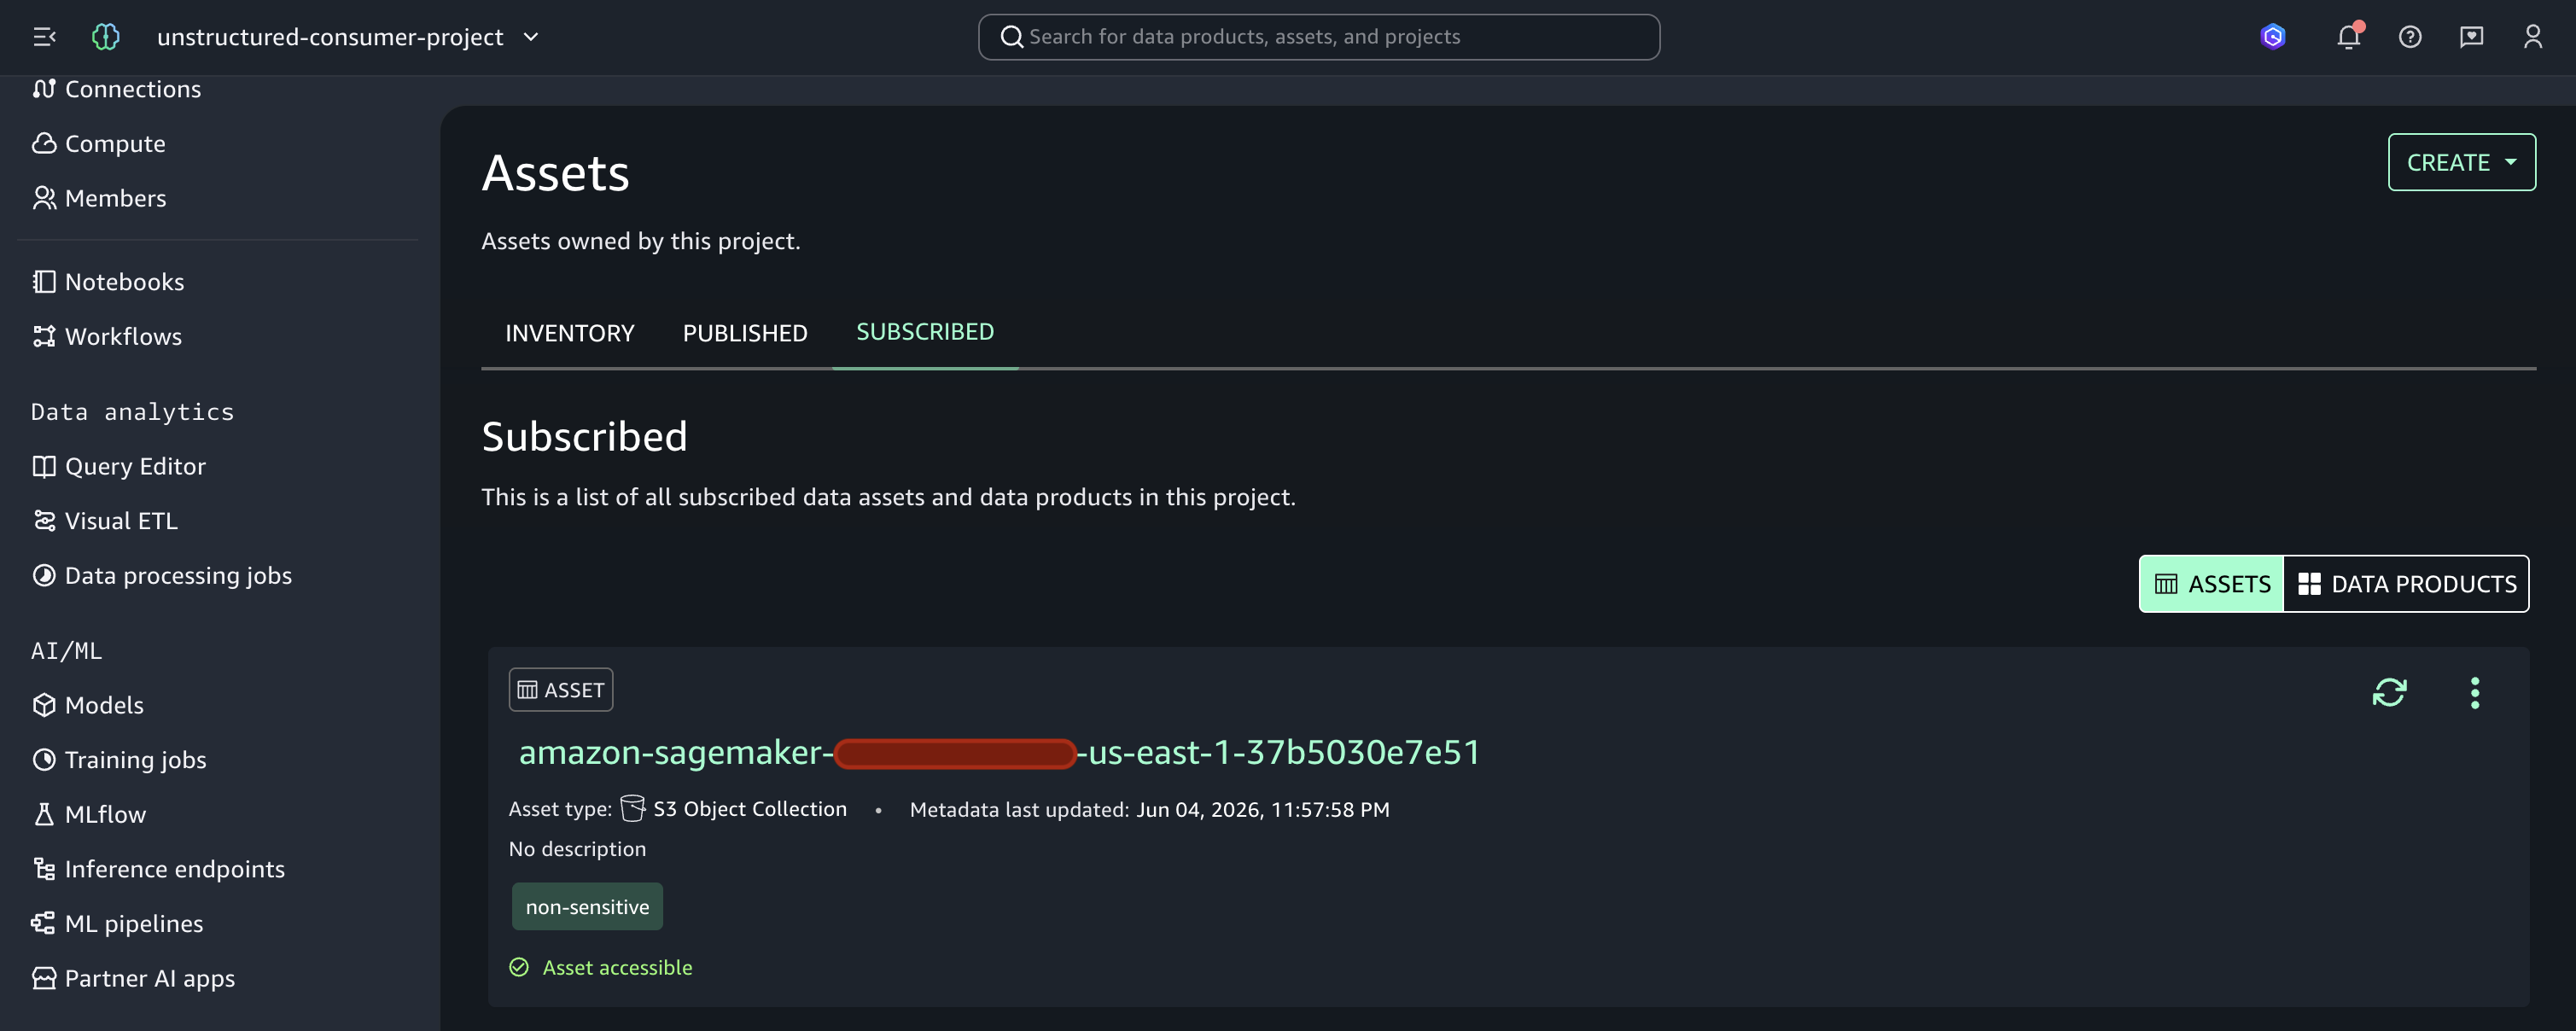
unstructured-producer-project)以批准订阅请求。 - 批准后,返回消费者项目并确认已订阅的资产现在显示在 Manage、Assets、Subscribed assets 下。 图 5:Subscribed assets 选项卡下已批准的订阅
订阅获批后,你现在可以通过两种方法访问丰富后的非结构化数据。
选项 1: 作为数据或业务分析师,你可以使用 Amazon Bedrock 聊天代理应用进行自然语言查询。
选项 2: 作为应用程序工程师,你可以使用 Amazon Bedrock 模型推理进行程序化自然语言查询。
让我们探讨这两种选项。
选项 1:Amazon Bedrock 聊天代理应用
Amazon Bedrock 聊天代理应用为您提供一个无代码的对话界面,让您使用自然语言查询已丰富化的非结构化数据。作为数据分析师或业务用户,您可以用简单的英语提问。您得到的答案基于您的组织已摄取的文件,而无需编写任何代码。对于生产工作负载,尤其是在医疗保健等敏感领域,您可以应用 Amazon Bedrock Guardrails 为您的模型响应添加内容筛选和接地验证。
数据科学家和应用工程师还可以通过将聊天代理应用 API 集成到自定义应用程序中来扩展这些功能,以便用户能够以编程方式与非结构化的 Amazon S3 数据进行交互。
要在您订阅的数据集上设置 Amazon Bedrock 聊天代理应用,请完成以下步骤。
先决条件: 添加 S3 数据位置。
在创建聊天代理应用之前,您需要将订阅数据的 S3 位置添加为项目中的注册位置。
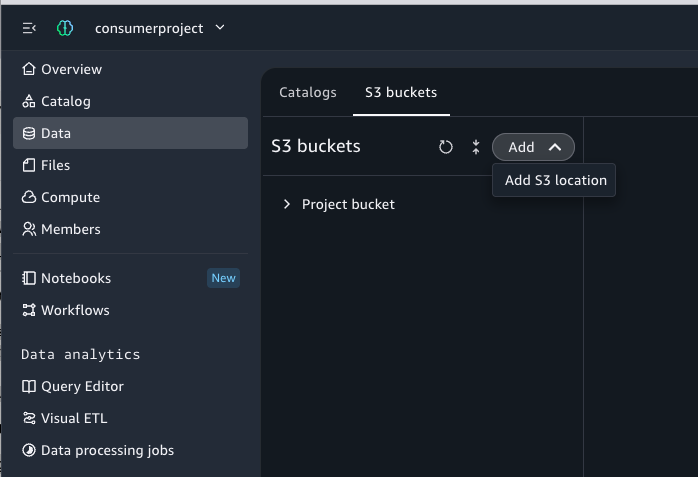
- 选择 Data 选项卡,位于 Overview 中。
- 选择 S3 存储桶,然后选择 Add 以添加 S3 位置。 图 6:从 Data 选项卡添加 S3 位置
- 添加名称:
producerprojectdata。 - 将生产者的 S3 路径添加为新的 S3 位置:
s3://amzn-sagemaker-bucket-<domain-id>-<project-id>/medical/。
注意: 您可以从订阅资产的技术名称中获取 S3 位置详细信息。
- 选择 AWS 区域,然后选择 Add data 将此添加为新位置。
注意: 请确保您选择的 AWS 区域支持本文后续使用的 Amazon Bedrock 基础模型。有关按区域提供的模型列表,请参阅 Supported Regions and models for Amazon Bedrock。
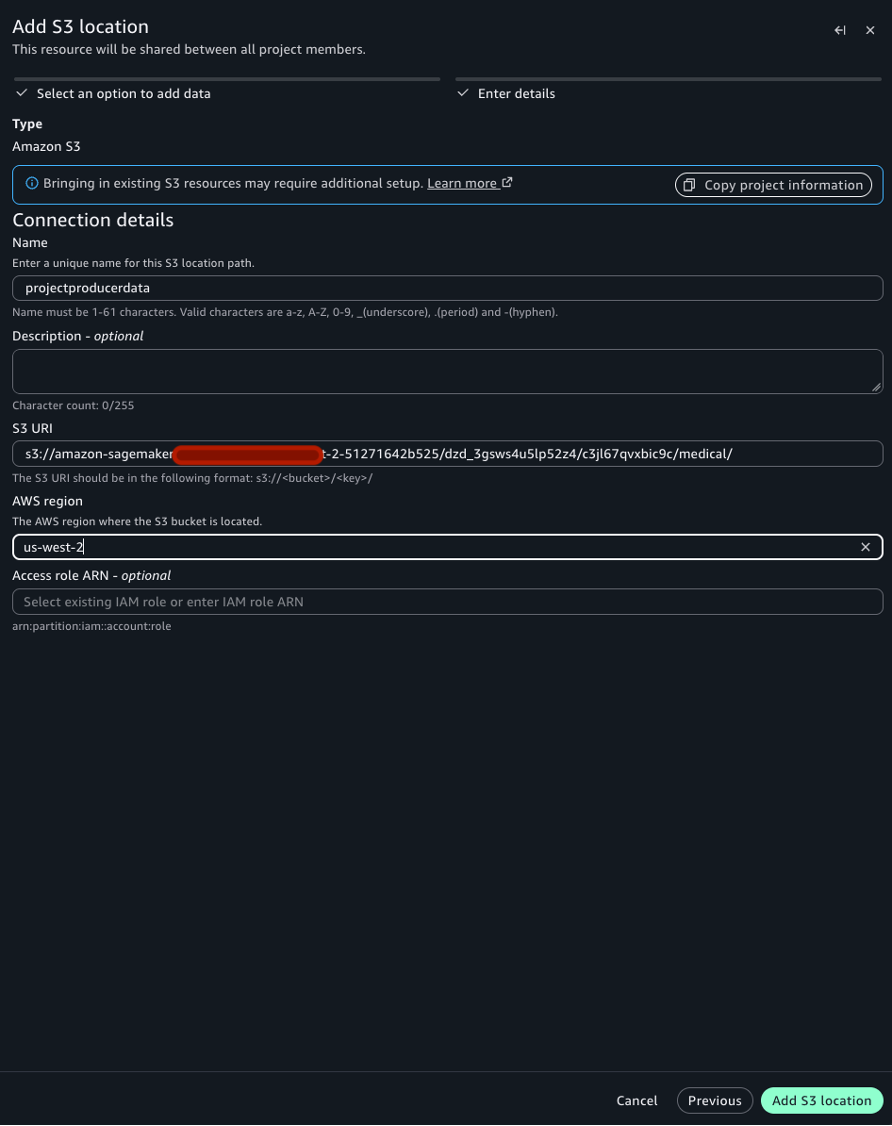
图 7:S3 位置详细信息和 AWS 区域选择
注意: 请确保仅选择 S3 路径中用作数据源的 PDF 文件。
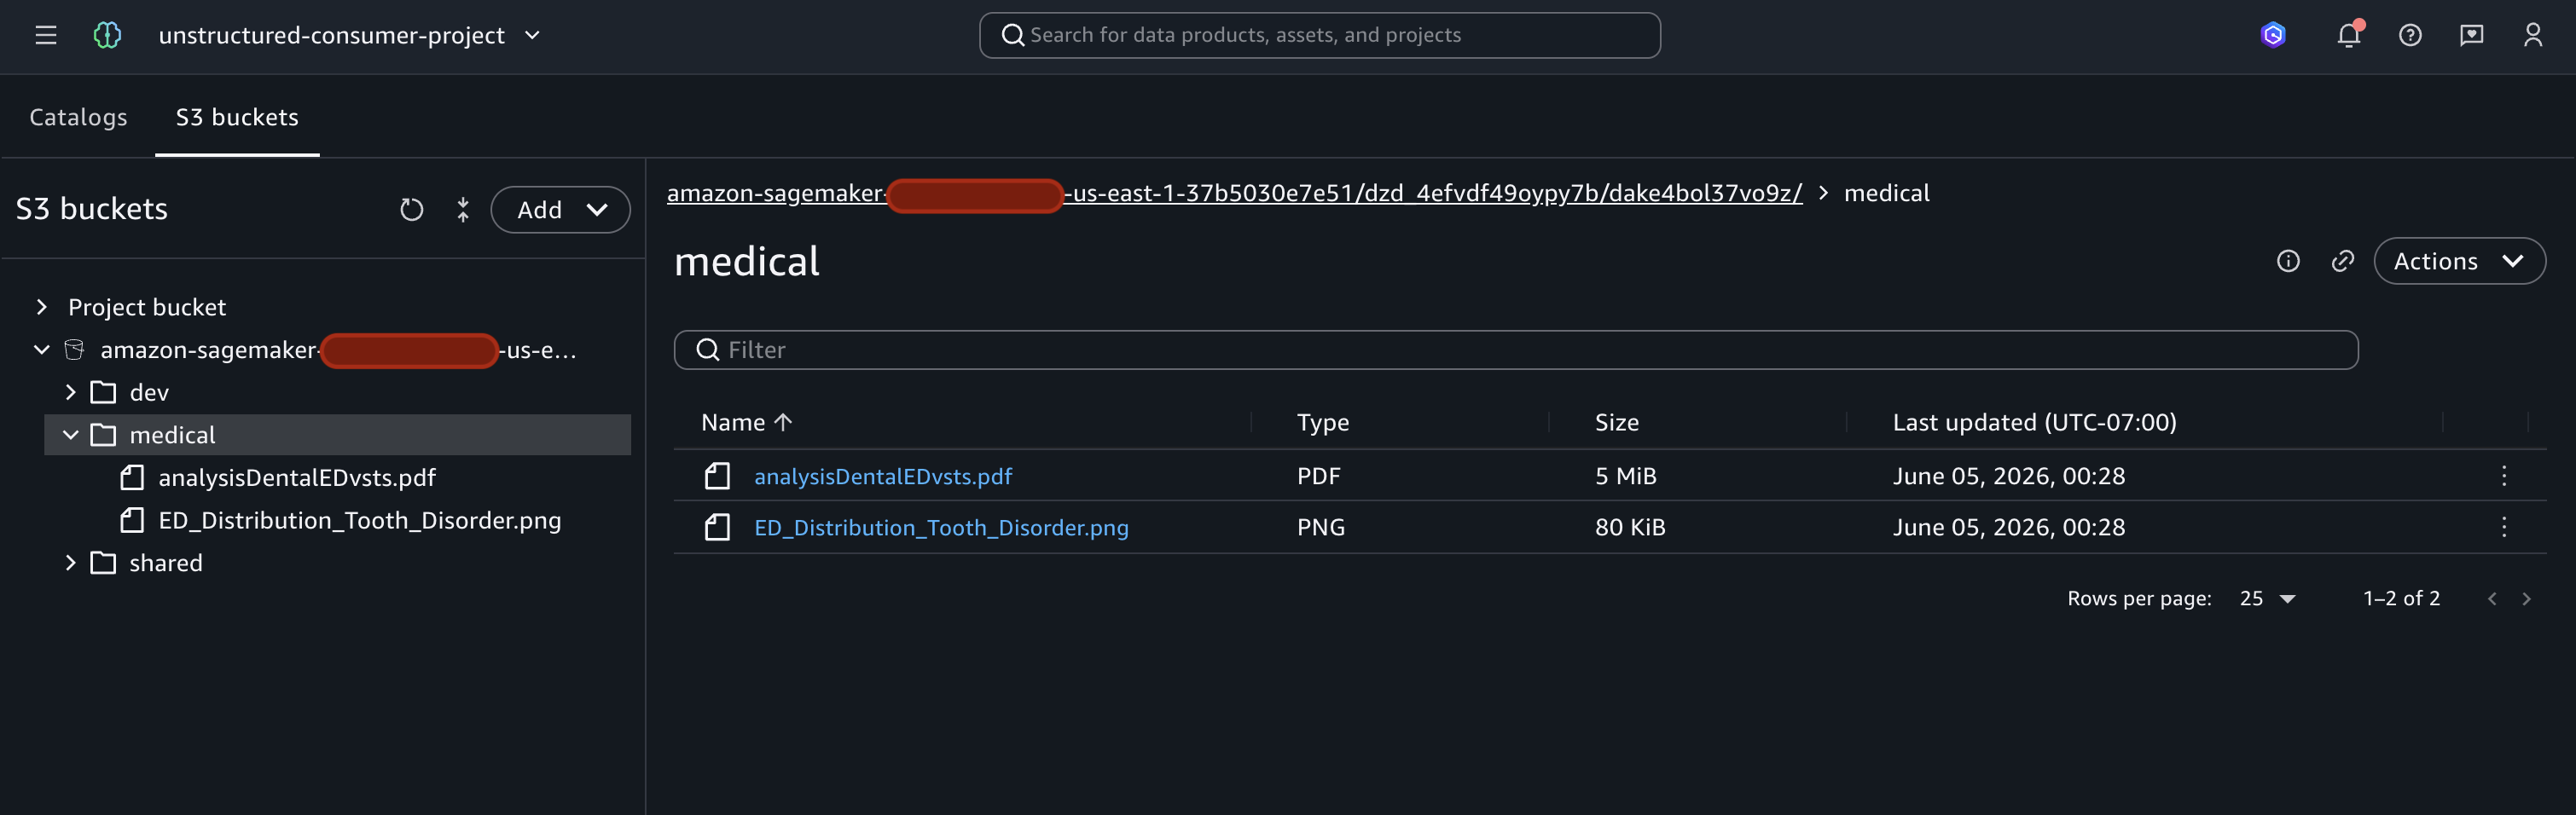
图 8:选择 PDF 文件作为数据源
添加位置后,在 AI Apps 中创建知识库时,它会显示为可选择的 S3 位置。
完成以下步骤以配置聊天代理应用:
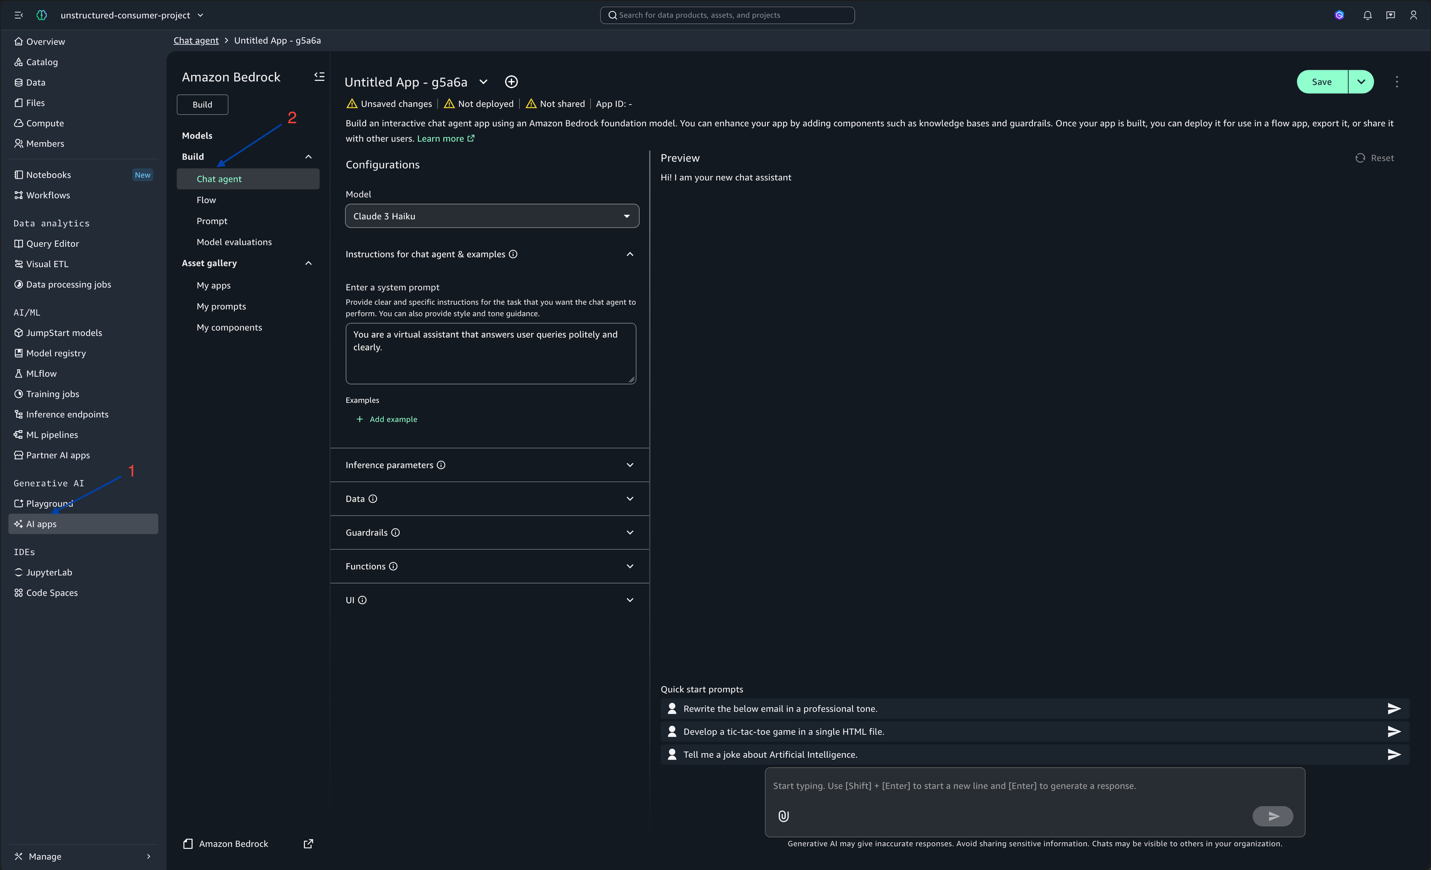
- 在左侧导航窗格中,位于 Generative AI 下,选择 AI Apps。
- 在页面的 Build 部分中,选择 Chat agent。 图 9:在 AI Apps Build 部分中选择 Chat agent
- 添加名称:
MedicalKB。 - 添加描述:
Knowledge base built from subscribed medical S3 data assets. Contains medical documents used to provide grounded, context-aware responses to medical domain queries. - 选择数据源。您将看到在上一步中添加的 S3 存储桶。
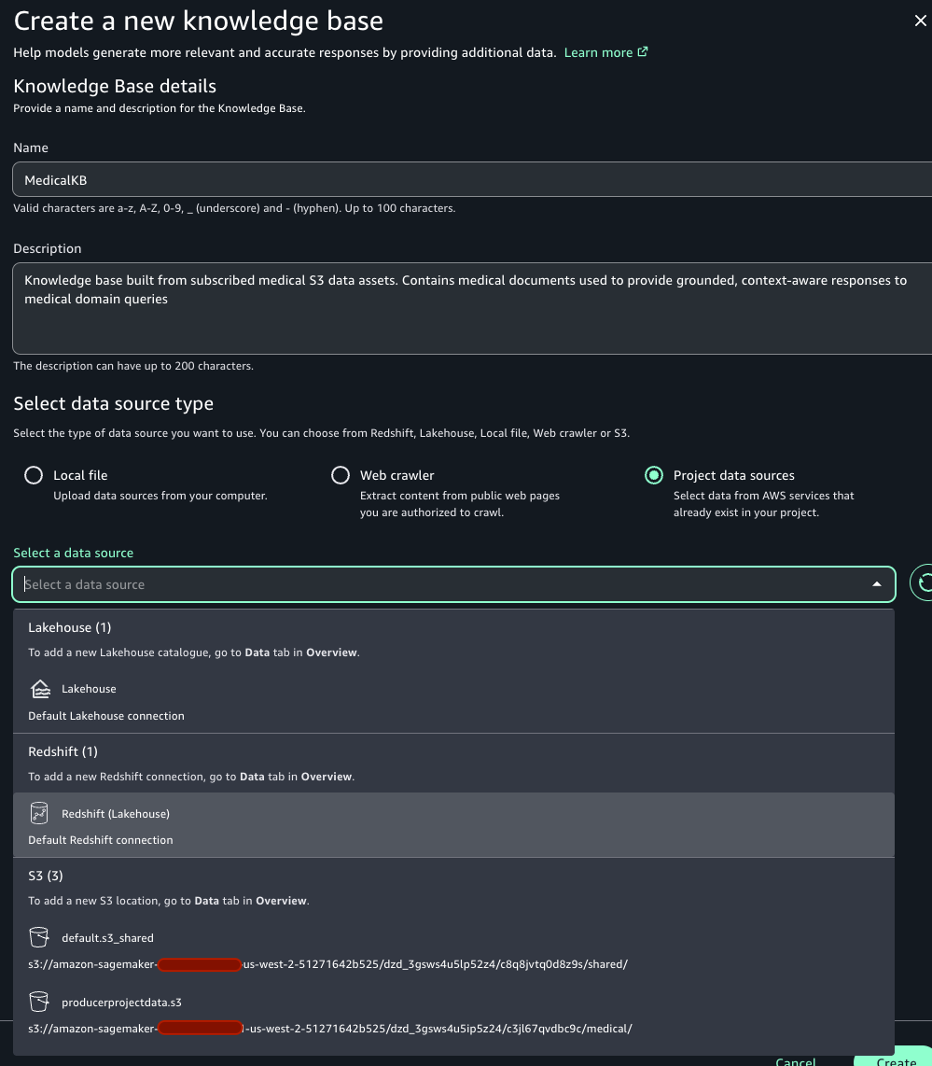
图 10:从 S3 数据源创建 MedicalKB 知识库
选择您的嵌入模型。您可以保留默认设置并选择 Create。创建知识库可能需要 10–15 分钟,具体取决于文件大小。创建知识库后,在 Chat agent 页面上:
- 从 Model 菜单中选择您偏好的模型(您可以根据需要切换不同的大型语言模型)。
- 在 Data 下,选择您已发布的 S3 存储桶作为知识库。
- 通过在 Enter prompt 字段中输入问题开始与代理交互。
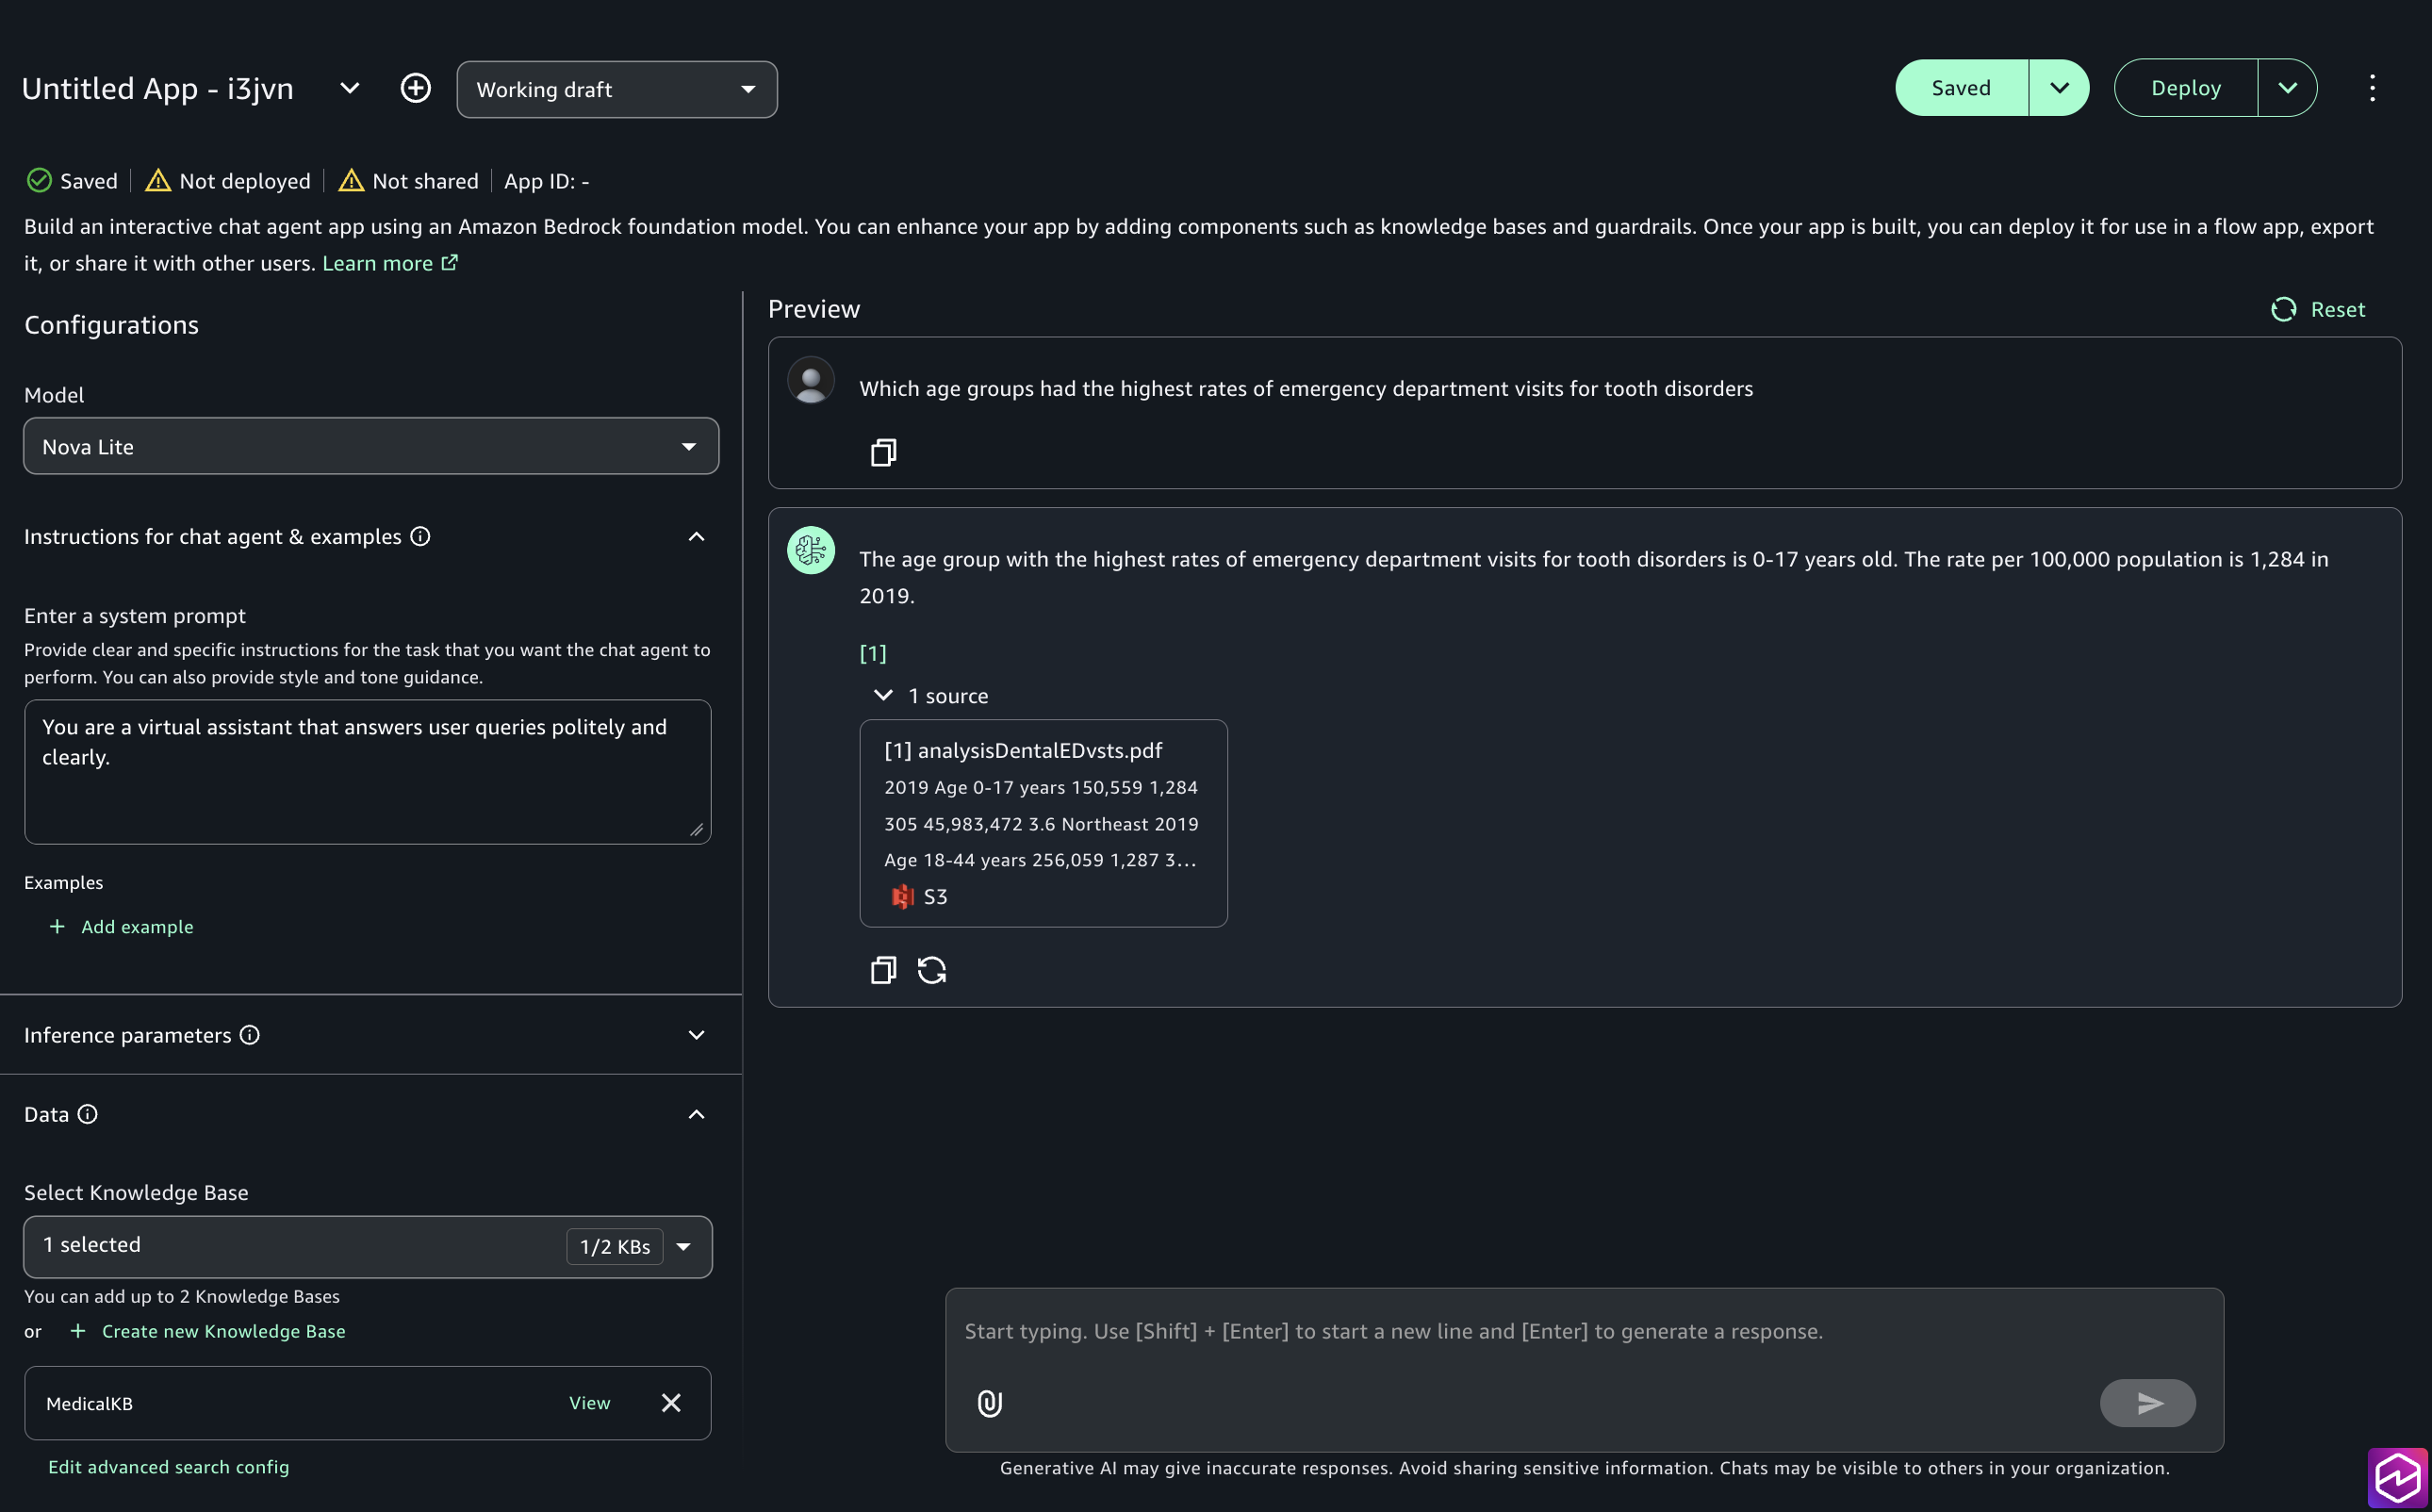
图 11:已选择模型和知识库的 Chat agent 页面
例如,输入“Which age groups had the highest rates of emergency department visits for tooth disorders?”会返回一个基于第 1 部分中发布的丰富化牙科数据集的答案。
聊天代理使用丰富化的 README 元数据以及底层文件来呈现上下文相关的答案。分析师可以探索非结构化内容,而无需知道数据存储在何处或其结构如何。
选项 2:使用 Amazon Bedrock 模型推理进行自然语言查询
此选项演示如何使用 Amazon Bedrock 模型推理以自然语言查询订阅数据。您可以将此功能与外部聊天应用程序集成,以便用户能够通过 Amazon Bedrock 运行自然语言查询。
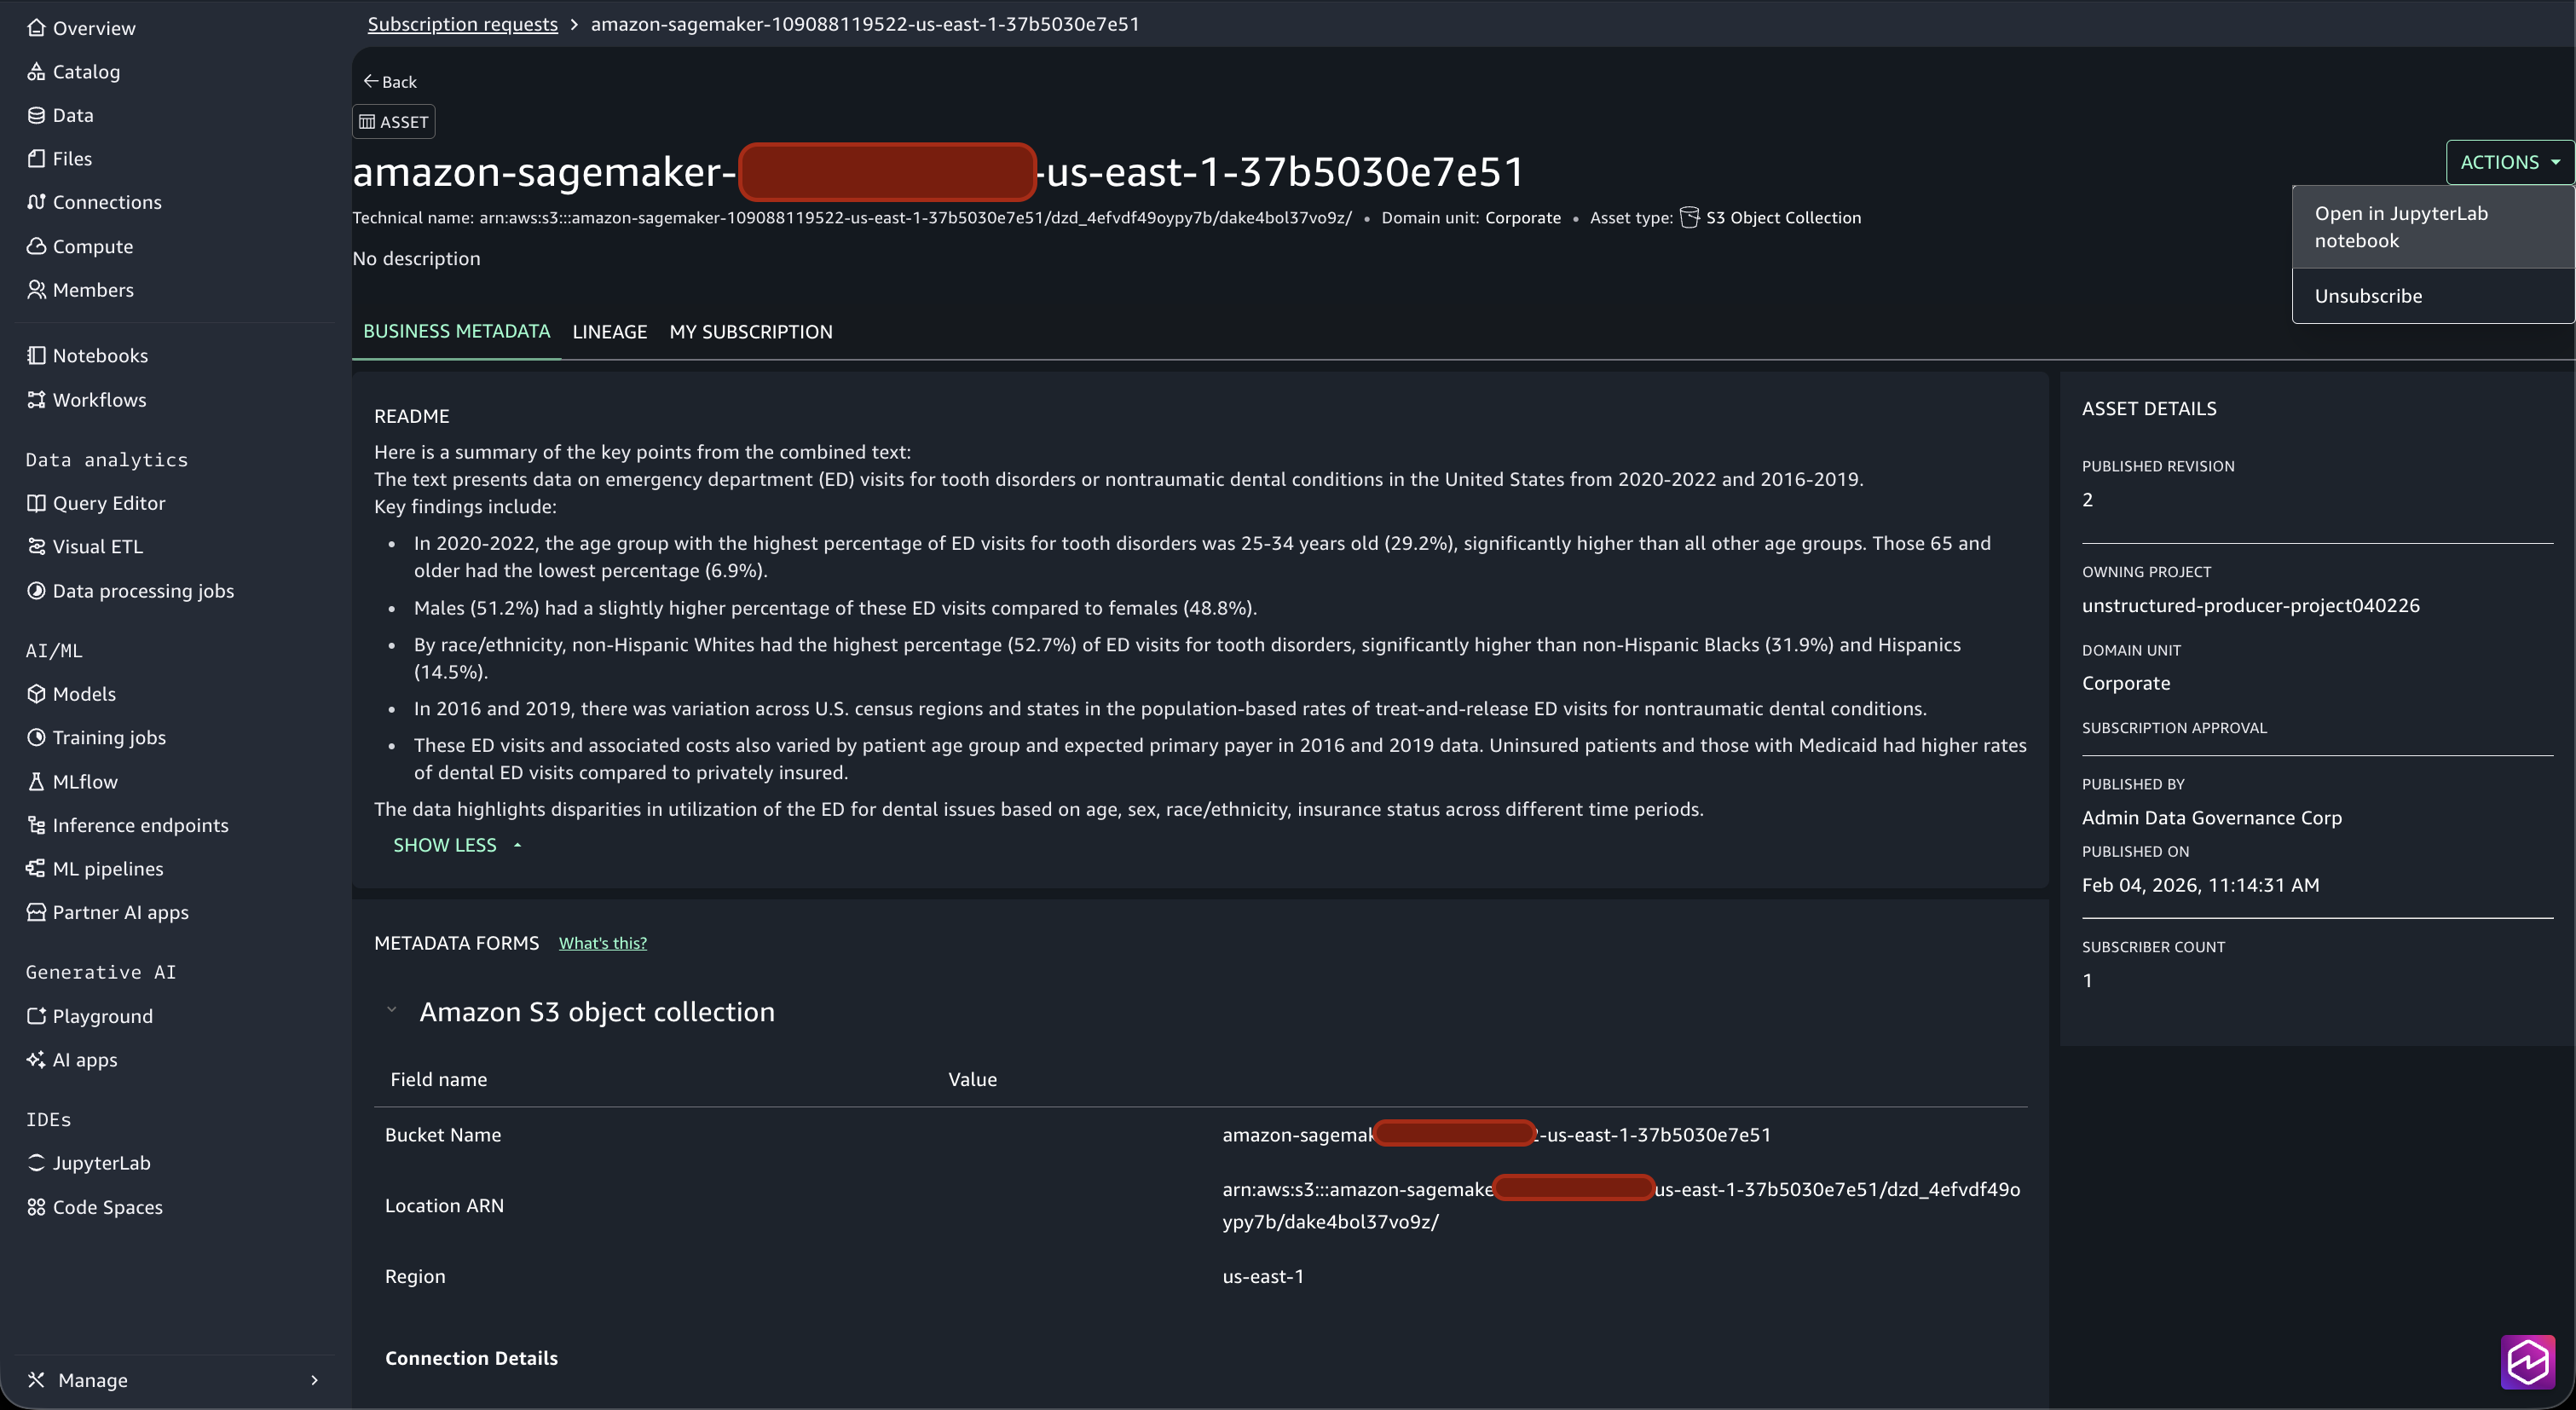
- 在您的消费者项目中,从左侧导航窗格底部选择 Manage、Assets。在 Subscribed 选项卡上,选择您订阅的 S3 资产。在 Actions 下,选择 Open JupyterLab notebook。 图 12:从订阅资产打开 JupyterLab notebook
- 这将打开 JupyterLab notebook 环境。上传
s3_document_consumer_v2.ipynbnotebook 并运行所有单元格。您可以从 s3_document_consumer_v2.ipynb 下载该 notebook。注意: 项目角色需要 Amazon S3、Amazon Textract 和 Amazon Bedrock 的权限。如果您已按照第 1 部分操作,您可能已经附加了这些策略。有关所需策略和指导的详细信息,请参阅 prerequisites in Part 1。 - 查看 notebook 单元格。 图 13:notebook 中由 Amazon Bedrock 回答的示例问题 在最后一个单元格中,您会找到一个由 Amazon Bedrock 回答的示例问题:“Which primary payer types (Medicare, Medicaid, private insurance, and so on) account for the highest proportion of dental-related emergency department visits?”Amazon Bedrock 针对 S3 存储桶中的丰富化内容处理该问题,并返回一个基于有据可依的答案。您可以将此示例问题替换为与您的文档相关的任何查询。
Amazon Bedrock 模型推理方法为您提供编程控制,从而可以将自然语言查询能力直接嵌入到您现有的数据应用程序和商业智能工具中。
清理
为避免持续产生费用,请务必在完成演练后立即删除本解决方案中使用的资源。主要费用来源是 SageMaker Unified Studio 笔记本实例、Amazon Bedrock 模型推理调用和 Amazon S3 存储。
- 关闭正在运行的笔记本。
- 停止正在运行的笔记本实例。
- 关闭未使用的内核。
注意: 正在运行的笔记本实例即使未使用也会继续产生费用。
清理 Amazon S3 存储:
- 删除处理过程中创建的临时文件。
- 移除不再需要的已上传测试文档。
注意: 尽管 Amazon S3 费用很低,但大量数据可能会累积产生可观的费用,因此最好删除不需要的数据。
结论
在这篇博文中,您了解了如何消费和查询本系列 第 1 部分 中发布的丰富非结构化数据资产。通过 Amazon SageMaker Catalog 发布-订阅模型订阅资产,您可以发现、访问您组织的非结构化数据并与之交互,无论是通过无代码聊天代理还是 Amazon Bedrock 模型推理。
本系列的两部分共同向您展示了如何构建一条全面的管道,将原始非结构化文档转换为受治理、可查询的知识资产。Amazon Textract 用于提取、Amazon Bedrock 用于智能摘要和 NLQ,以及 Amazon SageMaker Catalog 用于治理和可发现性,这些组合意味着您的团队可以专注于提取业务洞察,而不是管理基础设施。
要继续您的 Amazon SageMaker 之旅,请参阅以下资源:
- 浏览 Amazon SageMaker 开发人员指南。
- 在 Amazon SageMaker Unified Studio 文档 中查找完整的设置指南。
- 通过 Amazon SageMaker Unified Studio 控制台 开始使用这些新集成。
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏