Metabase 用 GROUPING SETS 加速透视表
有效阅读仅保存在当前浏览器,用于「为你」推荐;暂停或清除记录。
DataHot 速览
Metabase 64 对透视表进行了重大升级:此前计算行、列和总计会向数据库发送多条查询,两个分组字段可能跑 4 条查询,五个字段最多可达 32 条。新实现利用多数现代数仓支持的 SQL GROUPING SETS,将整个透视表合并为单条查询。官方基准中通常快 2–3 倍,并保证明细与总计一致;文章还讨论了行数上限保护和不同 SQL 方言的兼容问题。
为什么值得关注:介绍 BI 透视表查询从多查询改为 GROUPING SETS 单查询的工程实践,涉及性能、结果一致性和方言兼容,对 BI 与数仓从业者有直接参考价值。
译文
AI 逐段翻译我们受够了等待透视表加载,所以我们让它们变得更快了。
以前,透视表在 Metabase 中可能很慢,而且实现需要复杂的逻辑来保持结果一致。Metabase 会向数据库发送单独的查询来计算行、列和总计。这意味着一个有两个分组字段的透视表可能运行四个查询,一个有五个字段的透视表最多可能运行 32 个查询。
这种方法有两个代价。显而易见的代价是速度,因为这么多次往返数据库需要时间。但行数限制也会影响结果。Metabase 会限制查询可以返回的行数,当这个限制影响到透视表的某些查询但不影响其他查询时,我们就必须处理这些不一致,以使结果保持一致。
在Metabase 64中,我们发布了对透视表的重大升级。现在 Metabase 可以转而要求数据库使用大多数现代数据仓库都支持的标准 SQL 特性(GROUPING SETS)在单个查询中计算整个透视表。结果是相同的透视表,但在我们的基准测试中通常快 2–3 倍,并且明细和总计保证一致。
本文深入探讨新方法的细节:透视查询如何在 Metabase 的查询处理器(QP)中表示,旧路径和新路径各自生成的 SQL,行数限制保护机制如何工作,以及我们在推出新路径时遇到的方言怪癖。
什么是透视查询?
透视表将一组行维度与一组列维度交叉,并在单元格中显示一个或多个聚合的度量。前端可以请求沿行轴和列轴的小计,以及总计。
具体来说,以下查询是一个具有一个度量(count)的双分组透视表。该查询是使用 Metabase 的 MBQL 库编写的一系列 Clojure 函数调用。Metabase 使用 MBQL 来构造通过图形查询构建器的透视设置创建的查询,然后再编译该查询。
(-> (lib/query metadata-provider accounts) ;; accounts refers to the Accounts table
    (lib/breakout source)                  ;; breakout 0 refers to the Source column
    (lib/breakout plan)                    ;; breakout 1 refers to the Plan column
    (lib/aggregate (lib/count))            ;; create the Count aggregation
    (lib.pivot/with-pivot {:rows               [source-id]
                           :columns            [plan-id]
                           :show-row-totals    true
                           :show-column-totals true}))
列在:rows下的分组会成为透视表中的行标题。列在:columns下的分组会成为列标题。聚合填充每个交叉单元格(在本例中,聚合是count)。
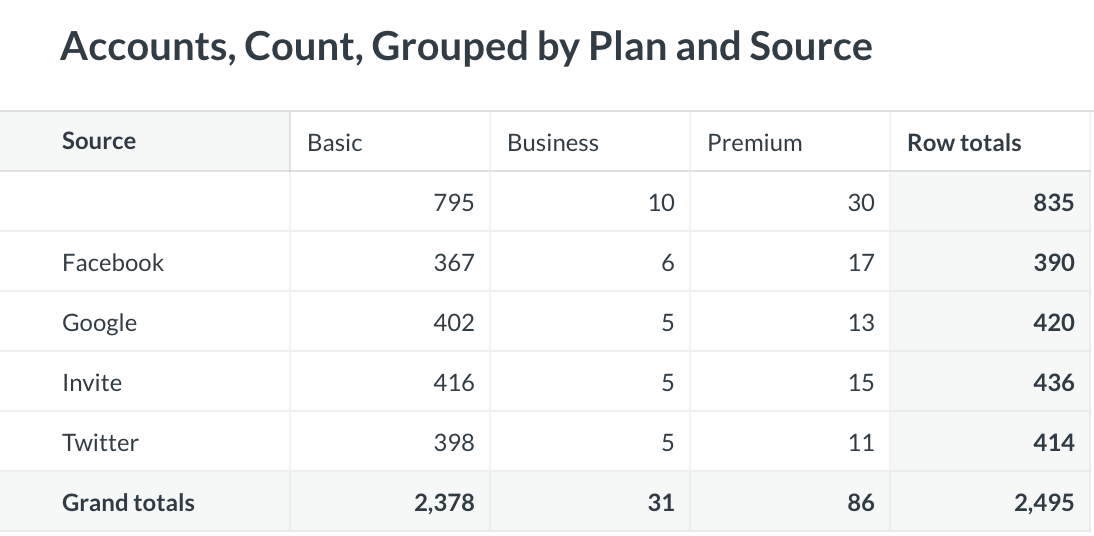
给定两个分组且两个总计都开启,透视渲染器需要四个结果集:
| 位(pivot-grouping) | 分组集 | 它提供什么 |
|---|---|---|
00 = 0 | (source, plan) | 明细单元格 |
01 = 1 | (plan) | 按 plan 的列小计(底行) |
10 = 2 | (source) | 按 source 的行小计(右列) |
11 = 3 | () | 总计(右下角) |
这个pivot-grouping列携带位掩码:每个分组一位,当该分组在此行中被聚合掉时置位。前端使用它来决定每一行在透视表中的位置。
旧的多查询路径
历史上,run-pivot-query为透视表分组的每个子集生成一个子查询,分别对数据库运行它们,然后在应用层将结果拼接在一起。对于我们这个双分组示例,这意味着四个子查询,上表中的每一行对应一个:
-- subquery #1: bitmask 0, detail rows — no columns dropped
SELECT source,         plan,         0 AS "pivot-grouping", COUNT(*) AS count
FROM accounts GROUP BY source, plan;

-- subquery #2: bitmask 1, per-plan column subtotals — source dropped
SELECT NULL AS source, plan,         1 AS "pivot-grouping", COUNT(*) AS count
FROM accounts GROUP BY plan;

-- subquery #3: bitmask 2, per-source row subtotals — plan dropped
SELECT source,         NULL AS plan, 2 AS "pivot-grouping", COUNT(*) AS count
FROM accounts GROUP BY source;

-- subquery #4: bitmask 3, grand total — both dropped
SELECT NULL AS source, NULL AS plan, 3 AS "pivot-grouping", COUNT(*) AS count
FROM accounts;
每个小计级别都是一次独立往返数据仓库:我们的双分组示例需要四次,而五分组透视表最多需要 32 次。
我们包含NULL AS <column>和<n> AS "pivot-grouping"部分仅用于说明,因为前端期望所有四个子查询具有统一的行形状:[source, plan, pivot-grouping, count]。真实的子查询会省略被丢弃的列,而查询构建器则会将常量位掩码和缺失的NULL值拼接到每一行中。
行数限制的复杂性
Metabase 对聚合查询应用默认的:max-results上限(10000)。如果天真地将这个上限应用于每个透视子查询,结果可能会彼此不一致。例如,明细子查询可能触及上限并丢弃一些行,而小计子查询仍然会计入这些行。当这些计数不一致时,人们会看到小计加不起来。
旧的多查询路径通过短路来处理这一点:如果第一个(明细级)子查询被:max-results截断,则完全跳过剩余的小计子查询,并设置:pivot_rows_truncated。因此前端要么得到完整的透视表,要么得到被截断的明细、没有小计并带有警告(这样 Metabase 就不会显示不正确数据)。
然而,使用新的原生路径,我们能够完全去掉整个检测并跳过的机制。
使用 GROUPING SETS 的原生路径
GROUPING SETS是GROUP BY的扩展,属于 SQL 标准的一部分。它允许一个查询同时聚合多个分组。你列出要分组的每一组列,数据库就会在单个结果中返回所有这些分组。这与你从多个独立UNION ALL的GROUP BY查询中得到的是相同的行。在每一行中,不属于该行分组的列会以NULL返回。ROLLUP和CUBE是常见分组集模式的简写。
我们本可以通过UNION ALL来绕过行数上限问题。只需运行四个子查询,将它们联合起来,并把结果包装在一个带有单个LIMIT的外层查询中。但那样数据库仍然会对accounts运行四个独立的聚合。
然而,使用GROUPING SETS,我们可以让数据库的查询规划器在一次事实表扫描中计算所有四个小计级别。它的GROUPING()函数还直接交给我们pivot-grouping位掩码(而不是需要为每个分支硬编码常量)。
对于上面的双分组示例,原生路径编译为:
SELECT
  accounts.source,
  accounts.plan,
  GROUPING(accounts.plan, accounts.source) AS "pivot-grouping",
  COUNT(*) AS count
FROM accounts
GROUP BY GROUPING SETS (
  (accounts.source, accounts.plan),  -- detail
  (accounts.plan),                   -- column subtotal
  (accounts.source),                 -- row subtotal
  ()                                 -- grand total
)
ORDER BY
  GROUPING(accounts.plan, accounts.source) ASC,
  accounts.source ASC,
  accounts.plan ASC;
这个GROUPING()函数用其小计级别标记每一行。其位顺序与 Metabase 的pivot-grouping约定相反,因此编译器会翻转参数列表。
这个ORDER BY子句先对明细行排序,最后对总计排序,因此如果行数上限使结果被截断,透视表会丢失末尾的总计,而不是显示零散的缺失单元格。这也意味着我们不必担心数据库返回行的顺序。
最后,并非所有数据库都使用相同的 GROUPING() 函数:有些称其为 GROUPING_ID(),还有些一次只接受一个参数。每个驱动程序的小型覆盖可将这些差异集中在一处。
原生路径的优势与局限
新的原生路径有明显的优势:
- 性能提升:一次共享扫描。
GROUPING SETS让数据库对事实表进行一次遍历即可计算所有小计层级。每个针对透视式工作负载调优过的数据仓库都知道如何做到这一点。 - 结果一致。 明细和总计来自同一查询,因此任何截断都会同时作用于两者。
- 更易于检查和调试。 整个计算就是一条 SQL 语句。你可以把它复制到数据库客户端中运行、
EXPLAIN它,或追踪某个特定小计是如何产生的。
然而,也有几点局限值得注意:
- 并非所有数据库都支持
GROUPING SETS。:native-pivot-tables控制该特性。数据库驱动必须继承自:sql,且其方言必须接受GROUP BY GROUPING SETS。这涵盖了大多数分析型数据仓库,但 MySQL(仅提供WITH ROLLUP)和 SQLite(完全不支持)仍走多查询路径。 - 不支持窗口函数聚合。
:offset、:cum-count和:cum-sum根据结果集中的其他行计算每一行的值(如累计总计、偏移量等)。在GROUPING SETS输出上计算会包含小计行,这并不合理。
后续计划
有些透视表仍无法使用 GROUPING SETS:MySQL 或 SQLite 上的任何场景,以及使用窗口函数聚合的查询。之前的 UNION ALL 折中方案对这些场景仍然有效:它无需数据仓库规划共享扫描,即可弥补往返和行数上限的差距。
MongoDB 则完全是另一回事。其聚合管道可以表达同样的“一次查询实现多个分组层级”的思路,但使用的是 $facet 而非 SQL。这需要单独的工程工作,因此 MongoDB 在 v64 中仍走多查询路径。
试用更快的透视表
单查询透视表已在 Metabase 64 中发布。
当满足两个条件时才会选择原生路径:MB_USE_NATIVE_PIVOT_TABLES 设置为开启(在 v64 中默认为关闭,直到它在足够多的真实安装环境中得到验证),并且 驱动程序声明了 :native-pivot-tables 特性。如果任一条件不满足,Metabase 会回退到多查询路径。
在自托管环境中开启: 升级到 Metabase 64,设置此环境变量,然后重启 Metabase:
MB_USE_NATIVE_PIVOT_TABLES=true
如果你运行的是 JAR:
MB_USE_NATIVE_PIVOT_TABLES=true java -jar metabase.jar
如果你运行的是 Docker:
docker run -d -p 3000:3000 \
  -e MB_USE_NATIVE_PIVOT_TABLES=true \
  --name metabase metabase/metabase:latest
在 Metabase Cloud 中开启: 联系支持,我们会为你开启。
一旦开启,受支持数据库(PostgreSQL、Redshift、Snowflake、BigQuery、Oracle、SQL Server、Presto、Starburst、Vertica、Athena、ClickHouse、Druid,以及 Hive 系列驱动程序 Spark SQL、Databricks)上的透视表会自动切换到单查询路径。其他所有内容都保持原有的工作方式。你无需更改任何问题或仪表板。
告诉我们进展如何。如果你的透视表变快了(或者有什么看起来不对劲),在 GitHub 上提交 issue 或在 论坛 发帖。来自真实环境的报告正是它成为默认特性的途径。
更多来自 Metabase 工程团队
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏