实验:dbt 项目对 AI Agent 究竟值多少
DataHot 速览
Fivetran 作者用同 4 张零售演示表向两个 AI Agent 提同一个问题(总营收是多少),Haiku 直接对明细行求和,Opus 先看订单表剔除了已取消订单并注明,两者给出自信却不同的答案。作者因此对比了 5 种接入同一 dbt 项目的方式,发现要求 Haiku 先读 dbt 文档后,其 join 问题的错误答案从 4 个降到 0 个;Semantic Layer 是唯一让两个模型都做到 0 错、且每个可信答案成本最低的接口。结论是对话式分析中,受治理的数据访问方式可能与模型本身同样重要。
为什么值得关注:用可量化的对照实验说明 Semantic Layer 相比裸 SQL 在准确率与成本上的价值,为 Data Agent/ChatBI 选型提供了直接依据。
本文目录 8 节
译文
AI 逐段翻译我让 2 个 AI 智能体 针对同样的 4 张演示零售表回答同一个问题:总收入是多少?运行 Haiku 的那个对行项目求和。运行 Opus 的那个先查看订单,发现有些被取消了,将它们排除在外,并在备注中说明了这一点。分析师可能会在回答前先问取消的订单是否计入,但两个智能体都没有这样做。这就是 1 轮对话中的会话式分析:一个用平实语言提出的问题,2 个自信的答案,而界面中没有任何东西说明适用哪条业务规则。
我想知道为什么这 2 个智能体在同一个问题上产生分歧,以及是否有任何 dbt 界面能够弥合这一差距。
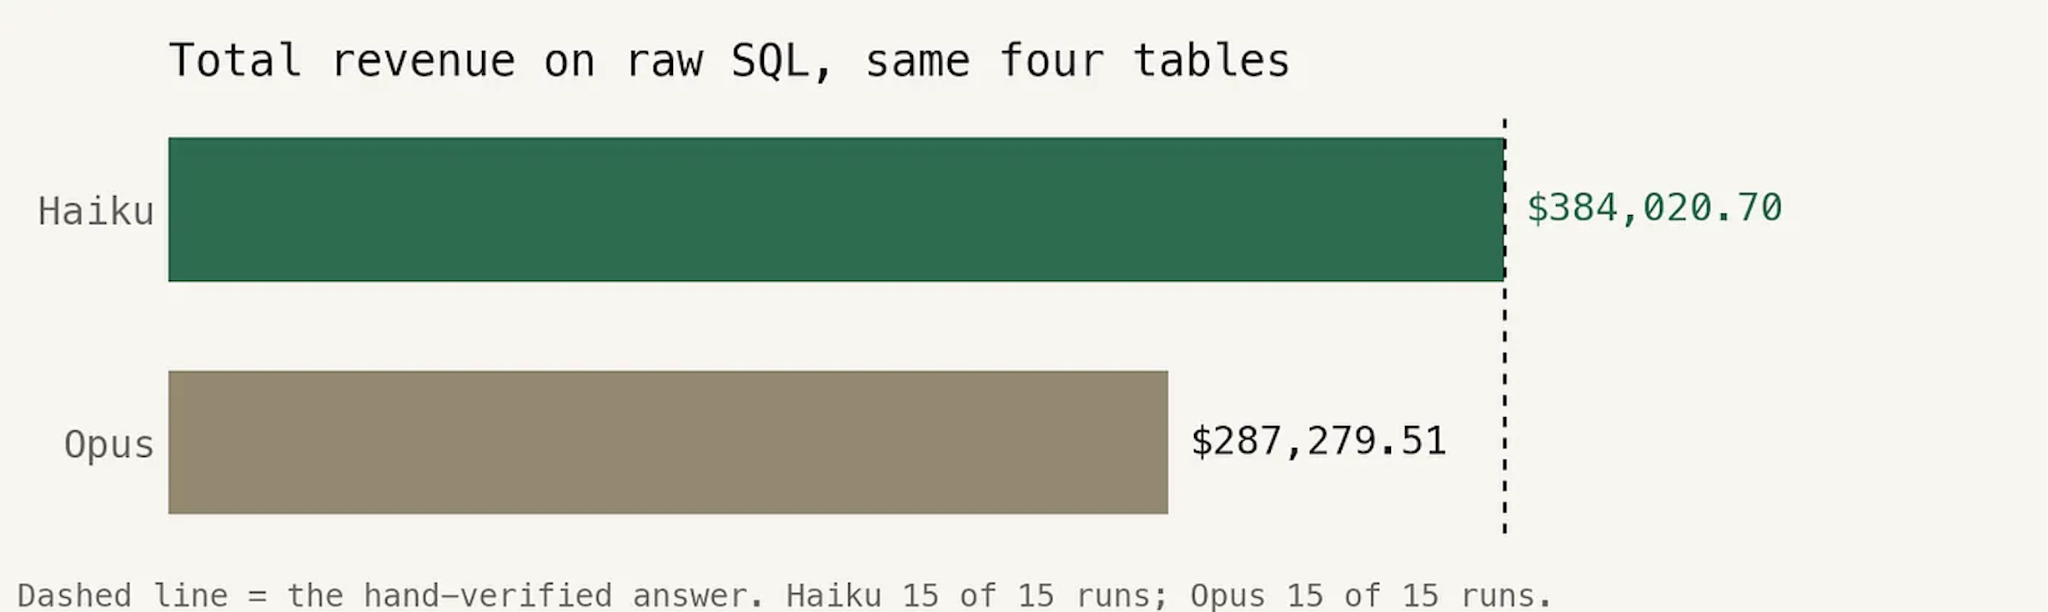
所以我测量了它,在这个过程中,我更清楚地看到,一旦数据的消费者是智能体而不是人,一个 dbt 项目 价值几何。本文逐一介绍进入同一个项目的 5 种界面,并附上数字:每种界面对准确性、信任和成本的作用,以及何时可以用较小的模型替代较大的模型。
简要版本:界面影响显著。要求 Haiku 在查询前阅读 dbt 文档,使其在连接问题上的错误答案从 4 个降到 0 个。语义层是唯一一个让两个模型都达到 0 个错误答案的界面,而且对两者来说,它的每个可信答案成本都是最低的。对于会话式分析,结论很明确:治理更好的数据访问可能与模型本身同样重要。
[CTA_MODULE]
我为什么要测量它
这项工作部分受到 MotherDuck 的智能体基准的启发,我是从 Jacob Matson 和 Alex Monahan 主讲的精彩网络研讨会中了解到它的, AI 智能体需要语义层吗? 他们的方法包括限制工具的智能体、检查智能体是否绕过受治理层,以及在测量准确性的同时测量效率。
第二个动机是我自己对智能体如何工作的兴趣。我针对 dbt 项目构建的每个智能体都始于一个关于界面的决定:对表使用原始 SQL、语义层,还是通过清单及其文档使用智能体模式和上下文。我其实没有明确的答案,不知道该用什么、何时用,或者在其背后放哪种模型。
我构建了一个测试框架,在改变界面的同时保持模型和问题不变。每个智能体都会收到一个业务问题和有限的工具,然后一直工作到能够返回答案、标记歧义,或者说明可用数据无法回答该问题。
每个问题都有一个经过验证的答案。如果智能体做出了回应但遗漏了该结果,则答案 错误。如果答案正确或正确说明数据无法回答该问题,则答案 可信。正确但伴随不确定性的答案算作运气,而非信任。
来自 1 个 dbt 项目的 5 种界面
以下是这 5 种界面;每一种都是一个 dbt 工件:
- 原始 SQL: 表名、列名和数据类型,没有文档。
- 智能体模式,可用: 相同的界面,加上使用 dbt Labs 开放智能体模式 标准生成的表,包含模型描述、列描述和血缘关系。这份文档就是大家谈论要给智能体的上下文,所以我在下文中两个词都会使用。智能体被告知这些表存在,但没有任何机制强制它去阅读它们。
- 智能体模式,必需: 相同的表,但智能体在查询数据之前必须阅读文档。
- 清单工具: 每次 dbt 解析都会写入一个清单,1 个文件包含每个模型、每一列及其描述,以及它们之间的血缘关系。在这里,智能体获得针对该文件的 3 个工具:关键词搜索、列查找和平实语言的模型定义。它也能获得 SQL,但在智能体至少查阅一次清单之前,测试框架会拒绝任何查询。
- 语义层: 通过命名维度查询命名指标,没有直接的 SQL 访问。我测试了本地 MetricFlow 和托管的 dbt 语义层 API。
我运行了 2 类问题:
- 25 个 "连接" 问题,涉及订单、行项目、客户和产品,包括粒度和扇出陷阱,以及 2 个数据完全无法回答的问题
- 10 个 "为什么" 问题,询问某个指标为什么在两个时期之间发生变化,使用的数据中原因已事先植入
Claude Haiku 4.5 和 Claude Opus 5 在 DuckDB 上把每个问题各运行了 3 次。我还在 Snowflake 上测试了语义层。
早先一项涵盖 3 个行业、60 个单表问题的基准,为我提供了额外数据,用于比较 4 个 Claude 模型——Haiku 4.5、Sonnet 5、Opus 5 和 Fable 5——以及 DuckDB、Snowflake 和 Databricks。合在一起,那一轮产生了 6,480 次运行。
文档修复了 Haiku 的粒度错误
以下是"连接"问题,每个单元格 75 次运行。每个可信答案的成本是该单元格中的模型支出除以你可以据此采取行动的答案数。
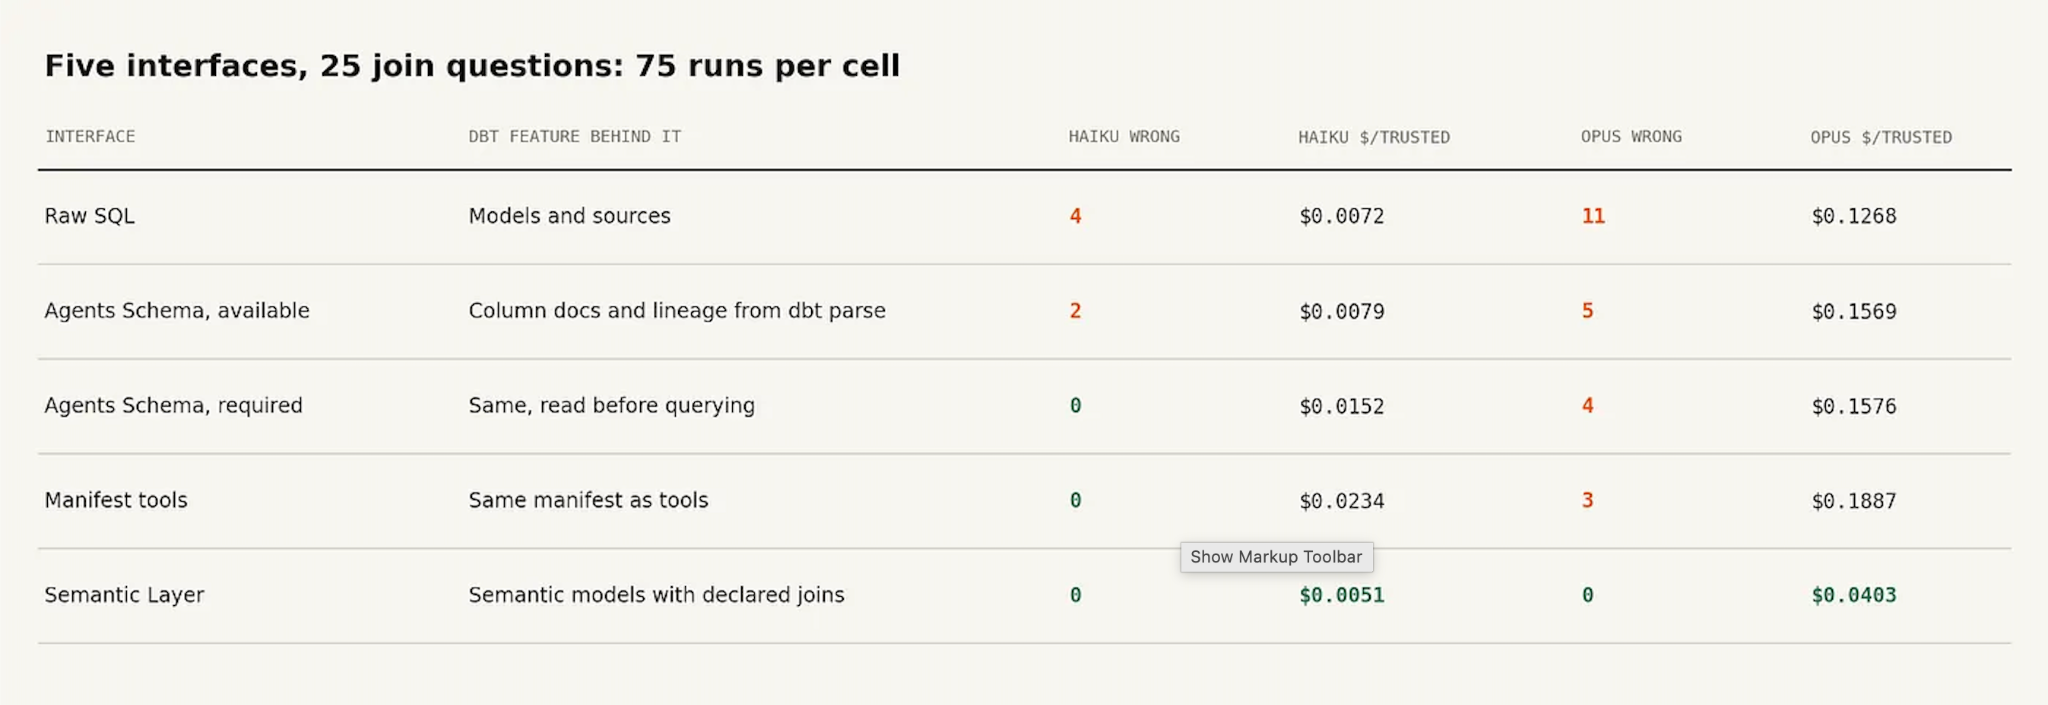
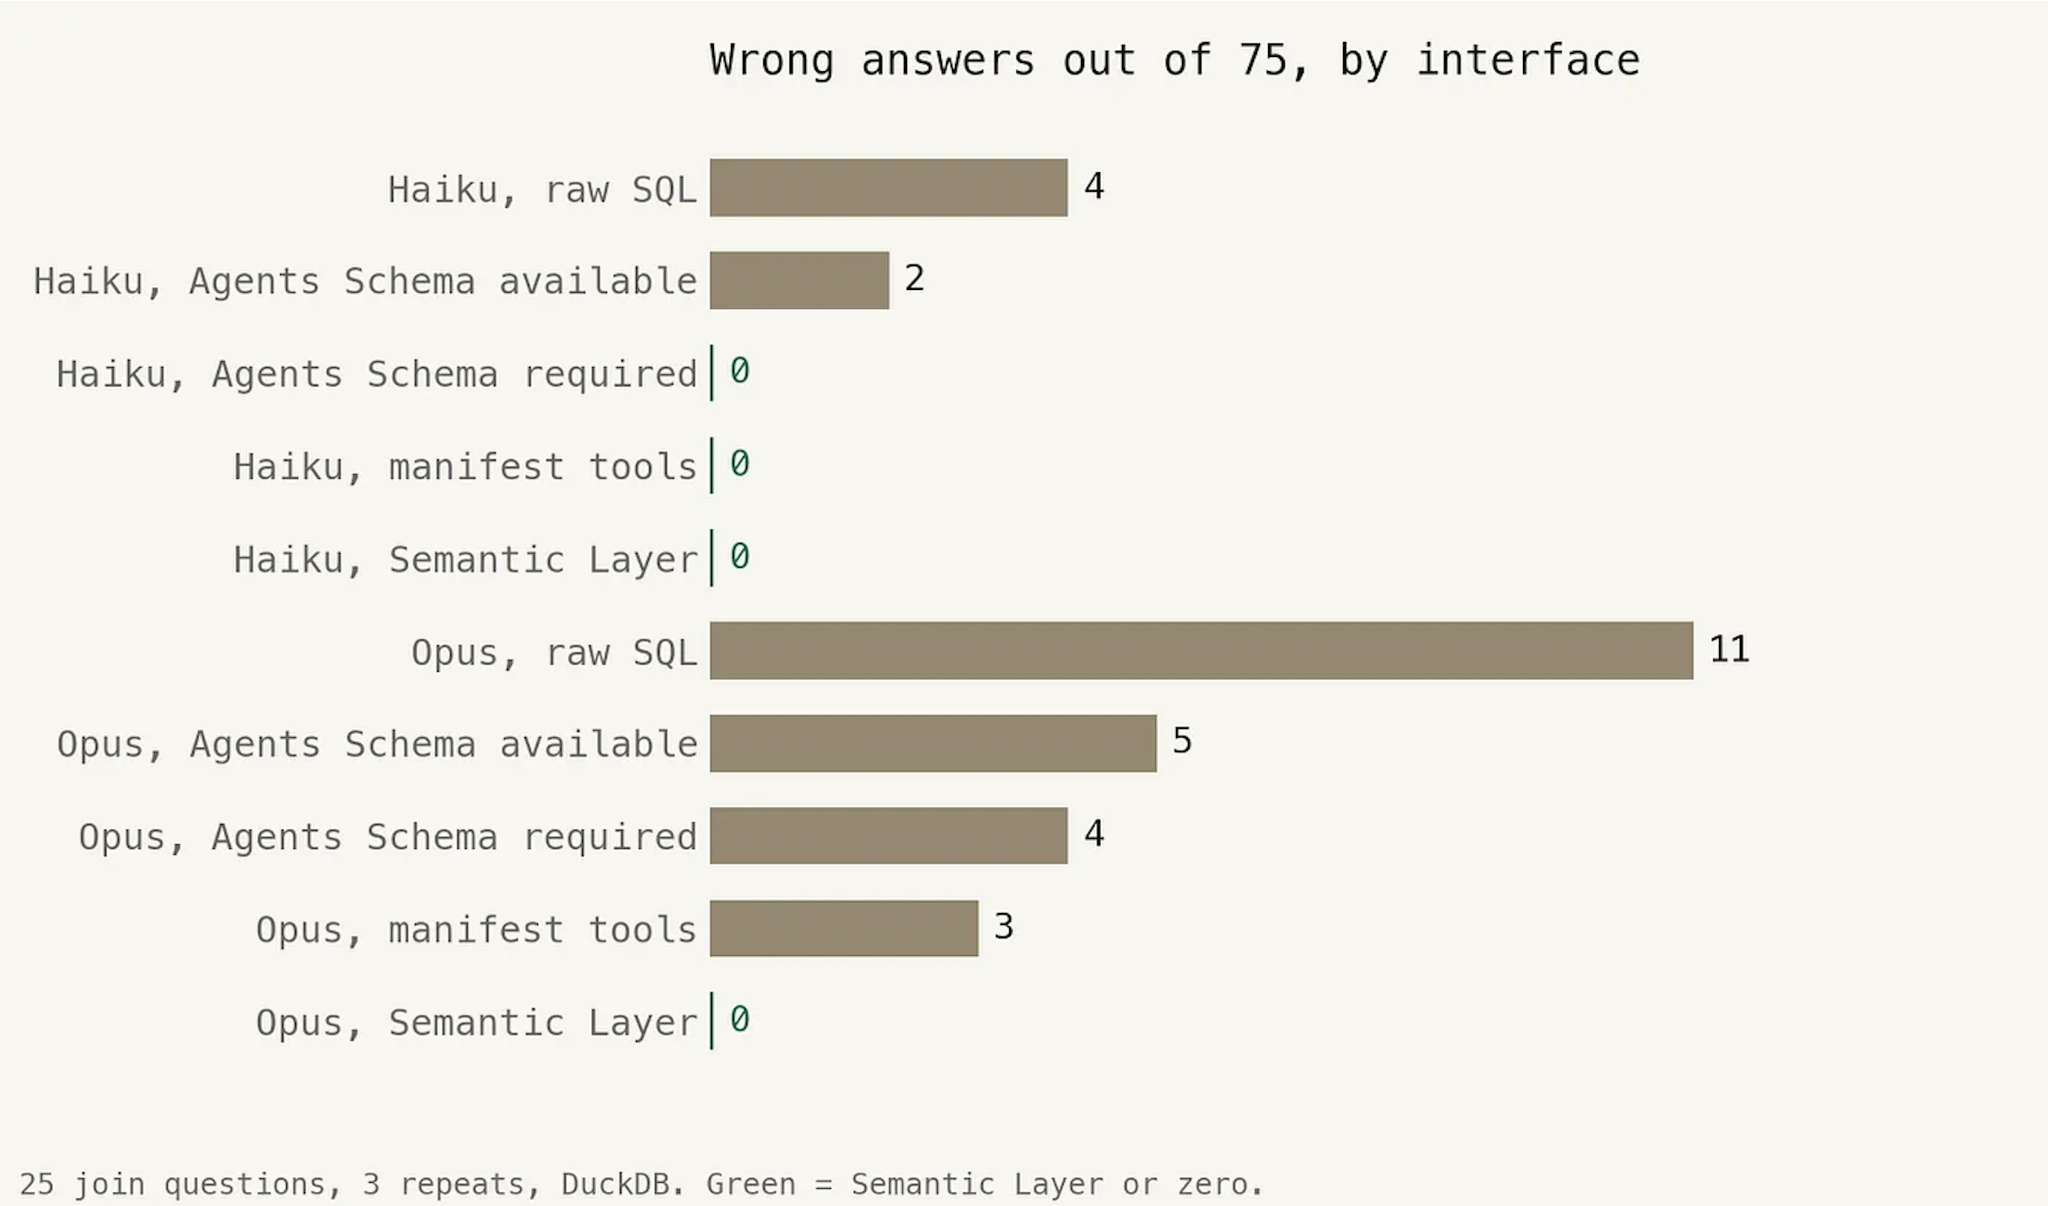
语义层是唯一一行两个模型都达到 0 的,而且对两者来说都是最便宜的一行。每个单元格的 75 次运行中有 6 次是那 2 个无法回答的问题,所有界面都正确地拒绝了这些问题。
Haiku 的 4 次原始 SQL 失误是同一个错误重复出现。当被问及平均订单总额时,它对单个行项目求平均,在 3 次运行中的 3 次都返回了 $255.33,而不是正确的订单级平均值 $512.03,且没有标记任何疑问。订单总额并未直接存储。它必须从行项目计算得出,而列文档解释了这一要求。
一旦 Haiku 阅读了那份文档,无论是通过必需的智能体模式还是清单工具,错误就消失了。在这 2 种界面上,它在 150 次运行中返回了 0 个错误答案。
仅仅让智能体模式可用还不够。Haiku 每次运行只查阅文档 0.09 次,在 3 次运行中仅有 1 次发现了该错误。
只要让智能体去阅读,列文档就能修复像这样的粒度错误。
语义层修复了 Opus 的收入政策
Opus 失败的原因不同。它读取原始 SQL 时出现的 11 次错误来自一个业务策略决策:在计算总收入、电子产品收入和平均订单金额时,它排除了已取消的订单。它披露了这一选择,但答案仍然与定义的指标不匹配。
文档并没有完全解决问题。即使被要求阅读 Agents Schema,Opus 在总收入与电子产品收入上仍在 3 次运行中的 2 次排除了取消订单。
文档描述了列,而 Opus 有异议的并不是这些列。
Semantic Layer 通过一次定义 total_revenue 解决了这种歧义。在这个受治理指标背后,Opus 在 75 次运行中返回了 0 个错误答案。
在这些运行中,并未实际执行针对这些定义的测试与契约;它们是在基准测试结束后保持定义正确性的东西。上下文和语义模型来自同一个 dbt 项目:这些表是建立在 dbt sources 之上的 dbt models,文档是模型与列描述,1 次 dbt parse 生成了供工具和 Agents Schema 表共同消费的 manifest,语义模型就在它们旁边,而该项目编译到 DuckDB、Snowflake、Databricks以及一个 dbt platform 环境,且无需改一行。我没有使用 dbt 之外的任何工具来构建任何接口。
“为什么”类问题是另一项工作
“为什么”类问题询问在第 1 期和第 2 期之间哪个因素驱动了某个指标,选项来自一个封闭列表:品类结构、子品类结构、定价、订单量、状态结构,或没有实质影响。每个问题都有 1 个预设原因。
有几个被故意设计得很棘手:一个中一个可见因素使指标朝错误方向变动,2 个中实际上没有任何东西真正变动,还有一个中 2 个原因平分秋色,因此正确答案是指出其中一个并提及另一个。
Opus 在所有接口上的 150 次运行中做对了 148 次。另外 2 次是拒绝回答而非错误答案。
Haiku 在每个接口上都答错了问题。它的错误遵循一致的模式:它选择的是变化最明显的因素,而不是实际推动指标的因素。
Semantic Layer 无法修复这种推理错误。智能体仍然必须解释数字并确定因果关系。
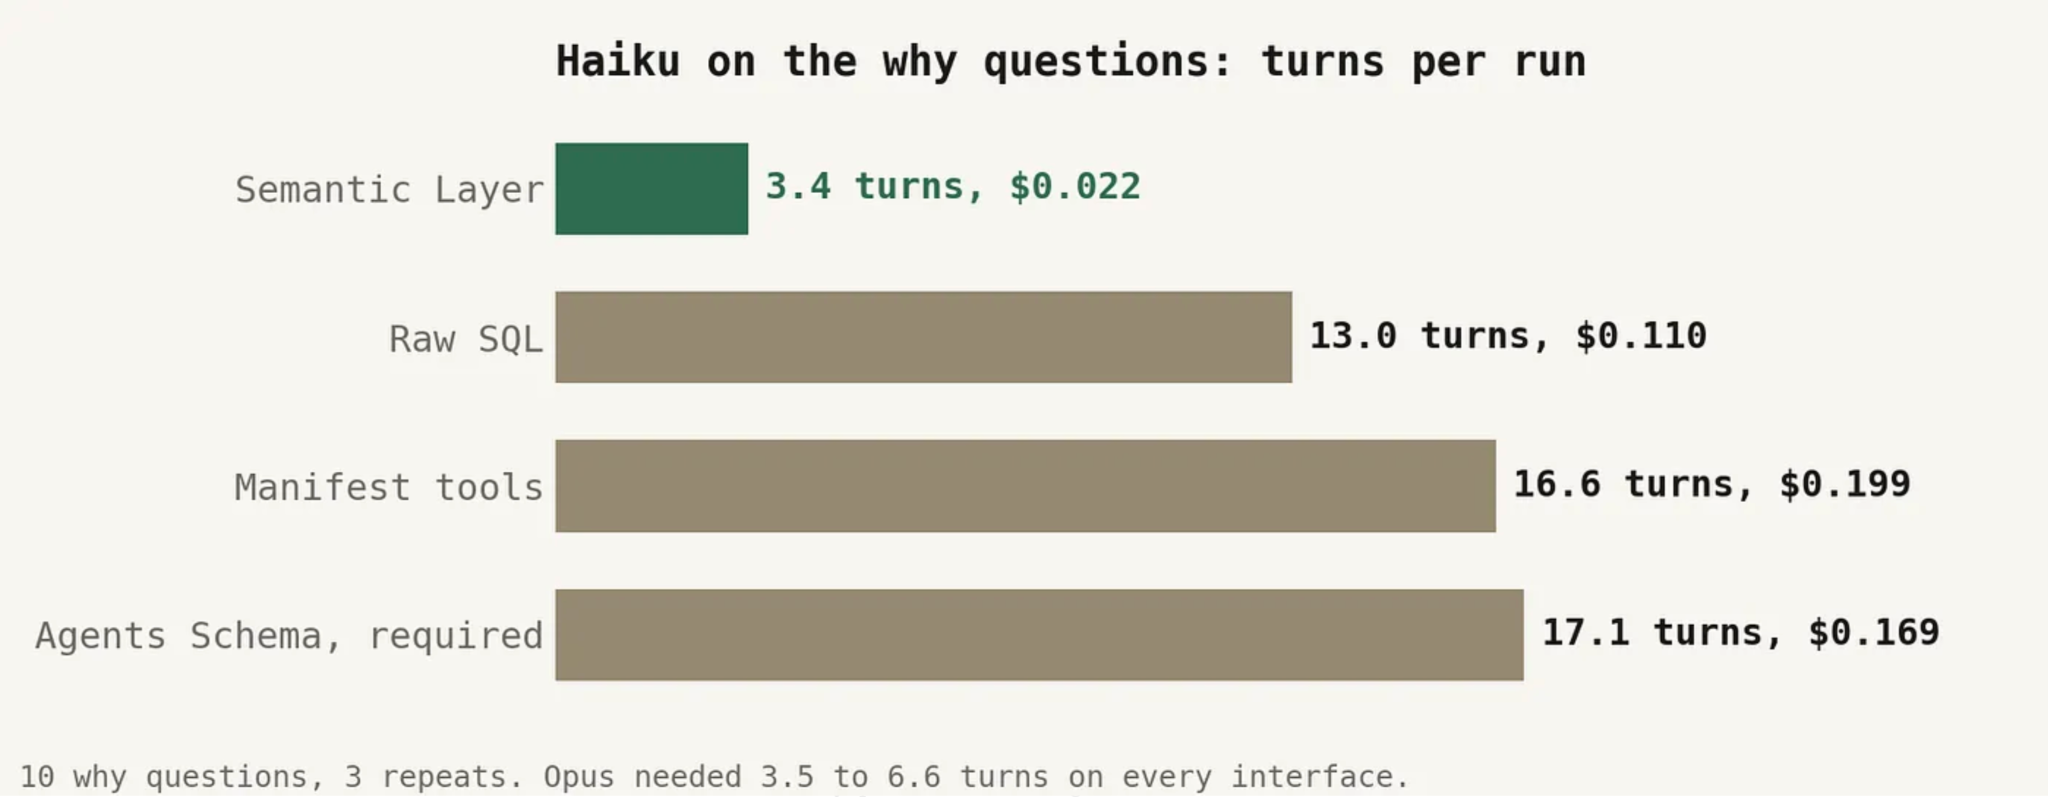
Semantic Layer 真正改变的是获取输入的成本。Haiku 在 Semantic Layer 上以 3.4 轮、每次运行约 $0.02 得出答案。在所有其他接口上,它用了 13 到 17 轮,每轮 1 次查询,成本最高达 $0.20。Opus 会规划其查询,在原始 SQL 上需要 4 轮,在文档接口上需要 6.6 轮。
上下文必须被要求且限定范围
可用的 Agents Schema 接口让我最深刻地了解到上下文实际上是如何被使用的。
当文档是可选时,Haiku 在每次 join 运行中只阅读它 0.09 次,并且在“为什么”问题上从不阅读。要求阅读文档后,使用率提高到每次运行 2.4 次阅读,并将其错误答案降至 0,同时使用的 token 数量是 manifest 工具所需的三分之二,因为阅读一张表比进行搜索与查找对话更便宜。
更早的单表研究显示了另一半情况。那一轮中能力最强的模型 Fable 5 在 manifest 工具上表现最差,错误率为 7.0%,因为它的工具让它能够浏览横跨 3 个行业的文档。在一个关于供应链预测的问题上,它在 9 次运行中的 9 次都从零售行业中同名的列作答。在受控 A/B 中,将工具限定到问题所属领域后,其错误率降至 3.3%,即它自己的原始 SQL 基线,而另一个模型没有变化。
当 Opus 可以访问项目中的每个模型(包括重复的零售数据)时,它表现出类似的模式。一旦访问被限制到相关表,每次运行的成本下降了一半以上。
我认为这是模型过度思考的一种形式,而它会朝 2 个方向过度思考:它搜索的范围比问题所需更广,这里发生的就是这种情况;它对问题解读得比所问的更多,收入策略那件事就是这样。dbt 针对每一种都有不同功能:限定接口范围处理第 1 种,受治理指标处理第 2 种。
dbt 生成上下文和指标,而智能体构建者仍然决定智能体可以访问项目中的多少内容,以及它在查询前是否必须阅读该上下文。在这些运行中,正是这 2 个决策把 dbt 工件变成了 0 错误的行。
较小的模型在受治理接口背后可以具有竞争力
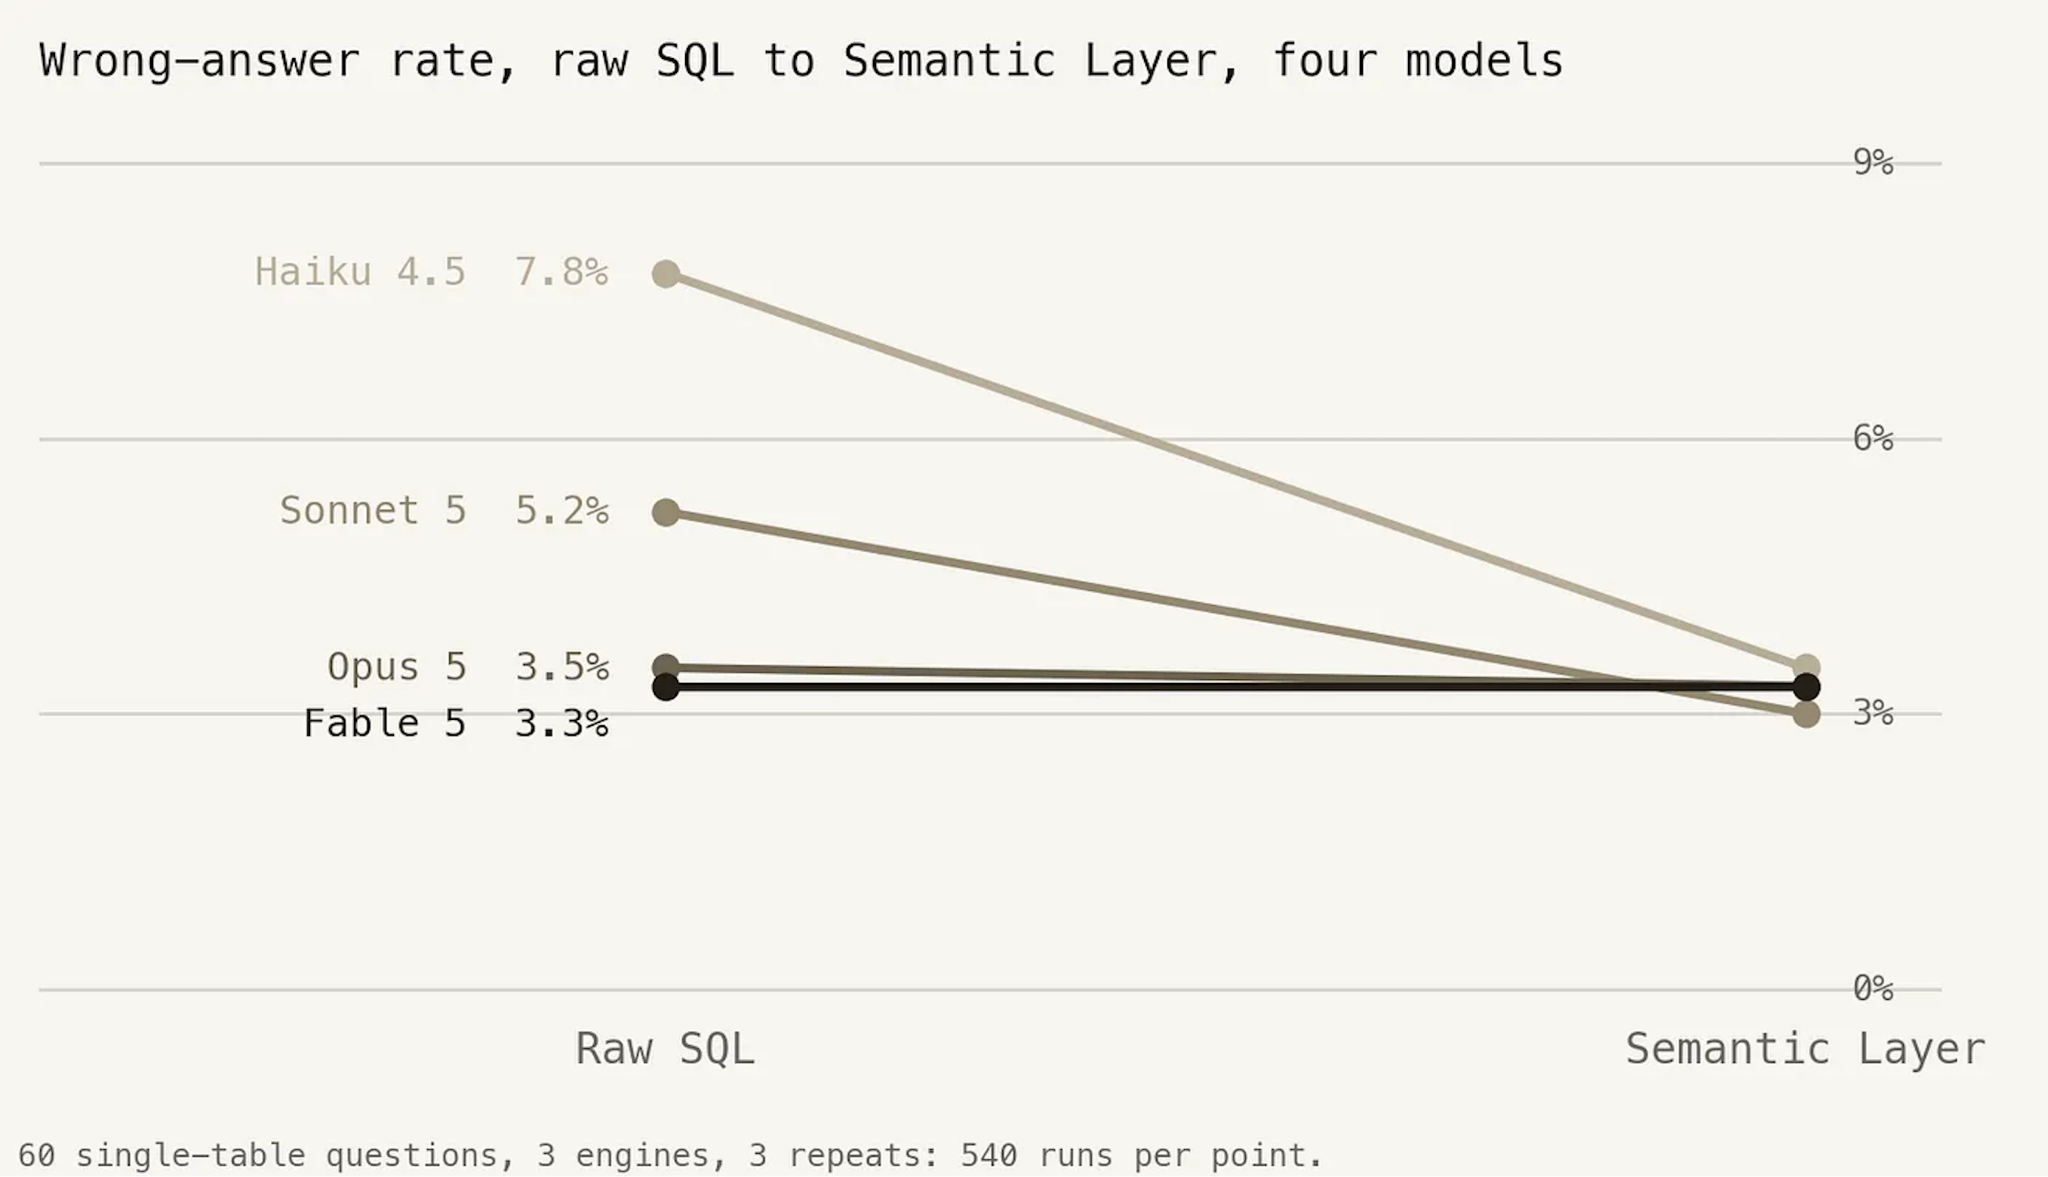
更早的基准测试显示,原始 SQL 错误率通常随着模型成本增加而下降,从 Haiku 的 7.8% 降至 Fable 的 3.3%。然而,在 Semantic Layer 背后,每个模型的错误率都落在 3% 到 3.5% 之间。
Semantic Layer 背后的 Haiku 达到了与自行编写 SQL 的 Fable 相同的准确率,而每个答案的成本仅为其 1/13:$0.0054 对 $0.0707。
在“join”类问题上,我运行的 2 个模型在它背后都降到了 0。这正是使 Haiku 在下文路由中对于受治理问题可行的原因。
这个 dbt 项目还在 DuckDB、Snowflake 和 Databricks 上产生了相同的已验证结果,包括一个读取了 Fivetran Managed Data Lake Service 的 Databricks 测试。每个引擎的所有 52 项单表检查和所有 23 项 join 检查结果均一致。
dbt 托管版 Semantic Layer 在 Snowflake 上完全复现了本地 MetricFlow 结果:两个模型都是 0 个错误答案。在单表轮次中,Semantic Layer 列在各引擎之间保持平稳,而原始 SQL 则因方言而异,且差异落在最小的模型上。在这些运行中,一旦指标定义固定,引擎就不再改变答案。
为 AI 智能体选择实用的 dbt 基础
1 个 dbt 项目支持了本基准测试中的每个接口,因此你不必在它们之中选择一个。下面的路由只是关于某个给定问题通过哪个接口的决策。
基于这个基准测试,以下是我正在考虑用于未来智能体的路由:
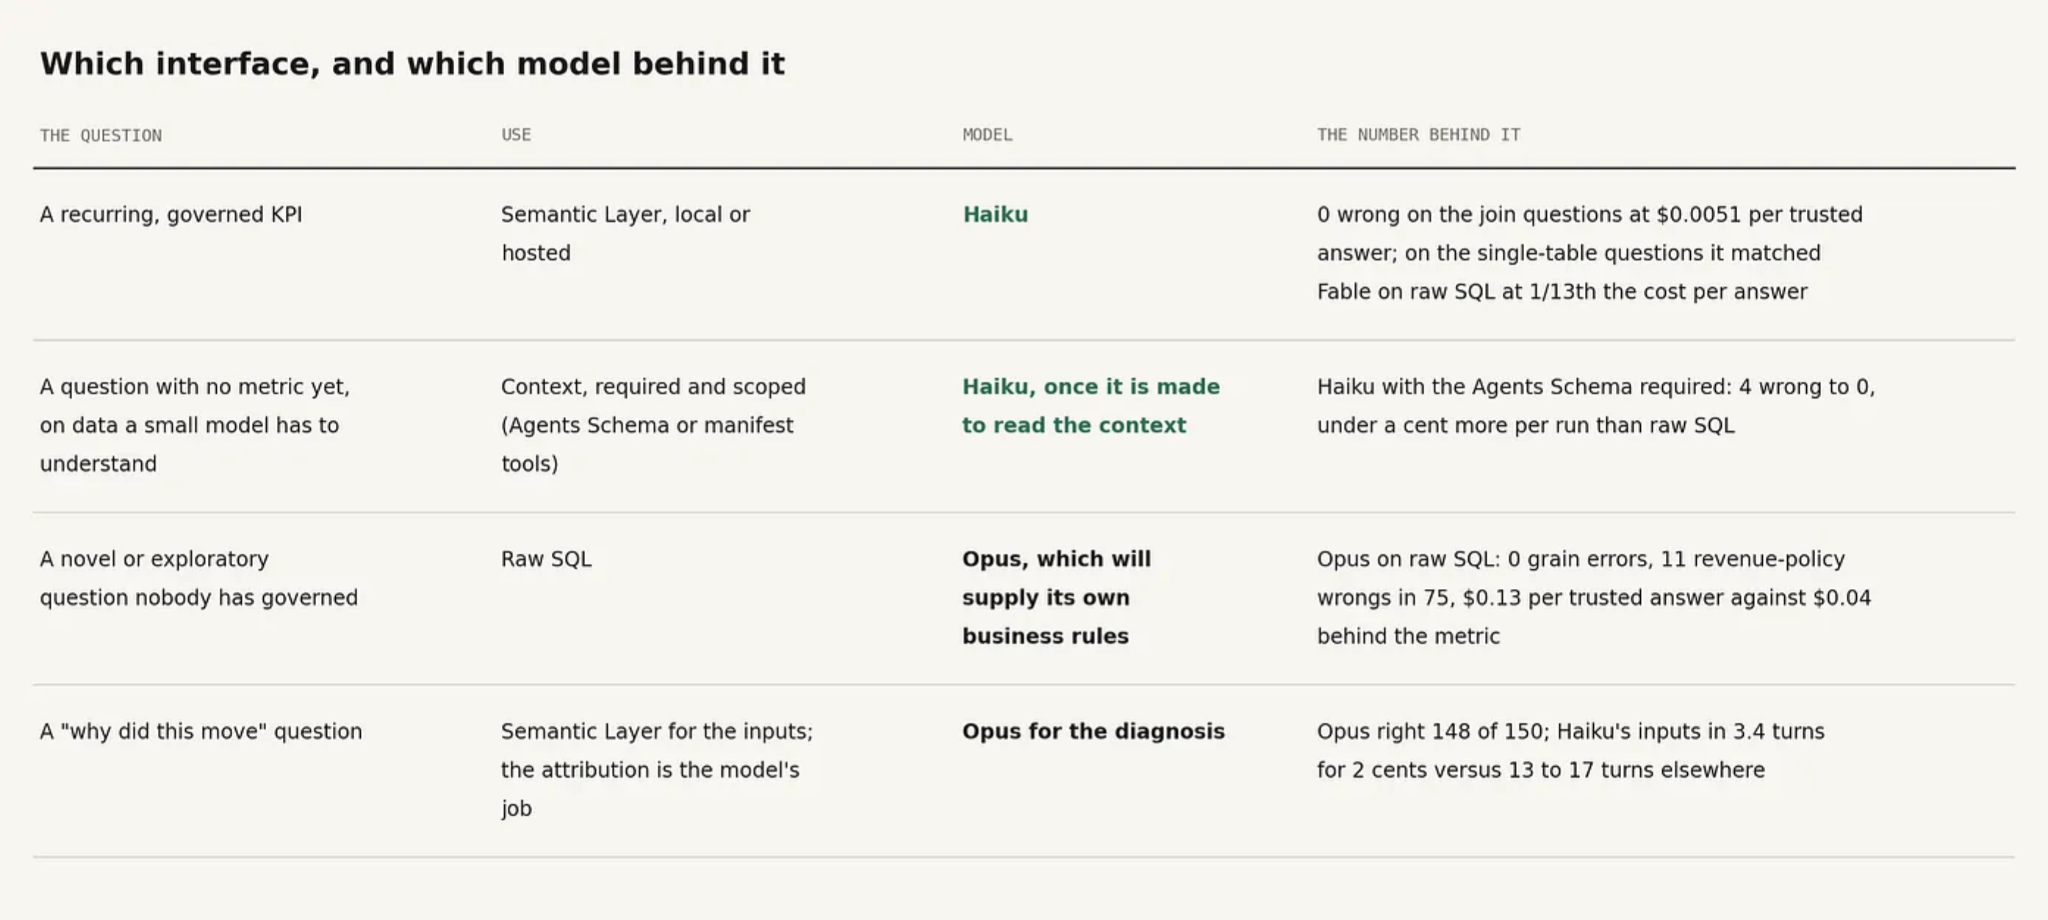
基于这些运行,受治理的问题——Slack 中的指标机器人或仪表盘问答框被问到的那类问题——正是我可以使用 Haiku 而不是更大模型的地方。反复需要原始 SQL 的问题也是指标定义的候选对象。
我已经在一个智能体应用中测试了这种方法的一部分。Haiku 读取问题以及一行已连接数据源的索引,然后选出少数看起来相关的数据源。Sonnet 5 仅使用这些工具进行推理,防止更强的模型在完整目录中游荡。如果数据源选择失败,应用程序会加载完整集合。
下一步是将受治理指标覆盖的问题直接路由到语义层上的 Haiku,而不调用 Sonnet。
只有当接口很短时,Haiku 才便宜。在"为什么"类问题上,Haiku 每次原始 SQL 运行花费 0.110 美元,而 Opus 为 0.135 美元,因为它需要 13 轮和 80,000 个 token,而 Opus 只需 4 轮就完成。在语义层后面,Haiku 的单次运行成本降至 0.022 美元,而 Opus 为 0.138 美元。
这 2 个模型在记录内容上也不同。Opus 会记录它的疑虑——在其原始 SQL 单元格中有 16 到 19 个靠运气答对但带有歧义标注的答案——而 Haiku 大多不这样做,只有 3 到 4 个。如果没有人会在输出被使用前阅读它,这一点非常重要。
以下是我现在在将任何智能体指向 dbt 项目之前可以问的 3 个问题,每个都对应这些运行中出错的某件事:
- 智能体能看多少项目内容,是否超过了问题所需? 更强的模型会探索所有内容。当 2 个数据集都可见时,Opus 将两者的收入相加;限定到正确的表后,它没有这样做。
- 问题是否有受治理的定义,还是模型会自行提供? 在除语义层之外的每个接口上,Opus 都用自己的取消订单规则来回答收入问题。
- 智能体是否必须先阅读上下文再查询,还是上下文只是放在那里? 当 Agents Schema 表只是放在那里时,Haiku 每次运行读取它们 0.09 次;当 harness 强制要求时则读取 2.4 次。
当没有人会在答案被使用前阅读它时,我会让智能体从语义层或从它必须阅读的上下文开始。这是 Haiku 的错误消失的 2 个地方,而它自己很少标记这些错误。
这也转化为一份用于智能体开发的简单 dbt 项目清单:
- 为每一列编写文档: 列上下文消除了 Haiku 的粒度错误。
- 为每个受治理的 KPI 创建语义模型: 受治理的收入定义消除了 Opus 的策略错误。
- 测试这些定义: 这些运行中没有用到测试和契约,而它们正是智能体上线后保持定义真实可靠的东西。
- 将 dbt 项目发布到智能体在运行时可以访问的地方: 仓库不可调用。指标和文档必须通过托管的语义层、仓库中的 Agents Schema 表或 dbt MCP Server 来提供。
- 从语义层上的低成本模型开始: 如果它回来说指标无法回答该问题,就把问题连同文档一起交给成本更高的模型。对于"为什么发生了这个变化"类智能体,从成本更高的模型开始。
join 那一轮来自 2 个模型和演示数据,所以我把这些发现视为一个起点。模型、接口以及 dbt 本身都在快速变化,我预计几个月内就会重写这份清单。
在这些运行中,接口改变答案的频率与模型一样高。同样的 2 个模型从原始 SQL 上的 4 个和 11 个错误答案变为语义层后面的 0 个,而在此期间模型本身没有任何变化。
了解 dbt 如何帮助将这一基础应用到你自己的人工智能工作流中。
[CTA_MODULE]
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏