构建Claude Code的经验:我们如何使用skills
DataHot 速览
Anthropic分享了在Claude Code中构建和扩展数百个内部技能的经验。技能是代理可以发现的指令、脚本和资源的文件夹,而不仅仅是markdown文件。通过梳理内部技能,他们发现技能分为九类,最佳技能应清晰归类。文中还讨论了如何构建技能、何时分享等最佳实践。
为什么值得关注:该文深入探讨了AI代理中技能的设计与组织,对数据Agent的构建与复用具有指导意义,适合数据从业者参考。
本文目录 25 节
译文
AI 逐段翻译技能类型
在整理了 Anthropic 内部所有技能后,我们注意到它们可以归为九个类别。最佳技能能干净地归入一个类别;而那些试图包罗万象的技能则会横跨多个类别,使智能体感到困惑。这并非一个权威清单,但它是一个有用的框架,可以帮助你识别自己的技能库中的空白。
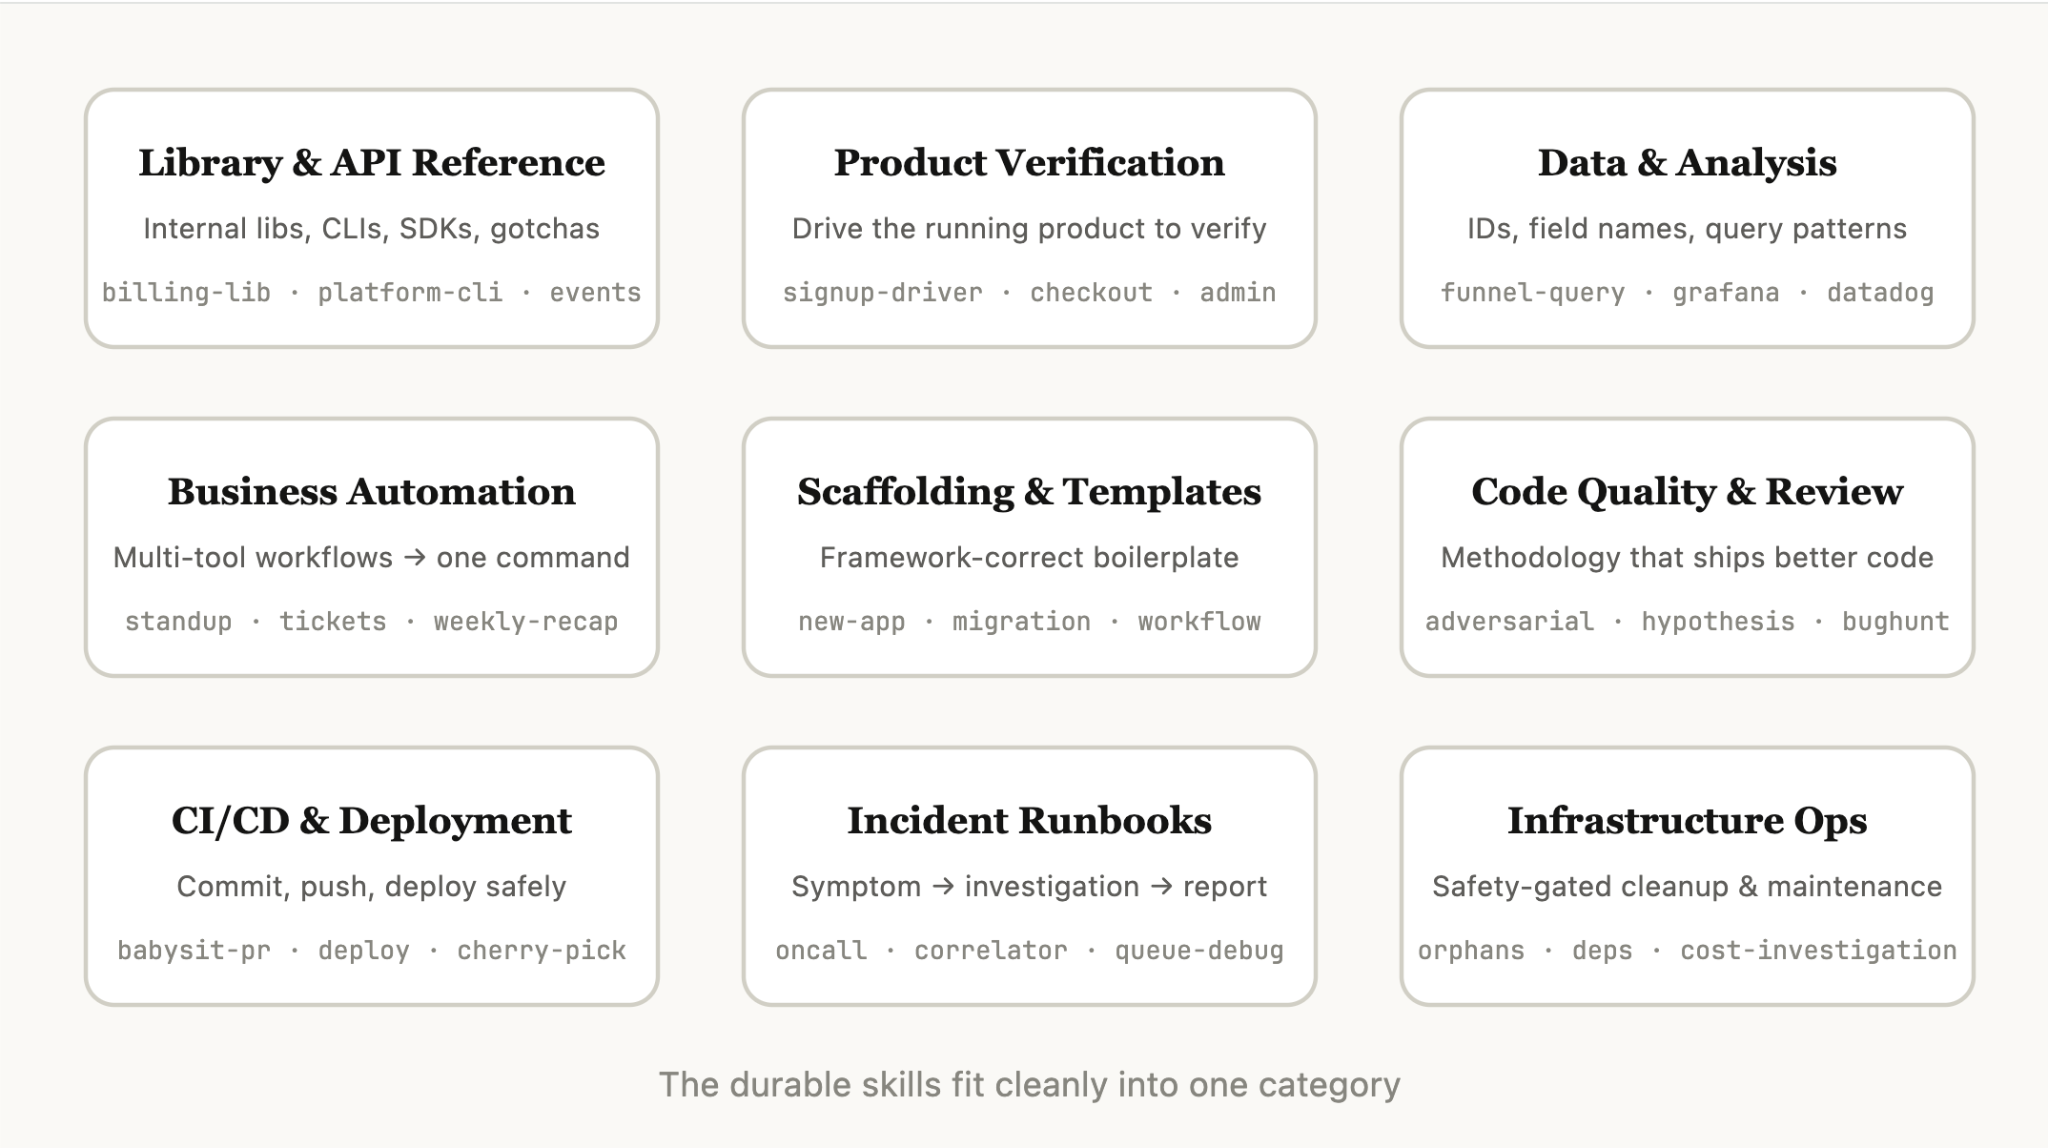
1. 库与 API 参考
这些技能解释了如何正确使用库、CLI 或 SDK。它们既可以针对内部库,也可以针对 Claude Code 有时难以处理的常见库。这些技能通常包含一个参考代码片段文件夹,以及一份 Claude 在编写脚本时应避免的陷阱清单。
示例包括:
billing-lib——你的内部计费库:边缘情况、易错点等。internal-platform-cli——内部 CLI 封装器的每个子命令,并附有使用示例。sandbox-proxy——配置你组织的开发用出口网关:哪些主机可访问,如何调试“连接被拒绝”错误,如何添加入站白名单条目。
2. 产品验证
这些技能描述了如何测试或验证你的代码是否正常工作。它们通常与 playwright、tmux 或其他外部工具搭配使用以进行验证。
在内部,验证技能对 Claude 输出质量的影响最为显著。值得让一名工程师花一周时间专注于完善你的验证技能。
可以考虑让 Claude 录制其输出视频,以便你确切看到它测试了什么,或者在每一步强制对状态进行程序化断言。这些通常通过在技能中包含各种脚本来实现。
示例包括:
signup-flow-driver——在无头浏览器中运行注册 → 邮箱验证 → 入门流程,并在每一步提供用于断言状态的钩子checkout-verifier——使用 Stripe 测试卡驱动结账 UI,验证发票确实进入正确状态tmux-cli-driver——用于交互式 CLI 测试,此时需要 TTY 环境来验证目标。
3. 数据获取与分析
这些技能连接你的数据和监控堆栈。这些技能可能包括获取数据所需的库及凭据、特定的仪表板 ID 等,以及常见工作流或获取数据方式的说明。
示例包括:
funnel-query——“我应该连接哪些事件来查看注册→激活→付费”以及实际包含权威 user_id 的表cohort-compare——比较两个群组的留存或转化,标记统计显著差异,并链接到分段定义grafana——数据源 UID、集群名称、问题→仪表板查找表datadog——字段参考(@request_id 与 trace_id)、服务列表、指标前缀约定
4. 业务流程与团队自动化
这些技能将重复性工作流自动化为一个命令。这些技能通常相对简单,但可能依赖其他技能或 MCP,且依赖关系较为复杂。对于这些技能,将先前结果保存在日志文件中可以帮助模型保持一致,并反思先前工作流的执行情况。
示例包括:
standup-post——聚合你的票据追踪器、GitHub 活动和之前的 Slack 消息,生成格式化的每日站会内容,仅显示增量部分create-<ticket-system>-ticket——强制实施模式(有效的枚举值、必填字段),并开展创建后工作流(在 Slack 中提醒审阅者并链接)weekly-recap——合并的 PR + 关闭的票据 + 部署 → 格式化的周报帖子
5. 代码脚手架与模板
这些技能为代码库中的特定功能生成框架样板。你可以将这些技能与可组合的脚本结合使用。当你的脚手架有纯代码无法覆盖的自然语言要求时,它们尤其有用。
示例包括:
new-<framework>-workflow——为你生成新的服务/工作流/处理器,并附带注释new-migration——你的迁移文件模板以及常见陷阱create-app——创建新的内部应用,并预先配置好你的身份验证、日志记录和部署配置
6. 代码质量与审查
这些技能在组织内部实施代码质量并协助审查代码。这些技能可以包含确定性的脚本或工具,以实现最大稳健性。你可能希望将这些技能作为钩子的一部分或 GitHub Action 中自动运行。
adversarial-review——生成一个全新视角的子代理进行批评,实施修复,迭代直至发现的问题降级为吹毛求疵code-style——强制代码风格,尤其是 Claude 默认不擅长的风格。testing-practices——关于如何编写测试以及测试什么内容的说明。
7. CI/CD 与部署
这些技能帮助你在代码库内获取、推送和部署代码。这些技能可能引用其他技能来收集数据。
示例包括:
babysit-pr——监视 PR → 重试不稳定的 CI → 解决合并冲突 → 启用自动合并deploy-<service>——构建 → 冒烟测试 → 逐步流量发布并比较错误率 → 在回归时自动回滚cherry-pick-prod——隔离工作树 → 樱桃挑选 → 冲突解决 → 使用模板提交 PR
8. 操作手册
这些技能接收症状(如 Slack 线程、警报或错误签名),进行多工具调查,并生成结构化报告。
示例包括:
<service>-debugging——将症状映射到工具和查询模式,针对流量最高的服务oncall-runner——获取警报 → 检查常见可疑点 → 格式化发现log-correlator——给定请求 ID,从可能触及该请求的所有系统提取匹配日志
9. 基础设施运维
这些技能执行日常维护和操作流程,其中一些涉及破坏性操作,受益于护栏。它们使工程师在关键操作中更容易遵循最佳实践。
示例包括:
<resource>-orphans— 查找孤立的Pod/卷 → 发布到Slack → 等待期 → 用户确认 → 级联清理dependency-management— 你组织的依赖审批工作流cost-investigation— “为什么我们的存储/出口账单飙升”并附带具体桶和查询模式
制作技能的技巧
一旦你决定了要制作的技能,如何编写它?以下是Claude Code团队的一些最佳实践、提示和技巧,用于制作技能。
不要陈述显而易见的事情
Claude已经知道如何编码,并能阅读你的代码库。一个重述Claude默认行为的技能会增加上下文但不增加价值。如果你发布一个主要关于知识的技能,重点放在推动Claude跳出常规思维的信息上。
前端设计技能 是一个很好的例子;它是由Anthropic的一位工程师通过与客户迭代改进Claude的设计品味而构建的,避免了Inter字体和紫色渐变等常见模式。
构建陷阱部分
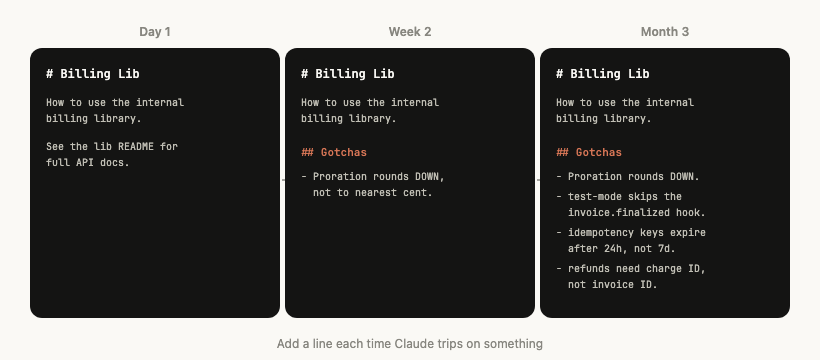
任何技能中信号最强的部分是“陷阱”部分。这些部分应从Claude使用你的技能时遇到的常见失败点构建。理想情况下,你会随着时间更新技能以捕捉这些陷阱。
例如:
“subscriptions 表是仅追加的。你想要的行是版本最高的那一行,而不是最新的 created_at。” “这个字段在API网关中称为@request_id ,在计费服务中称为trace_id。它们是同一个值。” “即使Stripe webhook没有实际处理,Staging也返回200。检查 payment_events 以获取真实状态。”
使用文件系统和渐进式披露
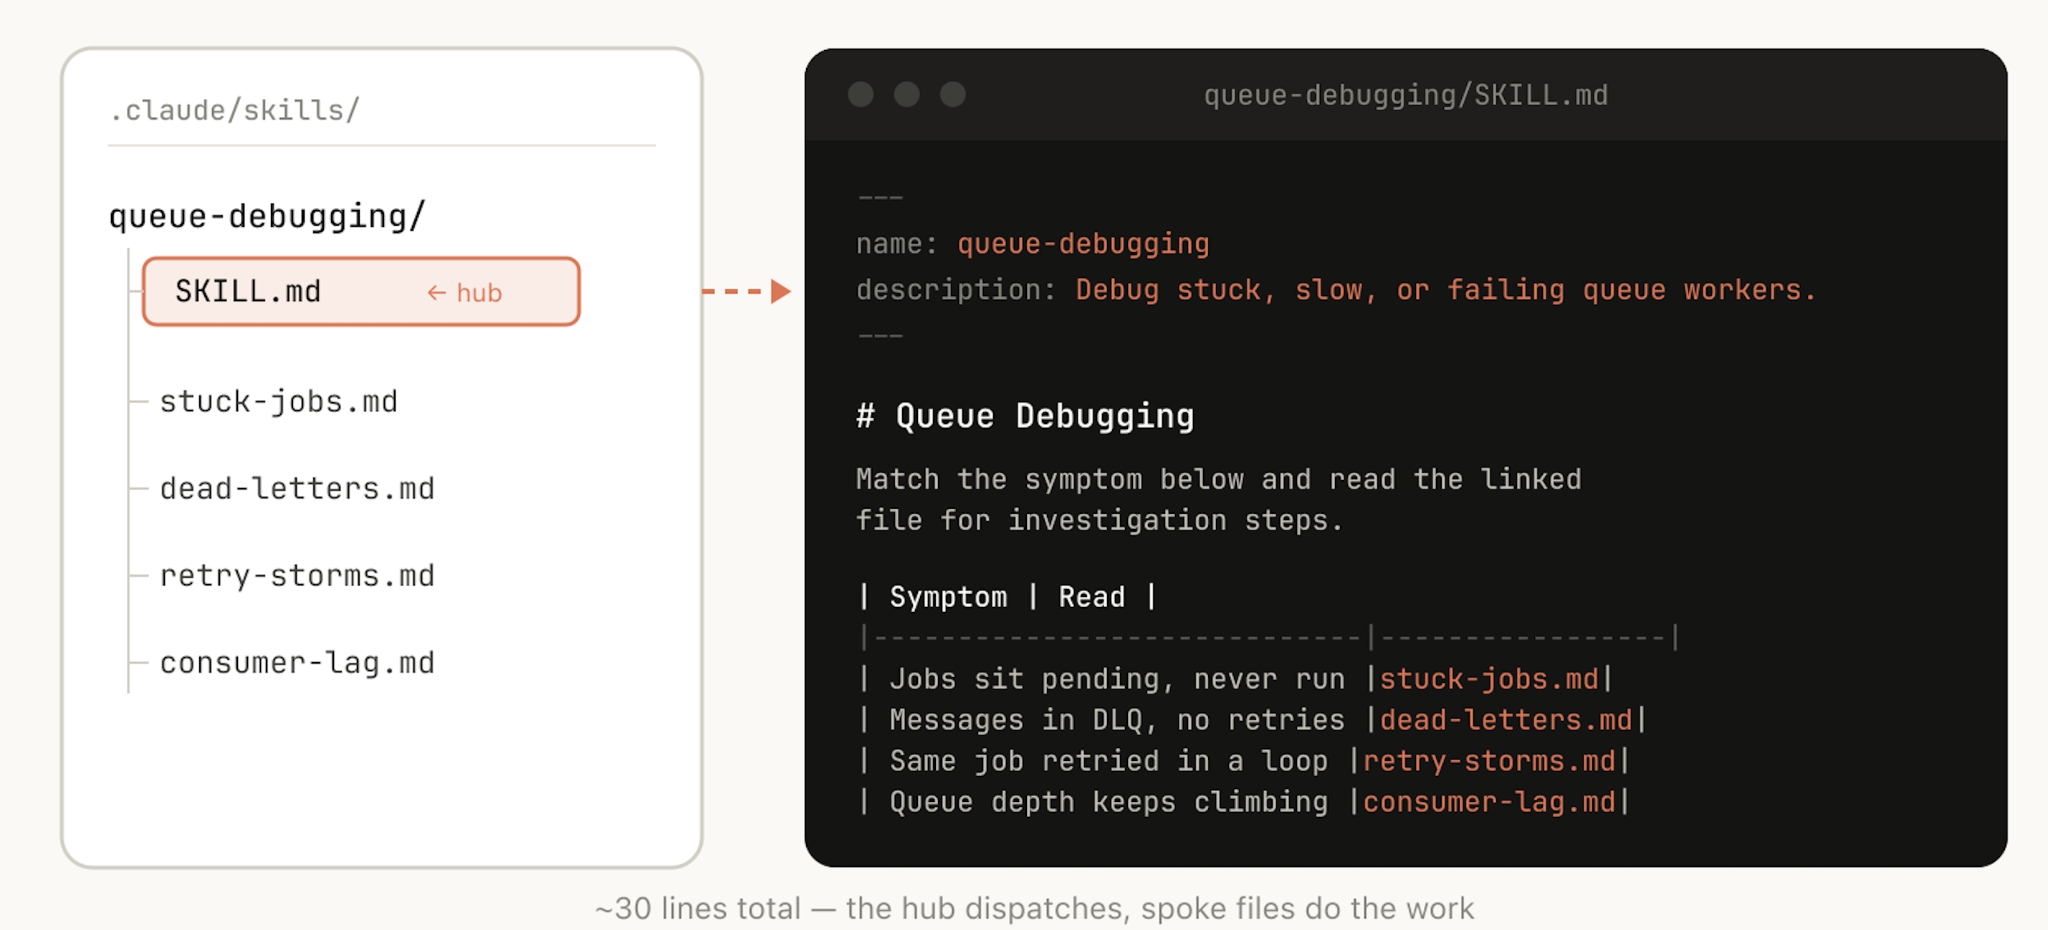
如我们之前所说,技能是一个文件夹,而不仅仅是一个markdown文件。你应该将整个文件系统视为一种上下文工程和渐进式披露的形式。告诉Claude你的技能中有哪些文件,它会在适当的时候阅读它们。
渐进式披露的最简单形式是指向其他markdown文件供Claude使用。例如,你可以将详细的函数签名和使用示例拆分为 references/api.md。
另一个例子:如果你的最终输出是一个markdown文件,你可能在 assets/ 中包含一个模板文件供复制和使用。
你可以有引用、脚本、示例等文件夹,这些有助于Claude更有效地工作。
避免过度限制Claude
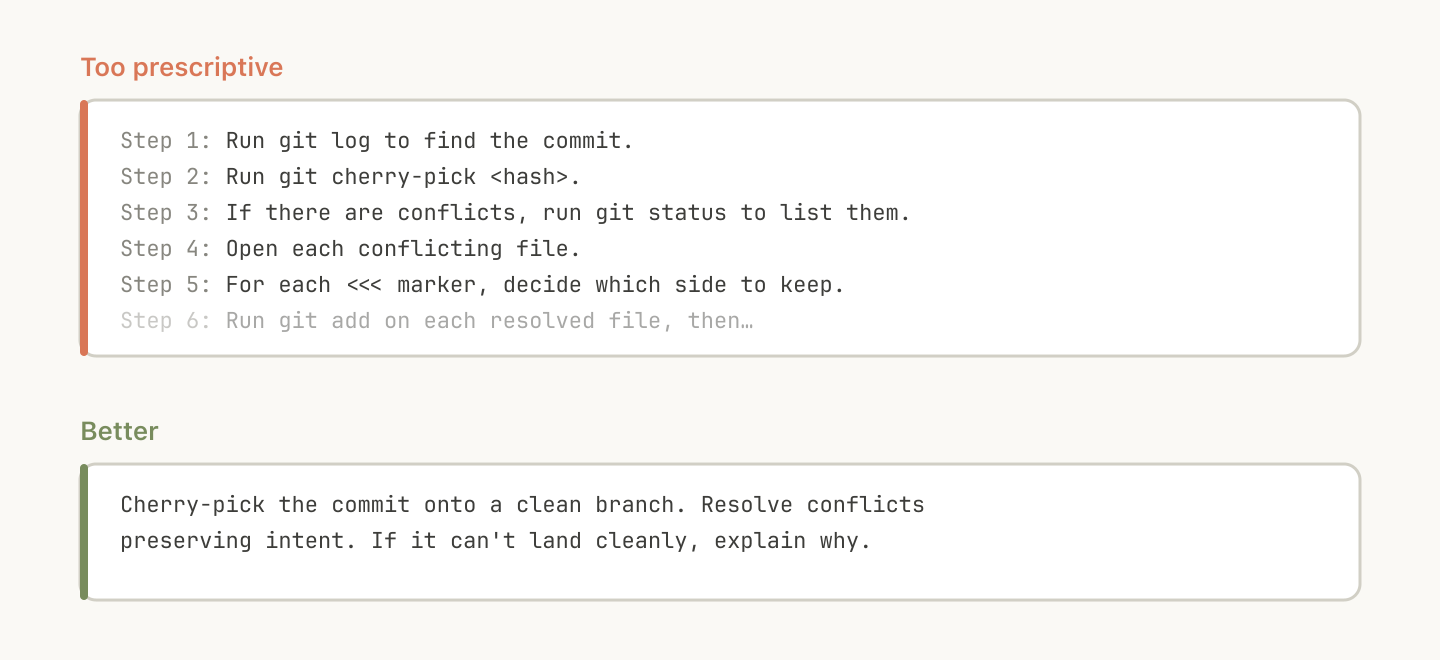
Claude通常会尽量遵循你的指示,由于技能如此可重用,你应该小心不要在指示中过于具体。给Claude所需的信息,但要给予它适应情况的灵活性。
例如:
考虑设置
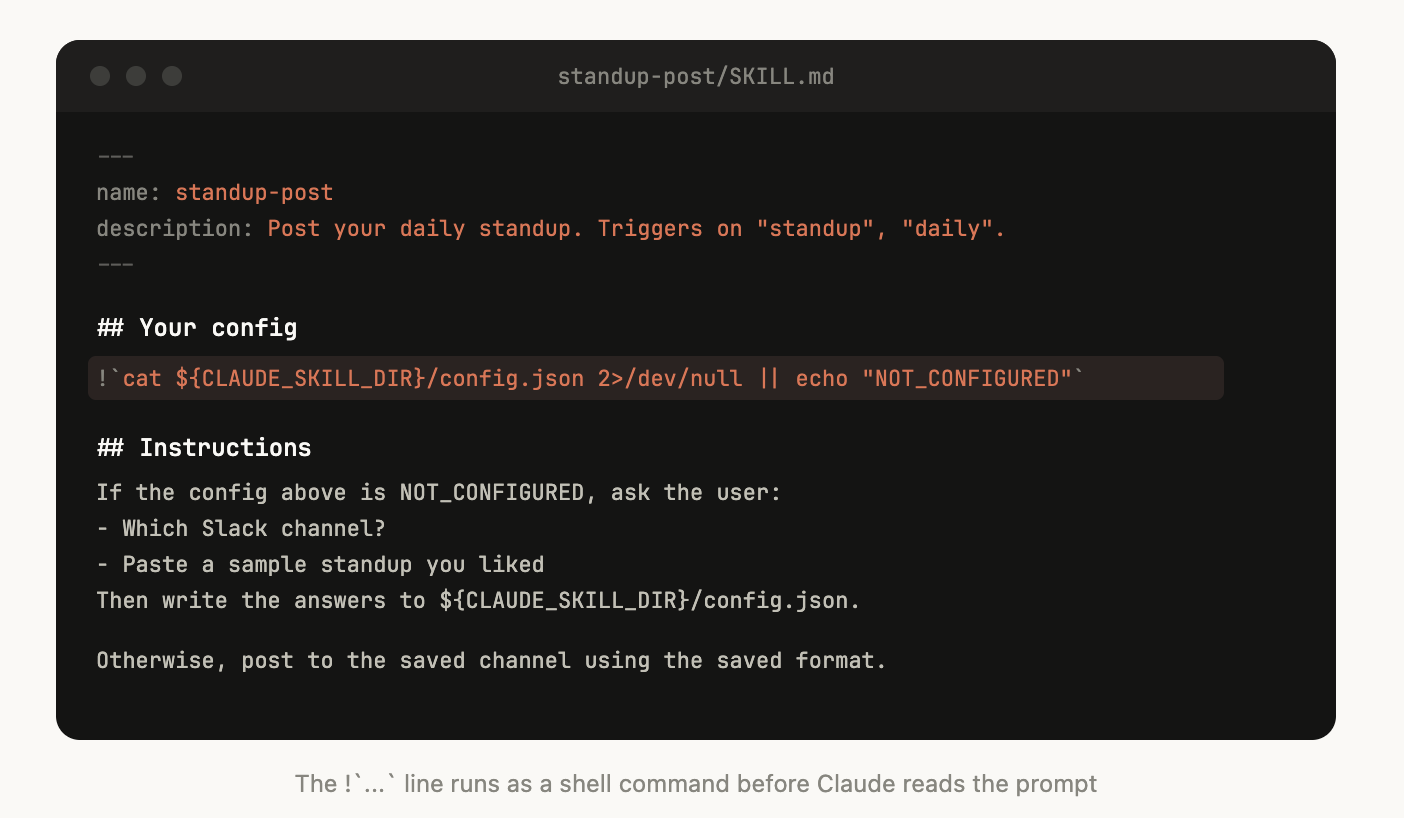
某些技能可能需要用户提供上下文进行设置。例如,如果你正在制作一个将你的站会发布到Slack的技能,你可能希望Claude询问要发布到哪个Slack频道。
一个好的模式是将这些设置信息存储在技能目录中的config.json文件中,如上面的示例。如果配置未设置,代理可以随后向用户询问信息。
如果你希望代理呈现结构化的多项选择题,你可以指示Claude使用AskUserQuestion工具。
为模型编写描述,而不是为人类
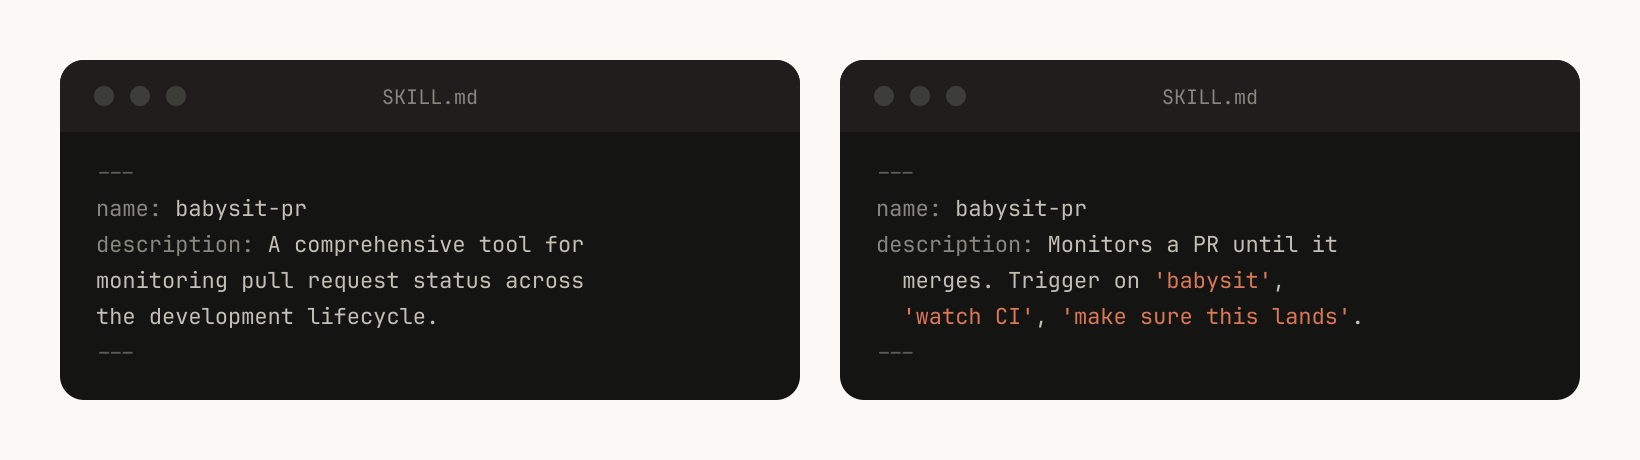
当Claude Code启动会话时,它会构建每个可用技能及其描述的列表。Claude扫描这个列表来决定“是否有适用于此请求的技能?”这意味着描述字段不是摘要,而是描述何时触发此技能。
帮助Claude记忆
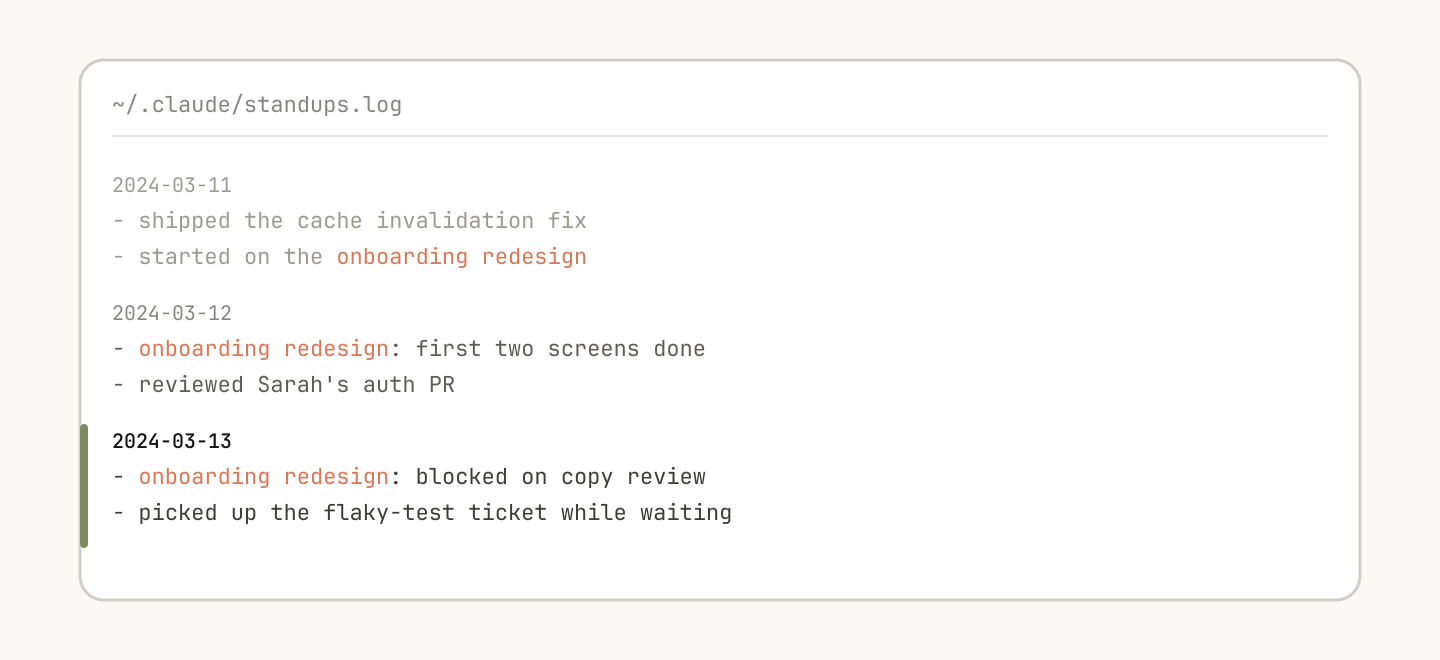
一些技能可以通过在其中存储数据来包含一种记忆形式。你可以将数据存储在任何简单的东西中,比如仅追加的文本日志文件或JSON文件,或者像SQLite数据库这样复杂。
例如,一个 standup-post 技能可能会保留一个standups.log,记录每次发布的帖子,这意味着下次运行时,Claude会读取自己的历史并可以分辨自昨天以来发生了什么变化。
你可以使用环境变量 ${CLAUDE_PLUGIN_DATA} 来获取一个稳定的目录,你可以在其中存储数据,更多关于在技能中持久化数据的读取:https://code.claude.com/docs/en/plugins-reference#persistent-data-directory 。
存储脚本和生成代码
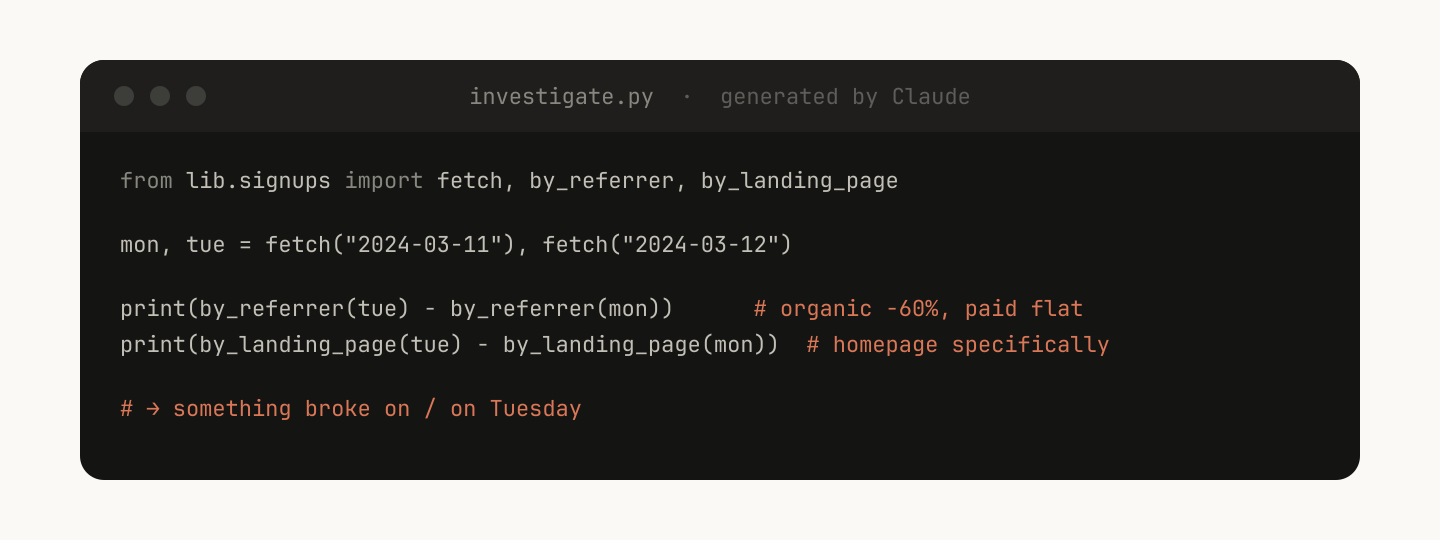
你可以给Claude的最强大的工具之一是代码。给Claude脚本和库可以让Claude将回合花在组合上,决定下一步做什么,而不是重建样板。
例如,在你的 data-science 技能中,你可能有一个函数库来从你的事件源获取数据。为了让Claude进行复杂分析,你可以给它一组辅助函数,如下所示:
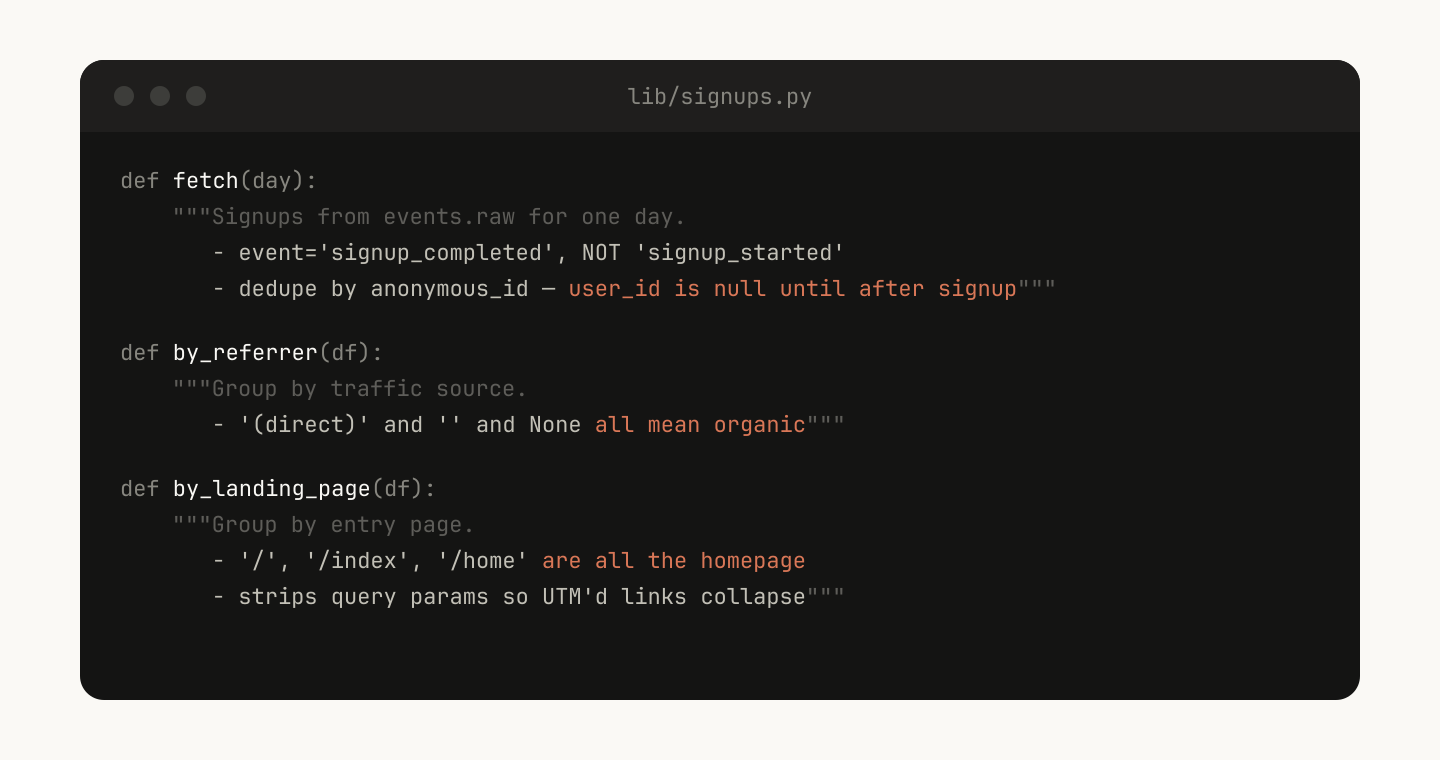
Claude然后可以即时生成脚本来组合此功能,以便对诸如“星期二发生了什么?”之类的提示进行更高级的分析。
使用按需钩子
技能可以包含仅在技能被调用时激活的钩子,并且仅持续会话期间。使用它来执行更有主见的钩子,这些钩子你不想一直运行,但有时非常有用。
例如:
/careful/freeze— 阻止任何不在特定目录中的编辑/写入操作。在调试时很有用:“我想添加日志,但总是意外‘修复’不相关的代码。”
分发技能
技能最大的好处之一是你可以与团队其他成员分享。
你可能想与他人分享技能的方式有两种:
- 将技能检入你的仓库(位于
./.claude/skills) - 制作一个插件,并拥有一个Claude Code插件市场,用户可以在其中上传和安装插件(在文档中了解更多信息)
对于在相对较少仓库上工作的小型团队,将技能检入仓库效果很好。但每个检入的技能也会增加模型的一点上下文。随着规模扩大,内部插件市场允许你分发技能,让你的团队决定安装哪些技能,并包含设置流程。
管理技能市场
你如何决定哪些技能进入市场?人们如何提交它们?
在Anthropic,我们没有集中式团队来做决定;相反,我们尝试有机地找到最有用的技能。如果有人有一个技能想让大家试用,他们可以将其上传到GitHub中的沙盒文件夹,并在Slack或其他论坛中向人们指出。
一旦一个技能获得了关注(由技能所有者决定),他们可以提交一个PR将其移入市场。
组合技能
你可能希望拥有相互依赖的技能。例如,你可能有一个文件上传技能,它上传文件,以及一个CSV生成技能,它生成CSV并上传它。这种依赖管理目前并未原生内置于市场或技能中,但你可以通过名称引用其他技能,如果它们已安装,模型将调用它们。
衡量技能
为了了解技能的表现,我们使用一个PreToolUse钩子,使我们能够在公司内部记录技能使用情况(示例代码在此)。这意味着我们可以找到受欢迎或与预期相比触发不足的技能。
开始使用
技能的最佳实践仍在发展。我们最好的技能大多始于几行代码和一个陷阱,然后因为Claude遇到新的边缘情况而不断添加,变得更好。
理解技能的最佳方式是开始使用、实验,看看什么适合你。
本文由Anthropic技术团队成员Thariq Shihipar撰写,他致力于Claude Code。
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏