用Replit和Lakebase在Databricks构建受治理企业应用
DataHot 速览
Databricks 官方博客介绍 Replit 与 Databricks 的集成,帮助企业在受治理环境中完成从开发到部署应用。团队可用 Replit Agent 基于实时 Databricks 数据构建前端,并自动配置 Lakebase Postgres 数据库,再部署为 Databricks Apps。部署后应用继承用户认证、安全访问控制,并与 Unity Catalog 集成,从而减少安全与基础设施审批环节。文章面向业务负责人、数据分析师和开发者,说明如何用自然语言提示构建生产级应用。
为什么值得关注:数据从业者可了解 Databricks 如何把 Agentic coding、Lakebase 与 Unity Catalog 治理结合,缩短企业数据应用从构建到生产部署的路径。
译文
AI 逐段翻译Replit 与 Databricks 的结合为企业提供了从开发到部署的完整平台。通过这一集成,企业团队可以使用 Replit Agent 构建受治理的应用程序,这些应用运行在实时的 Databricks 数据之上,并借助原生 Lakebase 支持将其部署到 Databricks Apps。无论用户是业务负责人、数据分析师还是开发者,都可以利用智能体编码,通过一句自然语言提示创建出生产级应用。
上个月,我们宣布了 Replit | Databricks 集成已正式可用,并原生支持 Lakebase。在这篇博客中,我们将超越已发布的内容,深入探讨原因——为什么企业团队关心它、人们在构建什么应用,以及如何从零开始构建一个受治理的完整生产应用。让我们依次回答这些问题。
为什么企业团队应该将 Replit 与 Databricks 一起使用?
许多企业面临一个两难境地。他们拥有受治理的数据平台,但像运营经理、数据分析师和业务经理这样的最终用户仍然难以快速构建自定义应用来可视化这些数据并与之交互。
他们需要一种快速、无摩擦的方式来构建一个具有用户友好前端的应用、配置数据库、构建身份验证层、实施治理,并最终部署到生产环境。每一步都需要不同的团队和多个审批链。
以下是 Replit 与 Databricks 之间的集成如何缩短这一过程:
1. 公民开发者: Replit 让业务用户可以用自然语言描述一个应用。这个智能体会构建前端来可视化/交互企业数据,并自动配置底层的交易数据库。在部署到 Databricks 时,Replit 会强制执行 Databricks 治理,因此构建者只能看到 他们有权访问的数据
2. 内置治理: 该应用被部署为一个 Databricks App。每个应用都自动继承用户身份验证、安全访问控制以及与 Unity Catalog 的紧密集成。这节省了与安全和基础设施团队的多轮变更。
3. 原生 Lakebase 支持: 当应用准备好部署时,在幕后,Replit Agent 会自动为你的应用运营数据配置一个 托管的 Lakebase Postgres 数据库。这使你的应用能够从 Databricks 读取实时分析数据,并将其自身数据写回 Lakebase。Lakebase 充当应用程序的持久数据存储。
重要的是要了解 Lakebase 与外部数据库的比较。过去,在 Databricks 数据上构建应用的团队不得不依赖外部 Postgres 或 MySQL 实例来存储应用需要维护的数据。这些数据,例如用户输入或应用执行状态,会位于 Databricks 之外,要求企业管理并行的治理基础设施和权限模型。借助 Lakebase,你不再需要这样做。
以下是它们的比较:
| Lakebase | 外部数据库 | |
|---|---|---|
| 交易数据位置 | 在 Databricks 边界内 | 数据在 Databricks 之外 |
| 权限 | 运行时使用 Unity Catalog | 需要维护单独的模型 |
| 设置 | 由 Replit Agent 自动配置 | 手动配置、连接和安全设置 |
| 治理 | 继承血缘、审计和访问控制 | 需要单独的合规工作 |
| 成本模型 | 无服务器,空闲时缩减至零 | 始终开启或手动扩展 |
企业可以在 Databricks 上使用 Replit 构建各种现代应用。让我们看看三个企业应用,它们展示了无限可能。
场景 1:面向运营负责人的绩效管理应用
一位运营负责人想要评估各个加盟店的绩效,并与特定的加盟店主分享绩效分析。过去,公司依赖其 BI 开发人员为此分析制作仪表板。这种方式的问题始终是开发需要时间,仪表板不易实现自定义或采取行动,而深入探究下一个问题总是充满挑战或完全不可能。
然而,借助 Databricks 和 Replit,企业用户可以获得两全其美的结果——开发速度和企业的治理/安全。通过使用简单的提示,运营负责人可以构建一个多页面的运营应用,Replit 智能体会根据运营负责人的规格生成整个应用。它直接从 Unity Catalog 下的 Lakehouse 仓库读取实时的、受治理的数据。在生产环境中,每个用户各自的令牌会被传递,使得数据只与那些被允许查看自己敏感数据集的特定加盟店主共享。
这样的绩效应用适用于零售运营仪表板、加盟店绩效追踪器、区域销售视图、供应链状态。
场景 2:面向业务分析师的文档处理流水线
财务和运营分析师必须分析大量非结构化文档,如发票、表单和合同,并利用这些数据立即做出关键决策。
这些分析师可以创建文档处理流水线应用,这些应用摄取这些文档并使用 Databricks AI 函数将其从非结构化文件(PDF、文档、图像)转换为结构化字段。该应用将允许他们查询这些文档,这些文档现已作为结构化数据存储在 Lakebase 数据库中,并据此做出明智的决策。
该应用广泛适用于发票处理、合同提取、索赔接收、监管文档解析。
场景 3:自动化手动工作流的全栈应用
每个组织都有若干手动工作流,需要处理电子表格、电子邮件线程以及位于不同位置的数据来推动审批或报告更新。这可以很容易地通过一个应用来解决,该应用通过将所有数据汇集在一起并构建审批工作流引擎来自动化工作流。它从 Databricks 读取实时分析数据 并在人们使用时将新的运营数据捕获到 Lakebase 中。
我们见过客户为审批工作流、项目接收系统、供应商管理工具、合规跟踪、内部请求门户构建类似的应用程序。
如何将 Replit 与 Databricks Lakebase 配合设置?
通过一个四步流程,任何用户都可以使用 Replit 构建应用,并将其作为 Databricks 应用部署到 Databricks 环境中。首先将 Databricks 环境连接到 Replit,使用户能够根据提示构建自定义应用,借助 Unity Catalog 治理将其原生部署到 Databricks Apps,并自动为应用数据配置一个 Lakebase 数据库。
以下是四步流程

入门需要三个角色,大约 15 分钟。你的 Databricks 工作区应为不带合规安全配置文件的标准工作区,你的组织应使用 Replit Enterprise 计划。
下面的演练使用服务主体(M2M)连接器进行共享访问。Replit 还支持用户到机器(U2M)连接器,允许每位构建者使用自己的 Databricks 身份进行连接。请参阅此指南以选择正确的选项
步骤 1:创建服务主体(Databricks 管理员)
在 Databricks 账户控制台中:
- 为 Databricks ↔ Replit 连接创建一个服务主体
- 生成客户端 ID 和密钥
- 将该服务主体分配到目标工作区
- 为其授予适当的权限(通常是访问 SQL 仓库以及应用将使用的目录/架构)
示例权限授予:
步骤 2:添加 Databricks 连接器(Replit 组织管理员)
在 Replit 中:
- 导航到你的组织的连接器设置
- 添加一个新的 Databricks(服务主体)连接器
- 输入步骤 1 中的客户端 ID 和密钥
- 可选地配置 RBAC 以控制哪些 Replit 用户可以使用该连接器
步骤 3:激活并连接(Replit Enterprise 用户)
- 在你的 Replit 项目中激活 Databricks 连接器
- 提供你的 SQL 仓库的 HTTP 路径 和 服务器主机名以完成连接
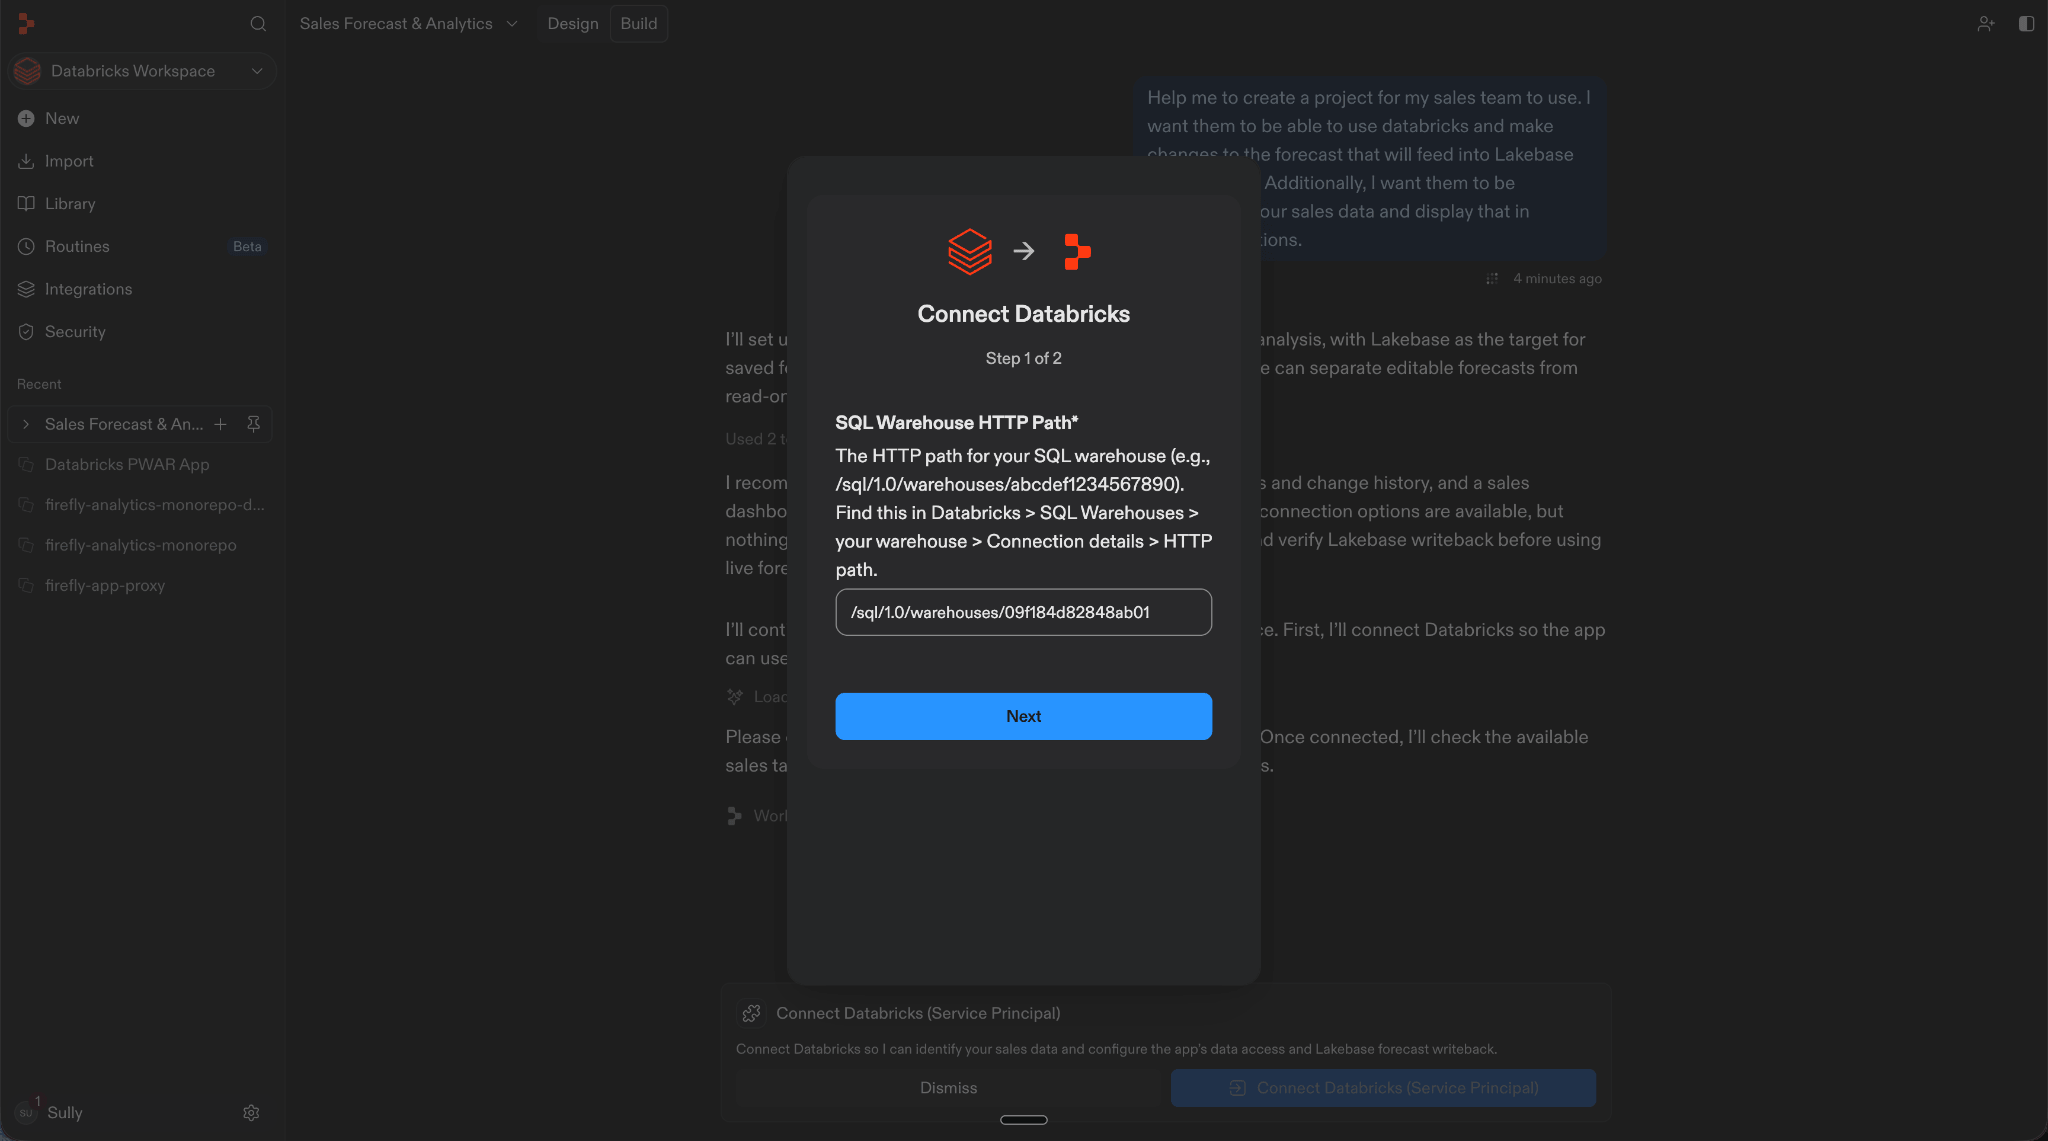
步骤 4:提示、构建并部署
- 用通俗语言描述你想构建的应用,并指明你想使用的仓库和数据
- 跟随智能体探索你的架构、生成查询并构建前端
- 在预览环境中测试
- 通过一个操作部署到 Databricks Apps
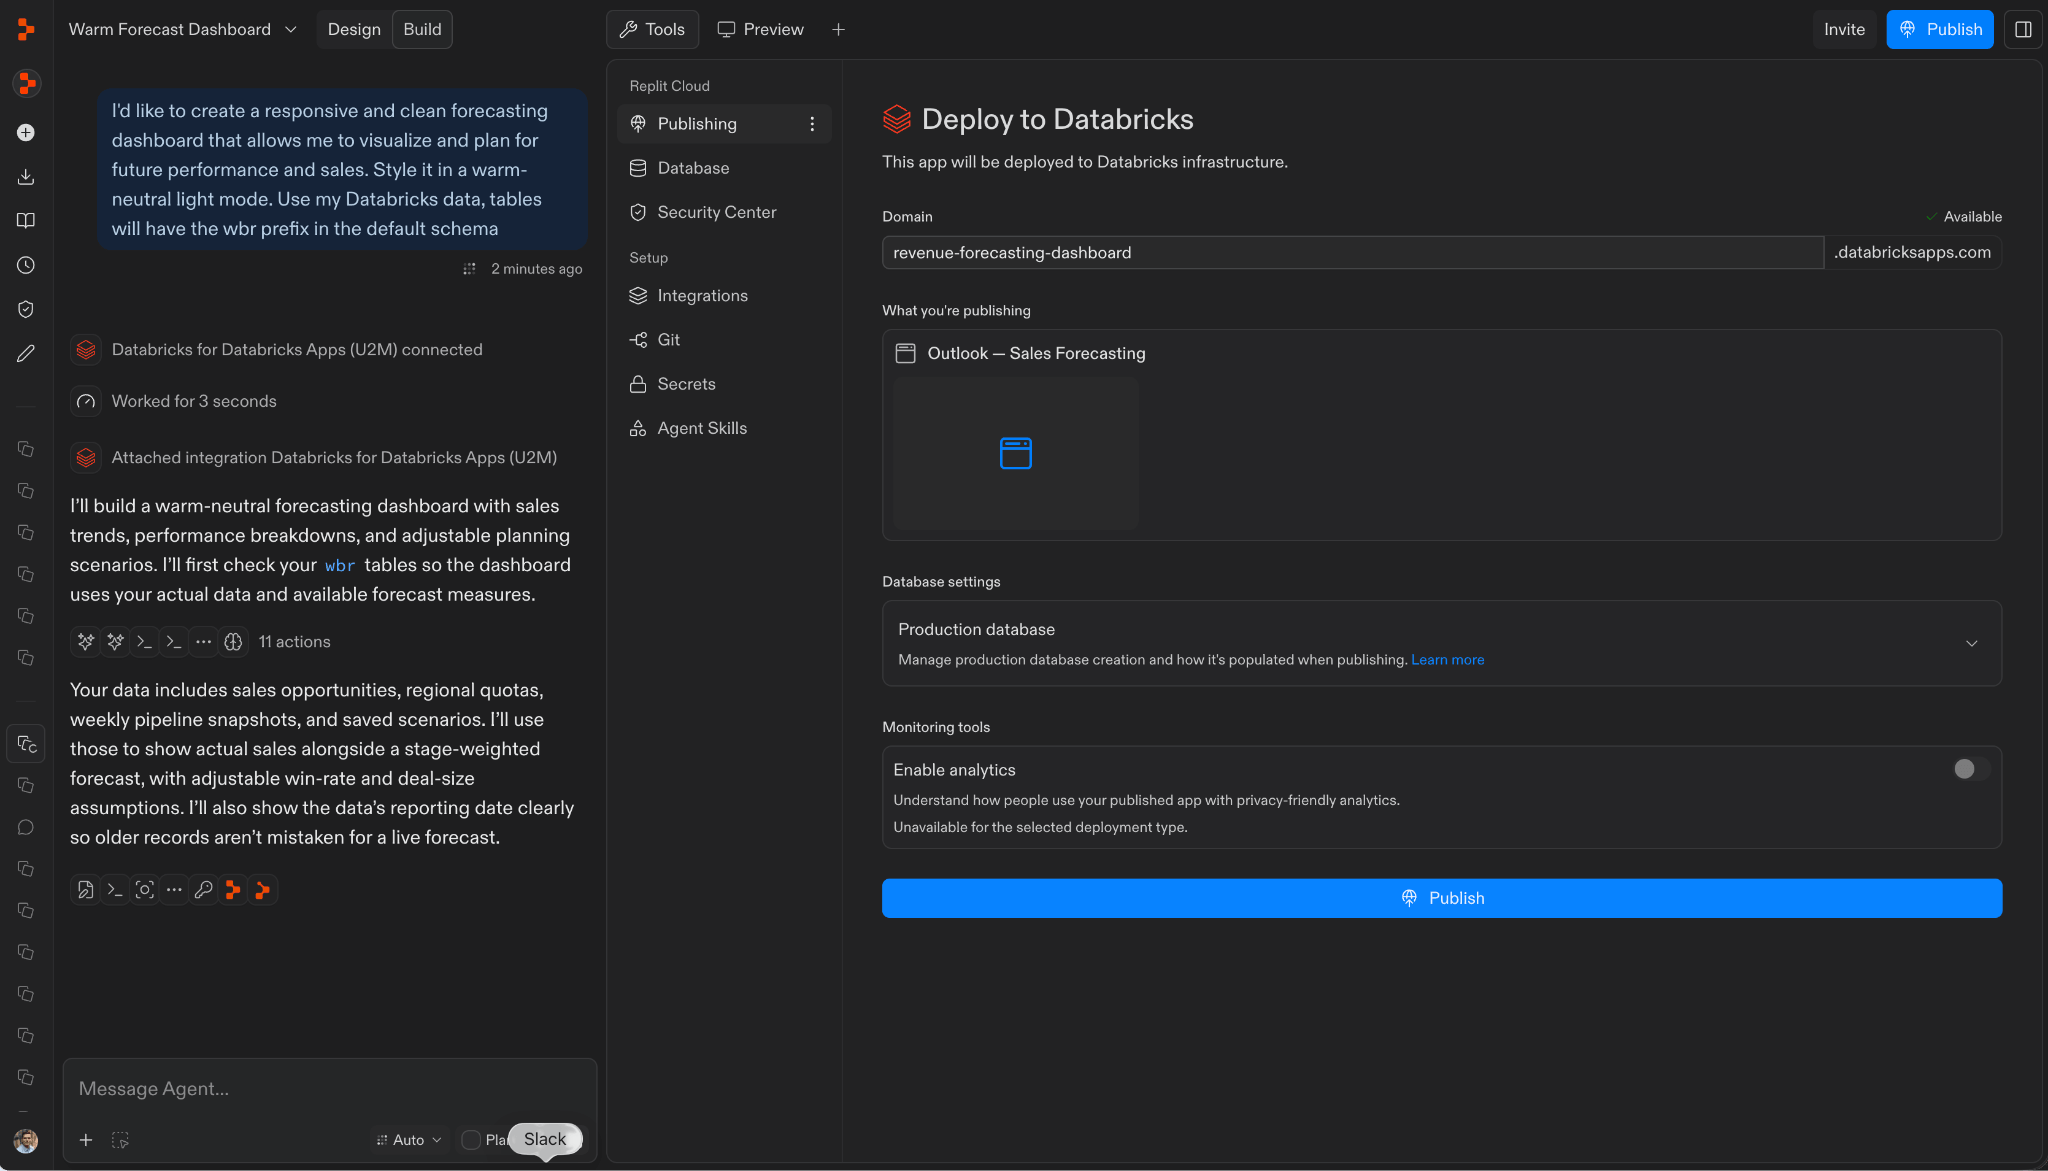
查看该集成的实际运行;
常见问题解答
什么是 Replit Databricks 集成? Replit 与 Databricks 的结合为企业提供了一个从开发到部署的完整平台。通过这一集成,企业团队可以使用 Replit Agent 构建受治理的应用程序,该智能体在实时 Databricks 数据上运行,并将其部署到具有原生 Lakebase 支持的 Databricks Apps。无论用户是业务负责人、数据分析师还是开发人员,他们都可以根据通俗语言的提示 vibe code 出一个生产级应用
Replit 如何连接到 Databricks? Replit 同时支持用户到机器(U2M)OAuth(使用每位构建者自己的 Databricks 身份和权限)和服务主体(M2M)OAuth(使用共享的服务身份)。本指南介绍服务主体设置。
什么是 Lakebase,为什么它对 Replit 应用很重要? Databricks Lakebase Postgres 是一项完全托管、无服务器的 Postgres 服务,运行在 Databricks 环境内。对于 Replit 应用,它提供了一个事务型数据库,用于存储应用特定的数据,如用户输入、应用执行状态,而无需一个位于 Databricks 环境之外的单独数据库。Replit Agent 在部署时自动配置 Lakebase 数据库。
非开发人员可以使用 Replit 在 Databricks 上构建应用吗? 可以。Replit Agent 让业务用户用通俗语言描述一个应用。该智能体不仅会构建用于可视化/交互企业数据的前端、配置底层事务型数据库,还会强制执行治理,使他们只能看到在 Databricks 中有权查看的数据,然后将其部署为生产就绪的应用程序
在 Replit 构建的 Databricks 应用中,治理是如何强制执行的? 该应用作为 Databricks 应用部署。因此,每个应用都会继承自动用户身份验证、安全访问控制以及与 Unity Catalog 的紧密集成。这节省了与安全和基础设施团队的大量反复沟通。
Replit 应用可以将数据写回 Databricks 吗? 可以。它可以将任何运营数据写入 Lakebase。该应用可以通过 SQL 仓库从 Databricks 读取分析数据,并将运营数据(提交、审批、状态)写入 Lakebase Postgres 数据库。
什么是受监督的 AI 迁移? 受监督的 AI 迁移确保 Replit Agent 提出的任何数据库架构变更在进入生产环境之前都需要团队批准。
什么是自动预览部署? 自动预览部署允许你在应用上线前对其进行测试。Replit 会创建一个单独的测试环境,以便团队可以在测试环境中构建、审查更改并进行调整,而不影响生产环境。
Replit Databricks 集成费用是多少? 该集成需要 Replit Enterprise 计划和 Databricks 用量(SQL 仓库计算和 Lakebase)。Databricks 计算是无服务器的。因此,它会在负载下扩展,并在完成后空闲至零,所以你只需为使用的部分付费。
我在哪里可以看到 Replit Databricks 集成的实际运行?注册参加 11 月 10 日(星期二)即将举行的网络研讨会 "在 Databricks Lakebase 上构建全栈应用"。观看完整的从构建到部署演示:如何使用 Lakebase Postgres 在 Replit 中构建生产就绪的应用。
后续步骤
- 参加我们 11 月 10 日即将举行的网络研讨会——现场演示如何使用 Replit 在 Databricks 上构建和部署一个受治理的应用。注册参加 11 月 10 日(星期二)即将举行的网络研讨会 "在 Databricks Lakebase 上构建全栈应用"。
- 观看演示——查看完整的从构建到部署流程的实际运行:如何使用 Lakebase Postgres 在 Replit 中构建生产就绪的应用
- 探索该集成——访问 replit.com/partners/databricks
- 阅读设置指南—— 将 Replit 连接到 Databricks,见 Databricks 文档
- 在数据与人工智能世界巡回大会上与我们相见 — Replit 将加入 Databricks 在全球各地的世界巡回大会站点,包括圣保罗、孟买、芝加哥、纽约、伦敦和东京。 在此注册
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏