美联航用Redshift联邦查询Databricks数据
DataHot 速览
AWS与美联航工程师介绍,美联航每天处理数十亿事件,数据平台横跨Amazon Redshift和Databricks Unity Catalog。为在不复制数据的情况下打通平台,团队使用AWS Glue Data Catalog联邦,让Redshift Serverless可直接对S3中的Iceberg表运行实时SQL查询。方案避免了将数据复制到Redshift Managed Storage并维护同步管道。文中还提到Redshift Serverless所用Graviton查询引擎对比前代可带来最高2倍数据湖查询性能。
为什么值得关注:该实践展示了跨Redshift与Databricks的湖仓目录联邦和零拷贝查询架构,对多平台数据集成、避免冗余同步、提升分析时效有直接参考价值。
本文目录 15 节
译文
AI 逐段翻译本文由来自United Airlines的Ankit Aggarwal和Raja Kalluri共同撰写。
United Airlines每天在其数据平台上处理数十亿个事件,该平台涵盖Amazon Redshift和带Unity Catalog的Databricks。为了在不复制数据的情况下桥接这些平台,团队转向了AWS Glue Data Catalog联邦。
在本文中,我们将介绍如何配置AWS Glue Data Catalog联邦以连接Databricks Unity Catalog,以便您可以从Amazon Redshift运行实时SQL查询,而无需移动或复制数据。
为什么United Airlines需要目录联邦
United Airlines通过Amazon Simple Storage Service(Amazon S3)上的medallion架构(从bronze到silver再到gold)管理数PB的数据。仅航空公司用户交互数据层就有数十TB的近实时流式数据。团队使用它来衡量Web和移动触点上的客户参与模式、功能采用情况和转化行为。分析师需要通过Amazon Redshift Serverless查询这些经过管理的数据。作为现有数据平台架构的一部分,这些数据表被编目在Databricks Unity Catalog中,而不是AWS Glue Data Catalog中。因此,Amazon Redshift无法原生查看它们。如果没有目录联邦,使这些数据可从Amazon Redshift查询的唯一方法就是将其复制到Amazon Redshift Managed Storage(RMS)中,并构建管道使其保持同步。
AWS Glue Data Catalog联邦消除了这一需求。Amazon Redshift用户现在可以直接查询存储在Amazon S3中的gold层,Iceberg元数据在查询时从Unity Catalog解析,且无需移动数据。AWS Glue Data Catalog联邦将Amazon Redshift连接到Unity Catalog等外部目录,因此分析师可以查询跨平台数据,而无需构建同步管道或复制存储。
Amazon Redshift Serverless由与新的RG实例系列相同的基于Graviton的查询引擎提供支持,该引擎可提供高达2倍更快的数据湖查询性能相比前几代产品。该引擎专为直接从Amazon S3读取Apache Iceberg表而构建,非常适合此类联邦查询工作负载。
United Airlines正在采取分阶段方法,在其数据平台中采用AWS Glue Data Catalog联邦。最初的重点是使用最频繁的用户交互数据表,目前生产环境中有30个表已联邦,另有70个表正在积极推广中。未来几个月计划将不同业务领域的另外数百个表投入生产。
解决方案概述
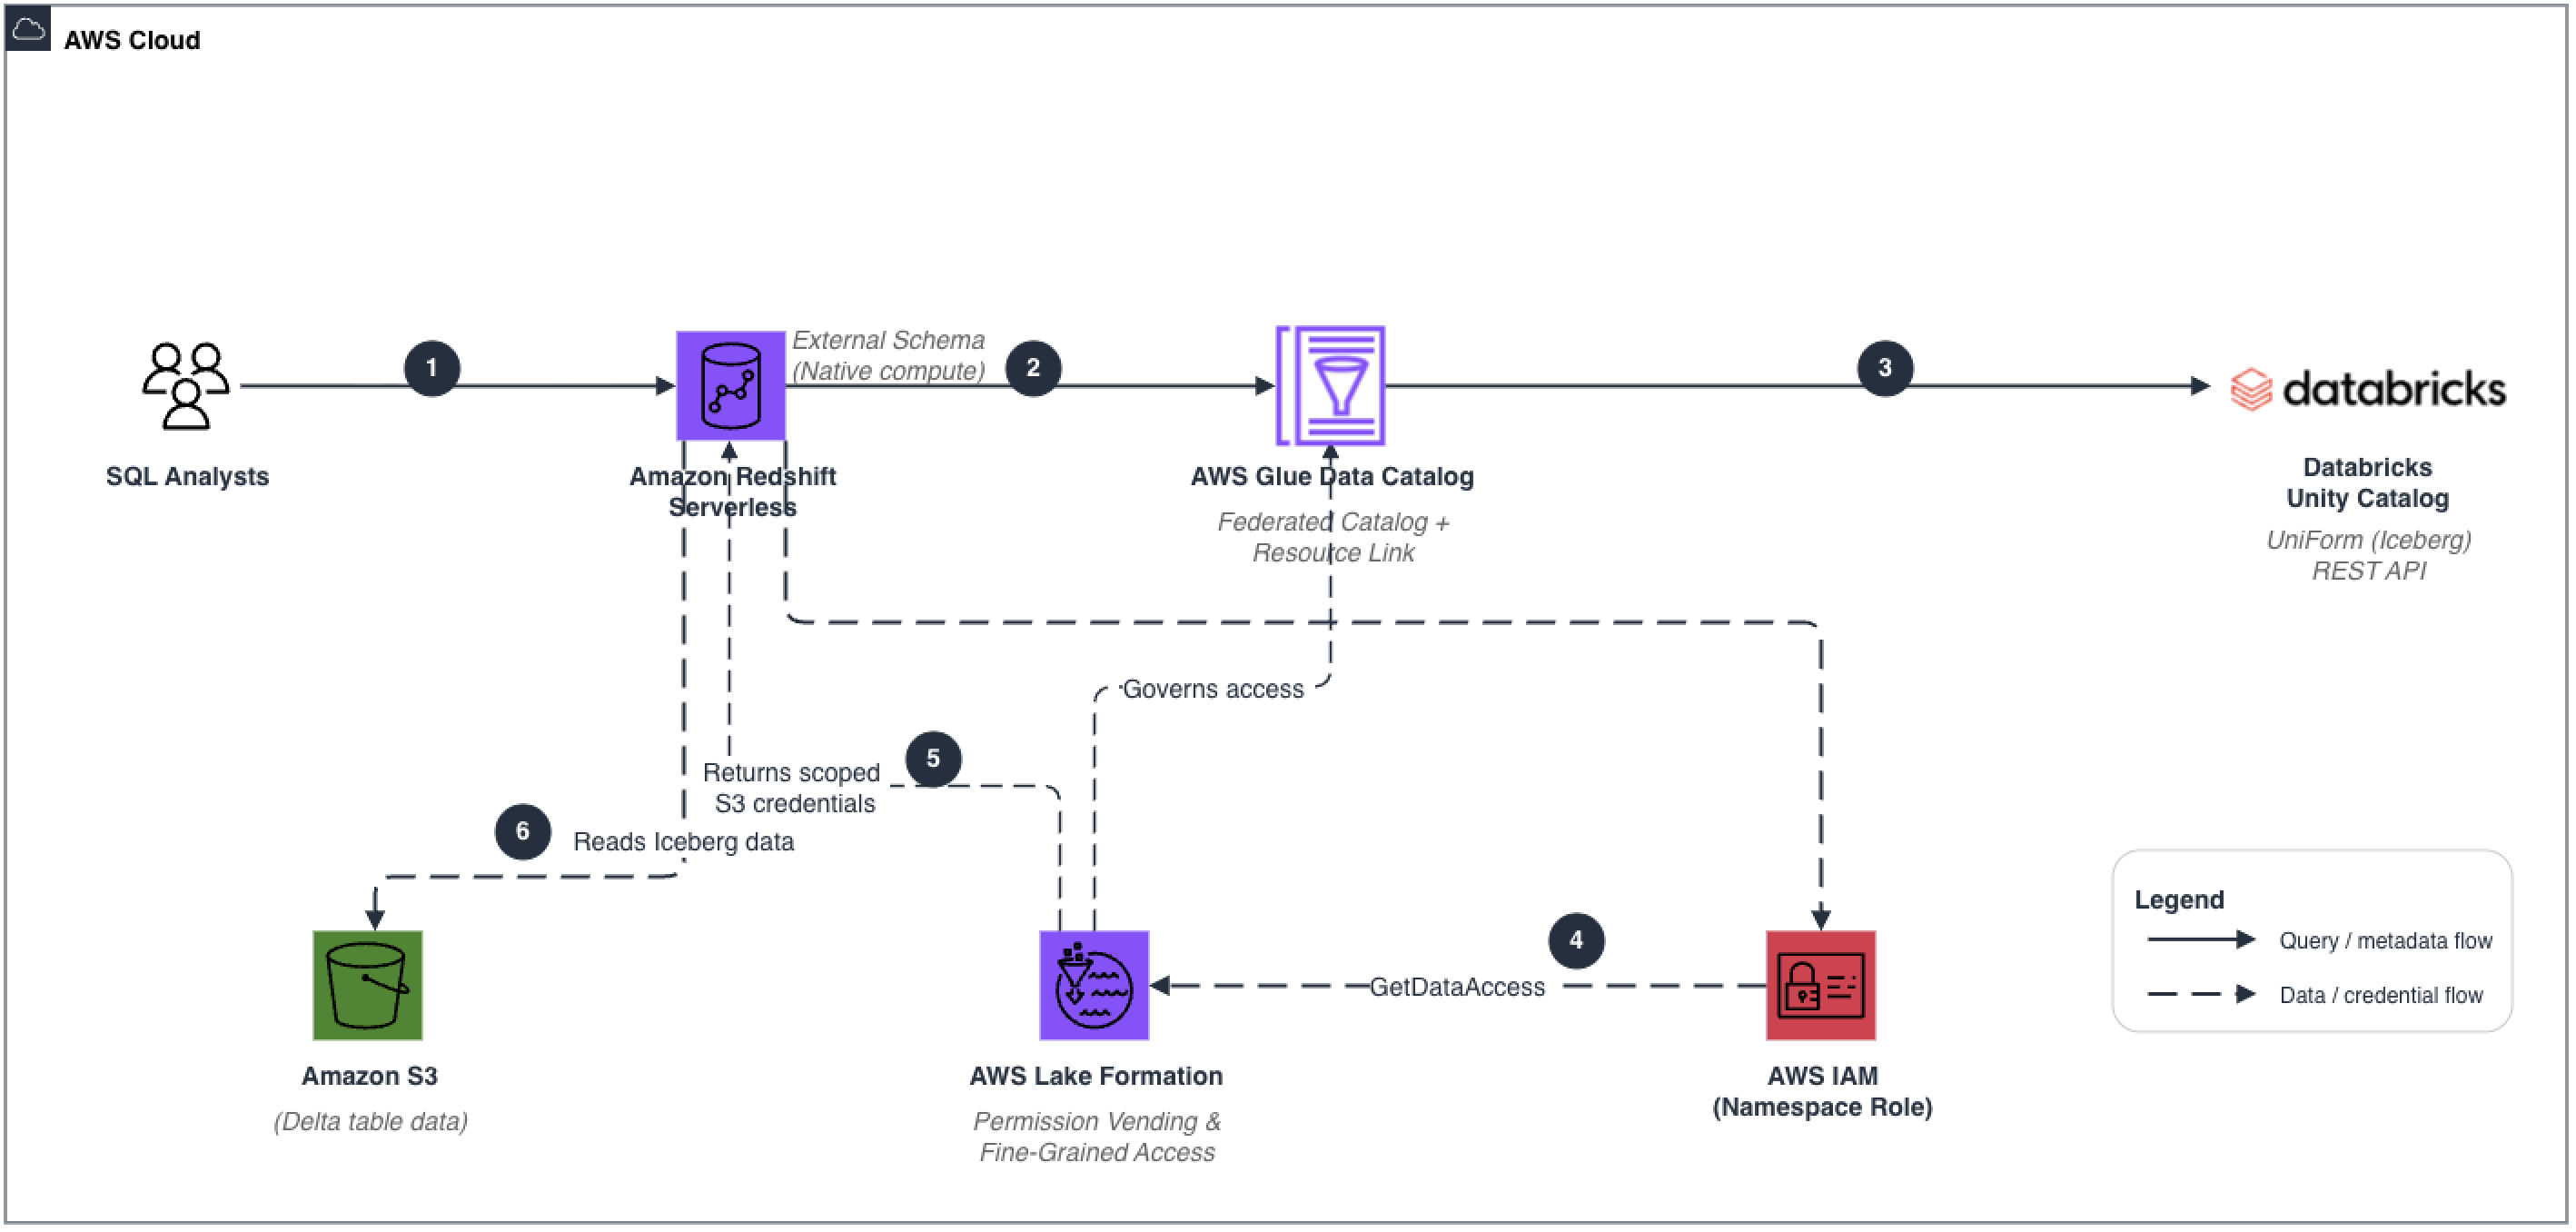
AWS Glue Data Catalog联邦在元数据层桥接这些平台。以下是该架构的工作方式。
该架构遵循四层联邦链:
- Databricks Unity Catalog通过其Iceberg REST API端点公开表。对于Delta表,您可以开启UniForm格式使其与Iceberg兼容。
- AWS Glue Data Catalog创建一个联邦目录,连接到Databricks Unity Catalog,使元数据在AWS内可见,而无需移动数据。
- 默认AWS Glue目录中的资源链接数据库充当桥梁,指向联邦目录数据库。这是Amazon Redshift计算所必需的。
- Amazon Redshift Serverless通过外部schema引用资源链接数据库。当查询运行时,Amazon Redshift会遍历该链接,调用AWS Glue Federation,并通过Databricks Unity Catalog REST API读取Iceberg数据。AWS Lake Formation在整个链路中管理权限。
此解决方案中使用的关键服务或服务功能:
- AWS Glue Data Catalog – 默认目录中的联邦目录和资源链接。
- AWS Lake Formation – 权限发放和精细访问控制。
- Amazon Redshift Serverless – 通过外部schema进行查询。
- AWS Identity and Access Management(IAM) – Amazon Redshift命名空间和SAML认证用户的基于角色的权限。
- Databricks Unity Catalog – 通过REST API公开Iceberg表的源目录。
图1:从Databricks Unity Catalog通过AWS Glue和Lake Formation到Amazon Redshift Serverless的联邦链
该架构遵循六步流程:
- SQL分析师向Amazon Redshift Serverless提交查询。
- Amazon Redshift通过AWS Glue Data Catalog(指向联邦目录的资源链接)解析外部schema。
- AWS Glue联邦目录调用Databricks Unity Catalog Iceberg REST API以检索当前表元数据。
- 命名空间IAM角色调用AWS Lake Formation GetDataAccess以获取限定范围的临时S3凭证。
- Lake Formation评估精细访问策略,并为已授权的数据文件发放凭证。
- Amazon Redshift Serverless直接从S3读取Iceberg数据文件并将结果返回给分析师。
先决条件
在开始之前,请确保已满足以下条件:
- 一个启用了Unity Catalog的Databricks工作区,以及至少一个目录、schema和表。Databricks使用UniForm在Amazon S3上的Delta Lake表上生成Iceberg元数据。
- 一个具有管理AWS Glue、AWS Lake Formation、Amazon Redshift Serverless和IAM权限的AWS账户。
- 已预置的Amazon Redshift Serverless工作组和命名空间。
- 已设置AWS Lake Formation并配置数据湖管理员。
- 已使用适当凭证配置AWS Command Line Interface(AWS CLI)。
- 熟悉Amazon Redshift Query Editor v2或SQL客户端。
注意: 有关设置Databricks Unity Catalog侧(第1阶段),请按照AWS博客文章Access Databricks Unity Catalog data using catalog federation in the AWS Glue Data Catalog中的步骤操作。本演练从AWS Glue中创建联邦目录之后开始。
解决方案演练
该演练分为六个步骤,涵盖 Lake Formation 配置、资源链接模式、IAM 角色设置以及从 Amazon Redshift 查询 Databricks 表。
步骤 1:配置 AWS Lake Formation
1a. 添加数据湖管理员
- 在 Lake Formation 中,选择 Administration,然后选择 Administrators 并添加您的管理员 IAM 用户或角色。
1b. 确认联合目录已注册
- 选择 Data Catalog,然后选择 Catalogs 并确认 databricks-federated-catalog 可见且已注册。
步骤 2:在默认 AWS Glue 目录中创建资源链接
此步骤是演练中的关键架构细节。Amazon Redshift 仅针对默认 AWS Glue Data Catalog 解析 CREATE EXTERNAL SCHEMA。联合目录(databricks-federated-catalog)是一个独立的非默认目录对象。为了给 Amazon Redshift 提供一条通往联合数据的路径,您需要在默认目录中创建一个资源链接数据库,指向联合目录的数据库。
资源链接不会复制数据或元数据。它是一个指针,由 Lake Formation 在查询时解析。
要在 Lake Formation 控制台中创建资源链接:
- 选择 Data Catalog、Databases、Create database。然后选择 Resource link。
- 对于 Resource link name,输入 databricks_federated_db_link。
- 对于 Target catalog,输入 databricks-federated-catalog。
- 对于 Target database,输入由 AWS Glue 爬网程序发现的数据库名称(例如 databricks_federated_db)。
或者,使用 AWS CLI:
aws glue create-database \
  --database-input '{
    "Name": "databricks_federated_db_link",
    "TargetDatabase": {
      "CatalogId": "<account-id>:databricks-federated-catalog",
      "DatabaseName": "databricks_federated_db"
    }
  }'
步骤 3:配置 Amazon Redshift Serverless 命名空间 IAM 角色
当 Amazon Redshift 通过资源链接进行查询时,它使用附加到 Amazon Redshift Serverless 命名空间的 IAM 角色调用 Lake Formation GetDataAccess API。必须向此命名空间角色授予 Lake Formation 权限。
从以下两种方法中选择一种:
- 选项 A – 通过以内联方式添加以下策略来更新现有命名空间角色。
- 选项 B – 创建一个新的专用角色(名为 RedshiftServerlessNamespaceRole)并将其与现有角色一起附加到命名空间。
将以下 IAM 策略附加到该角色:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": [
        "glue:GetDatabase",
        "glue:GetDatabases",
        "glue:GetTable",
        "glue:GetTables",
        "glue:GetPartitions",
        "glue:GetCatalog",
        "glue:GetCatalogs"
      ],
      "Resource": "*"
    },
    {
      "Effect": "Allow",
      "Action": "lakeformation:GetDataAccess",
      "Resource": "*"
    }
  ]
}注意:此策略中的 Resource: “*” 为简化起见而显示。在生产环境中,请根据您的使用场景将资源范围限定为特定的 AWS Glue 目录 ARN、数据库 ARN 和表 ARN。*
创建或更新角色后,将其与您的 Amazon Redshift Serverless 命名空间关联:
- 在 Amazon Redshift Serverless 控制台中,选择 Namespaces,选择 [您的命名空间],然后选择 Security and encryption,然后选择 Manage IAM roles。
- 如果您使用选项 A,现有角色已具有新权限,因此无需更改。
- 如果您使用选项 B,请将新角色与现有角色一起添加。
步骤 4:向 Amazon Redshift 命名空间角色授予 Lake Formation 权限
4a. 授予对资源链接数据库(默认目录)的 DESCRIBE 权限
- 在 Lake Formation 中,选择 Permissions, Data lake permissions,然后选择 Grant。
- Principal:RedshiftServerlessNamespaceRole。
- Resources:Named Data Catalog resources, Default catalog, databricks_federated_db_link (resouce link)。
- Database permissions:DESCRIBE。
4b. 授予对目标表的 SELECT 和 DESCRIBE 权限(Grant on Target)
资源链接仅允许对链接本身授予 DESCRIBE 和 DROP 权限。要允许 Amazon Redshift 实际读取数据,您必须单独授予对联合目录中目标表的 SELECT 权限。这就是 Lake Formation Grant on Target 模式。
- Principal:RedshiftServerlessNamespaceRole。
- Resources:Named Data Catalog resources, databricks-federated-catalog, databricks_federated_db,然后选择 Tables。
- Table permissions:SELECT, DESCRIBE。
- Catalog permission:DESCRIBE。
重要: 必须对联合目录中的目标表授予 SELECT 权限,而不是对资源链接授予。仅在资源链接上授予 SELECT 不会生效。这是一个常见的配置错误。
步骤 5:在 Amazon Redshift 中创建外部架构
在资源链接就位且权限已授予后,您现在可以在 Amazon Redshift 中创建一个指向资源链接数据库的外部架构。外部架构是查询接口。当用户对其运行 SQL 时,Amazon Redshift 会遍历链接到联合目录,并从 Databricks Unity Catalog 检索元数据和数据。
DATABASE 参数必须引用默认 AWS Glue 目录中的资源链接数据库名称(databricks_federated_db_link),而不是直接引用联合目录名称。此处不需要 CATALOG_ARN 参数,因为资源链接位于默认目录中,Amazon Redshift 会自动解析它。
以超级用户身份连接到您的 Amazon Redshift 集群(例如,使用 Amazon Redshift Query Editor v2)并运行:
CREATE EXTERNAL SCHEMA databricks_schema
FROM DATA CATALOG
DATABASE 'databricks_federated_db_link'
IAM_ROLE '<iam-role-arn>'
REGION '<region>';
此架构中的一个关键设计原则是明确区分物理存储在 Amazon Redshift 中的数据与通过联合从外部访问的数据。外部架构提供透明的抽象层,因此 Amazon Redshift 用户无需摄取即可查询存储在 S3 中的数据。为保持一致性和清晰性,United Airlines 对 Amazon Redshift 中的所有联合架构遵循标准命名约定:{domain}_iceberg。此约定可立即表明数据并非原生存储在 Amazon Redshift 中,而是通过 AWS Glue 和 Lake Formation 使用联合进行访问。这种区分对分析师和工程师至关重要,因为它提高了可发现性,避免了存储层之间的歧义,并在跨混合数据环境工作时强化了架构纪律。
User Interactions 域公开了表示客户交互活动、参与行为和渠道使用模式的精选数据集。运营数据集遵循相同的模式,通过共同的联合框架提供对支持性业务事件和参考信息的受治理访问。
您使用 WITH NO SCHEMA BINDING 在每个外部架构上创建一个视图层,以便分析师在每次查询执行时始终解析最新的架构。例如:
CREATE VIEW analytics.clickstream_events AS
SELECT * FROM {domain}_iceberg.interaction_events
WITH NO SCHEMA BINDING;
第 6 步:从 Amazon Redshift 验证并查询 Databricks 表
创建外部架构后,验证 Databricks 表是否可见,并运行测试查询。
验证表可见性
-- Confirm federated tables are visible in Redshift
SELECT * FROM SVV_EXTERNAL_TABLES
WHERE schemaname = 'databricks_schema';
查询 Databricks Unity Catalog 表
-- Query a Databricks Unity Catalog table via the federated catalog
SELECT *
FROM databricks_schema.<table_name>
LIMIT 10;
当查询运行时,Amazon Redshift 使用命名空间 IAM 角色调用 Lake Formation GetDataAccess 以获取临时凭证。然后它联系 AWS Glue 联合目录,后者又调用 Databricks Unity Catalog Iceberg REST API 以检索元数据并读取表数据。结果透明地返回给 Amazon Redshift 用户。
对于 SAML 认证的用户,请使用您的 IdP JDBC 插件进行连接:
jdbc:redshift:iam://<workgroup-name>.<account-id>.<region>.redshift-serverless.amazonaws.com:5439/<database>
?plugin_name=com.amazon.redshift.plugin.<YourIdPPlugin>
&idp_host=<your-idp-host>
&preferred_role=arn:aws:iam::<account-id>:role/RedshiftSAMLUserRole
&ssl=true
Amazon Redshift JDBC 驱动程序自动处理身份验证。它向您的 IdP 进行身份验证,接收 SAML 断言,并调用 sts:AssumeRoleWithSAML 获取临时 IAM 凭证。然后它调用 redshift-serverless:GetCredentials 以映射的数据库用户身份进行连接。
业务影响
AWS Glue Data Catalog 联合为 United Airlines 带来了可衡量的架构和运营改进:
| 领域 | 之前 | 之后 | 影响 |
| 数据访问 | Delta Lake 和 Amazon Redshift 数据完全孤立,因此 Amazon Redshift 用户无法访问 Databricks 管理的 S3 数据上的精选数据集 | Amazon Redshift 用户通过 AWS Glue Data Catalog 联合获得对 Databricks 管理数据的实时访问 | 第一阶段约 100 名分析师获得了对用户交互数据表的访问权限,而无需添加新的管道。 |
| 灾难恢复 | 跨区域灾难恢复依赖每 3 小时一次的 Amazon Redshift 快照(恢复点目标,即 RPO,为 3 小时或更长) | Delta Lake 上的 Amazon S3 跨区域复制提供近乎连续的 RPO。灾难恢复区域中新的 Amazon Redshift Serverless 工作组可以联合到相同的 S3 数据 | 更具弹性的架构。降低了跨区域维护 Amazon Redshift 快照和副本的成本 |
| 架构简化 | 数据处理在 Databricks 和 Amazon Redshift 中同时进行,需要在两个平台之间手动同步目录,这在运营上成本高昂且容易出现漂移 | 在联合架构下,数据处理整合到 Databricks 中,Amazon Redshift 仅作为查询引擎,通过目录联合为用户查询和仪表板提供支持 | 单一处理平台、零同步管道、单一事实来源 |
| 基础设施成本 | 运行专用的 Amazon Redshift ETL 集群,使用 RMS 存储、快照和计算进行数据处理 | 对于此联合用例,Amazon Redshift 不需要用于 ETL,而仅作为查询引擎。无需 RMS 存储重复,无需快照复制 | 每月减少约 3 万美元的冗余 ETL 基础设施成本 |
安全考虑
在 United Airlines,身份治理通过 Azure Active Directory 组统一。在 AWS 消费端,用户通过 SAML 联合向 Amazon Redshift Serverless 进行身份验证。AD 组成员身份决定了对联合架构的数据库级访问。在 Databricks 端,相同的 AD 组管理对 Unity Catalog 架构的访问。这种单一身份模型在无需单独配置用户的情况下,在两个平台上提供了一致的访问控制。Lake Formation 在联合查询期间处理 S3 数据访问的凭证发放,而架构级访问决策则通过每个平台上的 AD 组映射进行管理。
该架构还在联合链中内置了多层安全控制:
- AWS Lake Formation 在整个联合链中管理细粒度访问控制,因此主体只能访问已授权的数据库、表和列。
- IAM 角色遵循最小权限原则。Amazon Redshift 命名空间角色仅被限定用于 AWS Glue 元数据操作和 Lake Formation GetDataAccess。
- 基于 SAML 的身份验证集成了企业身份提供商,因此用户在访问联合数据之前通过现有的 SSO 基础设施进行身份验证。
- 所有 Amazon Redshift 连接都强制使用 TLS 加密(ssl=true),保护客户端与 Amazon Redshift 端点之间的传输中数据。
- Lake Formation 权限发放为每次查询执行签发短期、限定范围的凭证,而不是长期静态凭证。
其他注意事项
请查看 目录联合服务限制 后再部署。关键要求:
- Delta Lake 表必须启用 UniForm 以公开 Iceberg 兼容的元数据。
- 我们建议源表进行良好的分区并定期压缩,因为联合查询性能反映了数据在写入时组织的效率。
清理
为避免本演练中创建的资源产生持续费用,请按以下顺序将其删除。此拆除不会影响 Databricks 元数据或存储在 Amazon S3 中的底层数据。
- 在 Amazon Redshift 中删除外部架构:
DROP SCHEMA databricks_schema;。 - 在默认 AWS Glue 目录中删除资源链接数据库(databricks_federated_db_link)。
- 撤销授予 Amazon Redshift 命名空间角色在资源链接数据库和联合目录中目标表上的 Lake Formation 权限。
- 在 AWS Glue 中删除联合目录(databricks-federated-catalog)。
- 如果不再需要,请注销 Databricks Unity Catalog 的 AWS Glue 连接。
- 可选地,如果 IAM 角色(RedshiftServerlessNamespaceRole)仅为此演练创建,请将其删除。
结论
在本文中,我们展示了 United Airlines 如何使用 AWS Glue Data Catalog 联合,让 Amazon Redshift Serverless 分析师实时访问 Amazon S3 上数十 TB 的精选用户交互数据,而无需复制一个字节或构建同步管道。
该架构使用 Iceberg REST API、资源链接数据库和 Lake Formation 凭证分发,在 Amazon Redshift 与 Unity Catalog 之间创建了一条受治理的查询路径。对于 United Airlines 而言,这消除了冗余的 ETL 基础设施成本,免除了目录同步的需要,并将 Amazon Redshift Serverless 转变为面向分析师和仪表板的专用高性能查询引擎。
如有问题或反馈,请在此文章下留言评论。
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏