Lakebase Search:为 Postgres 带来全文与向量搜索
DataHot 速览
Lakebase 为 Postgres 推出 Lakebase Search,包含 lakebase_vector(可扩展近似邻居搜索)和 lakebase_text(BM25 全文搜索)两个扩展,现已在 AWS 和 Azure 正式可用。官方称在 VectorDBBench 100M 基准上,lakebase_vector 吞吐量达到次优系统的 2 倍,成本仅为使用 pgvector 的云 Postgres 厂商的 1/4。其测试显示在 100M LAION 数据集上,97% recall 时 P99 延迟为 71 毫秒。客户 Conexiom 使用 BM25 混合搜索处理超 1 亿行数据,计算资源仅为此前 pgvector 方案的一半。
为什么值得关注:Lakebase 把向量与 BM25 全文搜索直接放进 Postgres,瞄准 AI Agent 的低延迟、高准确检索需求,并给出吞吐、成本、延迟与召回率数据。数据平台从业者可据此评估是否仍需外挂独立搜索/向量数据库,以及 pgvector 在规模化后的替代路径。
本文目录 10 节
译文
AI 逐段翻译传统 OLTP 系统并非为 AI 代理的搜索需求而构建。它们需要在所有数据上实现低延迟、高准确率的检索,并且经常执行大规模并行搜索。到目前为止,解决这个问题意味着用 ETL 管道将一个独立的搜索引擎硬接到你的主数据库上。
但如果你的 OLTP 数据库能够直接高效地运行搜索工作负载呢?
今天,我们通过两个扩展将快速且可扩展的搜索引擎带到 Lakebase Postgres:lakebase_vector(可扩展的近似邻居搜索)和 lakebase_text(bm25 全文搜索)。这两个扩展已在 AWS 和 Azure 上正式可用。
借助 lakebase_vector,Postgres 如今处于向量搜索的前沿。它在效率和可扩展性上超越了专用搜索引擎。在 VectorDBBench 100M 基准测试中,它提供的吞吐量是次优系统的两倍,并且比使用 pgvector 的云 Postgres 供应商便宜 4 倍,而这还没有计入自动扩缩容带来的额外节省。
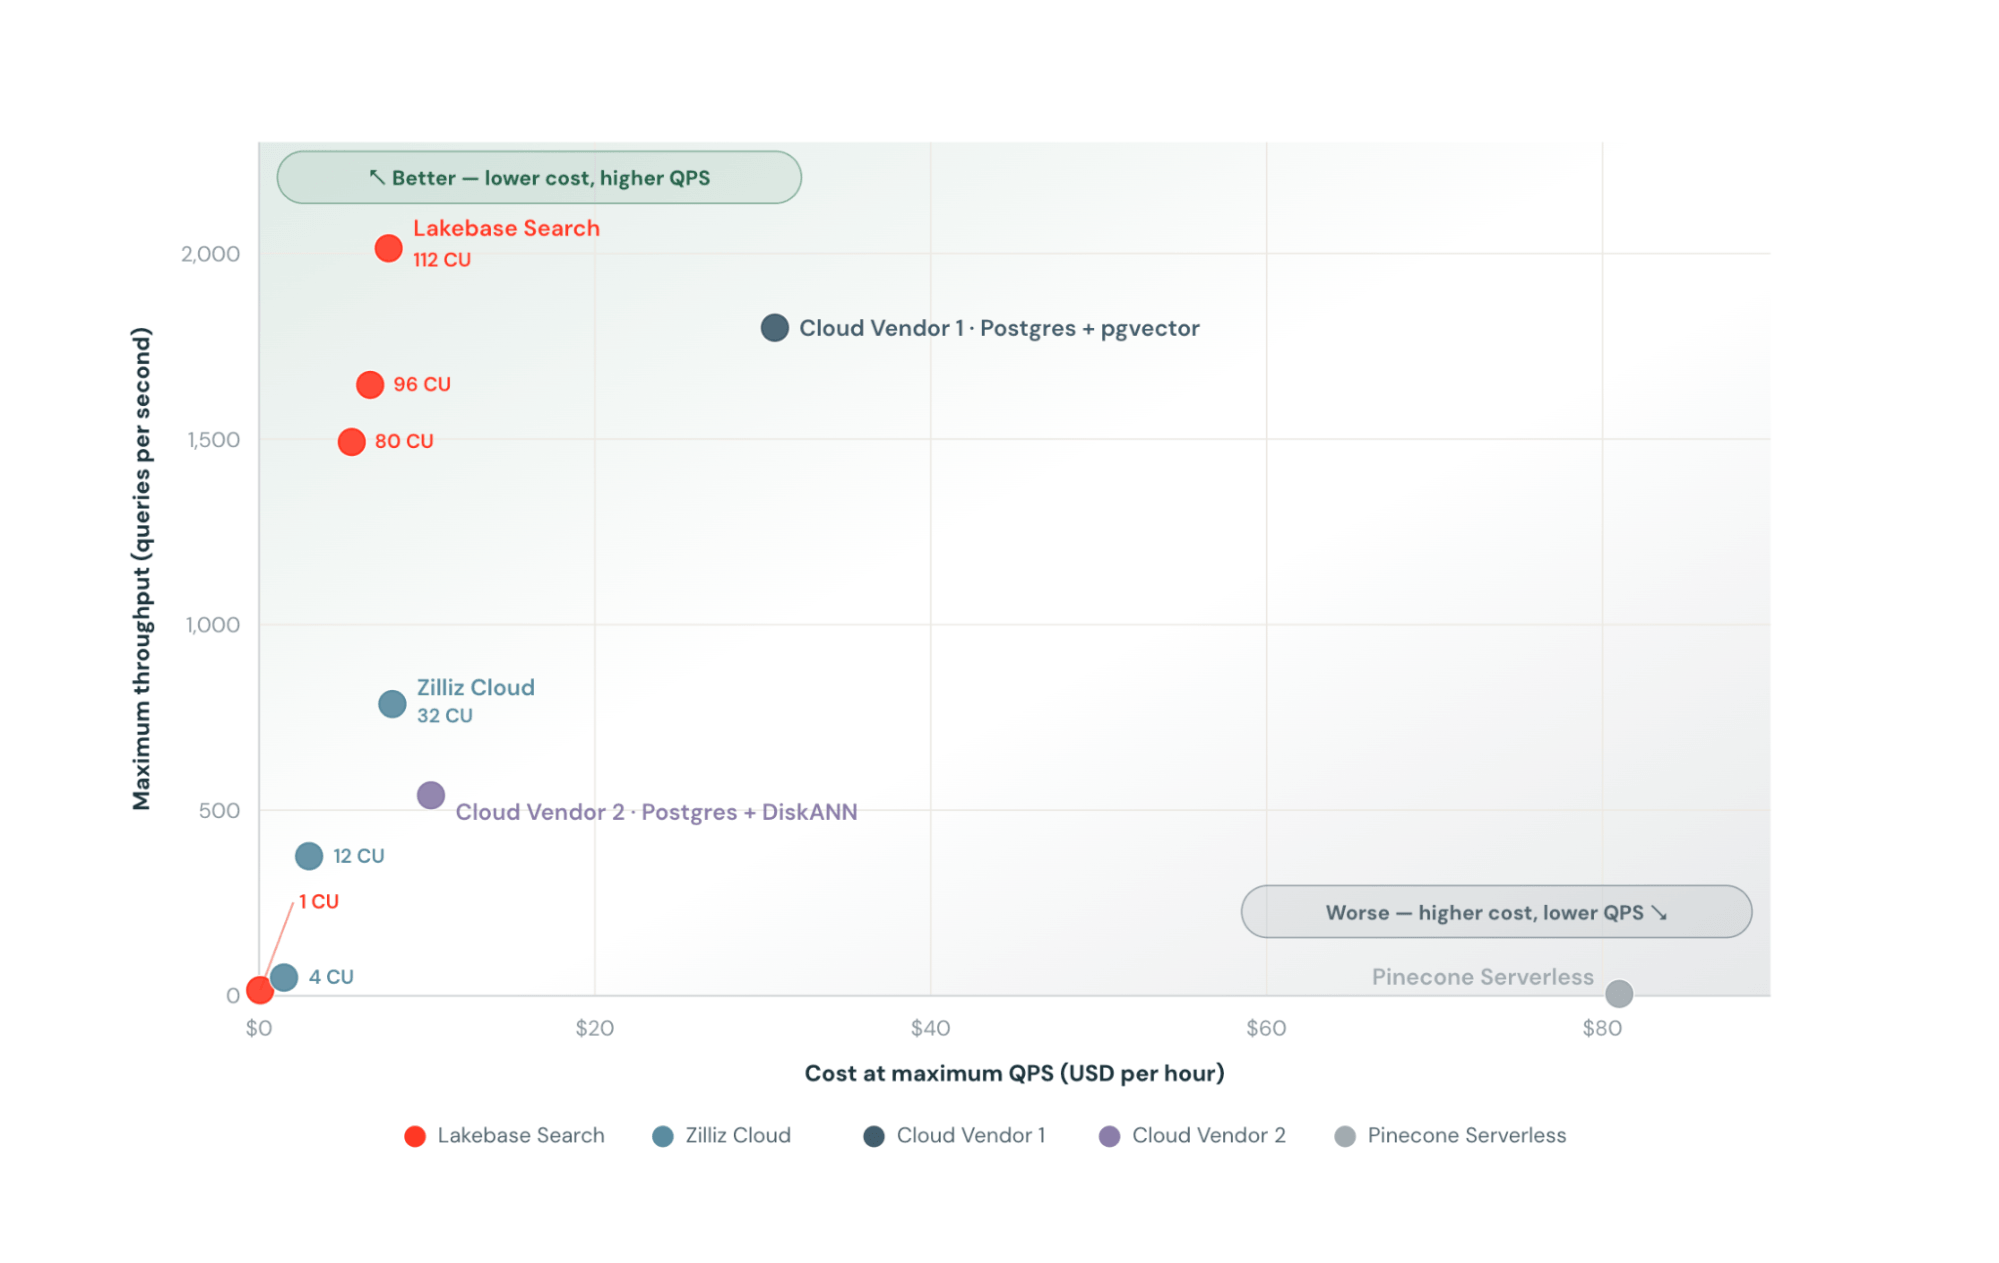
它在不牺牲准确率的情况下保持了这一性能。在我们的测试中,lakebase_vector在 97% 召回率下实现了 71 毫秒的 P99 延迟(97% 的情况下成功检索到真正的最近邻居)。

Lakebase Postgres 现在具备最先进的搜索能力,我们已经看到像 Conexiom 这样的客户在超过 1 亿行数据上使用 BM25 运行混合搜索,计算占用仅为之前 pgvector 设置的一半。他们现在拥有一个可同时处理所有 OLTP 和搜索工作负载的数据库,完全无服务器,并可按需扩展。
Lakebase Search 为我们提供了远超 pgvector 的全新可扩展性水平,并在同一个无服务器数据库中解锁了 BM25。我们使用 Lakebase 大规模地将数据连接到我们的代理。——Jordan Voves,Conexiom AI/ML 架构师
为什么 pgvector 在大规模下会碰壁
对大多数 Postgres 用户来说,搜索始于 pgvector。它允许通过诸如 HNSW 和 IVFFlat 等索引算法,在 Postgres 中直接对数据进行向量相似性搜索,避免了单独向量存储的复杂性。事实上,pgvector 是 Lakebase Postgres 中安装量最大的扩展。我们看到了客户在大规模运行 pgvector 时常见的 3 个痛点。
首先,成本随数据量而非使用量扩展。
pgvector 将索引保存在数据库内存中以保持快速。由于 HNSW 搜索依赖于随机访问的图遍历,只有当所有内容都完美地放入 RAM 时,查询才能在毫秒级执行。一旦索引溢出到磁盘,查询就会变成一连串的随机读取,性能骤降 10 倍到 50 倍。
在计入图链接和 Postgres 开销后,一个 768 维 float32 向量大约需要 3.3 KB 内存。在 1 亿行时,你需要约 330 GB 的 RAM 来保持索引常驻以实现毫秒级查询。这里没有“工作集”的概念。无论你查询全部还是完全不查询,你都要为整个索引进行配置。
其次,索引维护成本高昂且会阻塞你的数据库。
Pgvector 索引受限于内存,因为 HNSW 图依赖于连续的随机访问。当构建过程溢出到磁盘时,数百万次随机 I/O 操作会拖累性能——在标准云实例上构建 pgvector 索引需要将近 50 小时。
数据摄取也受到同样的瓶颈影响。插入新向量既缓慢又昂贵,因为每次写入都会迫使 pgvector 使用随机访问查找来导航和修改图的多层结构。
其次,数据摄取变得缓慢且昂贵 HNSW 依赖于连续的随机访问图导航。还需要修改图的每一层。因此 hnsw 索引
持续的维护使问题更加复杂。由于 HNSW 缺乏全局再平衡,恢复搜索质量需要完整的 REINDEX,这会锁定表并阻塞生产写入。
第三,你为了性能而牺牲搜索质量
每个 pgvector 查询都在单个 Postgres 后端进程上运行,这意味着 HNSW 索引扫描永远不会被并行化。
为了获得更高的召回率,引擎必须访问更多的图节点,触发更多的随机内存读取和距离比较。这会抬高延迟并降低你的 QPS。由于单次搜索无法跨核心并行化,提高吞吐量的唯一选择就是增加更多连接或只读副本。
lakebase_vector 将可扩展的向量搜索带到 Postgres
pgvector 的主要瓶颈在于整个索引必须放入单台机器的 RAM 中才能保持快速。如果不需要这样呢?
Lakebase Postgres 给了我们一个很好的起点,因为它将存储与计算分离。持久数据存放在廉价的云对象存储中,而 RAM 和本地 NVMe 则作为其前面的临时缓存,用于快速读取工作集数据。在这种架构下,HNSW 缓存意味着一系列随机对象存储读取。
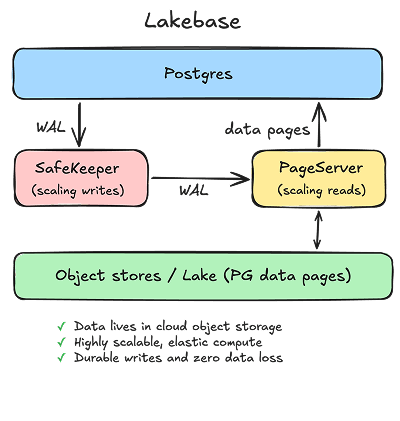
我们需要一种索引,无论是在 RAM 中缓存时还是在对象存储上冷置时都能保持快速。我们利用了两个思路:
- 分层 IVF 聚类。向量被分组为以连续块形式存储的聚类。查询在内存中对聚类质心打分,然后只读取少数几个有希望的块——将数百次随机跳转转变为少数几次大型顺序读取。
- 二值量化(RaBitQ)。每个向量被压缩到约每维 1 位,比 float32 小约 32 倍。查询扫描紧凑编码以筛选候选,然后用全精度向量对该有界候选集重新排序。
缓存时,搜索在极小的占用空间上使用量化向量进行操作。冷置时,查询只获取所需的块,无需爬取整个索引。Lakebase_vector 提供:
只为所用付费,并可缩容至零
将存储与计算解耦使 lakebase_vector 完全无状态:节点按需缓存热数据,空闲时暂停至零,并在下一次查询时恢复。
- 在静止状态下,你只需为存储付费,从而以较低的基线成本在 Lakebase 中保持向量索引。
- 冷启动成本很低,因为只有量化编码和查询所触及的特定块会被加载。我们实测的从零扩展后首次查询的 P90 仅为 1.13 秒(1 亿 × 768 维)。
- 甚至可以在仅 1 个 Lakebase 计算单元(CU)上服务 1 亿个向量。只有活跃的工作数据集需要缓存在计算节点中,为你提供真正反映实际使用量和查询活动的定价模型。

快速、卸载式索引构建
lakebase_vector 以更并行的方式构建索引。我们在一个小的随机样本上一次性训练质心。这是唯一一个需要遍历整个数据集的步骤。此后,每个向量都被独立分配到其最近的质心、被量化,并写入其所属聚类的块中。这一过程可以分布到你拥有的任意多个核心上,随计算资源扩展。

我们更进一步,将索引构建完全从你的主数据库卸载出去。以开放格式存储数据使我们的 LTAP 架构能够将索引和维护委托给像 Spark 这样的分布式引擎,借助并行计算将构建时间缩短至分钟级。敬请期待。
快速、准确的搜索
lakebase_vector 使用紧凑的 1 位编码以低成本扩大候选搜索范围,仅对一小份入围名单以全精度重新排序。由于索引块相互独立,单个查询可跨 CPU 核心并行化,从而同时提供高召回率和低延迟。
过滤直接在 lakebase_vector 扫描聚类块时进行。内联应用谓词避免了过度获取候选,并在过滤查询上保持高召回率。
lakebase_text:Postgres 中的原生 BM25 搜索
标准 Postgres 文本搜索(tsvector)缺乏语料库范围的相关性上下文。lakebase_text 通过使用全局逆文档频率(IDF)对词项评分,将原生 BM25 引入 Postgres:对稀有、高意图的词项赋予高权重,同时惩罚常见的填充词。
它也比传统的 tsvector + GIN 索引更快。通过在遍历过程中评估得分上界,引擎会跳过整个无法达到 top-K 结果的发布块。
将 lakebase_text 与 lakebase_vector 结合,可在 Postgres 内解锁原生混合搜索。在单个查询中,你可以融合语义向量搜索与 BM25 关键词相关性,应用标准 SQL 过滤谓词,并直接与实时运营表进行连接。
Lakebase Postgres 为智能体时代而生
智能体已将传统搜索引擎推向极限。它们使向量搜索成为数据栈的核心需求,并引入了极端的突发性,单个工作流可以在数秒内触发数千个并发检索请求。
我们专为这一全新现实设计了 Lakebase Search。Lakebase Postgres 现在可以处理你所有的运营和搜索工作负载,由无服务器架构支撑,可从 1 行无缝扩展到 10 亿个向量,从 1 QPS 扩展到数千 QPS,无需手动重新配置或管理基础设施。
我们与数百家 beta 客户的反馈共同打造了 Lakebase Search,结果不言自明:
- 数据库支出降低 3 倍:与 pgvector 相比,Conexiom 将基础设施成本降低了 3 倍,同时实现了 5 倍的吞吐量提升。
- 面向智能体的一次 SQL 工具调用:开发者用单次 SQL 调用即可实现原生混合搜索,取代复杂的多系统检索管道,并受标准数据库规则治理。
- 统一的 OLTP 与搜索:团队将实时运营表和专用搜索集群整合到一个按使用量付费的后端中。
Lakebase Search 今日已在 AWS 和 Azure 上正式可用。如果你已经在 Lakebase 上构建应用或智能体,只需启用这些扩展。如果你还没有尝试过 Lakebase,请从今天开始。
▎ 📝 注意:Databricks AI Search 是一款开箱即用的托管搜索引擎,可实现高质量检索——当你希望无需手动调优即可获得出色结果时,它可能是更合适的选择。而当你希望将所有运营数据和搜索数据放在同一个数据库中时,Lakebase Search 是更好的选择。
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏