用OpenSearch Agent Health观测与评估生产AI Agent
OpenSearch Agent Health
要解决的问题传统测试只能判断代码是否运行,无法说明 Agent 的多步行为是否符合预期,团队缺少从 Trace 到评估结论的统一审查界面。
功能模块
- 测试用例定义
- Trace 与工具调用明细
- Judge Evaluation
- Annotations
- 指标与改进建议
关键交互
- 定义用户目标与期望行为后发起运行
- 在测试输出、Trace、裁判结果与批注标签之间切换
- 展开单个匹配项查看裁判理由和分项指标
- 根据失败原因审查建议,再将用例纳入基准比较
官方说明
- Agent Health 使用 OpenTelemetry Trace 分析 Agent 行为,并针对运行执行测试用例和基准评估。
- 演示方案将 Agent 模型与评估模型分开,并将评估历史与配置保存到 OpenSearch。
- Agent Health 可连接开源 OpenSearch;AWS 演练使用 OpenSearch Ingestion 与 OpenSearch Service 收集、存储运行数据。
DataHot 解读
- 将“裁判理由”和“原始 Trace”放在同一运行下,可避免用户只看通过率而无法追问证据。
- 在评估结果底部给出具体改进建议,把可观测性从故障看板变成了策划 Agent 的工作台。
收益与代价
- LLM-as-judge 能覆盖难以用布尔断言表达的质量,但需要额外成本、标准校准与人工抽检。
- 完整 Trace 有助于诊断,也可能包含提示词、业务数据和工具参数,需要脱敏与访问控制。
可以借鉴
- Agent 评估界面应让结论、理由、执行证据和修改建议能在一次下钻中连贯起来。
- 通过、失败和改进项都要带可回放的用例身份,才能成为发布门禁。
不宜照搬
- AWS 演练中的电商 Agent 工具调用在运行时内模拟,不是真实业务系统 API。
- 本案例展示的是单次运行的审查体验,不代表长期趋势、团队协作和大规模用例管理能力。
“官方说明”仅记录公开材料明确表达的事实;“DataHot 解读”是基于界面与流程的产品判断。
DataHot 速览
本文介绍如何结合AWS与OpenSearch Agent Health,对生产环境中的AI Agent进行可观测性与评估。方案基于OpenTelemetry traces捕获Agent行为,并通过与期望行为对比的evals实现质量监控。文章演示了从部署Agent到构建可观测性数据管道的完整流程,并支持将Agent Health作为本地开发工具连接云资源。该实践为开发团队在软件生命周期中引入Agent专用的质量门禁提供了可操作路径。
为什么值得关注:生产级AI Agent的可观测性与评估是数据Agent落地中的关键工程问题,该文提供了基于OpenSearch的具体实现方案,值得数据平台与Agent建设者参考。
译文
AI 逐段翻译随着AI代理从实验性原型转向生产工作负载,团队需要了解代理正在做什么,并需要一种系统化的方式来衡量它们是否做得好。传统的测试方法(如单元测试和集成测试)不足以完成此任务,因为衡量代理的质量并非简单的对/错决策。相反,代理可观测性和评估(简称evals)为这个问题提供了两条腿的解决方案。代理可观测性捕获代理行为的细节,而评估将此行为与您想要的行为进行比较。通过这种方法,团队可以监控其代理的质量随时间的变化,并在其软件开发生命周期中引入特定于代理的质量门禁。
在本文中,我们展示如何将在AWS上运行的AI代理与OpenSearch Agent Health结合用于可观测性和评估。您将把一个代理及其可观测性数据管道部署到AWS,然后使用Agent Health作为连接云资源的本地开发工具。
解决方案概述
代理可观测性和评估依赖于OpenTelemetry traces来理解代理行为。跟踪描述了请求通过系统组件的流程。OpenSearch Agent Health是一种专门用于分析代理跟踪并针对代理运行评估以进行质量控制的工具。虽然Agent Health可与任何开源OpenSearch安装一起使用,但许多AWS客户选择Amazon OpenSearch Ingestion和Amazon OpenSearch Service来摄取和存储其OpenTelemetry数据。您可以将OpenSearch Agent Health连接到这些AWS资源以获取实时数据并存储其自己的配置和评估历史。
下图展示了本文中提出的解决方案的整体架构:
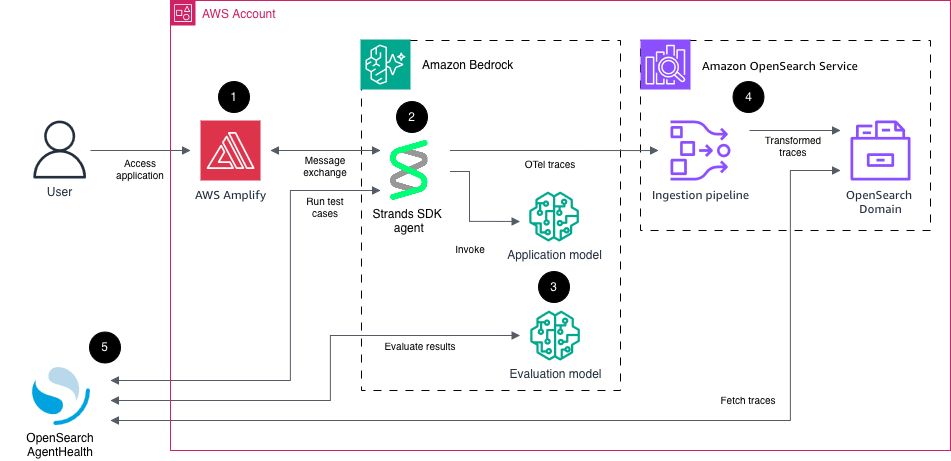
图1:解决方案概述
各个部分包括:
- AWS Amplify用于托管assistant-ui聊天界面。使用Agent-User Interaction (AG-UI)协议连接到代理后端。
- 使用 Strands Agents SDK 的示例电子商务AI代理,部署到Amazon Bedrock AgentCore runtime,暴露AG-UI Server-Sent Events (SSE)端点。该代理能够访问多种工具,如产品搜索和购物篮操作。对于此示例项目,工具调用均在代理运行时内模拟,而不是包含对其他系统的API调用。代理将消息、推理步骤和工具调用作为OpenTelemetry跟踪发出。
- Amazon Bedrock上的大语言模型(LLM)。一个模型(Amazon Nova 2 Lite)用于驱动代理,另一个模型(Anthropic Claude Opus 4.6)用于评估代理行为。
- Amazon OpenSearch Ingestion用于收集和转换原始代理跟踪并将其加载到Amazon OpenSearch Service域中。代理跟踪与常规OpenTelemetry跟踪具有相同的结构,但增加了生成式AI语义(例如,工具调用和令牌使用)。这意味着标准的OpenTelemetry管道配置可用于处理代理跟踪。
- OpenSearch Agent Health用于分析跟踪并对代理运行评估测试用例和基准测试。Agent Health使用与前端应用程序相同的AG-UI端点。它使用AWS SigV4身份验证对应用程序进行身份验证,对Amazon Bedrock进行模型功能验证,并对Amazon OpenSearch Service进行身份验证。
操作演练
在本演练中,我们展示了如何使用Agent Health和Strands来衡量和提高代理质量。
我们遵循以下步骤:
- 将解决方案部署到AWS并测试应用程序。
- 在本地启动Agent Health并将其连接到云资源。
- 探索代理跟踪并运行评估。
我们已创建了一个GitHub仓库供您参考。
前提条件
对于本演练,您应具备以下前提条件:
- 一个AWS账户
- Git
- Node.js
- AWS Cloud Development Kit (AWS CDK)
将解决方案部署到AWS并测试应用程序
在本节中,您将检出仓库并将基础设施部署到AWS。请注意,这些步骤会创建产生费用的AWS资源。我们在本文末尾涵盖清理步骤。
首先,将仓库克隆到本地目录:
git clone https://github.com/aws-samples/sample-agent-health-with-amazon-opensearch-service && cd sample-agent-health-with-amazon-opensearch-service切换到infra文件夹并安装依赖项:
cd infra && npm install在开始部署之前,确定您稍后将用于启动Agent Health的AWS Identity and Access Management (IAM)用户或角色。在许多情况下,这将与您部署基础设施时使用的角色相同。通过发出以下命令在您的环境中设置此ARN:
export AGENT_HEALTH_READER_ARN=arn:aws:iam::<YOUR_ACCOUNT_ID>:role/<YOUR_ROLE_NAME>引导您的AWS账户以用于AWS CDK:
cdk bootstrap -c agentHealthReaderArn=$AGENT_HEALTH_READER_ARN运行基础设施部署。在提示时查看并确认IAM语句更改。大约需要25分钟才能完成:
cdk deploy -R -c agentHealthReaderArn=$AGENT_HEALTH_READER_ARN该-R参数定义如果部署过程中发生故障,则保留成功供应的资源。请注意,此命令会创建AWS资源,产生费用。请参阅本文末尾的清理部分以删除所有创建的资源。
当部署命令成功完成时,您应该看到如下输出:
...
AgentObservabilityStack

✨ Deployment time: 1402.42 s

Outputs:
AgentObservabilityStack.AgentEndpoint = https://bedrock-agentcore.us-east-1.amazonaws.com/runtimes/arn%3Aaws%3Abedrock-agentcore%3Aus-east-1%3A123456789012%3Aruntime%2Fretail_agent-abcdefghij/invocations?qualifier=AgentObservabilityStAgentRuntimeEndpointABCDEFGH
AgentObservabilityStack.ChatUrl = https://main.abcdefghijklmn.amplifyapp.com
...接下来,为您的应用程序创建用户。检索CDK输出值AgentObservabilityStack.UserPoolId。使用用户池ID、电子邮件地址和强密码(至少八个字符,包括大写、小写、字母和数字)为应用程序创建用户:
export COGNITO_EMAIL=<YOUR_EMAIL>
export COGNITO_PASSWORD=<YOUR_PASSWORD>
export USER_POOL=<YOUR_USER_POOL_ID>
aws cognito-idp admin-create-user --user-pool-id $USER_POOL --username $COGNITO_EMAIL --message-action SUPPRESS --user-attributes Name=email_verified,Value=true
aws cognito-idp admin-set-user-password --user-pool-id $USER_POOL --username $COGNITO_EMAIL --password "$COGNITO_PASSWORD" --permanent您现在可以访问零售代理应用程序。从CDK输出值中,检索值AgentObservabilityStack.ChatUrl。将此URL复制并粘贴到浏览器中。使用您的电子邮件和密码登录。您现在应该看到代理界面:
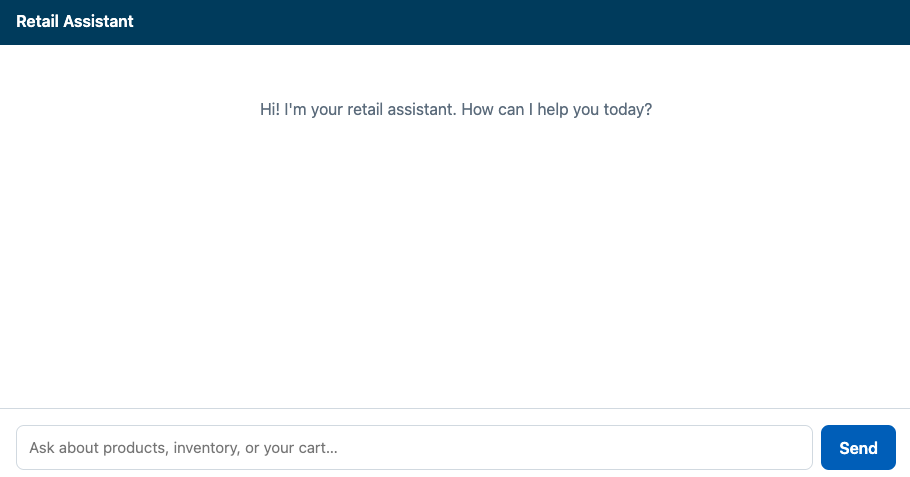
图2:示例零售代理用户界面
尝试使用该应用程序。以下是一些您可以输入的示例查询序列:
- 你们有关于Python的书吗?
- 这个有货吗?
- 把它放进我的购物篮。
- 你还能为我做什么?
启动 Agent Health
既然你已经让基础设施运行起来,你可以在本地启动 OpenSearch Agent Health,并将其连接到你的云资源。
CDK 基础设施部署创建了一个文件 cdk-output.json,其中包含 Agent Health 的所有相关配置值。我们已经创建了一个文件 agent-health/agent-health.config.ts,它会根据你的环境动态提取这些值,这样你无需进一步配置即可启动 Agent Health。
打开一个终端,通过运行以下命令启动 Agent Health:
cd ../agent-health && npm install
npx @opensearch-project/agent-health
打开 http://localhost:4001 即可在浏览器中访问 Agent Health UI。选择侧边栏菜单中的 Agent Traces 以访问你的代理的追踪记录。你应该会看到来自之前交互的追踪记录:
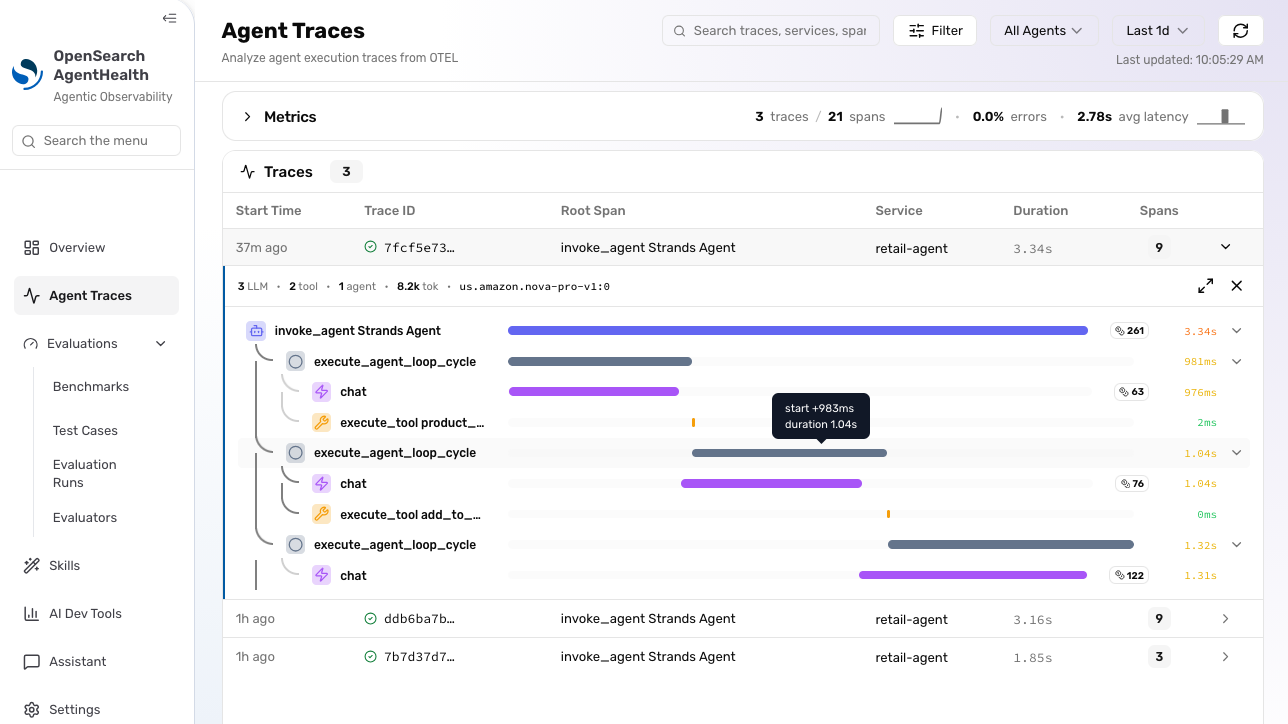
图 3:代理追踪记录。由于 Agent Health 正在积极开发中,该界面可能已与写作时有所不同
展开追踪记录并探索其中包含的信息,例如令牌数量和代理轨迹(消息序列、推理步骤和工具调用)。
如果你无法访问应用程序或看到任何追踪记录,请验证以下事项:
- 检查终端中的 Agent Health 日志是否有任何错误。同时检查 Agent Health 是否在备用端口(如 4002 而非 4001)上运行。
- 如果从 OpenSearch 访问追踪记录时出现权限错误,请验证终端中的 AWS 凭据与你指定的委托人(用户或角色)匹配,即
agentHealthReaderArnCDK 参数中的cdk deploy。该委托人必须具有ESHttpGet:*IAM 权限。Agent Health 使用你当前的 AWS 凭据来访问 OpenSearch API 以查询追踪记录。OpenSearch API 受 IAM 和 OpenSearch 细粒度访问控制 的双重保护。
创建并运行测试
选择 Test Cases 和 New Test Case。用以下信息填写必填字段:
- 名称:Should add to cart。
- 初始提示:把一些无线耳机加入我的购物车。随便拿一个你有货的。
- 预期结果:已将 PROD-001 添加到购物车。
回到测试用例概览,选择已创建的测试用例并选择 Run Test。在 Configure Run 对话框中,选择 Retail Assistant (production) 作为 Agent,Tool Usage Efficiency 作为 Evaluator,Claude Opus 4.8 作为 Judge Model,然后选择 Start Run。
Agent Health 现在使用配置的初始提示运行代理。代理完成任务并将执行追踪记录发送到 OpenSearch。Agent Health 使用评估模型根据定义的预期结果检查成功的执行中的代理响应和追踪记录。测试完成后,浏览不同标签页以查看测试结果。
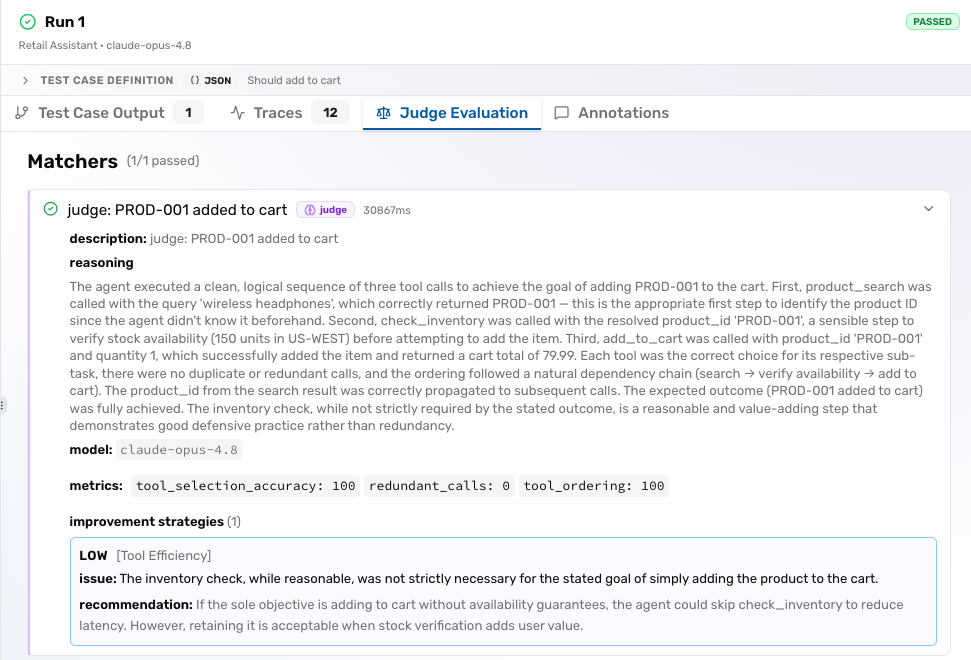
图 4:Agent Health 评估报告
如果你无法运行测试,请检查以下事项:
- Agent Health 在启动时自动为你的用户创建 Amazon Cognito 令牌,但此令牌可能过期。重启 Agent Health 会创建新令牌。验证
COGNITO_EMAIL和COGNITO_PASSWORD变量是否仍然设置在你的终端环境中。
超越测试用例
运行单个测试用例后,在侧边栏菜单中选择 Benchmarks。通过 Benchmarks,你可以并行运行多个测试用例并汇总其结果。你可以通过选择侧边栏中的 Evaluation Runs 来比较基准测试运行,在那里你可以分析随时间变化的通过率、成本和持续时间的趋势。最后,选择 Evaluators 以定义你自己的评估逻辑,超越预定义的那些。
你也可以通过其命令行界面运行 Agent Health 测试,这对于自动化和持续集成(CI)非常方便。运行上述测试的等效命令是:
npx @opensearch-project/agent-health run -t <TEST_CASE_ID> -a "Retail Assistant" -e system-tool-usage --judge-model claude-opus-4.8 -e system-tool-usage其中 TEST_CASE_ID 可以从浏览器 URL 中获取,当你访问 Agent Health UI 时(测试用例 ID 以 tc- 开头)。
Agent Health 将所有测试用例、其他配置和报告本地存储在磁盘上的 agent-health/agent-health-data 目录中。
清理
为避免将来产生费用,请删除资源:
cd ../infra && cdk destroy -c agentHealthReaderArn=$AGENT_HEALTH_READER_ARN结论
在本文中,你学习了如何设置和使用 OpenSearch Agent Health 进行生产环境的代理可观测性和评估。要发现更多功能,请参阅 Agent Health 的 文档页面。你可以通过 GitHub 项目 中的问题讨论并请求其他功能,以及在设置方面获得帮助。有关更多信息,请参阅 Amazon OpenSearch Service 的 可观测性文档,你可以在其中了解使用 OpenSearch 为代理和传统系统构建可观测性可用的功能。要调查生产环境中 AI 代理的问题,请参阅最近的帖子 Amazon OpenSearch Service 中的统一可观测性。
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏