用 Iceberg 物化视图加速 Spark 查询
有效阅读仅保存在当前浏览器,用于「为你」推荐;暂停或清除记录。
DataHot 速览
AWS 官方博客介绍如何借助 Apache Iceberg 物化视图降低 Apache Spark 查询执行时间,且无需修改任何 SQL。自 Amazon EMR 7.12.0 和 AWS Glue 5.1 起,系统会自动分析查询逻辑计划,并与物化视图元数据缓存匹配;命中后改写计划读取 MV,未命中则保持原查询不变。该能力面向 BI 仪表盘、ISV 应用和遗留报表等难以手工重写 SQL 的分析负载。文章还对比了标准视图、自定义 ETL、手工重写等方案,并讨论不同 MV 形状的权衡。
为什么值得关注:数据湖仓与 Spark 查询优化从业者可关注:它说明了如何在不改 SQL 的情况下通过物化视图自动重写降低延迟与成本,并提示命中条件、正确性和 MV 设计取舍。
译文
AI 逐段翻译在这篇文章中,您将了解如何减少 Apache Spark 查询执行时间,通过使用 Apache Iceberg 物化视图,而无需更改任何一条 SQL 查询。
在其数据湖上运行分析工作负载的组织常常会遇到一个共同的瓶颈:查询既慢又昂贵,却难以手工重写。多表连接、繁重的聚合以及大型事实表上的窗口函数都会推高执行时间,但背后的 SQL 往往无法更改。它可能来自 商业智能 (BI) 仪表板、打包的独立软件供应商 (ISV) 应用程序或遗留报表,在这些场景中编辑源内容所带来的回归风险超过了性能收益。
从 Amazon EMR 7.12.0 和 AWS Glue 5.1 开始,您无需重写这些查询即可加速它们。自动查询重写会分析每个传入查询的逻辑计划,并将其与可用 MV 的元数据缓存进行对比。当优化器找到一个 物化视图 (MV) 能够满足查询的全部或部分时,它会重写计划,改为从该 MV 而不是基表读取数据。匹配可以是结构性的(聚合和连接)或精确匹配(更复杂的模式,如窗口函数)。如果没有 MV 匹配,原始查询将原样运行,不影响正确性。
如果您之前尝试过加速缓慢的分析查询,您可能考虑过以下替代方案之一。以下是自动查询重写的对比:
| 查询修改方式 | 存储结果 | 刷新 | 对现有查询的修改 |
| AWS Glue 中的标准视图 | 否(每次重新运行) | 不适用 | 必需 |
| 自定义 ETL 管道 | 是 | 手动 | 必需 |
| 手工重写 | 是 | 手动 | 必需 |
| 启用自动重写的物化视图 | 是 | 通过 AWS Glue 数据目录 按配置的计划自动完成 | 在受支持时不需要 |
在本文中,我们将:
- 概述自动查询重写在 Apache Spark 中是如何工作的。
- 通过一个具体示例演示同一查询如何在不同的覆盖级别下从 MV 中获益。
- 讨论权衡取舍,以便您为工作负载选择合适的 MV 形态。
先决条件
要使用 Iceberg 物化视图的自动查询重写,您需要:
- Amazon EMR 版本 7.12.0 或更高版本,或 AWS Glue 5.1 或更高版本。
- 源表为 Apache Iceberg 或 Parquet 格式,已在 AWS Glue 数据目录中注册,并与物化视图位于同一 AWS 区域和账户中。从 Amazon EMR 7.14.0 和 AWS Glue 8.1 开始,支持对 Parquet 源表进行自动查询重写。
- 一个 Amazon Simple Storage Service (Amazon S3) Tables(Amazon S3 的一项功能)存储桶,或一个 S3 通用存储桶,用于存放物化视图数据。
- 定义者角色的权限。您可以使用 AWS Identity and Access Management (IAM) 策略或 AWS Lake Formation。
- 在您的 Spark 会话中开启自动查询重写:
--conf spark.sql.optimizer.answerQueriesWithMVs.enabled=true。 - 对于 Parquet 源表,请设置
spark.sql.materializedView.v1SourceTables.enabled=true和spark.sql.materializedView.v1ETagVersioning.enabled=true。
有关更多 Spark 配置,请参阅 在 AWS Glue 数据目录中引入 Apache Iceberg 物化视图。
工作原理
以下是 MV 和自动查询重写如何协同工作:
- 您定义一个 SQL 查询 ,在受支持的源表上执行聚合、连接或过滤。
- AWS Glue 数据目录存储预先计算的结果,作为 Apache Iceberg 表存储在您的 Amazon S3 存储桶中。您可以将其存储在通用 S3 存储桶或 Amazon S3 Tables 中。任何兼容 Apache Iceberg 的查询引擎都可以读取该物化视图,包括 Amazon Athena、Amazon EMR、AWS Glue、Amazon Redshift 以及兼容 Iceberg 的第三方查询引擎。自动查询重写可在 Amazon Athena、Amazon EMR 和 AWS Glue 中的 AWS 优化 Spark 运行时上使用。其他引擎可以直接查询物化视图,但不会自动重写查询来使用它。
- 自动刷新使 MV 保持最新 按照您定义的计划进行,例如
SCHEDULE REFRESH EVERY 1 DAY。您可以在创建时或之后通过ALTER MATERIALIZED VIEW ... ADD SCHEDULE REFRESH进行设置。在计划时间,刷新过程会检查当前的 Apache Iceberg 快照 ID 或 Parquet 文件 ETag,并在检测到源表更改时刷新 MV。 - 结构重写(改编自 Amazon Redshift)处理定义为对 INNER 连接执行单个 SELECT-FROM-WHERE-GROUP-BY 块的 MV。优化器可以将 MV 的聚合上卷到更粗的粒度,并将额外的查询谓词上拉到 MV 扫描上。
- 精确匹配重写处理定义为其他形态的 MV,例如窗口函数和外连接,方法是将 MV 主体的规范化形式与查询计划的子树进行匹配。
当优化器评估查询时,它会查阅来自所配置目录的 MV 元数据缓存,并选择最佳匹配。它还会在优化过程中检查 MV 是否过期。它会跳过过期的 MV,因此重写不会返回过期结果。如果没有 MV 匹配,原始查询将原样运行。
请注意,自动查询重写是选择加入的:在创建 Apache Spark 会话时设置 spark.sql.optimizer.answerQueriesWithMVs.enabled=true。
示例:一个查询与三个潜在 MV
MV 不需要覆盖整个查询才能发挥作用。Apache Spark 中的自动查询重写作用于子树:当 MV 与查询计划的一部分匹配时,重写器会替换该子树,并让查询的其余部分在重写输出上原样运行。因此,同一查询可以由许多可能的 MV 设计来服务,每种设计在单查询加速、存储成本和其他查询间的复用之间做出不同的权衡。
为了具体说明,考虑一个典型的分析查询:“按门店总消费额排名前 100 的美国首选客户。” 它连接事实表和维度表,在客户维度上应用两个选择性过滤器,按客户聚合,用窗口函数对结果排名,并仅保留前 100 名:
SELECT c_customer_id, total_revenue, num_transactions, avg_purchase, revenue_rank
FROM (
    SELECT cust.c_customer_id,
        SUM(sales.ss_quantity * sales.ss_sales_price) AS total_revenue,
        COUNT(*) AS num_transactions,
        AVG(sales.ss_quantity * sales.ss_sales_price) AS avg_purchase,
        RANK() OVER (ORDER BY SUM(sales.ss_quantity * sales.ss_sales_price) DESC) AS revenue_rank
    FROM base_catalog.base_db.store_sales sales
    INNER JOIN base_catalog.base_db.customer cust
        ON sales.ss_customer_sk = cust.c_customer_sk
    WHERE cust.c_birth_country = 'UNITED STATES'
        AND cust.c_preferred_cust_flag = 'Y'
    GROUP BY cust.c_customer_id
) ranked
WHERE revenue_rank <= 100
ORDER BY revenue_rank;
查询 1:原始查询。按门店总消费额排名前 100 的优选美国客户,在任何物化视图之前。
三种 MV 设计逐步覆盖此查询的更多部分,从单表预聚合到完整查询主体本身:
第 1 层:仅预聚合 store_sales,无连接,无过滤。 此层为单表聚合,聚合 store_sales,粒度为客户代理键。查询仍需连接 customer 表,应用两个过滤条件,按 c_customer_id 粒度重新聚合,并运行窗口函数。
CREATE MATERIALIZED VIEW mv_catalog.mv_db.customer_tier_1 AS
SELECT ss_customer_sk,
    SUM(ss_quantity * ss_sales_price) AS sum_revenue,
    COUNT(ss_quantity * ss_sales_price) AS count_revenue,
    COUNT(*) AS num
FROM base_catalog.base_db.store_sales
GROUP BY ss_customer_sk;
第 1 层 MV:按客户代理键对 store_sales 进行单表预聚合(无连接,无过滤)。
以下计划将原始查询计划与重写后的计划进行对比:
Window, filter, Sort
+- Aggregate by c_customer_id
:  total_revenue = SUM(ss_quantity * ss_sales_price)
:  num_transactions = COUNT(*)
:  avg_purchase = AVG(ss_quantity * ss_sales_price)
+- Project
   +- Join Inner ON ss_customer_sk = c_customer_sk
      :- BatchScan store_sales <- reads the large store_sales table
      +- Filter c_birth_country='UNITED STATES' AND c_preferred_cust_flag='Y'
         +- BatchScan customer
计划 1:原始计划。扫描大型 store_sales 表。
Window, filter, Sort
+- Aggregate by c_customer_id <- rolls up pre-aggregated sums
:  total_revenue = SUM(sum_revenue) <- sum of sum_revenue
:  num_transactions = SUM(num) <- sum of num
:  avg_purchase = SUM(sum_revenue) / SUM(count_revenue) <- sum of sum_revenue / sum of count_revenue
+- Project
   +- Join Inner ON ss_customer_sk = c_customer_sk
      :- BatchScan customer_tier_1 <- reads pre-aggregated MV
      +- Filter c_birth_country='UNITED STATES' AND c_preferred_cust_flag='Y'
         +- BatchScan customer
计划 2:重写后的计划(第 1 层)。读取预聚合的 customer_tier_1 MV。
第 2 层:预连接 store_sales x customer,预先应用一个过滤条件(c_preferred_cust_flag = ‘Y’)。 中间层预连接两个表并将优选客户过滤条件固化其中。查询仍需在 MV 扫描上作为残余条件应用国家过滤条件,并运行 RANK() 窗口。
CREATE MATERIALIZED VIEW mv_catalog.mv_db.customer_tier_2 AS
SELECT cust.c_customer_id, cust.c_birth_country,
    SUM(sales.ss_quantity * sales.ss_sales_price) AS sum_revenue,
    COUNT(sales.ss_quantity * sales.ss_sales_price) AS count_revenue,
    COUNT(*) AS num
FROM base_catalog.base_db.store_sales sales
INNER JOIN base_catalog.base_db.customer cust
    ON sales.ss_customer_sk = cust.c_customer_sk
WHERE cust.c_preferred_cust_flag = 'Y'
GROUP BY cust.c_customer_id, cust.c_birth_country;
第 2 层 MV:预连接 store_sales 和 customer,并应用优选客户过滤条件。
重写后的查询计划:
Window, filter, Sort
+- Aggregate by c_customer_id <- rolls up pre-aggregated sums
:  total_revenue = SUM(sum_revenue) <- sum of sum_revenue
:  num_transactions = SUM(num) <- sum of num
:  avg_purchase = SUM(sum_revenue) / SUM(count_revenue) <- reads pre-aggregated MV
+- Filter c_birth_country='UNITED STATES' [residual filter on MV scan]
   +- BatchScan customer_tier_2 <- reads pre-aggregated MV
计划 3:重写后的计划(第 2 层)。国家过滤条件作为残余条件应用于 MV 扫描。
第 3 层:匹配整个查询,包括窗口函数和 top N 过滤条件。 这是最具体的层。MV 主体即目标查询的逐字内容(去掉顶层 ORDER BY,这对存储集合没有意义)。MV 存储查询所要求的排名靠前的行(排名 ≤ 100)。
CREATE MATERIALIZED VIEW mv_catalog.mv_db.customer_tier_3 AS
SELECT c_customer_id, total_revenue, num_transactions, avg_purchase, revenue_rank
FROM (
    SELECT cust.c_customer_id,
        SUM(sales.ss_quantity * sales.ss_sales_price) AS total_revenue,
        COUNT(*) AS num_transactions,
        AVG(sales.ss_quantity * sales.ss_sales_price) AS avg_purchase,
        RANK() OVER (ORDER BY SUM(sales.ss_quantity * sales.ss_sales_price) DESC) AS revenue_rank
    FROM base_catalog.base_db.store_sales sales
    INNER JOIN base_catalog.base_db.customer cust
        ON sales.ss_customer_sk = cust.c_customer_sk
    WHERE cust.c_birth_country = 'UNITED STATES'
        AND cust.c_preferred_cust_flag = 'Y'
    GROUP BY cust.c_customer_id
) ranked
WHERE revenue_rank <= 100;
第 3 层 MV:存储查询的精确排名输出(精确匹配路径)。
此层演练 精确匹配重写路径:重写器将 MV 主体规范化,并将其与查询的逻辑计划进行匹配。
重写后的计划:
Sort revenue_rank ASC
+- BatchScan customer_tier_3 <- reads around 100 stored rows
计划 4:重写后的计划(第 3 层)。读取约 100 行存储的行。
权衡
这三层在每查询加速比与复用性和存储之间进行权衡。在我们对 TPC-DS 3 TB 的测试中,我们观察到以下结果:
| MV 设计 | 预计算 | 复用性 | 每查询加速比 | MV 大小 |
| 基线(无 MV) | 无 | 不适用 | 1x | 不适用 |
| 第 1 层:按客户代理键聚合 store_sales | 每个客户所有销售的聚合 | 最广:任何按客户的聚合 | 约快 5 倍 | TPC-DS 3 TB 下为 store_sales 的 0.07% |
| 第 2 层:store_sales x customer 聚合,预先应用一个过滤条件 | 连接 + 聚合,仅优选客户 | 中等:任何国家过滤条件,优选客户 | 约快 10 倍 | TPC-DS 3 TB 下为 store_sales 的 0.04% |
| 第 3 层:整个查询主体逐字(精确匹配) | 此查询的精确排名输出 | 最窄:仅此精确查询形态 | 快 20 倍以上 | 可忽略(仅 100 行) |
性能在 TPC-DS 3 TB 上测量。加速比是基线执行时间与 MV 加速执行时间的比值。结果可能因数据特征、集群规模和查询复杂度而异。
此外,MV 会产生额外成本。每个 MV 都会对源表运行一次查询并存储结果。预计算越多(连接更多表、应用更多过滤条件),耗时越长。
下图绘制了我们在 TPC-DS 3 TB 上测试三层时的每查询加速比和创建时间。每查询加速比稳步上升,从第 1 层的约 5 倍到第 3 层的 20 倍以上。创建时间并不遵循相同模式:它在第 2 层达到峰值。第 2 层预连接并聚合所有国家/地区的全部优选客户,因此它物化了最多的数据工作。第 3 层应用两个过滤条件,因此处理的行数少得多,创建成本也更低。
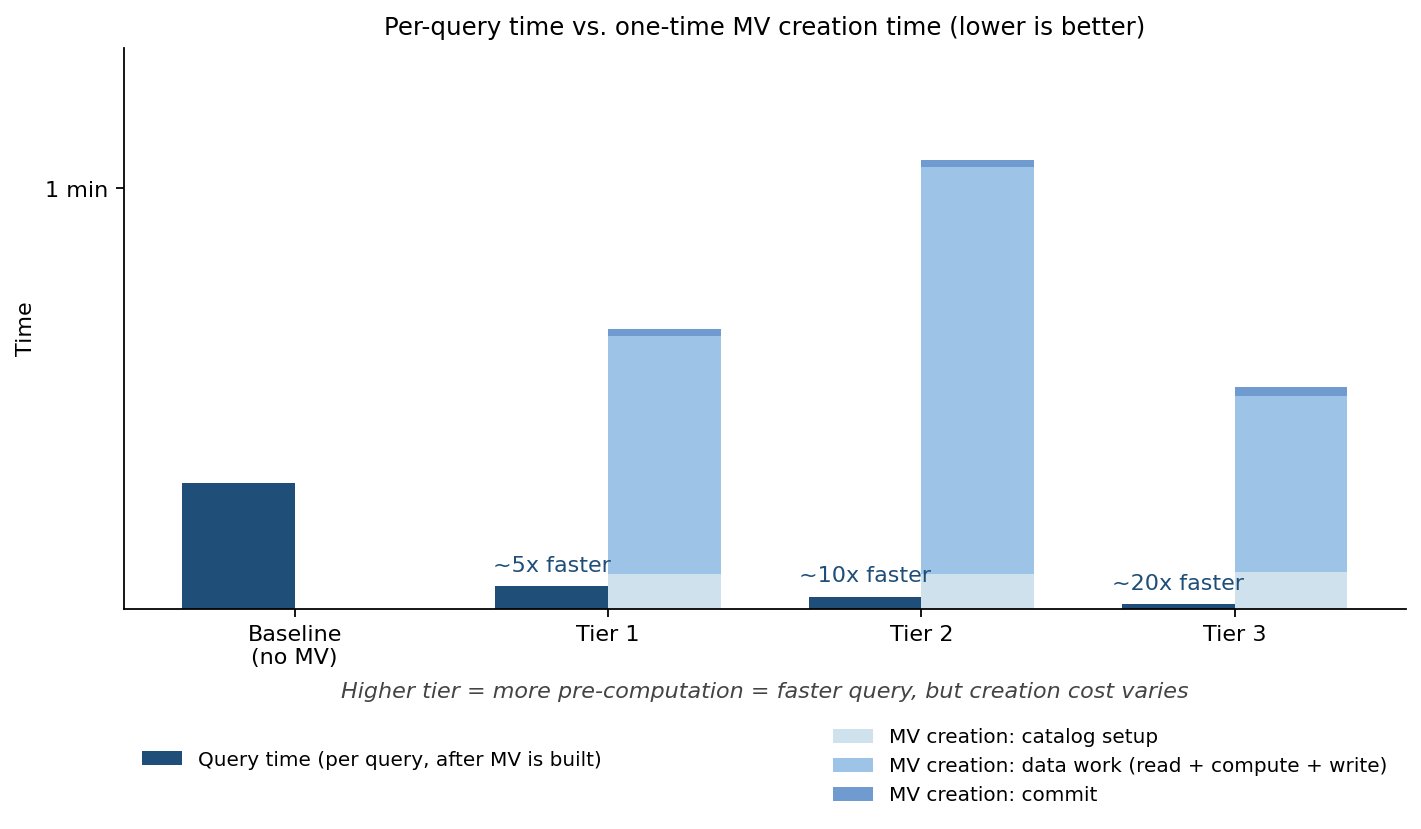
图 1:在 TPC-DS 3 TB 上测量的三个物化视图层的每查询加速比和创建时间
首先识别一个以稳定过滤条件重复运行的昂贵查询。它很可能是精确匹配 MV 的良好候选。
验证自动查询重写
要确认你的查询从自动重写中受益:
- 查询计划检查:检查查询的优化逻辑计划或物理计划,查找引用 MV 的叶扫描节点(例如
BatchScan mv_catalog.mv_db.your_mv_name)。如果 MV 作为扫描源出现,则重写成功。 - 日志确认(Amazon EMR 7.14.0+):查找 INFO 级别日志条目,例如
AQMV outcome: rewritten=true, mvs=[mv_name], duration=12ms。 - 未重写诊断(Amazon EMR 7.14.0+):如果未发生重写,请检查 Apache Spark 事件日志中的
MVRewriteMetricsEvent,了解优化器跳过 MV 的具体原因。
如果你已设置 spark.sql.optimizer.answerQueriesWithMVs.enabled=true 但查询仍针对基表运行,请检查以下常见原因:
- 写入命令默认阻止重写。 INSERT 和 MERGE 语句不会触发重写。设置
spark.sql.optimizer.answerQueriesWithMVs.commandBlockingEnabled=false以在写入命令子查询中启用重写。 - MV 已过期。 如果自上次刷新以来一个或多个源表已更改,重写会跳过该 MV。等待下一次计划刷新,或使用
REFRESH MATERIALIZED VIEW <mv_name>强制立即刷新。 - 启发式候选过滤。 优化器在尝试完全匹配之前使用启发式检查来缩小 MV 候选集。在某些情况下,可能使查询受益的 MV 会提前被这些启发式过滤掉。
- Spark 版本不匹配(Amazon EMR 7.13.0+)。 自动查询重写会跳过存储的
IMV_sparkVersion与集群当前 Apache Spark 版本不匹配的 MV。要绕过此检查,请设置spark.sql.materializedView.sparkVersionCompatibilityCheck.enabled=false。 - MV 元数据缓存未加载。 元数据缓存在 Spark 会话中第一个可重写查询的优化过程中惰性加载。如果你的关键查询在缓存预热之前触发,MV 将不可用。在会话启动时运行一个小型预热查询(例如,
SELECT 1 FROM <some_iceberg_table>),以将这一成本从关键路径上移除。 - MV 元数据缓存内存限制已达到。 如果缓存因达到内存限制而被禁用或停止加载 MV,请增加
spark.driver.memory。 - 配置的目录中表过多。 如果配置的目录中有很多表或 MV,缓存在你的查询开始之前可能无法完成加载。将 MV 放在一个专用目录中,将其添加到
spark.sql.materializedViews.additionalCatalogs,并设置spark.sql.materializedViews.scanCurrentCatalog=false以跳过扫描当前目录。 - Parquet 基表有额外的限制和配置要求。要对 Parquet 基表进行自动查询重写,请设置
spark.sql.materializedView.v1SourceTables.enabled=true和spark.sql.materializedView.v1ETagVersioning.enabled=true。如果没有 ETag 版本控制,Spark 无法确定可用的源表版本并会跳过 MV。分区 Parquet 基表还受到额外验证限制的约束。
性能注意事项
开启自动查询重写会带来开销:它引入了权衡,可能对某些查询产生负面影响:
- 优化开销。 启用重写会在查询优化期间增加处理时间,因为优化器会针对查询计划评估 MV 候选。此开销适用于会话中的每个查询,包括那些最终不匹配任何 MV 的查询。
- 任务并行度降低。 从 MV 而不是原始基表读取可能会产生更少的任务或引入数据倾斜,具体取决于 MV 的数据布局。与直接扫描更大、分布更均匀的源表相比,这会降低并行度。
结论
在这篇博文中,我们展示了自动查询重写如何加速你现有的 Apache Spark 工作负载。它在 AWS Glue Data Catalog 中使用 Apache Iceberg 物化视图,而无需更改一行 SQL。通过将预计算结果存储为托管的 Apache Iceberg 表,AWS Glue Data Catalog 让 Apache Spark 优化器能够透明地替换匹配的查询计划。你无需在应用层重新接线即可获得预聚合的性能优势。BI 仪表板、ISV 生成的报告和旧版管道只要存在匹配的 MV 就能立即受益。
我们介绍了针对同一分析查询的三种 MV 设计,每种设计在单查询加速、存储占用以及工作负载中的复用之间取得了不同的平衡。如权衡表所示,我们的测试发现,一个窄的、精确匹配的 MV 为单一查询形状带来了 20 倍以上的加速。一个更广泛的预聚合以约 5 倍的较温和增益服务了整个查询家族。正确的选择取决于有多少查询共享相同的连接加聚合模式,以及你的源数据变更的频率。
要开始使用:
- 启动一个 Amazon EMR 7.12.0+ 集群或一个 AWS Glue 5.1+ 作业。
- 使用
CREATE MATERIALIZED VIEW在 AWS Glue Data Catalog 中为你最昂贵的重复查询创建一个 MV。 - 通过在 Spark 会话配置中设置
spark.sql.optimizer.answerQueriesWithMVs.enabled=true来开启自动查询重写。 - 通过检查优化后的查询计划中是否存在 MV 扫描节点,或在 Amazon EMR 7.14.0+ 上检查 INFO 级日志来验证重写。
对大型事实表进行多表连接、重度聚合或窗口函数的查询是强有力的初始候选。从一个高成本、频繁执行的查询开始。验证加速效果,然后在识别出工作负载中的共享模式时扩展到更广泛的 MV。
特别感谢所有为自动查询重写功能和本博文做出贡献的人:Andre Hernich、Leon Lin、Yiyang Chen、Geeta Krishna Panda、Ashok Chintalapati、Muhammad Malik、Rishabh Bhatia 和 Giovanni Fumarola。
参考资料
更多详细信息,请参阅以下资源:
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏