AWS Glue 上使用 DuckDB 与 S3 Tables 的高性价比 ETL
DataHot 速览
AWS 官方博客介绍在 AWS Glue 作业中运行 DuckDB 的模式:DuckDB 作为嵌入式、进程内、向量化 SQL 引擎,可直接读取 S3 上的 Parquet,并通过 Iceberg REST 端点将 Apache Iceberg 表写入 Amazon S3 Tables,无需单独同步目录。该模式适合以 SQL 为中心的过滤、连接、聚合,以及按小时或按天运行的聚合、增量加载和汇总等频繁调度任务,并强调快速启动。AWS Glue 6.0 是当前版本,运行在现代化运行时上,相比旧版本价格降低 30%。文章给出可运行代码和具体 ETL 用例,并将实测成本与运行时间同执行相同工作的 Spark 作业进行比较;该模式与 AWS Glue 上的 Apache Spark 互补而非替代。
为什么值得关注:数据从业者可了解如何在 Serverless ETL 中按任务形态选择 DuckDB 或 Spark,并利用 S3 Tables/Iceberg 降低频繁 SQL 作业的成本与启动开销。文中包含可运行代码和与 Spark 的实测成本、运行时间对比,具备直接参考价值。
本文目录 17 节
译文
AI 逐段翻译许多数据集成作业都以 SQL 为核心:它们按计划对数据进行过滤、连接和聚合,而且运行频率足够高,因此快速启动至关重要。对于这类工作负载,团队希望让引擎与作业相匹配,快速且经济高效地运行,而无需搭建和调优单独的基础设施。
AWS Glue 是无服务器数据集成服务,客户使用它来运行任意规模的提取、转换和加载(ETL)作业,而无需管理基础设施。借助 AWS Glue,你可以在标准 AWS Glue 作业中运行 DuckDB,这是一个嵌入式、进程内、向量化的 SQL 引擎。DuckDB 从 Amazon Simple Storage Service(Amazon S3)读取 Parquet 文件,并将 Apache Iceberg 表直接写入 Amazon S3 Tables,这是 Amazon S3 的一项能力。DuckDB 是一个开源、进程内、向量化的分析型 SQL 引擎,嵌入在你的应用程序中运行,无需管理单独的服务器或集群。它原生读写 Parquet 和 Apache Iceberg 等云数据格式。 AWS Glue 6.0 是最新版本,运行在经过现代化改造的运行时上,相比之前的版本价格降低了 30%。DuckDB 通过其 httpfs 扩展读取 Amazon S3 Parquet,并通过 Iceberg REST 端点将 Iceberg 快照提交到 Amazon S3 Tables,因此无需单独的目录同步。在 AWS Glue 中运行 DuckDB 非常适合以 SQL 为核心的转换,例如过滤、连接和聚合。它也适合频繁的、按计划运行的作业,例如每小时或每日聚合、增量加载和汇总,这些作业受益于快速启动。此模式是对 AWS Glue 上 Apache Spark 的补充,而非替代:当工作负载需要分布式处理时,同一作业类型可运行 PySpark,而无需更改你的基础设施、IAM 或触发器。
本文通过一个具体的 ETL 用例演示该模式,并提供完整、可运行的代码。它还将实测的成本和运行时间与在相同 AWS Glue 6.0 运行时上执行相同工作的 Spark 作业进行了对比。
何时使用此模式
此模式是对 AWS Glue 上 Spark 的补充,而非替代。下表总结了每种方法在何时能产生最佳结果。
| 信号 | AWS Glue 6.0 上的 DuckDB | AWS Glue 6.0 上的 Apache Spark |
| 每次运行的数据集大小 | 随工作节点大小扩展 | 跨多个节点水平扩展,适用于任意大小的数据集 |
| 并行性要求 | 单节点、进程内执行 | 跨托管集群的分布式处理 |
| SQL 复杂度 | 聚合、连接、窗口函数 | 复杂图操作、自定义 UDF、机器学习流水线 |
| 成本优先级 | 最小化每次运行的成本和时长 | 在规模上最大化吞吐量 |
| Iceberg 写入 | DuckDB iceberg 扩展到 S3 Tables | 原生 Spark Iceberg 集成 |
对于需要分布式处理的工作负载,同一 glueetl 作业类型可运行 PySpark,而无需更改你的基础设施、AWS Identity and Access Management(IAM)配置或触发器。你可以选择适合每个工作负载的引擎。
DuckDB 如何在 AWS Glue 6.0 上运行
在 AWS Glue 作业中运行 DuckDB 归结为两件事的协同:一个足够现代化、能够加载 DuckDB 及其原生扩展的运行时,以及 DuckDB 在加载后为 ETL 带来的能力。
AWS Glue 6.0 运行时提供什么
现代运行时兼容性。 AWS Glue 6.0 运行在 Amazon Linux 2023 上,使用 glibc 2.34 和 Python 3.13。DuckDB 1.5.x 及其原生 C++ 扩展二进制文件(httpfs、aws、iceberg)可通过 pip 安装并加载,无需任何变通方法。DuckDB 扩展二进制文件需要现代 glibc(2.28 或更高版本),而 AWS Glue 6.0 运行时提供了这一支持。
AWS Glue 6.0 解决了这一兼容性要求。你可以通过两种方式将 DuckDB 1.5.x 添加到 AWS Glue 6.0 作业中。第一种是 --additional-python-modules 作业参数(duckdb==1.5.1),它会在作业启动时通过 pip 安装该包,并加载所有扩展,无需额外步骤。或者,你可以将依赖项打包为 Python 虚拟环境,上传到 Amazon S3,并使用 --python-virtual-env 参数引用它。在 AWS Glue 6.0 上,你还可以添加 --python-virtual-env-storage-prefix,让 AWS Glue 自动构建并缓存虚拟环境。有关更多信息,请参阅 使用 Python 虚拟环境与 AWS Glue。
DuckDB 提供什么
DuckDB 是一个开源、进程内的分析型 SQL 引擎。它作为单个进程在 AWS Glue 作业内运行,没有单独的集群或协调器。以下能力使其切实适合在 AWS Glue 6.0 运行时上进行 ETL。
- 单节点向量化执行。 DuckDB 在单个 AWS Glue 作业内运行。对于几 GB 的数据,没有 shuffle、没有执行器调度、也没有节点间网络 I/O。工作在列式内存上以单次向量化遍历完成。
- 原生 Amazon S3 和 Parquet 访问。
httpfs扩展直接读写 Amazon S3 对象,通过CREDENTIAL_CHAIN自动使用 AWS Glue 作业的 IAM 角色。 - 原生 Amazon S3 Tables 写入。
iceberg扩展连接到 Amazon S3 Tables Iceberg REST 端点(ENDPOINT_TYPE s3_tables)并提交标准 Iceberg 快照。借助 AWS Glue 6.0,你可以使用两项各自独立成熟的能力:Amazon S3 Tables 和 DuckDB Iceberg 写入。 - 大于内存的算子。 排序、连接和聚合会溢写到
/tmp,因此大于可用 RAM 的数据集仍可处理,无需更改代码。
输出是 Apache Iceberg 表,位于 Amazon S3 Tables 中。它可由 Amazon Athena、Amazon Redshift 和 Amazon EMR,以及其他支持 Iceberg REST Catalog API 的 Iceberg 兼容引擎查询。
容量规划指引。 DuckDB 在单个 AWS Glue 工作节点内运行,因此其可用内存和磁盘随工作节点类型扩展。本演练使用最小的 glueetl包含 2 个 worker(2 个数据处理单元,即 DPU)的配置,worker 类型为 G.1X:每个 G.1X worker 提供 4 个 vCPU 和 16 GB 内存。DuckDB 在 driver 上运行并在内存中处理数据,当数据集或中间结果超出可用 RAM 时溢出到本地磁盘。对于更大的输入,请选择更大的 worker:G.2X 提供 8 个 vCPU 和 32 GB 内存,而 G.4X 和 G.8X 类型可扩展到更高规格。请根据您的输入量以及聚合和连接的内存占用情况来确定 worker 大小。有关当前规格,请参阅AWS Glue worker 类型。
架构
下图展示了本文所述的架构。
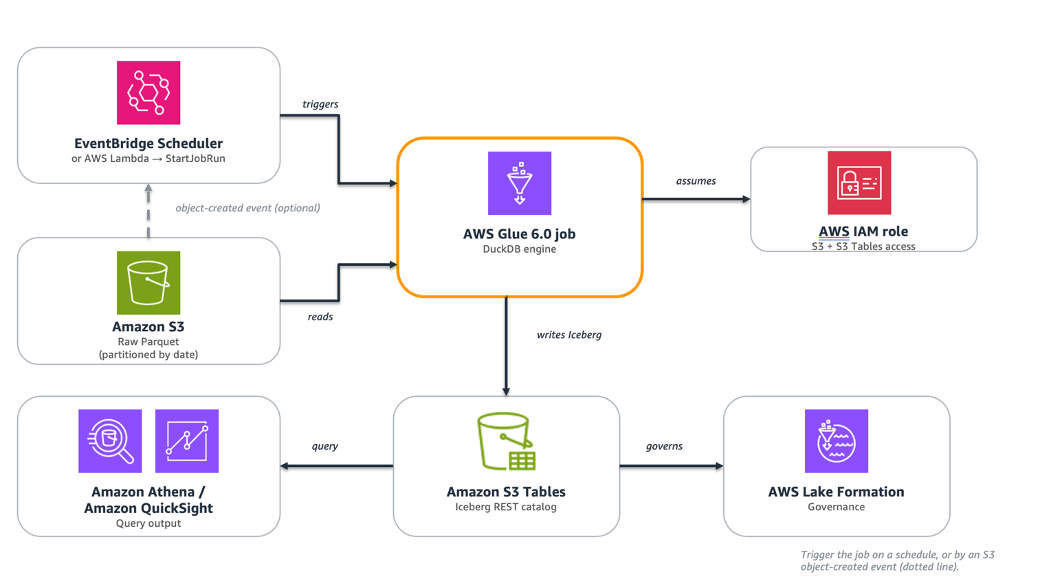
图 1:数据从 Amazon S3 中的原始 Parquet 文件流经运行 DuckDB 的 AWS Glue 6.0 作业,该作业将 Apache Iceberg 表写入 Amazon S3 Tables,以供 Amazon Athena 和 Amazon QuickSight 查询。
该管道由以下托管组件组成:
| 层 | 角色 | AWS 服务 |
| 源 | 按日期分区的原始 Parquet 文件 | Amazon S3 |
| 计算 | 在 AWS Glue 6.0 运行时上运行的 DuckDB SQL 引擎 | AWS Glue 6.0(glueetl) |
| 目标 | 可由任何引擎查询的 Iceberg 分析表 | Amazon S3 Tables |
| 治理 | S3 Tables 写入的权限和访问控制 | AWS Lake Formation |
| 查询 | 对输出表的分析和商业智能(BI) | Amazon Athena、Amazon QuickSight |
原始 Parquet 文件按计划到达 Amazon S3。AWS Glue 6.0 作业运行 DuckDB。DuckDB 读取这些文件,在内存中应用 SQL 转换,并通过 Iceberg REST catalog 将聚合结果作为 Iceberg 表写入 Amazon S3 Tables。 Amazon Athena 和 Amazon QuickSight可以立即查询输出。无需单独的 catalog 同步。
您可以通过多种方式触发该作业:
- 使用原生 AWS Glue 触发器,可以按计划、按需触发,或根据另一个作业或爬网程序完成情况有条件地触发。
- 使用 Amazon EventBridge Scheduler 按固定计划调用
StartJobRun。 - 通过调用 AWS Lambda 函数并调用
StartJobRun的 Amazon S3 事件通知来响应新数据。 - 作为 AWS Glue Workflow 的一部分。
演练:电子商务每日订单汇总
本节演练一个电子商务应用程序的每日 ETL 管道。该管道从 Amazon S3 读取原始交易文件,对其进行清洗和聚合,并将可供查询的汇总写入 Amazon S3 Tables。
| 步骤 | 操作 | 详情 |
| 1. 源 | 从 S3 读取原始 Parquet | s3://<amzn-s3-demo-source-bucket>/orders/year=2026/month=08/*.parquet |
| 2. 筛选 | status IN (‘completed’,‘processing’) | 丢弃已取消和测试订单 |
| 3. 充实 | net_revenue、 avg_order_value | 通过 SQL 表达式派生的列 |
| 4. 聚合 | GROUP BY order_day, region, category | 每日收入、订单数、唯一客户数 |
| 5. 写入 | INSERT 写入 Amazon S3 Tables Iceberg 表 | 按天幂等重新加载 |
先决条件
- 一个具有 AWS Glue、Amazon S3、Amazon S3 Tables、AWS Identity and Access Management(IAM)和 AWS Lake Formation 权限的 AWS 账户。
- 一个包含原始 Parquet 文件的 Amazon S3 存储桶(在本文中称为
<amzn-s3-demo-source-bucket>)。 - 一个 Amazon S3 Tables 表存储桶(在本文中称为
<amzn-s3-demo-table-bucket>)。请参阅 创建 S3 Tables 表存储桶 一节。 - 对
<amzn-s3-demo-source-bucket>的 Amazon S3 读取权限。 - Amazon S3 Tables 读写权限。
- AWS Glue 作业执行权限。
AWS Lake Formation 对 S3 Tables catalog 和命名空间的授权(Iceberg 写入操作所需)。一个 AWS Glue 6.0 作业(glueetl),具有:
--additional-python-modules:duckdb==1.5.1。- 最低 worker 配置:2 个 worker,类型为 G.1X。
关于 DuckDB 版本的说明。 DuckDB 对通过 REST catalog(包括 Amazon S3 Tables)写入 Apache Iceberg 表的支持要求版本 1.4.0 或更高。本演练使用 duckdb==1.5.1。在 AWS Glue 6.0 运行时(Amazon Linux 2023)上,它可以安装,且所有原生扩展无需额外配置即可加载。
创建 S3 Tables 表存储桶
如果您还没有 Amazon S3 Tables 表存储桶,请使用 AWS Command Line Interface(AWS CLI)创建一个:
aws s3tables create-table-bucket \
    --name <amzn-s3-demo-table-bucket> \
    --region <YOUR-REGION>
请记下输出中的表存储桶 Amazon Resource Name(ARN)。其格式如下:
arn:aws:s3tables:<YOUR-REGION>:<YOUR-ACCOUNT-ID>:bucket/<amzn-s3-demo-table-bucket>
开启与 AWS 分析服务的集成,以便该表可被 Amazon Athena、Amazon Redshift 和 Amazon EMR 发现。请使用 AWS CLI 在 AWS Glue Data Catalog 中创建 s3tablescatalog catalog 以完成集成。有关步骤,请参阅 将 Amazon S3 Tables 与 AWS 分析服务集成。
开启集成后,向 AWS Glue 作业角色授予对 Amazon S3 Tables catalog 和 analytics 命名空间的 Lake Formation 权限:
# Allow the job to create the target table on first run (namespace-scoped)
aws lakeformation grant-permissions \
    --principal DataLakePrincipalIdentifier=arn:aws:iam::<YOUR-ACCOUNT-ID>:role/<YOUR-AWS-GLUE-ROLE> \
    --resource '{"Database":{"Name":"analytics","CatalogId":"<YOUR-ACCOUNT-ID>:s3tablescatalog/<amzn-s3-demo-table-bucket>"}}' \
    --permissions '["CREATE_TABLE"]'

# Grant only the operations the job performs on the target table
aws lakeformation grant-permissions \
    --principal DataLakePrincipalIdentifier=arn:aws:iam::<YOUR-ACCOUNT-ID>:role/<YOUR-AWS-GLUE-ROLE> \
    --resource '{"Table":{"DatabaseName":"analytics","Name":"daily_order_summary","CatalogId":"<YOUR-ACCOUNT-ID>:s3tablescatalog/<amzn-s3-demo-table-bucket>"}}' \
    --permissions '["SELECT","INSERT","DELETE"]'
生成示例数据
本演练使用合成电子商务数据集。请在本地或 AWS CloudShell 中运行以下 Python 脚本,以生成与转换中所用 schema 匹配的 Parquet 文件。它会生成约 840 万行,分布在 12 个文件中(作为 Parquet 在磁盘上约 94 MB,在内存中未压缩约 1.2 GB)。
import pandas as pd
import numpy as np
import pyarrow as pa
import pyarrow.parquet as pq
import os

np.random.seed(42)

N = 8_400_000  # ~8.4M rows
NUM_FILES = 12  # split across 12 files to mimic a partitioned landing zone

df = pd.DataFrame({
    "order_date": pd.date_range("2026-08-01", periods=N, freq="s"),
    "region": np.random.choice(["US", "EU", "APAC"], N),
    "category": np.random.choice(["electronics", "books", "home", "clothing"], N),
    "status": np.random.choice(
        ["completed", "processing", "cancelled"], N, p=[0.6, 0.3, 0.1]
    ),
    "quantity": np.random.randint(1, 10, N),
    "unit_price": np.round(np.random.uniform(5.0, 200.0, N), 2),
    "customer_id": np.random.randint(1000, 9999, N),
})

os.makedirs("sample_orders", exist_ok=True)

for i, chunk in enumerate(np.array_split(df, NUM_FILES)):
    path = f"sample_orders/orders_part_{i}.parquet"
    pq.write_table(pa.Table.from_pandas(chunk), path)
    print(f"Wrote {path} ({os.path.getsize(path):,} bytes)")
将生成的文件上传到您的源存储桶:
aws s3 cp sample_orders/ \
    s3://<amzn-s3-demo-source-bucket>/orders/ \
    --recursive
注意。 本演练中的 CLI 命令和代码示例使用尖括号占位符,例如 <amzn-s3-demo-source-bucket> 和 <amzn-s3-demo-table-bucket>。在运行之前,请将这些占位符替换为您自己的值。
步骤 1:在 AWS Glue 6.0 作业中配置 DuckDB
除 /tmp 外,AWS Glue 文件系统为只读,因此 DuckDB 使用 /tmp 作为其扩展缓存和溢出文件的可写主目录。该作业加载 DuckDB 扩展:httpfs 直接读写 Amazon S3 对象,aws 处理 AWS 凭证解析、刷新和 AWS Region 检测,而 iceberg 连接到 Amazon S3 Tables REST catalog。CREDENTIAL_CHAIN 提供程序(来自 aws 扩展)告诉 DuckDB 使用标准 AWS 凭证提供程序链,该链会自动选取附加到 AWS Glue 作业的 IAM 角色。代码中不会出现访问密钥或机密。
import os
import duckdb

os.makedirs('/tmp/.duckdb/extensions', exist_ok=True)

con = duckdb.connect(':memory:')
con.execute("SET home_directory='/tmp';")
con.execute("SET extension_directory='/tmp/.duckdb/extensions';")

con.execute("INSTALL httpfs; LOAD httpfs;")
con.execute("INSTALL aws; LOAD aws;")
con.execute("INSTALL iceberg; LOAD iceberg;")

con.execute("CREATE SECRET (TYPE s3, PROVIDER credential_chain);")
该 home_directory 设置必须在加载任何扩展之前应用。如果没有它,DuckDB 会尝试写入 /.duckdb/ 并失败,报错 IOError: Permission denied。
步骤 2:使用 DuckDB SQL 读取和转换
DuckDB 通过 httpfs 扩展 直接读取 Amazon S3 Parquet 文件。无需本地下载。read_parquet() 函数接受 Amazon S3 glob 模式,将多个文件作为单个关系读取。
import sys
from awsglue.utils import getResolvedOptions

args = getResolvedOptions(sys.argv, ['s3_input_path'])
S3_INPUT = args['s3_input_path']

con.execute(f"""
CREATE OR REPLACE TEMP TABLE _batch AS
SELECT date_trunc('day', order_date) AS order_day,
region, category,
COUNT(*) AS total_orders,
SUM(quantity * unit_price) AS gross_revenue,
SUM(CASE WHEN status = 'completed'
THEN quantity * unit_price ELSE 0 END) AS net_revenue,
COUNT(DISTINCT customer_id) AS unique_customers,
ROUND(AVG(quantity * unit_price), 2) AS avg_order_value,
SUM(CASE WHEN quantity * unit_price > 500
THEN 1 ELSE 0 END) AS high_value_orders
FROM read_parquet('{S3_INPUT}')
WHERE status IN ('completed', 'processing')
GROUP BY ALL
ORDER BY order_day DESC, gross_revenue DESC
""")
GROUP BY ALL 是 DuckDB SQL 扩展,它会按 SELECT 列表中的每个非聚合列进行分组。这是一个便利功能,而非标准 SQL,并且不同查询引擎的支持情况各异。如果你将此查询调整用于另一个引擎,请检查它是否支持 GROUP BY ALL,或者显式列出分组列(GROUP BY order_day, region, category)。
该 WHERE 子句同时保留 completed 和 processing 订单。gross_revenue 列反映所有进行中的收入,而 net_revenue 仅统计已完成的订单。仅包含处理中订单的分区会显示 net_revenue = 0。这是有意设计的:这两列服务于不同的报告目的。
步骤 3:写入 Amazon S3 Tables
DuckDB 使用 ENDPOINT_TYPE s3_tables 选项将 S3 Tables 存储桶作为 Iceberg REST 目录附加。DuckDB 通过该目录将每次写入提交为新的 Iceberg 快照。
写入使用幂等的按日重新加载模式:如果表不存在则创建表,删除该批次日期范围内的任何现有行,然后插入。这样,重新运行不会产生重复行。
注意: DELETE 和 INSERT 不是原子提交的。如果作业在两者之间失败,受影响的分区会留空。有关缓解措施,请参阅 生产环境的错误处理。
import sys
from awsglue.utils import getResolvedOptions

args = getResolvedOptions(sys.argv, ['s3t_arn'])
S3T_ARN = args['s3t_arn']

con.execute(f"ATTACH '{S3T_ARN}' AS s3t (TYPE iceberg, ENDPOINT_TYPE s3_tables);")
con.execute("CREATE SCHEMA IF NOT EXISTS s3t.analytics;")
con.execute("""
CREATE TABLE IF NOT EXISTS s3t.analytics.daily_order_summary (
order_day DATE,
region VARCHAR,
category VARCHAR,
total_orders BIGINT,
gross_revenue DOUBLE,
net_revenue DOUBLE,
unique_customers BIGINT,
avg_order_value DOUBLE,
high_value_orders BIGINT
);
""")

con.execute("""
DELETE FROM s3t.analytics.daily_order_summary
WHERE order_day IN (SELECT DISTINCT order_day FROM _batch);
""")
con.execute("""
INSERT INTO s3t.analytics.daily_order_summary BY NAME
SELECT * FROM _batch;
""")

count = con.execute(
"SELECT COUNT(*) FROM s3t.analytics.daily_order_summary"
).fetchone()[0]
print(f"S3 Tables now holds {count} rows in analytics.daily_order_summary")
生成的 Iceberg 表可立即被 Amazon Athena、Amazon Redshift 和 Amazon EMR 通过 S3 Tables REST 目录读取。Amazon S3 Tables 自动处理压缩、快照过期和孤立文件清理。
完整的 AWS Glue 6.0 作业脚本
以下脚本结合了全部三个步骤,并包含结构化日志记录、错误处理和 AWS Glue 作业参数解析。它可以直接用作 AWS Glue 6.0 glueetl 作业的脚本。
import os, sys, logging, duckdb
from awsglue.utils import getResolvedOptions

logging.basicConfig(level=logging.INFO,
                    format='%(asctime)s %(levelname)s %(message)s')
logger = logging.getLogger(__name__)

TARGET = 's3t.analytics.daily_order_summary'

DDL = """
CREATE TABLE IF NOT EXISTS s3t.analytics.daily_order_summary (
order_day DATE, region VARCHAR, category VARCHAR,
total_orders BIGINT, gross_revenue DOUBLE, net_revenue DOUBLE,
unique_customers BIGINT, avg_order_value DOUBLE, high_value_orders BIGINT
);
"""

TRANSFORM = """
SELECT date_trunc('day', order_date) AS order_day,
region, category,
COUNT(*) AS total_orders,
SUM(quantity * unit_price) AS gross_revenue,
SUM(CASE WHEN status = 'completed' THEN quantity * unit_price ELSE 0 END) AS net_revenue,
COUNT(DISTINCT customer_id) AS unique_customers,
ROUND(AVG(quantity * unit_price), 2) AS avg_order_value,
SUM(CASE WHEN quantity * unit_price > 500 THEN 1 ELSE 0 END) AS high_value_orders
FROM read_parquet('{s3_input}')
WHERE status IN ('completed', 'processing')
GROUP BY ALL
ORDER BY order_day DESC, gross_revenue DESC
"""

def setup_duckdb():
    os.makedirs('/tmp/.duckdb/extensions', exist_ok=True)
    con = duckdb.connect(':memory:')
    con.execute("SET home_directory='/tmp';")
    con.execute("SET extension_directory='/tmp/.duckdb/extensions';")
    con.execute("INSTALL httpfs; LOAD httpfs;")
    con.execute("INSTALL aws; LOAD aws;")
    con.execute("INSTALL iceberg; LOAD iceberg;")
    con.execute("CREATE SECRET (TYPE s3, PROVIDER credential_chain);")
    logger.info("DuckDB %s initialized with httpfs, aws, and iceberg extensions",
                duckdb.__version__)
    return con

def transform_orders(con, s3_path):
    logger.info("Reading source data: %s", s3_path)
    con.execute("CREATE OR REPLACE TEMP TABLE _batch AS " +
                TRANSFORM.format(s3_input=s3_path))
    return con.execute("SELECT COUNT(*) FROM _batch").fetchone()[0]

def write_to_s3_tables(con, s3t_arn):
    con.execute(f"ATTACH '{s3t_arn}' AS s3t (TYPE iceberg, ENDPOINT_TYPE s3_tables);")
    con.execute("CREATE SCHEMA IF NOT EXISTS s3t.analytics;")
    con.execute(DDL)
    con.execute(f"""
DELETE FROM {TARGET}
WHERE order_day IN (SELECT DISTINCT order_day FROM _batch);
""")
    con.execute(f"INSERT INTO {TARGET} BY NAME SELECT * FROM _batch;")
    count = con.execute(f"SELECT COUNT(*) FROM {TARGET}").fetchone()[0]
    logger.info("Write complete. %s now holds %s rows.", TARGET, count)
    return count

def main():
    args = getResolvedOptions(sys.argv, ['s3_input_path', 's3t_arn'])
    con = setup_duckdb()
    n = transform_orders(con, args['s3_input_path'])
    logger.info("Transformed %s summary rows", n)
    total = write_to_s3_tables(con, args['s3t_arn'])
    logger.info("ETL complete. Table holds %s total rows.", total)

if __name__ == '__main__':
    main()
使用 AWS CLI 创建作业:
aws glue create-job \
    --name duckdb-order-summary \
    --role <YOUR-AWS-GLUE-ROLE> \
    --glue-version "6.0" \
    --number-of-workers 2 --worker-type G.1X \
    --command '{"Name":"glueetl","ScriptLocation":"s3://<amzn-s3-demo-source-bucket>/scripts/duckdb_job.py","PythonVersion":"3"}' \
    --default-arguments '{
    "--additional-python-modules": "duckdb==1.5.1",
    "--s3_input_path": "s3://<YOUR-SOURCE-BUCKET>/orders/year=2026/month=08/*.parquet",
    "--s3t_arn": "arn:aws:s3tables:<YOUR-REGION>:<YOUR-ACCOUNT-ID>:bucket/<amzn-s3-demo-table-bucket>"
}'
注意。 在运行前,请将尖括号占位符(<amzn-s3-demo-source-bucket>、<amzn-s3-demo-table-bucket>、<YOUR-REGION>、<YOUR-ACCOUNT-ID>、<YOUR-AWS-GLUE-ROLE>)替换为你自己的值。
Lake Formation 权限。 Amazon S3 Tables 访问由 AWS Lake Formation 管控。仅向 AWS Glue 作业角色授予该作业所需的权限:SELECT、INSERT 和 DELETE 作用于目标表(daily_order_summary),外加 CREATE_TABLE 作用于 analytics 命名空间,以便作业在首次运行时可以创建表。有关确切的权限名称和资源范围,请参阅 Lake Formation 权限 参考。该角色还需要 lakeformation:GetDataAccess IAM 操作。如果没有这些授权,ATTACH 和 CREATE TABLE 语句会因访问被拒绝错误而失败。
生产环境的错误处理
对于生产使用,请为三种故障模式做好规划:
- 目录访问。 如果
ATTACH到 Amazon S3 Tables 返回访问被拒绝错误,请验证作业的 IAM 角色是否对表存储桶 ARN 具有限定范围的 Amazon S3 Tables 操作以及所需的 AWS Lake Formation 授权。写入需要两者。 - 部分写入。
DELETE和INSERT不是原子提交的,因此它们之间的失败可能会使分区留空。将MaxRetries设置为 1,以便幂等重新加载会自动重新运行,或者写入暂存表并在成功后切换。 - 超时。 将作业
Timeout设置为高于预期运行时间,以停止挂起的运行。
监控
DuckDB 在标准 AWS Glue 作业中运行,因此你可以使用与任何 AWS Glue 作业相同的 Amazon CloudWatch 指标 来监控它。有两个指标有助于为此工作负载合理调整规模:
glue.driver.jvm.heap.usage:驱动程序内存压力。数值高或持续攀升意味着工作节点需要更多内存,或者查询正在大量溢出到磁盘。glue.driver.aggregate.bytesRead:从 Amazon S3 读取的字节数,有助于将输入大小与运行时间和成本关联起来。
DuckDB 的内部执行指标(查询计划、算子耗时、溢写量)不会暴露给 Amazon CloudWatch。作业脚本中的结构化日志记录是观察 DuckDB 本身的主要方式:生产脚本使用 logger.info 记录已转换行数和已写入行数,这些行会出现在作业的 CloudWatch Logs 流中。如果你需要更细粒度的时间记录,请在每个阶段周围添加更多 logger.info 语句。
实测结果
本节中的测量数据是在 AWS Glue 6.0 上使用 DuckDB 1.5.1 写入美国东部(弗吉尼亚北部)区域(us-east-1)的 Amazon S3 Tables 时收集的。输出表已通过在 Amazon Athena 中查询它们进行验证。两个作业产生了相同的输出:1,176 行汇总行。
数据集由 12 个 Parquet 文件中的 840 万行组成(磁盘上压缩后约 94 MB,未压缩约 1.2 GB)。一个作业在 AWS Glue 6.0 运行时上运行 DuckDB。另一个在 AWS Glue 6.0 上运行 Apache Spark,使用等效转换和原生 Iceberg 写入。
| 指标 | AWS Glue 6.0 上的 DuckDB | AWS Glue 6.0 上的 Spark |
| 计算配置 | 2 DPU(2x G.1X) | 2 DPU(2x G.1X) |
| 作业时长 | 约 56 秒 | 约 117 秒 |
| 计费时长 | 1 分钟(最低) | 2 分钟 |
| 每次运行成本 | $0.0103 | $0.0205 |
| 输出行数(经 Athena 验证) | 1,176 | 1,176 |
在相同的 AWS Glue 6.0 运行时和相同的 2 DPU 配置下,对于此工作负载,DuckDB 以大约一半的时间和大约一半的成本完成了 Spark 的工作。
成本按每 DPU 小时 $0.308(AWS Glue 6.0 费率)计算。AWS Glue 按 1 秒增量计费,每次运行最低 1 分钟。请根据你所在区域当前的 AWS Glue 定价页面 进行核实。结果会随数据集大小、查询复杂度和区域而变化。
按每天运行 20 次计算,使用 DuckDB 时此作业每年成本约为 75 美元,而使用 Spark 则为每年 150 美元。除了成本节省之外,这种模式还使以 SQL 为中心的工作能够快速迭代:你用 SQL 表达转换逻辑,DuckDB 在 AWS Glue 工作节点上以进程内方式运行它。
清理
为避免持续产生费用,请删除本演练过程中创建的资源:
- 删除 AWS Glue 作业(
duckdb-order-summary)。 - 从你的 Amazon S3 存储桶中删除示例数据(
s3://<amzn-s3-demo-source-bucket>/orders/)。 - 在 Amazon Athena 中删除 Iceberg 表:
DROP TABLE analytics.daily_order_summary; - 如果 Amazon S3 Tables 表存储桶是为本演练创建的,请将其删除。
- 撤销 AWS Lake Formation 授权,并在不再需要时删除 IAM 角色。
结论
在本文中,我们演示了如何在 AWS Glue 6.0 作业中运行 DuckDB,以读取 Amazon S3 Parquet,用 SQL 对其进行转换,并将 Apache Iceberg 表直接写入 Amazon S3 Tables。AWS Glue 6.0 将运行时环境现代化为 Amazon Linux 2023、Python 3.13 和 Apache Spark 4.1。借助这一现代化,你可以在 AWS Glue 作业中运行嵌入式 SQL,并将 Iceberg 表直接写入 Amazon S3 Tables。对于数据能够放入单个工作节点内存的 ETL 作业,此模式完成相同工作的时间约为 Spark 的一半,成本也约为 Spark 的一半。Measured results 部分描述了这些测量结果。该作业使用与 AWS Glue 上任何 Spark 作业相同的 glueetl 作业类型、IAM 配置和触发机制。当工作负载超出单工作节点处理能力时,将脚本切换回 PySpark 无需更改基础设施。结果是能够为每个作业匹配引擎:一个计划性 SQL 转换和一个大规模分布式工作负载可以在同一平台上运行,你可以按作业选择引擎,而无需管理单独的系统。
要开始使用,请创建一个 AWS Glue 6.0 作业,通过 duckdb==1.5.1 参数添加 --additional-python-modules,并将其指向你的 Amazon S3 源数据和 Amazon S3 Tables 存储桶。本文中的完整脚本是一个可用的起点,你可以根据自己的数据集和计划进行调整。有关更多信息,请参阅 AWS Glue Developer Guide 和 Amazon S3 Tables user guide。有关使用 DuckDB 读取和查询 Amazon S3 Tables 中数据的补充模式,请参阅 Streamlining access to tabular datasets stored in Amazon S3 Tables with DuckDB。
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏