Lakebase Search 实测:真实应用与400万片段规模
DataHot 速览
Databricks 内部应用 Slide Hub 用 Lakebase Postgres 为约 700 份内部演示文稿提供搜索,工程师可按语义和关键词查找单页幻灯片,MCP server 也让 AI Agent 复用同一搜索。Slide Hub 的 2.3 万行幻灯片数据与投票、遥测、变更历史、预览及两类索引同库存储,被用作真实负载基准。Lakebase Search 通过 lakebase_vector、lakebase_text 扩展支持 ANN 与 BM25,并采用 IVF 分区和 RaBitQ 量化。文章给出从 100 万到 400 万行公共语料的测试、负载瓶颈、成本与计算规格选择建议。
为什么值得关注:数据从业者可了解在 Lakebase Postgres 内同时承载应用数据与语义/关键词搜索的架构、性能边界和成本取舍,为自建搜索或 Agent 工具选型提供实测参考。
本文目录 13 节
译文
AI 逐段翻译Slide Hub 是 Databricks 内部的一个应用。现场工程师用它从约 700 份内部演示文稿——活动演讲、产品演示文稿和架构演示文稿——中查找并复用幻灯片。搜索栏可按语义和关键词查找单张幻灯片,而一个 Model Context Protocol(MCP)服务器为 AI 智能体提供相同的搜索能力。该应用将幻灯片、投票、搜索遥测数据和变更历史存储在 Lakebase Postgres 中。我们以 Slide Hub 为基线来对 Lakebase Postgres 进行基准测试。它是一个真实应用,有真实用例和真实用户,因此其数据展示了该数据库在实际工作负载下的表现。
本文面向在 Databricks 上构建应用、并希望在应用自有的 Lakebase Postgres 数据库内实现搜索的开发者和架构师。文章假设你了解 SQL 和 PostgreSQL 基础知识。如果你计划在 Lakebase Postgres 上构建搜索栏或智能体工具,下面的数据可帮助你在投产前选择计算规格。
本文展示 Slide Hub 如何在 Lakebase Postgres 内运行搜索、在负载下受什么限制、成本是多少,以及 Lakebase Search 在一个公共语料库从 100 万行到 400 万行时的表现。
一个数据库同时承载应用及其搜索
Lakebase Search 已于 9 月正式发布。它是一组 Postgres 扩展,因此与应用程序表运行在一起。应用不会将数据复制到单独的搜索系统。开发者无需维护第二条事务路径。
两条 CREATE EXTENSION 语句即可启用这些组件。lakebase_vector 存储 嵌入向量,即表示文本含义的数字向量,并支持用于近似最近邻(ANN)搜索的 lakebase_ann 索引。lakebase_text 支持用于 BM25 的 lakebase_bm25 索引,BM25 是一种按文本所含查询词对文本排序的标准方法。lakebase_tokenizer 是可选的。ANN 索引使用 IVF 分区,即将相似向量分组,使查询只读取少数几组;以及 RaBitQ 量化,即将每个向量压缩到约每维 1 比特。BM25 使用 <@> 运算符对文本评分。
Slide Hub 的 2.3 万行幻灯片数据与投票、遥测数据、变更历史、预览以及两个索引位于同一个无服务器 Lakebase Postgres 实例中。应用在一个连接和一个权限模型内读取数据和索引。
搜索查询
Slide Hub 运行 混合搜索。它结合了 向量搜索,即查找与查询语义相似的幻灯片,以及 BM25 关键词搜索,即查找包含查询词的幻灯片。每种方法返回一份其最佳匹配的短列表,即 候选。一条 SQL 语句承载整个排名策略。它对每个候选列表进行排名,融合两个排名,应用应用层过滤器,并连接投票数据。搜索和应用逻辑共享一个连接、一组授权和一次提交。
Slide Hub 从每种方法取 200 个候选。它使用 Reciprocal Rank Fusion(RRF) 在 k=60 时融合两个列表:一张幻灯片在每个列表中的得分为 1/(60 + 其排名),两个得分相加。相似度阈值 0.70 会拒绝与该嵌入模型下查询距离过远、无用的向量匹配。标题层级在查询匹配幻灯片标题时增加权重。备注权重为 0.5。范围过滤器将结果限制为用户有权查看的资源。
负载下应用的瓶颈是什么
一个搜索请求使用两个独立的计算资源,其中任何一个都可能成为限制。
Lakebase Postgres 计算 运行数据库。Lakebase Postgres 以 计算单元(CU) 为其设定规格。1 CU 为数据库分配约 2 GB 内存,以及相应份额的 CPU 和本地 SSD。计算可在 0.5 CU 到 64 CU 的最小和最大规格之间自动扩缩,且最大值最多可比最小值高 16 CU。固定规格计算最高可达 112 CU,最高 32 CU 的计算可以 缩容到零。Postgres 以 8 KB 页 存储表和索引。Lakebase Postgres 将最近读取的页保留在计算上的 Local File Cache(LFC) 中。缓存随 CU 规格增长,最多可使用计算内存的 75%。不在缓存中的页需要从存储读取,耗时更长。
Databricks Apps 计算 运行 Slide Hub Web 服务器。其规格按应用固定。MEDIUM 应用最多有 2 个 vCPU 和 6 GB 内存,LARGE 应用最多有 4 个 vCPU 和 12 GB。Slide Hub 运行一个应用实例。其中每个 Python 工作进程持有一个 8 个数据库连接的连接池,因此 2 个工作进程最多打开 16 个连接,4 个工作进程最多打开 32 个。
对于每个请求,应用会嵌入查询文本,向 Lakebase Postgrse 发送一条 SQL 语句,并返回结果。为找出限制,测试每次只改变一侧。它将 Lakebase Postgres 固定在一个 CU 规格并改变应用,或者保持应用不变并改变 CU 规格。一个负载生成器模拟发送搜索请求的用户,并分步增加用户数。该列表显示了每种 Lakebase Postgres 规格和应用规格在 500 用户时的每秒请求数和延迟中位数(p50)。
- 1 CU,MEDIUM 应用,2 个工作进程:196 请求/秒,p50 1.8 秒
- 0.5 到 1 CU,LARGE 应用,4 个工作进程:193 请求/秒,p50 1.6 秒
- 2 CU,MEDIUM 应用,2 个工作进程:201 请求/秒,p50 1.8 秒
- 4 CU,MEDIUM 应用,2 个工作进程:219 请求/秒,p50 1.6 秒
- 8 CU,MEDIUM 应用,2 个工作进程:336 请求/秒,p50 1.0 秒
- 16 CU,MEDIUM 应用,2 个工作进程:349 请求/秒,p50 1.0 秒
- 16 CU,LARGE 应用,4 个工作进程:至少 662 请求/秒,p50 343 毫秒
最高到 4 CU 时,Lakebase 是限制。一个拥有两倍工作进程和连接的 LARGE 应用在 1 CU 时没有任何提升。在 1 CU 时,搜索语句平均耗时 146 毫秒,从存储读取了 1490 万页,文件缓存为 1.5 GB。在 8 CU 时,平均耗时 34 毫秒,缓存为 12 GB,吞吐量提升了约 50%。
从 8 CU 起,应用是限制。16 CU 配同样的 MEDIUM 应用仅提升 4%,其数据库连接大多处于空闲状态。4 个工作进程的 LARGE 应用在 16 CU 时达到至少 662 请求/秒,而那里负载生成器成了限制。先为查询定规格。然后扩展 Lakebase Postgres,直到应用工作进程成为限制,然后再扩展应用。
要点:扩容前先找到极限。低于 8 CU 时,增加 Lakebase Postgres 的 CU。从 8 CU 起,为应用增加更多工作进程。
连接池仍然必要。在 50 个用户时,没有连接池时应用达到 45 req/s 和 2.4 秒 p95,有连接池时为 85 req/s 和 0.7 秒 p95。嵌入缓存在负载下没有带来可测量的差异。
候选池与冷启动
候选数上限设定了查询会触及的页面数量。在冷缓存下,这个数字决定了延迟。Slide Hub 上线时每种方法使用 1,000 个候选。文档中的模式使用 40 个。候选数上限实验只改变了 candidate_limit,并在三种状态下测量了 20 个公开查询。冷是计算缩放到零后的第一次查询,缓存为空。首次触及是查询在已唤醒的计算上的第一次运行。重复是同一查询再次运行,其页面已在缓存中。触及页面数统计查询从任何来源读取的页面数。Top-10 重叠率是与 1,000 个候选时的结果相比,前 10 个结果中相匹配的比例。
- 40 个候选:冷 127 毫秒,首次触及 13 毫秒,重复 5.0 毫秒。触及 5,655 个页面。Top-10 重叠率 74.5%。
- 100 个候选:冷 240 毫秒,首次触及 16 毫秒,重复 7.9 毫秒。触及 7,355 个页面。Top-10 重叠率 89%。
- 200 个候选:冷 387 毫秒,首次触及 24 毫秒,重复 11.7 毫秒。触及 10,401 个页面。Top-10 重叠率 90.5%。
- 1,000 个候选:冷 740 毫秒,首次触及 109 毫秒,重复 35.3 毫秒。触及 28,972 个页面。Top-10 重叠率 100%(参照基准)。
在 200 个候选时,前 10 个结果中有 90.5% 保持不变,报告的匹配数量是 1,000 个候选时的 81%。用户很少翻过 200 条结果之后,因此 Slide Hub 现在使用 200 个候选。在与应用同一云区域的任务中端到端测量,200 个候选时的冷搜索耗时 2.9 秒,重复搜索耗时 40 毫秒。冷启动时间有两部分。连接在端点唤醒期间等待约 1 秒。然后每个查询从存储读取其页面,直到缓存变热。新连接上的第一次查询还要额外付出约 75 毫秒的规划时间。
要点:保持候选池小。200 个候选保留了前 10 结果的 90.5%,读取约 1,000 个候选三分之一的页面,并将冷延迟减半。
规模:MIRACL 英文 100 万到 400 万行
规模测试使用MIRACL 英文,这是一个由维基百科构建的段落语料库。完整语料库有 32,893,221 个段落。我们使用gte-large-en-v1.5对其进行了嵌入,这是一个 1024 维的开源模型,与 Slide Hub 嵌入的规模相同。我们在一张 A10G GPU 上自托管该模型,速度为每秒 379 个段落。整个语料库耗时 2.95 GPU 小时,而在模型服务端点上完成同样的工作需花费 48.87 美元。GPU 向量与端点向量一致(平均余弦相似度 1.0000,最小值 0.9978)。
我们构建了三个子集:100 万、200 万和 400 万个段落。lakebase_ann 索引随语料库增长:100 万时为 5.8 GB,200 万时为 11.5 GB,400 万时为 23.0 GB。一次二进制 COPY 在 8 CU 下用 19 分钟加载了全部 400 万行。
Lakebase Postgres 每 CU 约有 1.6 GB 的文件缓存。规模带来一个问题:当索引大于缓存时会发生什么?每个测试单元是一种语料库规模对应一种 CU 规模,因此缓存是索引的一个已知比例。我们称该比例为缓存比率:缓存大小除以向量索引大小。比率为 1.0 表示索引刚好能放下。命中率是查询读取的页面中不来自存储的比例。
我们对每个单元运行了三种查询组合。均匀组合每次都发送一个新标题,从不重复,这是缓存的最坏情况。偏斜组合从 20,000 个标题的池中按 Zipf 分布抽取,这是搜索流量的常见模型。冷组合在唤醒后立即运行首批查询,此时缓存为空。在均匀和偏斜测量之前,会运行一次预热,反复执行同一组合,直到命中率不再变化。我们将预热后的结果称为热。
命中率跟随缓存比率

命中率取决于缓存比率。语料库大小不会改变它:200 万和 400 万的点落在同一条曲线上。在比率为 0.07 时,偏斜组合有 45% 的页面命中缓存。在 0.57 时为 86%。在 1.14 时,索引刚好能放下,命中率为 97%。均匀组合低几个百分点,因为它不复用任何内容。
这给出了一条容量规划规则。测量你的索引大小,为你想要的缓存比率选择一个 CU 大小,然后从曲线上读出命中率。该比率在不同语料库规模下都适用,因此 200 万时的测试可以预测 400 万时的行为。
要点:根据向量索引而非行数来确定缓存大小。缓存与索引差不多大时,95% 到 98% 的页面无需访问存储即可得到服务。
延迟跟随命中率
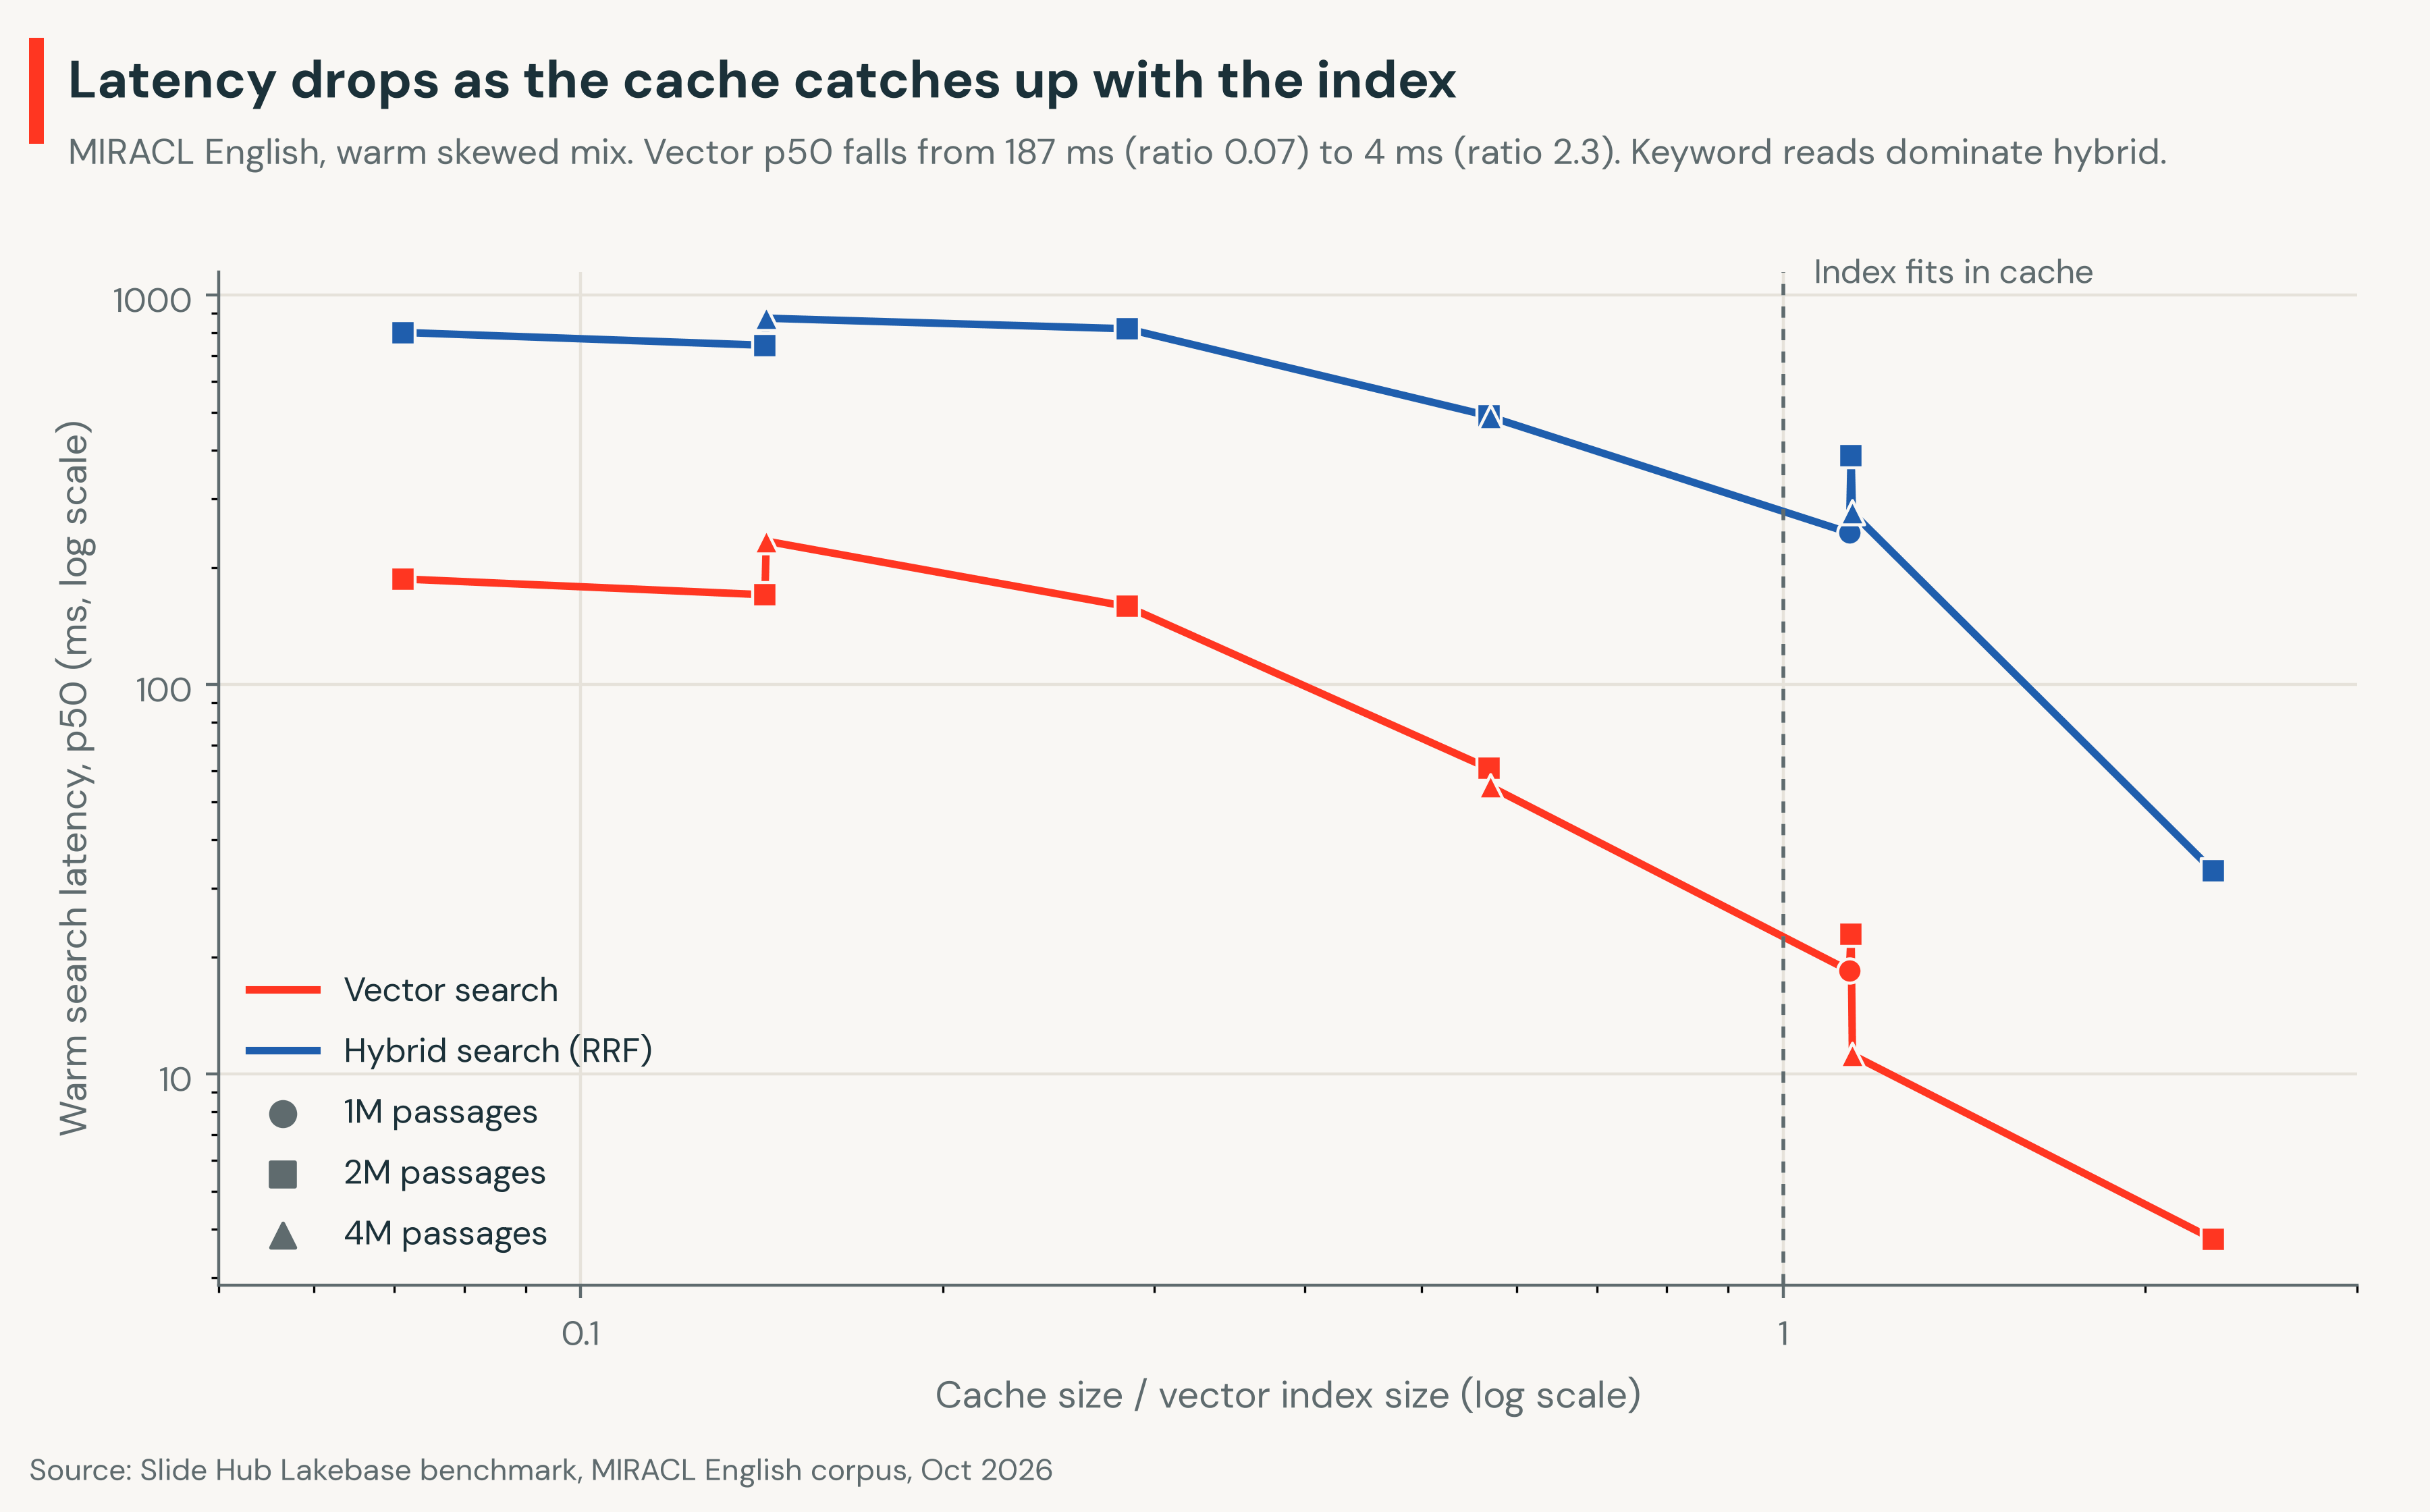
热向量 p50 从比率为 0.07 时的 187 毫秒降至比率为 2.3 时的 4 毫秒。混合搜索在比率接近 1 之前一直保持在 800 毫秒附近,然后降至 33 毫秒。混合查询的关键词部分读取的页面最多,因此从完整缓存中获益最大。
要点:当缓存容纳的索引不足三分之一时,向量搜索耗时 160 到 230 毫秒,一旦整个索引都能放下则为 11 到 23 毫秒。

一次未命中是一个不在本地文件缓存中的 8 KB Postgres 页面。在向量索引中,一个页面存放一或两个嵌入。从存储读取一个页面耗费固定时间。在所有测量的查询中,向量搜索的执行时间每未命中一页约增加 252 微秒,混合搜索为 316 微秒。一个未命中 2,000 页的查询约多付半秒。完整缓存几乎消除了所有未命中。这就是缓存比率决定延迟的原因:它决定了每个查询从存储读取多少页面。
要点:每个来自存储的页面约增加 0.3 毫秒。将每个查询的存储未命中数乘以 0.3 毫秒,即可估算缓存为你节省的时间。
从缓存命中时,延迟几乎不随语料库增长

保持缓存比率接近 1.0,并改变语料库大小。从 1M 到 4M,热向量延迟保持在 11 到 23 毫秒之间。热混合延迟保持在约 276 毫秒。冷查询从存储读取,随着语料库增长而增长:冷向量查询在 1M 时为 44 毫秒,到 4M 时增至 133 毫秒,冷混合查询在 4M 时达到 911 毫秒。
这就是“你不需要把整个索引放在内存里”的诚实形式:你不需要,因为该架构让计算内存保持平稳。RaBitQ 每维度存储约 1 位,比 float32 小 32 倍,而 IVF 每次查询只读取少数几个分区。索引由存储支持,因此计算可以很小,也可以缩容到零。未命中缓存的查询要为未命中付出代价,而缓存比率控制这种情况发生的频率。
要点: 让计算随语料库增长,热延迟就保持平稳。只有未命中缓存的查询会随着语料库增长而变慢。
吞吐量随计算扩展
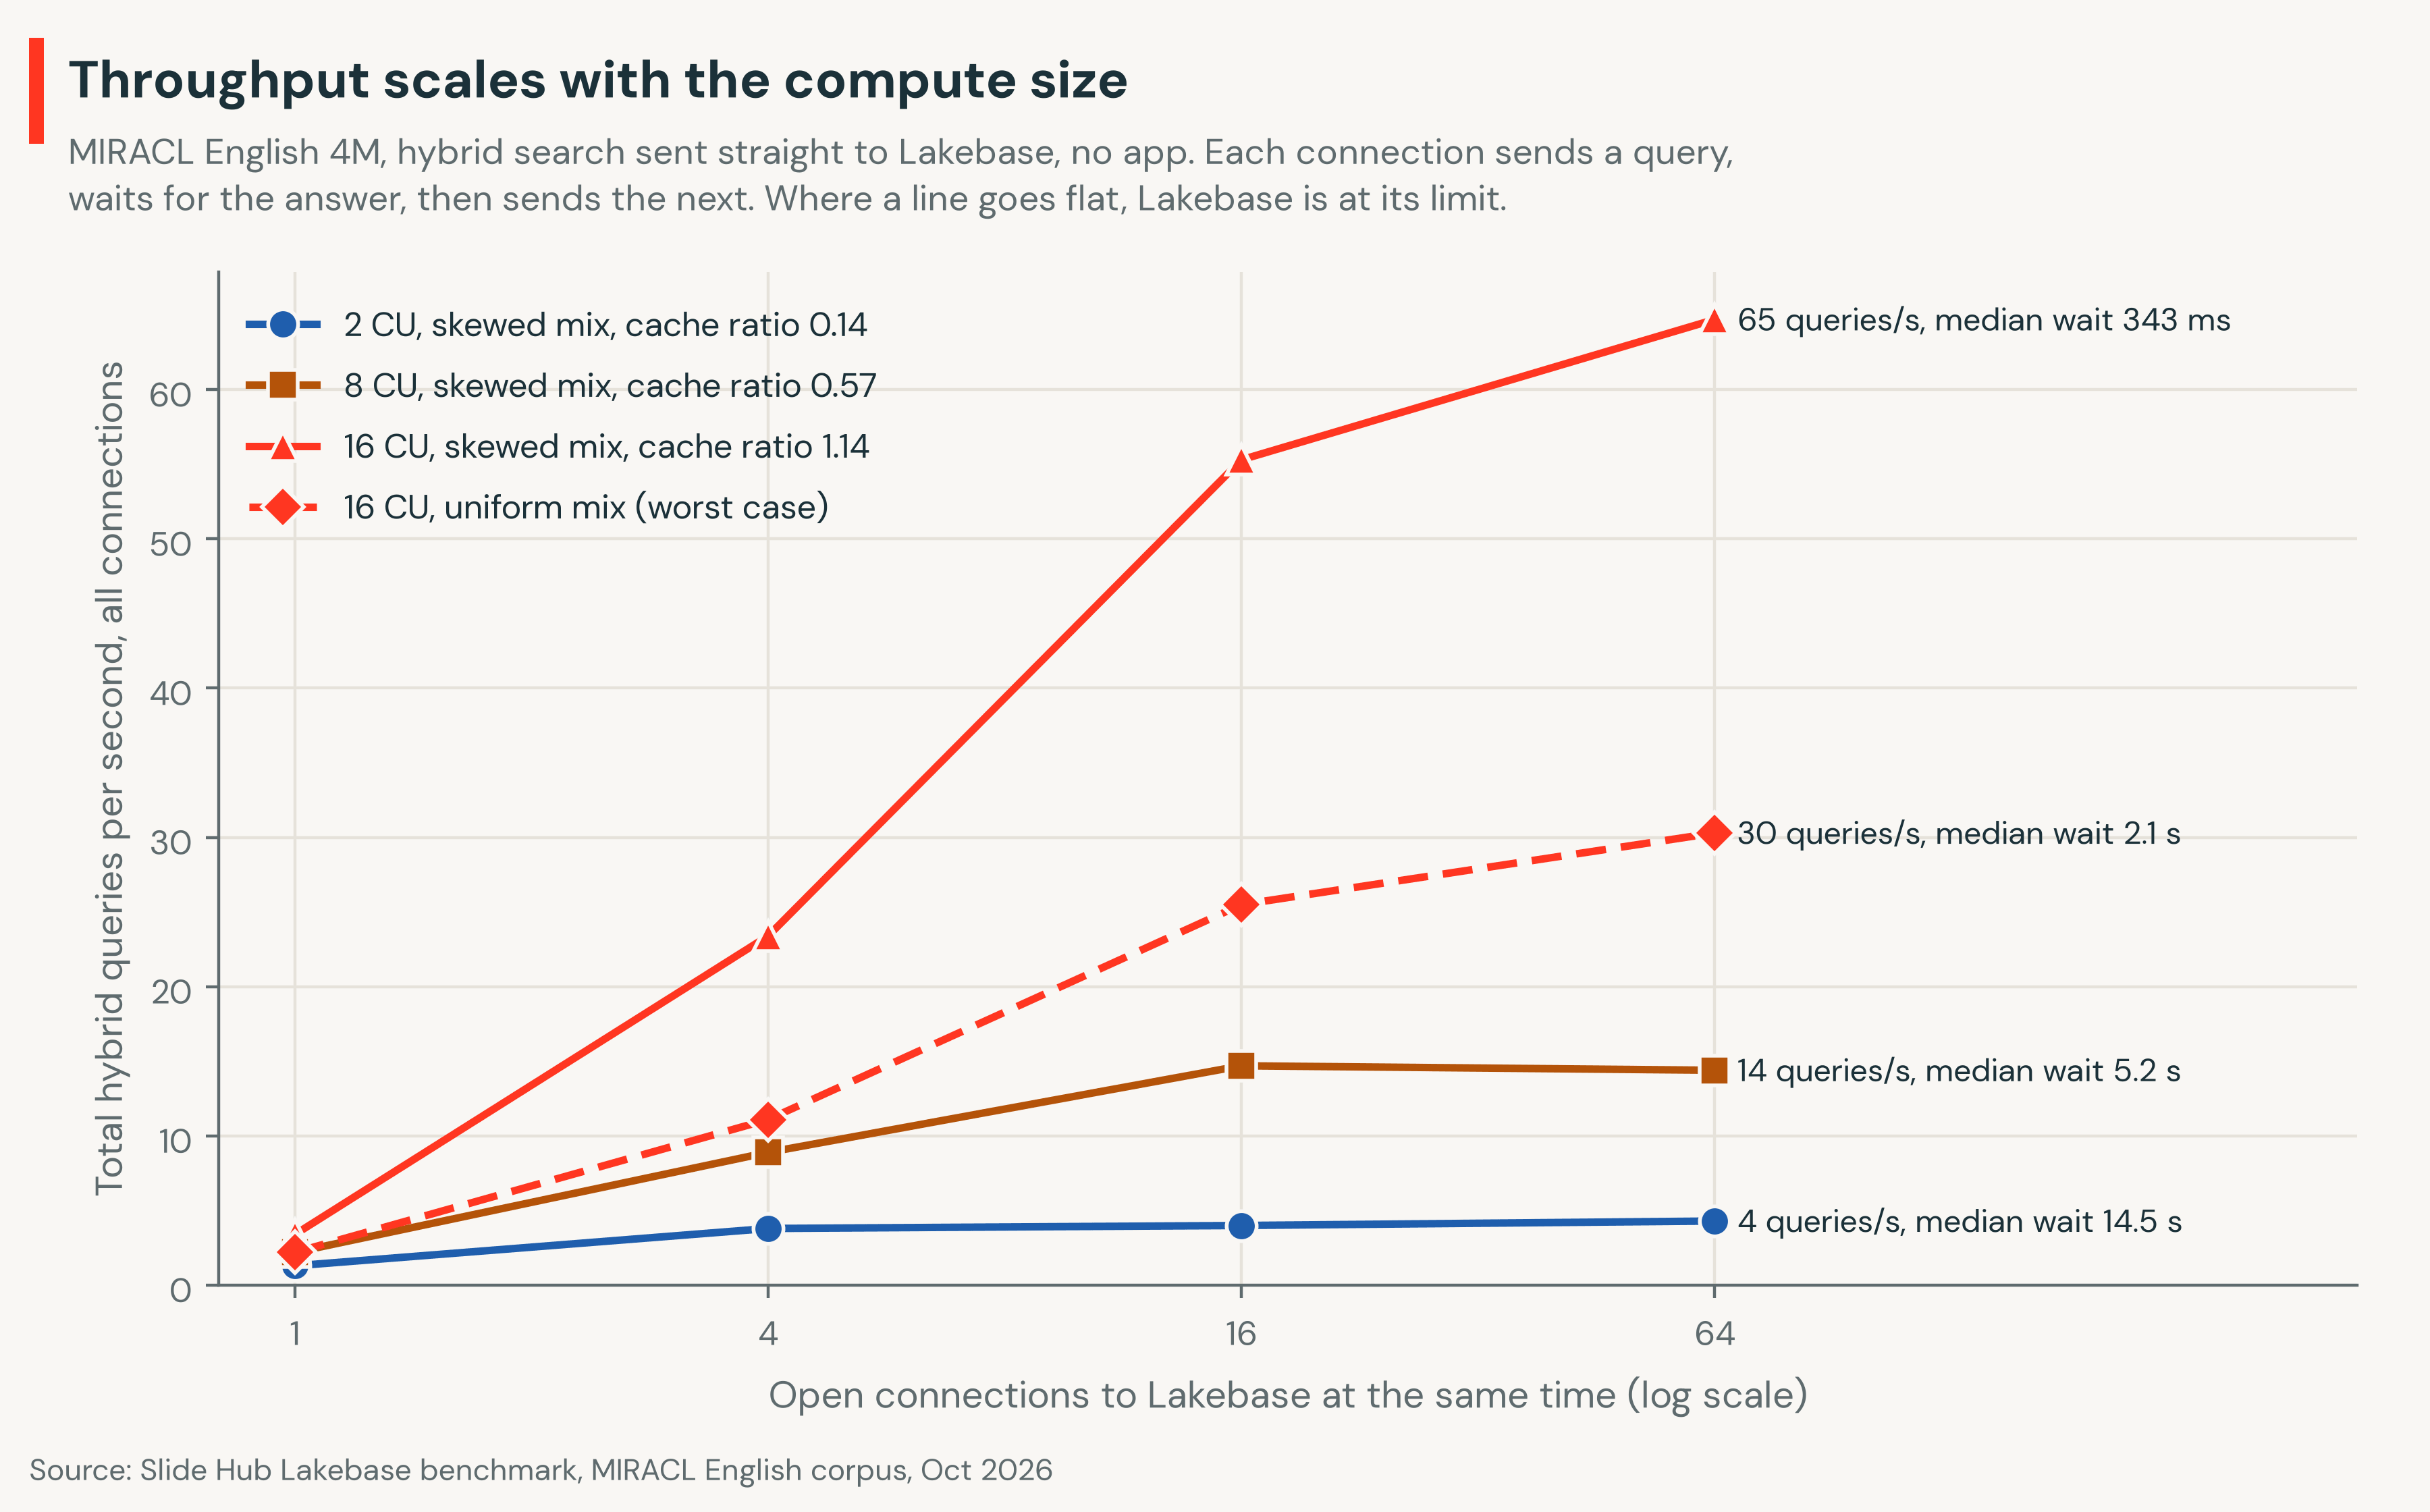
吞吐量测试将混合查询直接发送到 Lakebase Postgres,不经过应用,因此它只测量数据库。它同时向 Lakebase Postgres 打开 1、4、16 或 64 个连接。每个连接发送一个查询,等待答案,然后发送下一个。图表显示所有连接的总查询每秒数。当一条线变平时,更多连接无法完成更多查询。此时 Lakebase Postgres 达到其极限,每个查询反而等待更久。负载生成器自身的 CPU 保持在接近零的水平,因此每个数字都由 Lakebase Postgres 决定。
在 4M 语料库上,偏斜混合在 2 CU 时达到约每秒 4 个查询,在 8 CU 时为 15 个,在 16 CU 时为 65 个。在 64 个连接时,单个查询的中位等待时间在 2 CU 时为 14.5 秒,在 8 CU 时为 5.2 秒,在 16 CU 时为 343 毫秒。均匀混合在 16 CU 时峰值为每秒 30 个查询,因为它从不重用页面。吞吐量随计算规模和缓存比率共同扩展。
把这些理解为负载下缓存未命中的成本。真实应用中的大多数查询会重复或聚集,因此稳态容量由热命中率而非均匀混合决定。
要点: 更多 CU 通过更多 CPU 和更大缓存带来双倍的吞吐量提升。从 8 CU 增加到 16 CU 将偏斜吞吐量从每秒 15 个查询提高到 65 个。
针对精确搜索的召回率
lakebase_ann 索引是近似索引。 Recall@10 是索引也返回的、来自对所有向量进行精确搜索得到的真实前 10 个最近段落的占比。该索引将向量分成多个分区(IVF),lakebase_ann.probes 设置查询读取多少个分区。在默认探测数下,Recall@10 几乎不随语料库大小变化:1M 时为 0.74,2M 时为 0.75,4M 时为 0.75。更多探测以延迟换取召回率。

在 4M 下使用默认索引时,默认的 109 次探测在 3 毫秒内给出 0.74 的 recall@10,2,000 次探测在 49 毫秒内给出 0.95。使用 build_mode = 'quality' 构建的索引在每个探测数下都提高了召回率:默认探测数下为 0.80,耗时 3 毫秒;2,000 次探测时为 0.97,耗时与默认构建大致相同。其构建在 16 CU 下耗时 52 分钟。将 lakebase_ann.epsilon 提高到 4(在我们的测试中它接受的最高值),提升不到 0.3 个点。[9] 召回率取决于数据和嵌入模型,因此要在你自己的数据上测量它,并选择你的应用所需的探测数。Lakebase Search 支持单个索引超过 10 亿个向量。[1]
要点: 使用 build_mode = 'quality' 构建向量索引。在默认探测数下,它在约 3 毫秒内将 recall@10 从 0.74 提高到 0.80;在 500 次探测时,它在 13 毫秒内达到 0.91,而在默认构建上需要 1,000 次探测和 20 毫秒。代价是构建时间:在 16 CU 下为 4M 段落耗时 52 分钟。仅当你的应用需要更高召回率时才提高探测数。
成本
Lakebase 成本随使用而定。挂起的计算不产生计算成本,存储单独计费。Lakebase 约占 Slide Hub 30 天账单的 1%。Slide Hub 是一个内部应用,其用户可以接受空闲 5 分钟后的首次搜索较慢,因此其生产数据库在无人搜索时缩容到零。
规模评估很便宜。对整个语料库进行自托管嵌入花费了 2.95 GPU 小时,而模型服务端点为 48.87 美元。一次区域内负载爬坡运行了 14 分钟,按标价花费 0.13 美元:应用 0.11 美元,Lakebase Postgres 0.02 美元,后者在 0.5 到 1 CU 之间自动扩缩,并使用了 0.21 CU 小时。在最多 1,000 个用户时,该爬坡无错误地服务了 109,602 个请求。这些单元在 0.5 到 16 CU 下运行,并在两次运行之间挂起。在我们工作区的计费表中,1 CU 小时为 0.213 DBU:在 AWS 美国东部的 Premium 标价约合 0.085 美元,Enterprise 标价约合 0.11 美元。
要点: Lakebase Postgres 仅在运行时对计算计费。14 分钟的负载测试使用了 0.02 美元的 Lakebase Postgres 计算费用,而该计算成本约占 Slide Hub 30 天账单的 1%。对于生产环境,将最小值设为 0.5 CU,而不是缩容到零。按标价,这每月花费约 31 到 40 美元,并且搜索不再需要等待约 1 秒让计算唤醒,也不会从空缓存开始。[11] 让开发分支和测试分支缩容到零。
关于数据的说明
MIRACL English 是开放的。语料库采用 Apache-2.0 许可,其段落来自 CC BY-SA 下的 Wikipedia。嵌入模型 gte-large-en-v1.5 采用 Apache-2.0。本文仅报告聚合指标。相同的测试可在任何 1024 维模型上运行:替换嵌入步骤,保留表、索引和搜索。
结论
把 Lakebase Postgres 想象成一位坐在大书架前书桌旁的读者。
- 书架是存储,书桌是缓存。 书桌上的页面读起来很快。书架上的页面需要走一趟,每页约 0.3 毫秒。
- 让书桌和你使用的书籍一样大。 当缓存与向量索引差不多大时,几乎每一页都在书桌上,向量搜索只需毫秒级。
- 更多 CU 意味着更大的书桌和更多帮手。这使每次搜索更快,并让 Lakebase Postgres 能同时响应更多搜索。
- 请求更少的书籍。一次取 200 个候选而非 1,000 个的搜索大约只承载三分之一的页面量,并保留前 10 个结果中的 9 个。
- 把书架整理好,然后选择要搜索多少。以质量模式构建的索引在默认 probes 下于 3 毫秒内返回真实最近的 10 个段落中的 8 个,而在 2,000 个 probes 下约 50 毫秒内返回 100 个中的 97 个。
- 应用有自己的书桌。一旦 Lakebase Postgres 变快,应用的 worker 就成为瓶颈。此时就给应用更多 worker。那时增加更多 Lakebase Postgres CU 也无济于事。
- 你不需要把整个图书馆都放在书桌上。Lakebase Postgres 从存储中读取其余部分。它更慢,但能工作,而缓存命中率告诉你这发生的频率。
- 只有在有人阅读时你才为书桌付费。当无人搜索时,Lakebase Postgres 可以挂起并仅对存储计费;在 Slide Hub 中这约为 30 天账单的 1%。在生产环境中,保留一张小书桌常开:0.5 CU 每月约花费 31 到 40 美元,并避免冷启动。
Databricks 有三种搜索,每一种都对应不同的工作。选择与你数据相邻的那一种。
- Lakebase Search运行在应用自身的 Postgres 数据库内。当搜索必须与应用自身的表放在一起,并且要立即看到每一次写入时,就使用它。
- AI Search,前身为 Vector Search,是面向 Unity Catalog 中 Lakehouse 表的托管搜索服务。它使索引与 Delta 或 Iceberg 表保持同步,并可为你创建嵌入。将它用于基于 Lakehouse 数据的 RAG、智能体和推荐。
- 全文搜索索引(Beta)可加速对托管 Delta 和 Iceberg 表的 SQL 查询。search 和 isearch 函数使用索引跳过不可能包含匹配项的文件,因此日志和关键词查找读取的数据更少。它们过滤行,但不为搜索栏对结果排序。
Slide Hub 将所有这些都运行在一个 Lakebase Postgres 数据库中:应用数据、向量索引和关键词索引。先从 Lakebase Search 文档开始,然后对你的自己的数据运行同样的测试。
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏