托管 Postgres:Lakebase 实际替你分担了什么
DataHot 速览
文章讨论 Lakebase 所代表的托管 Postgres 在 AI 应用中的价值,核心是 Postgres 能否在同一系统中承载事务状态与向量检索。它介绍了 pgvector、向量/语义搜索、LLM 记忆和 Agent 工作负载,说明嵌入可与业务数据同库存储,减少同步与运维问题。文章也指出,超大规模专用向量检索仍可能需要独立向量数据库,索引策略需按数据规模和查询模式评估。
为什么值得关注:数据从业者可关注托管 Postgres 如何把向量检索、LLM 记忆和 Agent 状态统一到数据库层,以及何时仍应选择专用向量库。
本文目录 15 节
译文
AI 逐段翻译Postgres 适合 AI 应用吗?
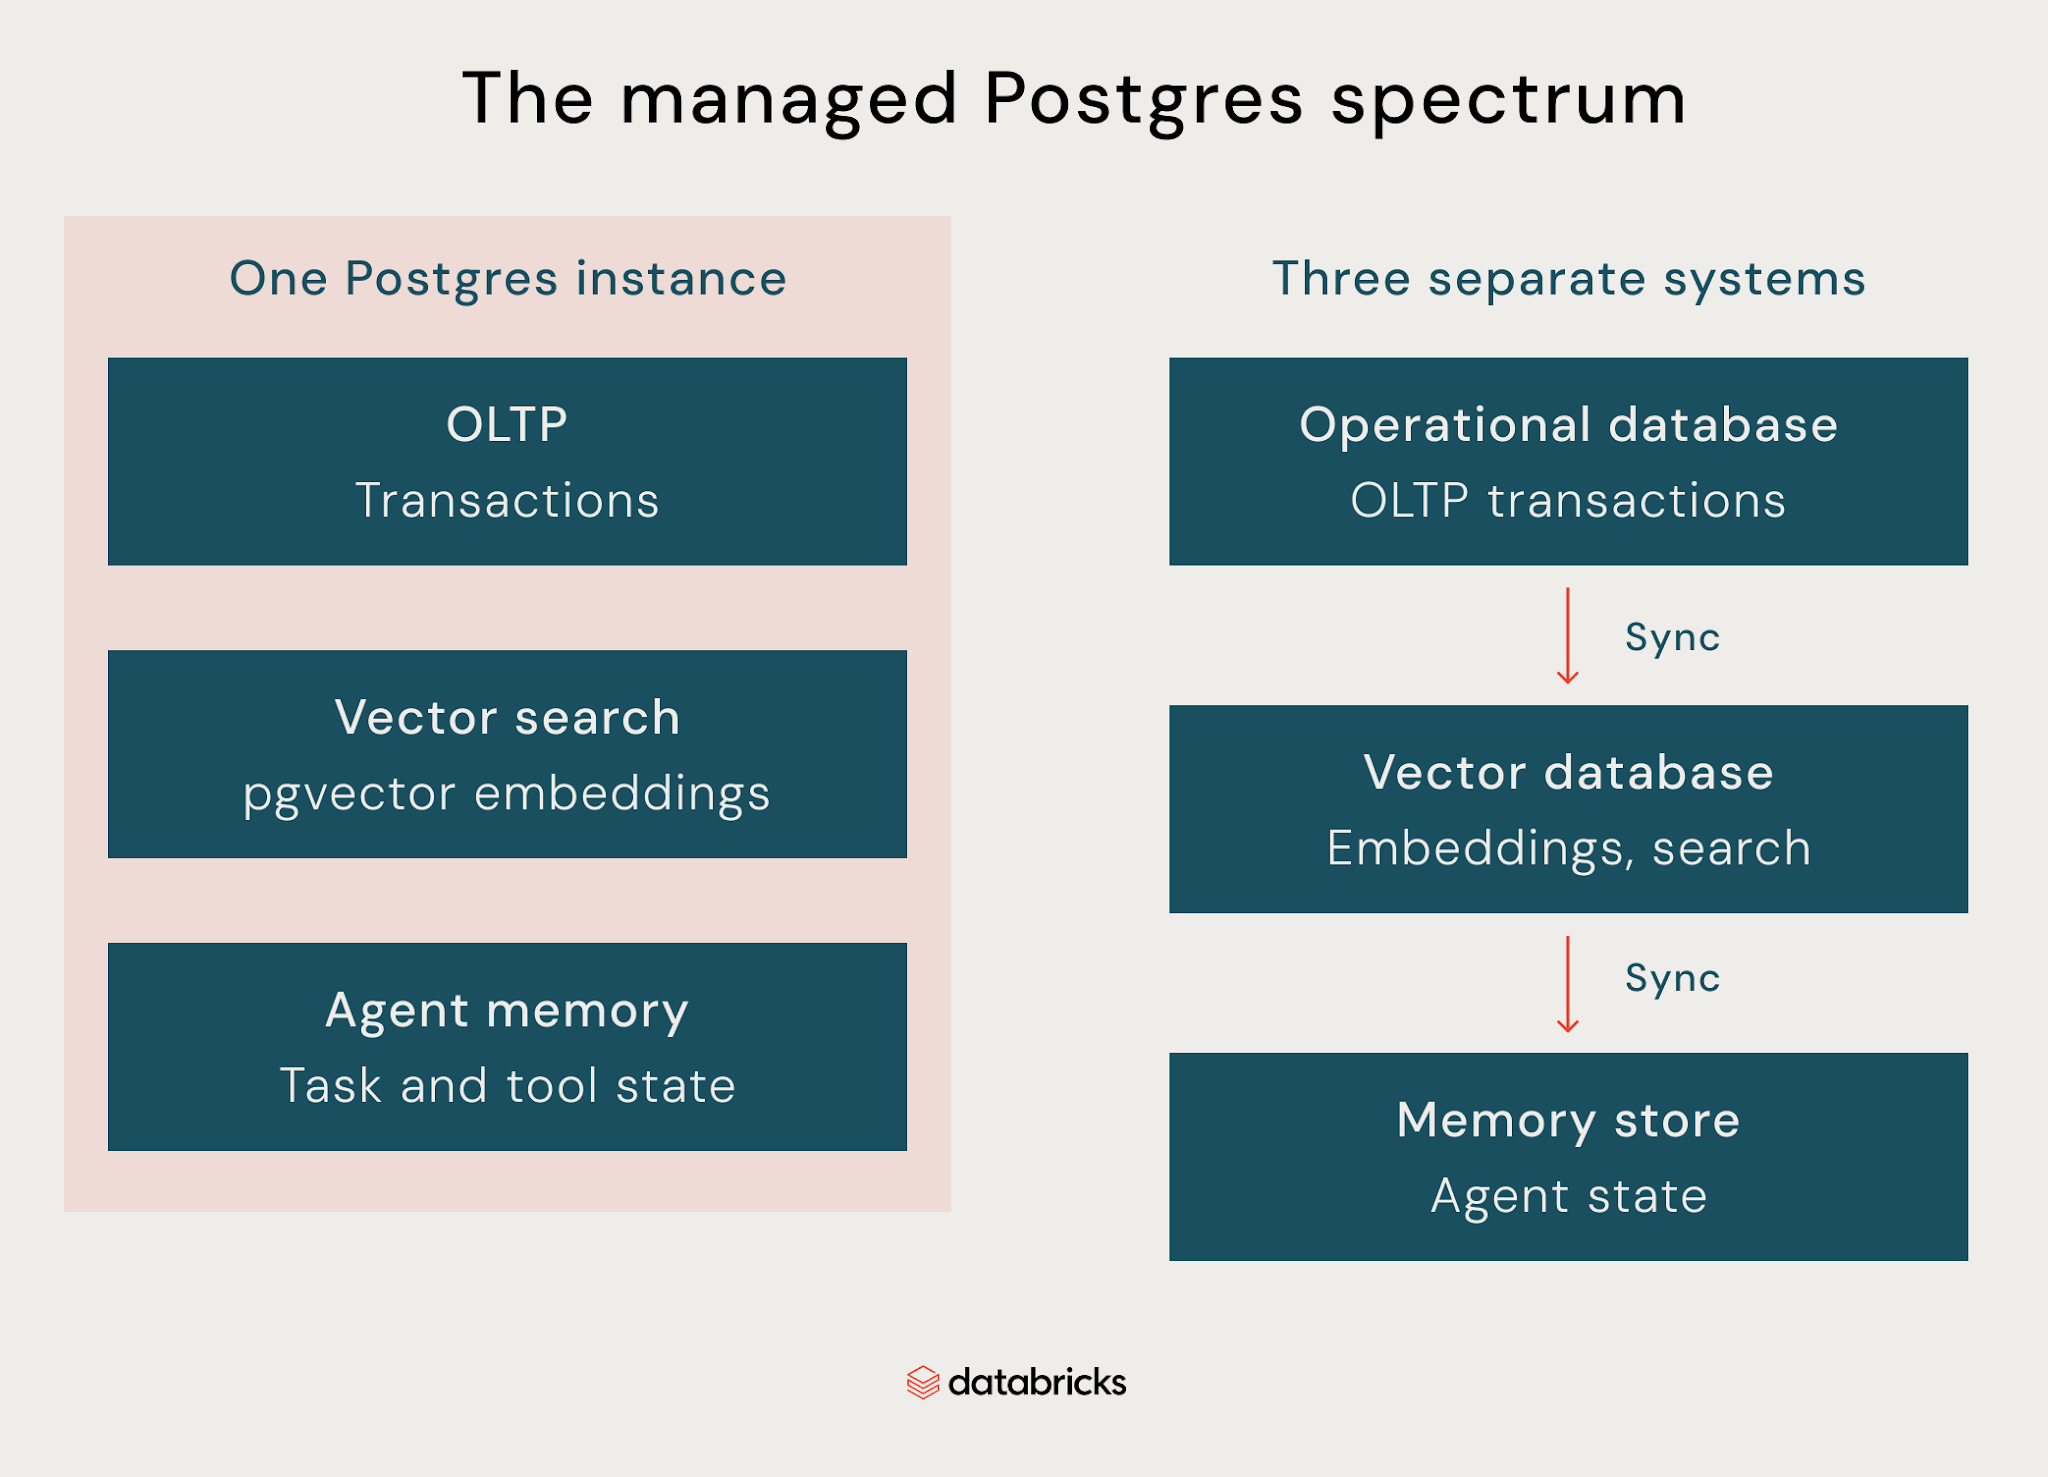
当应用需要在同一系统中同时具备事务性状态和向量搜索时,Postgres 可以非常契合 AI 应用。这归结为四点:pgvector 作为使之成为可能的扩展、用于检索的向量搜索、用于在请求之间持久化状态的大语言模型(LLM)记忆,以及同时需要这两者的智能体工作负载。
pgvector
pgvector直接在 Postgres 内部添加了向量数据类型和相似度搜索索引,因此嵌入向量与你的其余应用数据存放在一起,而不是放在它们自己的系统中。其代价在于,单独的向量数据库意味着保持嵌入向量和业务数据同步本身就成了一个工程问题,而对于不需要专用向量存储的工作负载,pgvector 消除了这一问题。
向量搜索和语义搜索
pgvector 让你可以存储嵌入向量,并使用近似最近邻(ANN)索引,随着数据集增长高效地查找相似向量,这正是使语义搜索、检索增强生成和基于含义的匹配能够在 Postgres 内部实现的原因。正确的索引策略仍然取决于数据集大小和查询模式,因此 pgvector 并没有消除针对你特定工作负载评估性能的需要。
LLM 记忆
LLM 应用需要某个地方来在请求之间保存状态,包括对话历史、用户偏好、检索到的文档和工具结果。Postgres 可以将该状态存储为普通的关系数据,同时由 pgvector 在同一数据库中处理嵌入向量。对于需要在极大规模下进行专门向量检索的工作负载,专用向量数据库可能仍有意义,但许多 AI 应用可以将业务状态和检索放在一起。
智能体工作负载
智能体在运行时会持续读取和更新状态。它们跟踪对话、存储中间结果并记录工具调用,这使得数据库成为智能体执行层的一部分,而不仅仅是检索上下文的地方。一个为 AI 智能体工作负载构建的数据库需要在一个系统中同时支持这种不断变化的事务性状态以及智能体用来查找相关上下文的检索。
用于应用开发的 Postgres
除了运行生产工作负载之外,Postgres 还需要支持你的团队实际构建的方式。这意味着连接不会随着你扩展而成为瓶颈,并且测试 schema 变更并不意味着拿生产数据冒险。
连接管理
Postgres 对其一次可以保持的连接数量有有限制的上限,而水平扩展的应用实例可能会在计算或存储成为瓶颈之前就触及该上限。连接池在请求之间复用已建立的数据库连接,而不是为每个请求打开新连接。在托管服务中,重要的是连接池是内置的,还是你的团队必须单独运维的。
数据库分支
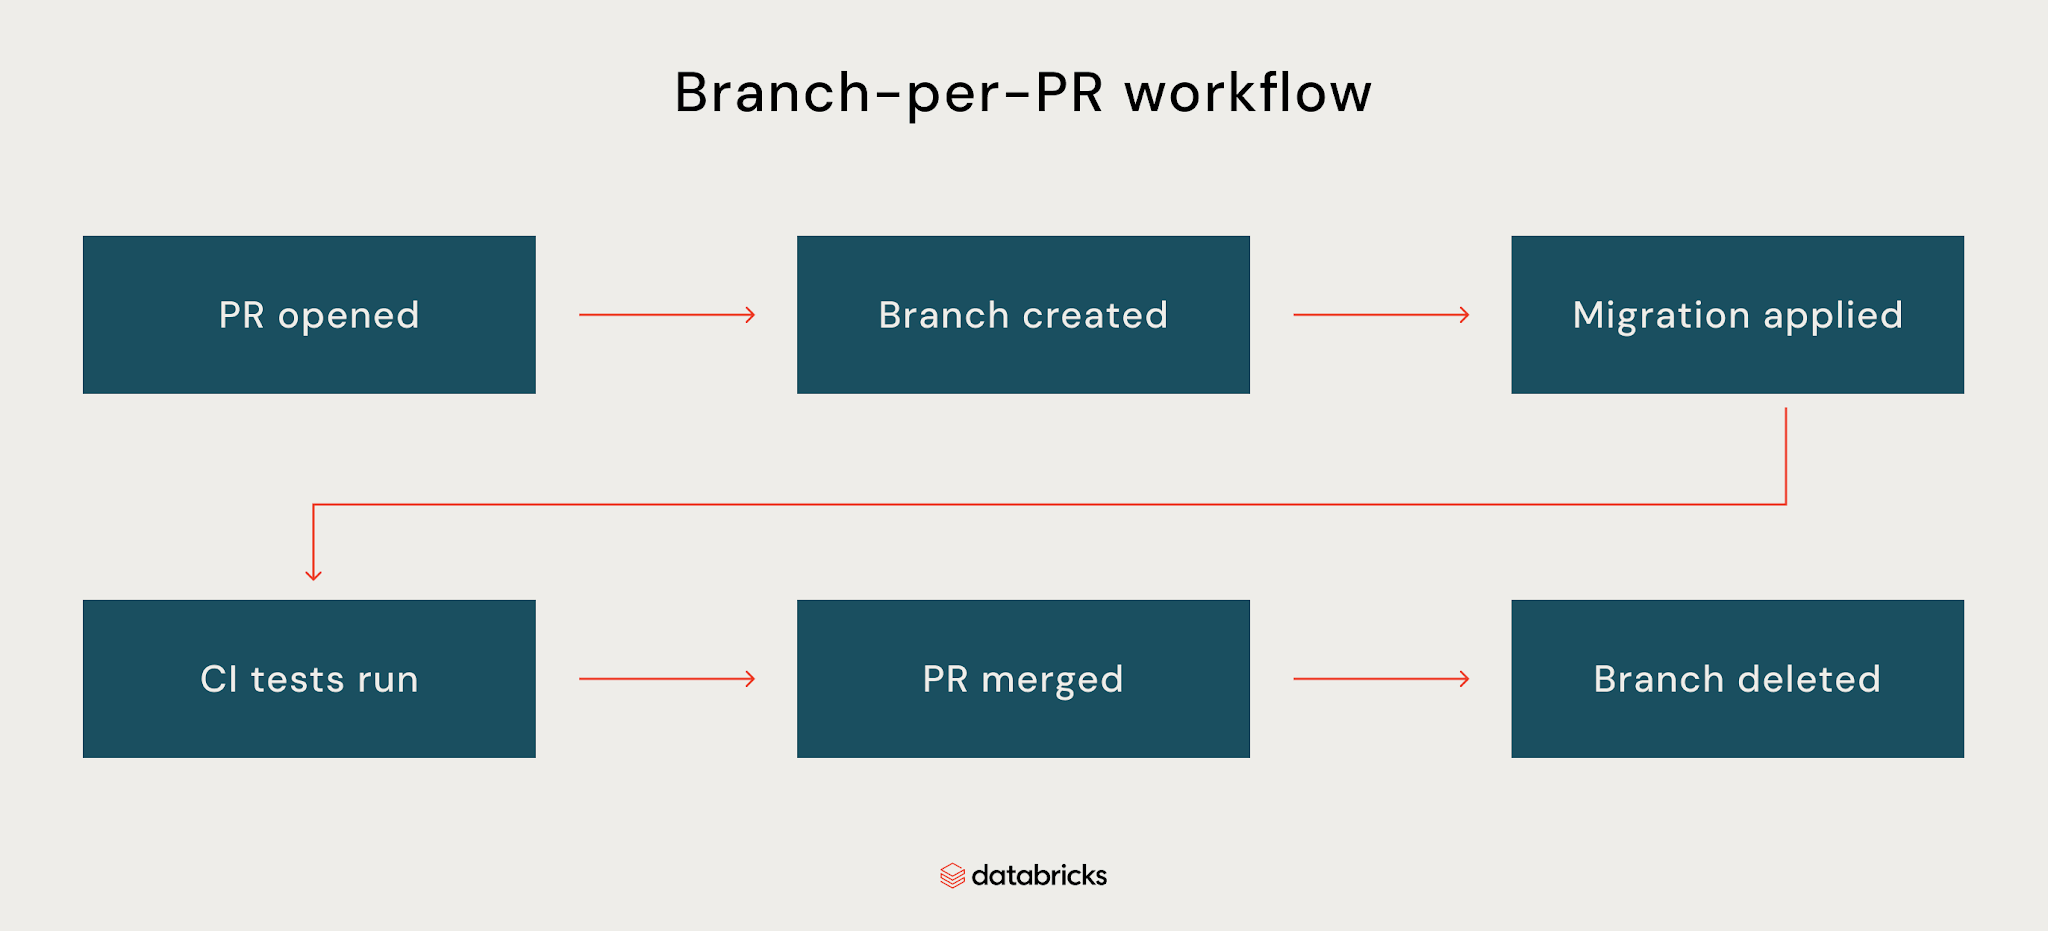
针对生产数据测试 schema 变更意味着拿生产环境冒险,或者维护一个随着时间推移会脱离同步的预发布数据库。数据库分支从现有数据库状态或时间点快照创建隔离环境,因此开发者可以针对真实数据测试迁移,像演进式数据库开发那样工作,并在不再需要时删除该分支。
为什么在托管 Postgres 上选择 Lakebase
Lakebase 的方法,当你将其与托管 Postgres 应处理的核心任务对照时,会变得更加清晰:
- 无服务器:Lakebase 在随需求自动扩展(包括空闲时缩减至零)的无服务器计算上运行 PostgreSQL,因此无需预先为实例设定规格,也无需为未使用的容量付费。Databricks 报告称,在其测试中,Lakebase 的 Postgres写入吞吐量最高提升 5 倍,尽管结果取决于工作负载和配置。
- PostgreSQL 兼容性:Lakebase 使用标准 PostgreSQL 连接,因此现有驱动程序、ORM 以及 psql、pgAdmin 和 DBeaver 等工具会以与连接任何其他 Postgres 实例相同的方式连接,应用和数据库之间没有专有协议阻隔。
- 可靠性:Lakebase 在独立的可用区运行辅助计算,并在主节点发生故障时自动将其提升,同时保持连接端点不变。数据库团队无需在事故期间手动提升副本或重新配置应用。
- 定价:计算随工作负载扩展,而不是永久预置的实例,并且一旦数据库暂停,计费就会停止。存储单独计费。
- Lakehouse 集成:Lakebase 连接到 Databricks 平台的其他部分,而不是作为一个孤立的 Postgres 服务运行。同步表使 Unity Catalog 数据可供 Postgres 应用使用,而无需自定义同步管道;Change Data Feed 目前处于公开预览阶段,可将数据库变更暴露给 lakehouse 中的下游处理。
团队不再需要处理什么
下表显示了 Lakebase 处理哪些数据库运维工作,以及哪些仍由数据库团队负责:
| 维度 | Lakebase 处理的内容 |
|---|---|
| 补丁 | 自动进行 PostgreSQL、安全、操作系统和计算更新 |
| 扩展 | 自动扩展,包括空闲时缩减至零 |
| 故障转移 | 区域内自动故障转移到辅助计算 |
| 备份和恢复 | 时间点恢复,可配置 2-30 天历史记录,外加计划快照以提供额外备份保护 |
| 灾难恢复 | 私有预览,仅 AWS。定期复制,需手动故障转移和客户管理的恢复流程。 |
| 加密 | 静态和传输中加密,可使用客户管理的密钥 |
| 访问控制 | PostgreSQL 角色和权限,并通过 Unity Catalog 集成实现更广泛的治理。 |
| 扩展 | pgvector、PostGIS 以及其他受支持的 PostgreSQL 扩展 |
| 连接池 | 内置 PgBouncer |
| 分支 | 写时复制,不重复存储 |
| Lakehouse 集成 | 同步表和 Change Data Feed |
| 定价 | 无服务器,随工作负载扩展,空闲时暂停。存储单独计费。 |
根据上表,补丁、扩缩容、故障转移和备份均自动运行。灾难恢复是例外:仍为 Private Preview,仅限 AWS,采用手动故障转移,背后由客户管理的恢复流程支撑。在指望 Lakebase 承担任何跨区域任务之前,这个细节值得核实。进一步了解 Databricks Lakebase。
总结
“托管”的含义因卖方而异,从给操作系统打补丁就宣称完成,到承担运行生产数据库的全部重担:扩缩容、故障转移、备份、安全、迁移、AI 工作负载,以及围绕这一切的开发者体验。
Lakebase 在大部分方面都达到了这一标准。补丁、扩缩容和故障转移无需你的团队介入即可运行;时间点恢复是内置的,安全、扩展、连接池和分支功能都随服务提供。跨区域灾难恢复是唯一的例外,仍处于 Private Preview,采用手动故障转移,与 Lakebase 在区域内提供的自动保护并不相同。
对于评估托管 Postgres 的团队来说,重要的问题是:究竟有多少运维工作真正离开了他们的职责范围。Lakebase在区域内承担了大部分此类工作,而跨区域灾难恢复仍然是团队需要承担职责的领域。
常见问题解答
托管 Postgres 与自托管 Postgres 有什么区别?
自托管 Postgres 将所有运维任务都压在数据库团队身上:打补丁、扩缩容、故障转移、备份策略、灾难恢复。托管 Postgres 将其中部分或全部任务转移给提供商,但转移的程度差异很大。部分托管服务负责基础设施,其余留给客户。一些全托管服务还包括安全工具、迁移协助以及诸如数据库分支之类的开发者工作流。
什么是 Serverless Postgres?
Serverless Postgres 是一种托管数据库模型,其计算资源随需求自动扩缩容,无需预置固定实例规格。一些提供商在数据库空闲时将计算缩容至零,而另一些则保留基线容量。定价通常依据实际使用的计算资源,而非永久预置的实例。
Postgres 中的数据库分支如何工作?
数据库分支会创建一个隔离的、写时复制的数据库分支,而无需复制底层存储。每个分支可以拥有自己的计算资源和数据变更,而不影响生产环境。团队用它来针对真实数据测试模式迁移、为每个拉取请求创建一个分支,或从特定时间点恢复一个分支,然后在工作完成后将其删除。
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏