用Amazon Bedrock AgentCore构建自愈ETL管道
有效阅读仅保存在当前浏览器,用于「为你」推荐;暂停或清除记录。
DataHot 速览
AWS官方博客介绍如何用AWS Glue与Amazon Bedrock AgentCore搭建自愈ETL管道:管道检测到模式漂移、字段缺失、类型不匹配等坏记录后,借助存于S3 Vectors的预计算纠错策略和领域知识自动修复并写回数据湖,可选生成修复PR防止同类错误复发。系统在秒级应用已知纠错,并通过置信度阈值和人工通知兜底控制自主行为,文中给出架构、CDK部署步骤与前后记录对比测试。
为什么值得关注:展示了Data Agent在数据工程与数据质量闭环中的具体落地架构,含AgentCore、Knowledge Bases、置信度阈值等可复用设计,对做数据管道与数据治理的从业者有直接参考价值。
本文目录 17 节
译文
AI 逐段翻译提取、转换和加载(ETL)管道会静默失败。模式漂移、缺失字段和类型不匹配会破坏下游分析。典型的修复方式是手动操作:检测错误、分类排查、修补记录、更新代码、重新部署。随着数据量增长,这种检测-分类-修复-部署的循环无法扩展。基于 Amazon Bedrock AgentCore(一个可使用任意框架或模型大规模构建、连接和优化代理的平台)构建的自愈管道可以自我修复。
本文中的自愈管道会修复自身数据、持久化修正结果,并可以提出拉取请求以帮助防止相同错误再次发生(可选,需要存储库凭据)。
在本文中,你将构建一个自愈 ETL 管道,它使用 AWS Glue 和 Amazon Bedrock AgentCore。该管道使用领域知识自动纠正错误记录,并将它们写回数据湖。当你配置可选的存储库集成时,它还会生成包含建议修复的代码审查。其结果是一个数据质量的闭环,减少了对人工干预的需求。你将了解架构、使用 AWS 云开发工具包(AWS CDK)部署基础设施,并使用示例数据测试数据纠正工作流,包括记录的前后对比。
Amazon Bedrock Knowledge Bases 结合存储在 Amazon S3 Vectors(Amazon Simple Storage Service(Amazon S3)的一项功能)中的预计算纠正策略,可缩短创建和部署纠正措施的时间。手动工作流需要工程师诊断错误模式、编写修复程序,并通过发布周期进行部署。该系统在检测到错误后几秒内应用已知纠正。它还会向团队呈现新出现的模式及完整上下文,包括建议的代码修复。当记录未通过验证时,自动纠正可让它们继续流向使用方,而不是滞留在死信队列中等待人工分类排查。置信度阈值和人工通知回退机制提供了内置监督,用于治理这种自主代理行为。如需更多负责任的 AI 控制措施,请考虑 Amazon Bedrock Guardrails、grounding 和内容过滤。
问题:大规模数据质量
设想一个假设的天气数据系统,它摄取美国国家海洋和大气管理局(NOAA)跨 15 种模式类型的记录:温度、降水、风、气压、湿度、能见度、云量、太阳辐射等。在这样的系统中,传感器故障、模式漂移和生产者缺陷可能导致相当比例的记录无法通过验证。
如今,这意味着:
- 工程师在坏数据到达数小时后才会收到寻呼通知。
- 有人手动检查错误、确定修复方法并修补记录。
- 开发人员追溯根因到上游代码并提交修复。
- 管道被重新部署,直到同一错误的下一变体出现。
每个步骤都需要一个人、一个工具和一次上下文切换。自愈管道会捕获这些纠正知识,并在下次出现类似错误时自动应用。
先决条件
要实现此模式,你需要:
- Amazon S3(包括 Amazon S3 Vectors)、AWS Glue、Amazon Bedrock。
- Amazon Elastic Container Registry(Amazon ECR)、AWS CodeBuild、AWS Lambda。
- Amazon Simple Notification Service(Amazon SNS)、AWS Secrets Manager、AWS Identity and Access Management(IAM)。
在目标 AWS 区域中为 Anthropic Claude(代理推理)和 Amazon Titan Embeddings V2(知识库索引)启用 Amazon Bedrock 模型访问权限。有关各区域的模型可用性,请参阅 Amazon Bedrock 中按 AWS 区域支持的模型(https://docs.aws.amazon.com/bedrock/latest/userguide/models-regions.html)。已安装 AWS CDK CLI(npm install -g aws-cdk@latest)以及 Python 3.10+。用于构建代理容器镜像的 Finch 或 Docker(CDK 通过 CodeBuild 构建 ARM64 镜像,但本地测试需要容器运行时)。熟悉 Amazon S3 数据湖模式,并基本理解多代理编排概念。示例实现使用 Strands Agents SDK进行代理开发,并使用 AWS CDK(Python)进行基础设施部署。在单个 AWS 区域内部署所有资源。
解决方案概述
此解决方案用多代理系统取代该手动循环,该系统自动化三件事:纠正数据、持久化修复以及修复代码。下图展示了完整架构:
图 1:自愈 ETL 管道的端到端架构
以下是数据在管道中的流动方式:
- 摄取 – 数据生产者将天气记录直接写入 Amazon S3 原始着陆桶,按模式类型组织在
raw/前缀下。记录保持未修改。 - 转换 – AWS Glue ETL 作业根据其声明的天气模式验证每条记录,并将有效记录写入转换区域。未通过验证的记录按错误类型(缺失字段、类型不匹配、模式违规、无效格式)分类,并路由到 AgentCore 系统。
- 编排代理协调顺序工作流:纠正、持久化、修复。
- 数据纠正代理查询领域知识以查找并应用高置信度修复。
- 数据持久化代理将纠正后的记录写回数据湖。
- 代码修复代理识别根因并提出拉取请求以帮助防止再次发生。
通知 – 当未找到高置信度纠正时,编排器通过 Amazon Simple Notification Service(Amazon SNS)发布通知以进行人工干预,而不是应用糟糕的修复。
验证和错误路由如何工作
AWS Glue ETL 作业充当质量关口。它通过一个调度器对每条记录进行验证,该调度器将 15 种 schema 类型中的每一种映射到专门的验证器。每个验证器都会检查必填字段、数据类型、枚举值和数值约束:
def validate_record(record: dict) -> dict:
    """Validate a single weather record against its declared schema_type."""
    schema_type = record.get("schema_type")
    if schema_type not in VALID_SCHEMA_TYPES:
        return {"valid": False, "error_type": "invalid_format",
                "error_details": f"Unknown schema_type: '{schema_type}'"}

    data = record.get("data")
    validator = SCHEMA_VALIDATORS.get(schema_type)
    error_details = validator(data)

    if error_details:
        # Validators emit only three message shapes, so once missing-field and
        # type-mismatch are ruled out, the else is always a constraint/enum/range failure
        if "Missing required field" in error_details:
            error_type = "missing_field"
        elif "Type mismatch" in error_details:
            error_type = "type_mismatch"
        else:
            error_type = "schema_violation"
        return {"valid": False, "error_type": error_type,
                "error_details": error_details}

    return {"valid": True, "error_type": None, "error_details": None}
当记录验证失败时,该作业会将其打包为错误记录,保留原始负载、分类后的错误类型以及验证详情。随后它通过 InvokeAgentRuntime API 将错误路由到 AgentCore 编排器。这是交接点,流水线在此不再是被动的数据搬运者,而成为主动的自愈系统。
使用 Bedrock AgentCore 进行多智能体编排
编排器智能体协调整个修正工作流。它从 AWS Glue ETL 作业接收错误记录,并驱动一条依次经过各专门智能体的路径;当其无法以至少 70% 的置信度完成修正时,会优雅降级为人工通知。如果某个步骤失败,它会停止,而不是将错误数据继续向下游传播。下图展示了该流程,以及每个智能体如何连接其知识来源和输出:
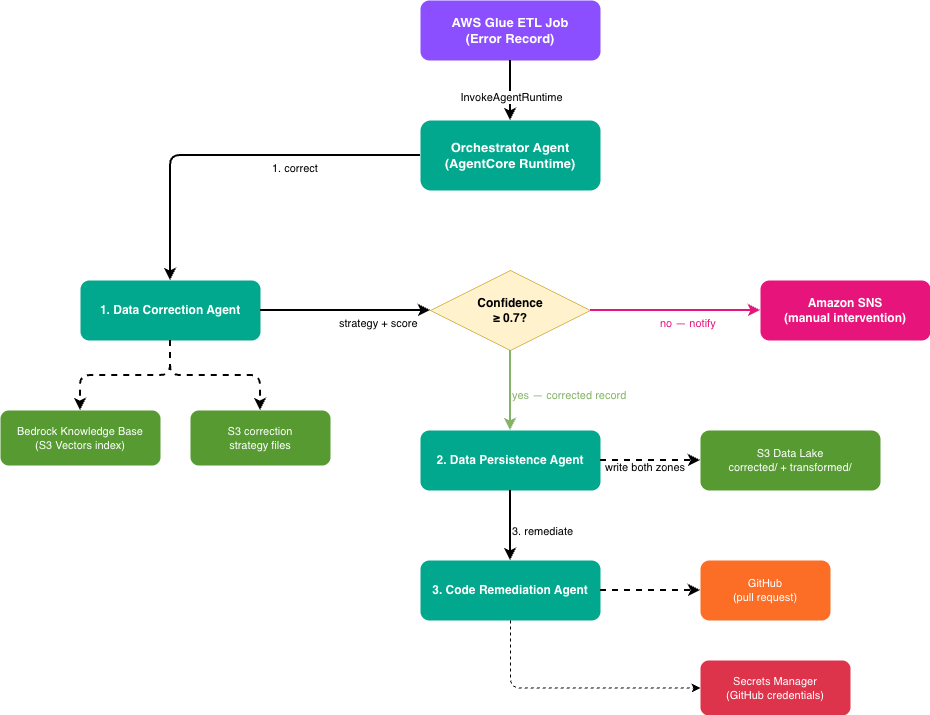
图 2:Amazon Bedrock AgentCore 上的多智能体编排工作流
该图展示了编排器从 AWS Glue 接收错误记录并调用修正智能体,后者利用 Amazon Bedrock 知识库和 S3 修正文件。随后编排器检查该修正的置信度是否达到阈值:如果达到,编排器将记录路由到持久化智能体(写入两个数据湖区域)和修复智能体(发起仓库拉取请求)。如果未达到,编排器将记录发送到 Amazon SNS 进行人工审核。
每个智能体都是使用 Strands Agents SDK 构建的容器化应用,并作为 AgentCore 运行时(Amazon Bedrock AgentCore 的一项能力)部署。
编排器本身不包含修正逻辑。它将任务委托给专门智能体,并根据它们的响应做出路由决策。这种分离意味着你可以在不触碰编排逻辑的情况下更新修正策略。你也可以在不影响修正智能体的情况下替换不同的持久化后端。
双来源修正:广度与精度相结合
修正智能体的职责是以高置信度找到正确的修复方案。它使用两个互补的知识来源:
Amazon Bedrock Knowledge Bases。 该智能体将描述错误的自然语言查询发送到由 Amazon S3 Vectors 和 Amazon Titan Embeddings V2 提供支持的知识库。Amazon Bedrock Knowledge Bases 提供完全托管的检索增强生成(RAG)能力。在此场景中,知识库对已索引的领域文档(NOAA 数据指南、schema 定义、错误模式目录)提供语义搜索,并返回带有相关性分数的排序结果。
def _query_knowledge_base(error_record: dict) -> dict:
    """Query Amazon Bedrock KnowledgeBase for correction strategies."""
    query_text = (
        f"How to correct a {error_record.get('error_type')} error "
        f"in a {error_record.get('schema_type')} weather record? "
        f"Error details: {error_record.get('error_details')}"
    )
    response = bedrock_agent_runtime.retrieve(
        knowledgeBaseId=KNOWLEDGE_BASE_ID,
        retrievalQuery={"text": query_text},
        retrievalConfiguration={"vectorSearchConfiguration": {"numberOfResults": 3}},
    )

    results = response.get("retrievalResults", [])
    top_result = results[0]
    score = top_result.get("score", 0.0)
    content = top_result.get("content", {}).get("text", "")
    source = top_result.get("location", {}).get("s3Location", {}).get("uri", "unknown")
    return {"strategy": content, "score": score}
Amazon S3 Vectors。 与此同时,该智能体在 correction/{schema_type}/{error_type}.json 处直接查找预先计算好的修正策略。这些文件包含针对已知错误组合的具体修复说明及置信度分数:
{
  "correction_strategy": "For missing temperature fields, check if the complementary unit field is present (celsius/fahrenheit) and compute the missing value using the conversion formula.",
  "confidence": 0.85
}
该智能体比较两个结果,并选择置信度分数更高的那个。如果所选策略达到阈值(默认 0.7),则应用该修正。如果未达到,编排器会发送 SNS 通知以进行人工干预。
这种设计为你带来:
- 广度 – 知识库可以利用已索引文档中的领域知识,对新颖的错误模式进行推理,即使对于它此前未见过的组合也是如此。
- 精度 – S3 Vectors 为已知组合提供即时、高置信度的修复,无需 Amazon Bedrock 模型推理。
- 优雅降级 – 如果两个来源都无法返回有信心的答案,系统会通知人工,而不是应用糟糕的修复。
修正智能体通过权衡两个知识来源与置信度阈值来决定应用哪个修复。以下流程图展示了该决策逻辑,并附有示例置信度分数:
图 3:带置信度阈值的双来源修正决策流程
该流程图展示了修正智能体并行查询 Amazon Bedrock 知识库和 S3 修正文件,然后选择置信度更高的策略(例如,S3 分数为 0.85,高于知识库分数 0.78)。如果所选分数达到 0.7 阈值,智能体便应用修正并返回修正后的记录。如果未达到,智能体返回失败。这会触发 Amazon SNS 通知以进行人工审核。
闭环:自动化代码修复
大多数数据质量系统止步于修复记录。这条流水线更进一步:修复智能体会将错误追溯到其源头,并提出代码修复方案。
修正成功后,编排器调用代码修复智能体,该智能体会:
- 读取源仓库 – 使用存储在 AWS Secrets Manager 中的凭证连接到该仓库。
- 分析根本原因 – 关联错误类型、schema 类型和所应用的修正,以确定是哪个上游代码产生了错误数据。
- 生成代码变更 – 生成保留现有逻辑的推荐变更(它不会建议禁用验证或移除功能)。
- 提交拉取请求 –使用 GitHub MCP Server 创建分支、提交更改,并开启一个拉取请求,在描述中包含根因分析。
def _create_mcp_client(auth_token: str):
    return MCPClient(
        lambda: streamable_http_client(
            GIT_MCP_URL,
            http_client=create_mcp_http_client(headers=headers),
        ),
        startup_timeout=GIT_MCP_TIMEOUT,
    )
这意味着反复出现的错误会在源头得到修复,而不仅仅是在数据湖中打补丁。随着时间的推移,随着上游代码的改进,管道的错误率会下降。
数据湖:三个区域,一个真相
S3 数据湖跨三个区域使用基于前缀的组织方式。下游消费者可以看到已处理记录的完整数据,无论记录在首次通过时有效还是被代理更正:
| 区域 | 用途 | 写入方 |
raw/ | 未修改的原始记录(审计跟踪) | 数据生产者 |
transformed/ | 经过验证、符合模式的记录 | Glue ETL 作业 + 持久化代理 |
corrected/ | 带有更正元数据的已更正记录 | 持久化代理 |
持久化代理将已更正记录写入两个区域。corrected 区域提供可审计性,捕获错误内容及其修复方式。transformed 区域为下游消费者提供完整数据集,无需合并多个路径。
部署管道
了解架构后,即可部署管道。完整的示例实现可在 GitHub 仓库 中找到。整个系统在 AWS CDK(Python)中定义。一条 cdk deploy 命令即可配置所有基础设施、通过 CodeBuild 构建容器镜像、创建知识库,并设置 AgentCore 运行时资源。
步骤 1:克隆仓库并安装依赖
git clone https://github.com/aws-samples/sample-self-healing-etl-pipeline.git
cd sample-self-healing-etl-pipeline

python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
步骤 2:引导 CDK 并部署基础设施
使用一条命令部署所有堆栈。CDK 自动处理依赖顺序、容器镜像构建、知识库创建和运行时配置:
# Bootstrap CDK (first time only)
cdk bootstrap aws://$(aws sts get-caller-identity --query Account --output text)/us-east-1

# Deploy all stacks
cdk deploy --all \
  --require-approval broadening \
  -c aws_region=us-east-1 \
  -c aws_account=$(aws sts get-caller-identity --query Account --output text) \
  -c [email protected] \
  -c git_repo_url=https://github.com/aws-samples/sample-self-healing-etl-pipeline
CDK 按依赖顺序部署以下堆栈:
| 堆栈 | 资源 |
WeatherDataLakeStack | S3 输出存储桶(transformed + corrected 区域) |
WeatherIngestionStack | S3 原始着陆存储桶 |
WeatherGlueStack | 爬网程序、数据目录、ETL 作业、自动脚本上传 |
WeatherKnowledgeBaseStack | S3 Vector 存储桶 + 索引、Amazon Bedrock 知识库 + 数据源、自动文档上传 + 摄取、带生成的查找文件的代理向量存储桶 |
WeatherAgentCoreStack | ECR 仓库、IAM 角色、SNS 主题、Secrets Manager、带有自动 ARM64 镜像构建的 CodeBuild 项目 |
WeatherAgentCoreRuntimeStack | 四个 AgentCore Runtime 资源 |
为可选修复步骤传递仓库凭据:
./scripts/set_git_token.sh --token <your_github_token>堆栈通过 app.py 中的构造函数参数相互传递资源。例如,AgentCore 运行时堆栈从 AgentCore 堆栈接收 IAM 角色和 ECR 仓库 URI。它还从知识库堆栈接收知识库 ID:
# app.py: cross-stack wiring
agentcore_stack = AgentCoreStack(
    app,
    "WeatherAgentCoreStack",
    notification_email=config["notification_email"],
    git_repo_url=config["git_repo_url"],
    knowledge_base_id=knowledge_base_stack.knowledge_base.attr_knowledge_base_id,
    correction_vectors_bucket=knowledge_base_stack.correction_vectors_bucket.bucket_name,
    persistence_vectors_bucket=knowledge_base_stack.persistence_vectors_bucket.bucket_name,
    corrected_bucket=data_lake_stack.output_bucket.bucket_name,
    transformed_bucket=data_lake_stack.output_bucket.bucket_name,
    log_retention_days=config["log_retention_days"],
    env=env,
)

# Runtime stack deploys last, after CodeBuild pushes the agent images to ECR
runtime_stack = AgentCoreRuntimeStack(
    app,
    "WeatherAgentCoreRuntimeStack",
    agent_roles=agentcore_stack.agent_roles,
    ecr_repo_uris={name: repo.repository_uri for name, repo in agentcore_stack.ecr_repos.items()},
    notification_topic_arn=agentcore_stack.notification_topic.topic_arn,
    git_secret_arn=agentcore_stack.git_secret.ref,
    knowledge_base_id=knowledge_base_stack.knowledge_base.attr_knowledge_base_id,
    correction_vectors_bucket=knowledge_base_stack.correction_vectors_bucket.bucket_name,
    persistence_vectors_bucket=knowledge_base_stack.persistence_vectors_bucket.bucket_name,
    corrected_bucket=data_lake_stack.output_bucket.bucket_name,
    transformed_bucket=data_lake_stack.output_bucket.bucket_name,
    env=env,
)
有一个连接细节值得提及:AWS Glue 堆栈在运行时堆栈存在之前部署。这意味着在不产生循环依赖的情况下,无法将编排器 ARN 作为 CDK 引用传递。取而代之的是,运行时堆栈将 ARN 写入 AWS Systems Manager (SSM) 参数 (/weather-etl/orchestrator-runtime-arn),而 AWS Glue 作业在作业运行时读取它。
步骤 3:验证知识源
知识源在 cdk deploy 期间自动填充。领域文档(模式定义、错误模式、NOAA 数据指南)从仓库的 knowledge_base/ 文件夹上传到知识库源存储桶。随后自定义资源触发知识库摄取作业。更正策略文件和存储映射从相同文档生成,并上传到代理向量存储桶。
验证填充已完成:
# Resolve the auto-generated vector bucket names from stack outputs (run once)
CORRECTION_BUCKET=$(aws cloudformation describe-stacks \
  --stack-name WeatherKnowledgeBaseStack \
  --query "Stacks[0].Outputs[?ExportName=='WeatherKB-CorrectionVectorsBucketName'].OutputValue" \
  --output text)

PERSISTENCE_BUCKET=$(aws cloudformation describe-stacks \
  --stack-name WeatherKnowledgeBaseStack \
  --query "Stacks[0].Outputs[?ExportName=='WeatherKB-PersistenceVectorsBucketName'].OutputValue" \
  --output text)

# Check correction strategy files (one per schema-type/error-type combination)
aws s3 ls "s3://$CORRECTION_BUCKET/correction/" --recursive | head

# Check storage mapping files
aws s3 ls "s3://$PERSISTENCE_BUCKET/persistence/" --recursive | head
更正向量存储桶包含每种模式类型/错误类型组合一个 JSON 文件,每个文件包含更正策略和置信度分数。持久化向量存储桶包含存储映射文件,告知持久化代理每种模式类型的写入位置和方式。
步骤 4:使用示例数据测试更正工作流
生成包含有意错误的示例天气数据并直接上传到 S3:
# Generate 15 valid records + 4 error records and upload to S3 raw zone
python3 scripts/generate_sample_data.py --upload --region us-east-1
上传数据后,AWS Glue 爬网程序将在其下一次计划运行时对新记录进行编目。然后您可以触发 AWS Glue ETL 作业来验证记录,将有效记录写入 transformed 区域,并将错误路由到编排器。
# Trigger the Glue ETL job manually
aws glue start-job-run \
  --job-name weather-etl-job-$(aws sts get-caller-identity --query Account --output text)-us-east-1 \
  --region us-east-1

# Resolve the auto-generated data lake bucket name from stack outputs
OUTPUT_BUCKET=$(aws cloudformation describe-stacks \
  --stack-name WeatherDataLakeStack \
  --query "Stacks[0].Outputs[?ExportName=='WeatherDataLake-OutputBucketName'].OutputValue" \
  --output text)

# Check results
aws s3 ls "s3://$OUTPUT_BUCKET/transformed/" --recursive
aws s3 ls "s3://$OUTPUT_BUCKET/corrected/" --recursive
您可以在 Amazon CloudWatch Logs(日志组 /aws/bedrock-agentcore/runtimes/weather_correction_agent-*)中查看更正代理的决策流程。以下摘自真实运行的片段展示了针对 missing_field 错误的双源查找和策略选择:
[CORRECTION] Step 1: Querying Amazon Bedrock knowledge base for semantic correction guidance
  (domain docs, error patterns, schema definitions)
[KB] Querying Amazon Bedrock knowledge base (ID=XXXXXXXXXX) for correction strategy.
  Query: 'How to correct a missing_field error in a precipitation_measurement
  weather record? Error details: Missing required field: data'
[KB] Received 3 results from knowledge base
[KB] Top result: score=0.784, source=s3://weatherknowledgebasestack-kbsourcebucket29781297-xxxxxxxxxxxx/error_patterns/missing_field.md,
  content_preview='# Error Pattern: Missing Field ## Description Records where one or
  more required fields in the data payload are absent...'
[CORRECTION] Step 2: Querying S3 Vectors for pre-computed correction strategy
  (exact match by schema_type + error_type)
[S3V] Querying S3 Vectors for pre-computed correction strategy.
  Bucket=weatherknowledgebasestack-correctionvectorsbucket27485eb2-xxxxxxxxxxxx, Key=correction/precipitation_measurement/missing_field.json
[S3V] Found correction strategy: score=0.85, strategy='**Field name correction**:
  Check for similar field names that may be typos and rename them.'
[CORRECTION] Step 3: Strategy selection — KB strategy=found (score=0.78),
  S3V pattern=found (score=0.85) → selected confidence=0.85, threshold=0.70
两个来源都返回了策略。预计算的 S3 文件得分更高(0.85 对比 0.78),超过了 0.7 阈值,更正已应用。
要查看更正本身,请将错误记录与其更正版本进行比较。此示例记录未通过验证,因为 temperature_celsius 包含字符串而不是数字:
{
  "record_id": "fd04d2d9-ab37-4baf-869b-33a52ef9c574",
  "schema_type": "temperature_observation",
  "data": {
    "temperature_celsius": "not-a-number",
    "temperature_fahrenheit": 74.3,
    "measurement_type": "surface",
    "quality_flag": "valid",
    "sensor_id": "TEMP-ERR-001"
  }
}
写入数据湖的已更正记录保留原始字段,并用所选更正策略对记录进行标注。这使下游消费者和审计人员能够看到选择了哪种修复:
{
  "record_id": "fd04d2d9-ab37-4baf-869b-33a52ef9c574",
  "schema_type": "temperature_observation",
  "data": {
    "temperature_celsius": "not-a-number",
    "temperature_fahrenheit": 74.3,
    "measurement_type": "surface",
    "quality_flag": "valid",
    "sensor_id": "TEMP-ERR-001"
  },
  "_correction_applied": "**Type coercion**: For invalid numeric formats,
    check if the complementary unit field is present and compute the value
    using the conversion formula."
}
示例实现使用策略对记录进行标注,而不是修改字段值,从而保持更正的透明性和可逆性。要直接应用转换(例如,从有效的 temperature_celsius 推导 temperature_fahrenheit 值),请使用您领域的转换逻辑扩展更正代理的 _apply_correction 函数。
代理完成后,已更正记录会出现在两个数据湖区域中。此测试运行的列表显示,四条有意损坏的记录在 AWS Glue 作业将其路由后几分钟内被修复并写入 corrected 区域:
$ aws s3 ls s3://$OUTPUT_BUCKET/corrected/ --recursive

2026-08-04 11:51:12  720  corrected/precipitation_measurement/2026-08-04/0bde2ae3-....json
2026-08-04 11:56:28  758  corrected/pressure_observation/2026-08-04/ce2ea549-....json
2026-08-04 12:01:44  783  corrected/temperature_observation/2026-08-04/24050a62-....json
2026-08-04 12:06:59  716  corrected/wind_observation/2026-08-04/d894ac43-....json
相同的已更正记录也会落入 transformed 区域,因此下游消费者可以将它们与首次通过验证的记录一并看到。如果更正低于置信度阈值,编排器则改为向配置的电子邮件地址发布 SNS 通知,其中包含错误详情以供人工审核。
修复步骤需要仓库凭据(git_repo_url部署时的上下文值,使用脚本设置 git token)。配置后,修复代理会创建一个分支,提交建议的修复,并打开一个拉取请求,在描述中包含根因分析。如果没有凭据,代理会记录修复已被跳过,工作流仅完成数据纠正和持久化。
此模式自动化的内容
下表将标准 ETL 错误处理工作流与自愈方法进行了比较:
| 标准 ETL 工作流 | 自愈 ETL 工作流 |
| 坏记录进入死信队列 | 坏记录被纠正并重新插入 |
| 工程师手动分诊错误 | 代理自动分类并修复错误 |
| 代码修复需要单独的工作流 | 自动提交拉取请求 |
| 在代码被修补之前,同样的错误会反复出现 | 根因在源头得到解决 |
| 下游消费者看到不完整的数据 | 转换区包含已纠正的记录 |
| 知识存在于运行手册和部落记忆中 | 知识存在于可搜索、有版本控制的知识库中 |
要了解自愈自动化如何针对单条记录协同工作,请从头到尾跟踪一条错误记录贯穿管道的过程。下图描绘了该路径:
图 4:单条错误记录贯穿管道的端到端跟踪
该图跟踪一条错误记录贯穿管道的过程:AWS Glue ETL 作业中的验证失败、路由到编排器代理、来自 Amazon Bedrock 知识库和 S3 纠正文件的带置信度分数的双源纠正、持久化到转换区和纠正区两个数据湖区,以及一个解决上游代码中根因的仓库拉取请求。
关键设计决策
四个代理强制执行关注点分离 – 你可以在不触碰持久化逻辑的情况下,用新策略更新纠正代理。在没有仓库访问权限的环境中,跳过配置修复代理的凭据。低置信度通知等故障模式位于编排器中,独立于纠正逻辑。
置信度阈值有助于防止不正确的纠正 – 应用错误的纠正比不纠正更糟。使用 0.7 阈值时,系统在有信心时采取行动,否则通知人类。你可以根据你的容忍度,按模式或按错误类型调整此值。
两个知识源扮演不同且互补的角色 – 知识库擅长处理新颖模式。它可以通过利用领域文档,对以前未见过的错误组合进行推理。Amazon S3 Vectors 擅长处理已知模式,无需模型推理延迟即可返回即时、确定性的结果。二者结合,覆盖了长尾情况和常见情况。
清理资源
为避免持续产生费用,完成后请拆除已部署的资源:
source .venv/bin/activate
cdk destroy --all
CDK 按反向依赖顺序销毁所有堆栈。清理过程会处理:
- 删除所有 CDK 堆栈及其资源。
- 清空 S3 存储桶(通过使用
autoDeleteObjects)。 - 删除 ECR 容器镜像(通过使用
emptyOnDelete)。 - 删除 S3 Vector 存储桶和索引。
- 强制删除用于仓库凭据的 Secrets Manager 密钥。
如果你希望手动清理,请按以下顺序删除堆栈:
WeatherAgentCoreRuntimeStack。WeatherAgentCoreStack。WeatherKnowledgeBaseStack。WeatherGlueStack。WeatherIngestionStack。WeatherDataLakeStack。
CDK 创建的 S3 存储桶已启用 autoDeleteObjects,并会在堆栈删除期间自动清空。清理不会删除 CDK 引导堆栈(CDKToolkit)。如果不再需要,请单独删除它。
结论
多代理系统将标准 ETL 管道转变为自愈管道。系统会自动纠正并持久化错误,并且系统可以提出拉取请求以修复源代码。关键组件:
- AWS Glue 充当质量门,验证数据并将失败路由到代理系统,而不是死信队列。
- Amazon Bedrock AgentCore 搭配 Strands Agents SDK 提供托管的多代理编排,无需构建自定义工作流基础设施。
- Amazon Bedrock Knowledge Bases + S3 Vectors 通过语义推理和确定性查找为代理提供领域专业知识。
- 修复代理旨在在配置了仓库凭据时闭环。它提议修复产生坏数据的代码,而不仅仅是数据本身。
要开始使用,请克隆 示例仓库 并按照本文中的部署步骤操作。要了解有关所用服务的更多信息,请参阅 Amazon Bedrock AgentCore 文档、Strands Agents SDK 文档 和 AWS Glue 文档。通过将天气模式验证器替换为你所在领域的验证逻辑,将此模式适配到你自己的数据格式。用你的领域专业知识更新知识库文档,并用已知错误模式的纠正策略填充 S3 Vectors。你可以通过添加用于领域特定纠正的微调模型或实施自动合并低风险修复的审批策略来扩展管道。随着错误目录的增长,你还可以连接其他知识源。
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏