在Databricks上高效运行dbt的实践指南
有效阅读仅保存在当前浏览器,用于「为你」推荐;暂停或清除记录。
DataHot 速览
Databricks 官方博客介绍如何在 Databricks 上更高效地运行 dbt。文章称已有超过3000家组织在 Databricks 上运行 dbt,但多数团队仍有优化空间。文中给出增量策略选择(append、merge、replace_where、insert_overwrite、delete+insert、microbatch)、自动表维护和按模型归因成本等实践。目标是让 dbt 管道更便宜、更快、更易运维。
为什么值得关注:对使用 dbt + Databricks 的数据团队有直接参考价值,涵盖增量策略、表维护和成本归因等可落地的性能与成本优化方法。
本文目录 11 节
译文
AI 逐段翻译数万个组织依赖 dbt 进行数据转换。你在哪里运行它决定了方方面面:运行 dbt 管道的成本、交付速度,以及所承载的运维工作量。在 Databricks 上运行 dbt 能为你的 dbt 工作负载提供一个开放平台和统一管道。
超过 3000 个组织在 Databricks 上运行 dbt,而大多数团队本可以从中获得更多收益。本文重点介绍能让 dbt 管道在 Databricks 上更便宜、更快速、更易于运维的实践。
让你的 dbt 管道更便宜、更快速
dbt 账单的攀升源于你无需重复的工作。全量重建会重新计算未发生变化的数据,保持查询快速需要手动调优,而当账单激增时,又无法清晰地归因到导致问题的 dbt 模型。采用本节中的实践后,你的管道将:
- 只重建实际发生变化的数据
- 无需你选择或重做分区键即可保持快速
- 无需 post-hooks 即可自动运行表维护
- 将每一美元支出追踪到具体模型
1. 使用增量策略只构建发生变化的部分
全表重建是大多数 dbt 项目中最大的可避免成本。当两次运行之间只有一小部分数据发生变化时,重新计算整张表会浪费你的计算资源并增加账单。dbt 的增量策略均在 dbt-databricks 上受支持,可让每个模型只处理新数据,而正确的选择取决于你的数据实际如何到达。
| 策略 | 适用场景 |
|---|---|
| append | 行只会被插入,从不更新 |
| merge | 同一个键可能多次到达且需要更新插入(缓慢变化维度、去重、延迟到达的更新) |
| replace_where(dbt-databricks 专有) | 模型在每次运行时重新推导一个狭窄的时间窗口,例如最近几天的活动 |
| insert_overwrite | 你的查询返回完整分区 |
| delete+insert(dbt-databricks 专有) | 你想按键替换记录,但不涉及列级更新逻辑 |
| microbatch | 具有 event_time 列且需要结构化回填的时间序列数据 |
大多数项目默认使用 merge,即使更狭窄的策略就足够了。如果你能用谓词描述变化的数据,replace_where 所做的工作比需要扫描目标表以查找匹配项的 merge 更少。如果你无法做到,在 incremental_predicates 中为 merge 设置增量谓词可以大幅缩小该扫描范围。
上述每种策略都是你需要做出并维护的决定。下一项实践让平台为你处理这件事。
2. 让物化视图为你处理增量计算
物化视图 可自动完成增量计算。你可以用普通 SQL 定义模型,Databricks 会跟踪哪些底层数据发生了变化,并仅刷新受影响的结果。在 dbt-databricks 上,物化视图是一种原生物化,因此这只是一行配置的改动:
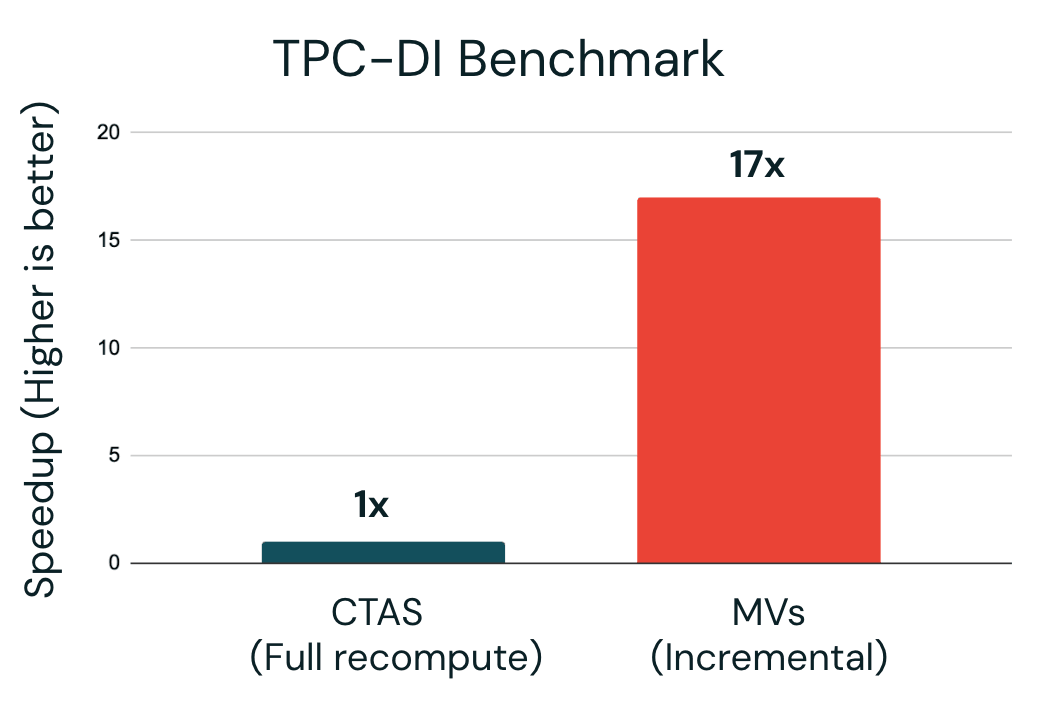
物化视图最适合服务层:对频繁变化的源进行聚合,尤其是那些支撑仪表板且需要保持新鲜的昂贵聚合。在我们的 TPC-DI 基准测试中,将服务层的全量重算切换为物化视图带来了 17 倍的加速。
3. 自动化数据布局以进行性能调优
选择分区键、在查询模式变化时重做它们,以及在 post-hooks 中调度 OPTIMIZE、VACUUM 和 ANALYZE,都会占用工程时间。
预测性优化 会在托管表上自动运行 OPTIMIZE、VACUUM 和统计信息收集,并根据每张表的查询方式选择运行什么以及何时运行。在目录或 schema 级别启用一次,dbt 项目通常为表维护积累的 post-hooks 就可以退役了。
对于数据布局,Liquid Clustering 用自调优布局取代了分区设计。它根据表的实际查询方式组织数据,避开了过度分区表所遭遇的小文件爆炸问题,并随查询模式的变化而自适应。或者借助由预测性优化驱动的 自动 Liquid Clustering(CLUSTER BY AUTO),让 Databricks 根据查询历史选择并调整它们。一个项目级配置即可为项目构建的每张新表设置聚类。
这两项功能都被设计为一次性决策。借助 自动升级,Unity Catalog 托管表会随着 Databricks 发布新优化而持续获得这些优化。
4. 使用查询标签归因每一美元支出
季度末,财务部门会问为什么数据仓库账单上涨了。在大多数配置中,没有人能回答,因为使用数据中的查询与发出它的 dbt 模型之间没有任何关联。
查询标签 让这种关联自动建立。dbt 在 Databricks 上运行的每个查询都会自动打上模型名称、dbt 版本和物化类型。添加你自己的 DIY 自定义标签,用于组织预算所依据的维度:
这些标签会出现在 system.query.history 中,与 system.billing.usage 进行连接,即可将无服务器仓库支出归因到标签支持的任何分组:按模型、按团队、按领域、按物化类型的成本。你可以确切看到哪些模型成本最高。
简化你的 dbt 管道
典型的 dbt 设置依赖一堆其他工具:一个单独的系统用于摄取数据,一个外部编排器用于运行项目,每个 BI 工具都会重新定义相同的指标,以及治理规则位于 dbt 项目之外。每一样都是额外需要维护的东西,也是额外可能发生漂移的地方。采用本节中的实践后,一个 dbt 项目将能够:
- 直接将数据摄取到项目中
- 从 Databricks 运行和部署,无需维护第三方编排器
- 向每个工具提供统一的受治理指标定义
- 自带治理规则,并与你的 dbt 模型一起进行版本控制
1. 使用流式表将数据摄取纳入 dbt 项目
摄取是管道中传统上位于 dbt 之外的部分,导致架构割裂且没有统一的血缘概览。streaming_table 物化消除了这种拆分。以流式表物化的 dbt 模型会随着新文件或事件到达而增量地获取它们,因此数据接入就变成了 DAG 中又一个普通的模型。
从那里开始,管道的其余部分(silver 和 gold 模型)可以用 ref() 来引用这个流式表,测试和文档适用于每一层,血缘覆盖了从原始文件到最终 mart 的整条路径。
2. 使用 Unity Catalog Semantics 标准化指标
每个 BI 工具、智能体或其他数据消费者都会构建自己的指标定义,这会导致利益相关者之间产生困惑和分歧。一个 指标视图 将定义移入一个受治理的统一位置:你只需声明一次度量和维度,每个消费者都会查询相同的逻辑。
dbt-databricks 将 指标视图 暴露为一种原生物化类型,因此定义就存放在你的 dbt 项目中,像任何其他模型一样被版本化并接受审查。
用户可以在查询时使用 MEASURE() 函数自行选择分组,因此同一份定义便可服务于 SQL 编辑器、BI 仪表板、笔记本和 Genie。
3. 通过 Lakeflow Jobs 原生编排 dbt
dbt 运行很少就是整条管道。当上游和下游步骤位于不同工具中时,额外开销会不断累积:需要额外管理、付费和保障安全的工具,以及分散的血缘。
Lakeflow Jobs 将其整合为一个有向无环图(DAG),并将 dbt 作为原生任务。数据接入任务为 dbt 任务提供输入,下游任务在其完成后触发,依赖关系由平台强制执行。运维层已内置调度、自动重试、运行历史和告警,无需维护任何额外基础设施。Jobs 支持 dbt Core 和 dbt Platform,对 dbt Core v2.0 的支持也即将推出。
4. 使用 Declarative Automation Bundles 以代码形式部署
在 UI 中手工组装的任务难以版本化、审查或复现。 Declarative Automation Bundles(DABs)解决了这个问题,它让任务定义成为代码仓库的一部分。Lakeflow Job、其调度、计算设置以及 dbt 项目全部在 YAML 中声明,并作为一个包进行部署。
使用 --target dev 部署会创建整条管道的隔离副本;--target prod 将其提升。
项目中的每个模型并非都需要在每次调度时运行。在 dbt YAML 中按节奏为模型打标签,并为每种节奏分配各自的任务,只构建带有该标签的模型。将模型从每日改为每小时就变成了一行改动:
5. 在项目中定义治理
治理通常在模型运行之后配置,与构建数据的 dbt 项目分离。由于治理位于你的 dbt 项目之外,它可能与你的 dbt 运行逐渐失去同步。
在模型本就所在的 dbt 项目中定义治理。作为项目配置,它随代码一起交付,像代码一样接受审查,并由 Unity Catalog 在每次查询时强制执行。
标签、授权以及行级和列级保护都可以在 dbt_project.yml 中的项目级配置里定义。 databricks_tags 驱动分类和策略,grants 控制谁可以读取该表,而 row_filters 和 column_masks 控制每个用户能看到什么:
在规模化场景下,基于属性的访问控制(ABAC)消除了重复。在一个受治理的标签上定义一次策略,它就会将正确的行过滤器和列掩码应用到所有带有该标签的表上,因此一个标记为 pii 的新模型在构建的那一刻就受到覆盖。只有当逻辑确实是模型特有的时候(例如多租户隔离),才需要为单个模型设置过滤器和掩码。
这些实践的共同主题是将运维工作交给平台:增量处理、数据布局、表维护、治理执行和编排。留在你的 dbt 项目中的是经过版本控制和测试的转换逻辑。选择能解决你项目当前痛点的实践,并从那里开始。
加入已在 Databricks 上运行 dbt 的 3000+ 组织。从 dbt-databricks 适配器 开始使用。
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏