用 OpenSearch 与 AI Agent 监控 MWAA ETL 管道
DataHot 速览
当 MWAA 编排的 ETL 管道跨多个 AWS 服务时,故障排查需要在 AWS Glue、Amazon EC2 和 Amazon MWAA 各自的 CloudWatch 日志组之间来回查找,凌晨 2 点排障尤其耗时。该方案通过 CloudWatch 实时流式传输把日志集中到 Amazon OpenSearch Service,并部署运行在 Amazon Bedrock AgentCore 上的 OpenSearch MCP server 与 ETL analysis agent。文章提供 CloudFormation 模板和 Amazon SageMaker AI notebook,用于搭建示例架构与演示 ETL 作业。目标读者是数据工程师、DevOps 工程师和云工程师,用 AI agent 加速根因定位、解读日志并给出修复建议。
为什么值得关注:展示如何把多服务 ETL 日志集中并接入 AI Agent 做根因定位,为数据平台可观测性与运维自动化提供可复制的架构参考。
本文目录 22 节
译文
AI 逐段翻译当你的由 MWAA 编排的提取、转换和加载(ETL)管道跨越多个 AWS 服务时,排查故障就变成了一场寻宝游戏。AWS Glue 作业转换数据,自定义脚本运行在 Amazon Elastic Compute Cloud(Amazon EC2) 上,而 Amazon Managed Workflows for Apache Airflow(Amazon MWAA)中的有向无环图(DAG)协调工作流,但每个服务都会将自己的日志写入其各自的 Amazon CloudWatch 日志组。当凌晨 2 点出现故障时,你的团队要花费宝贵的时间定位正确的日志流,然后才能开始诊断根本原因。
这些可观测性挑战并非某个团队独有。DevOps 工程师经常要周旋于多种工具之间,并且必须分析大量日志才能识别和解决问题。在故障期间,每次在工具或日志之间切换都要耗费数分钟,并直接推高平均解决时间。解读日志是另一个挑战。即使工程师找到了正确的日志流,解析输出结果也需要对每个服务的日志记录约定有深入了解。一个失败的任务就可能将相关上下文分散在数十条冗长、交错的日志条目中,这些条目掩盖而非揭示根本原因。
本解决方案通过使用 AI 代理来加速根本原因识别、解读相关日志并推荐问题解决方法,帮助你修复分析管道中的错误。在本文中,你将学习如何实现这一分析可观测性解决方案。目标受众是数据工程师、DevOps 工程师和云工程师。
你部署一组提供的 AWS CloudFormation 模板和一个 Amazon SageMaker AI 笔记本 来实现示例架构,并创建一组由 Amazon MWAA 编排的演示 ETL 作业。CloudFormation 模板部署架构组件,SageMaker AI 笔记本包含用于配置组件并与 MCP 服务器交互的代码。
解决方案概述
本解决方案使用 CloudWatch 实时流式传输将日志集中到 Amazon OpenSearch Service 中。借助运行在 Amazon Bedrock AgentCore 上的 OpenSearch MCP 服务器,工程师可以通过 ETL 分析代理识别问题并获得建议。
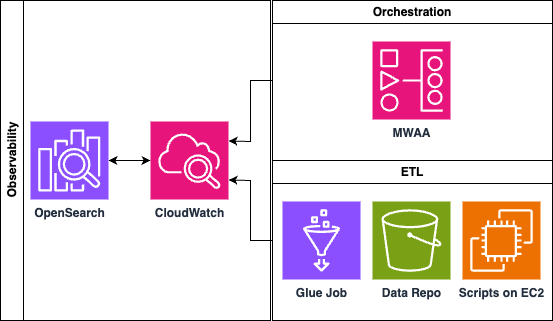
图 1:将 ETL 日志流式传输到 Amazon OpenSearch Service 并通过 Amazon Bedrock AgentCore 上的 MCP 服务器查询它们的解决方案架构
先决条件
在部署此解决方案之前,请确保已具备以下条件:
AWS 账户和 AWS 区域
一个可访问美国东部(弗吉尼亚北部)us-east-1 区域的活跃 AWS 账户。CloudFormation 堆栈必须部署在 us-east-1 中。
IAM 权限
一个 AWS Identity and Access Management(IAM)用户或角色,具有创建和管理以下 AWS 资源的权限:
- Amazon OpenSearch Service(域创建、精细访问控制)。
- Amazon MWAA(环境创建、DAG 执行)。
- Amazon MWAA Serverless(工作流创建和执行、用于工作流定义的带版本 S3 存储桶,以及一个需要
iam:PassRole的工作流执行角色)。 - AWS Glue(作业创建和执行)。
- Amazon EC2(实例启动、安全组)。
- Amazon Simple Storage Service(Amazon S3)(存储桶创建、对象管理)。
- AWS Lambda(函数创建和执行)。
- Amazon CloudWatch Logs(日志组创建、订阅筛选器)。
- Amazon SageMaker AI(笔记本实例创建)。
- Amazon Bedrock(模型访问,以及 AgentCore 运行时,这是 Amazon Bedrock AgentCore 的一项功能)。
- Amazon Cognito(用户池创建)。
- Amazon Elastic Container Registry(Amazon ECR)(存储库创建)。
- AWS CodeBuild(项目创建)。
- AWS CloudFormation(使用 IAM 资源创建堆栈)。
- AWS Secrets Manager(密钥创建)。
- IAM(角色和策略创建)。
Amazon Bedrock 模型访问
在 Amazon Bedrock 控制台中启用对 Anthropic Claude Sonnet 模型的访问。在 Amazon Bedrock 控制台中导航到 Model access,如果尚未启用,则请求访问权限。
CloudFormation 模板
在开始部署之前,从提供的 opensearch_cfn.yaml、etl.yaml 和 agentcore-mcp-server.yaml 中下载三个 CloudFormation 模板文件(GitHub 存储库)。
网络
ETL 堆栈会创建一个新的虚拟私有云(VPC)(默认 CIDR 为 10.192.0.0/16)。如果你计划设置 VPC 对等连接或连通性,请检查此 CIDR 范围是否与账户中的现有 VPC 冲突。
架构
该架构使用 Amazon MWAA(预置型和 Serverless 型)作为编排层。作为托管式 Apache Airflow 服务,Amazon MWAA 让团队能够以代码形式编写复杂的、依赖关系感知的管道,并对其进行调度、重试和监控,而无需预置或运行任何 Airflow 基础设施。Airflow DAG 定义管道工作流,触发 AWS Glue ETL 作业和运行在 Amazon EC2 实例上的 Python 脚本。每个组件都会生成日志并流入 Amazon CloudWatch Logs:Amazon MWAA 通过其原生集成,AWS Glue 通过其默认日志组配置,Amazon EC2 通过 CloudWatch 代理。
CloudWatch 订阅筛选器提供了日志存储与分析之间的桥梁。配置后,这些筛选器会立即开始将来自所选日志组的实时日志数据流式传输到 Amazon OpenSearch Service。这种方法意味着数据无需被复制或重复。订阅筛选器创建了一个实时流式传输管道,在日志到达时对其进行索引。
在 OpenSearch 中,ML Connector 框架与 Amazon Bedrock 集成,以在日志索引上提供基于大语言模型(LLM)的推理。随后,OpenSearch MCP(模型上下文协议)服务器将这些能力暴露给 AI 助手,因此用户可以使用自然语言查询其管道日志,以识别错误、理解故障模式并接收上下文相关的修复建议。
编排和日志生成
架构以 Amazon MWAA 作为编排层开始。Airflow DAG 定义管道工作流,触发 AWS Glue ETL 作业和运行在 Amazon EC2 实例上的 Python 脚本。这些组件中的每一个都会生成日志,这些日志流入 Amazon CloudWatch Logs。
工作流
Amazon MWAA DAG 按计划或事件驱动方式触发 ETL 工作流。AWS Glue 作业运行基于 Spark 的转换,日志自动流入 /aws-glue/ CloudWatch 日志组。同时,Amazon EC2 Python 脚本运行自定义处理逻辑,并将其日志发送到 CloudWatch。Amazon MWAA 任务日志自动落入 /airflow/{env}/ 日志组。最后,CloudWatch 统一代理将日志传送到指定的日志组,在那里可以通过 OpenSearch MCP 服务器进行查询。
日志集成方法
| 组件 | 集成 | 日志组 |
| Amazon MWAA | 原生集成 | /airflow/{env}/task |
| AWS Glue | 默认日志配置 | /aws-glue/jobs/output |
| Amazon EC2 脚本 | CloudWatch 统一代理 | /ec2/etl-scripts |
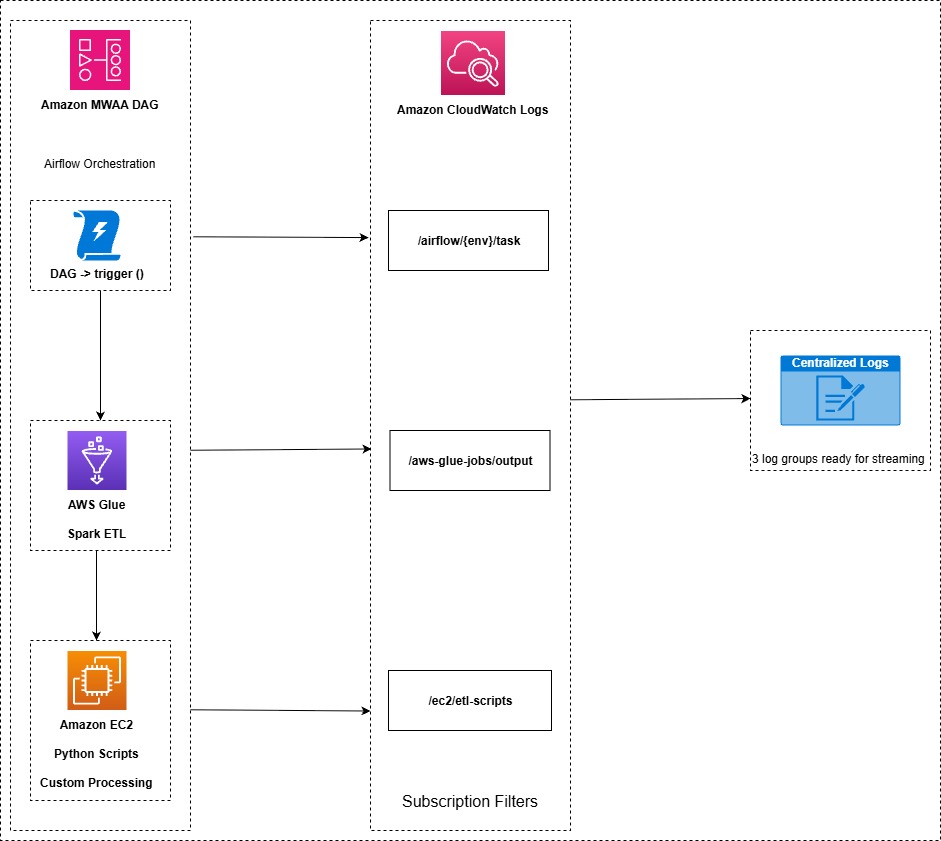
图 2:跨 Amazon MWAA、AWS Glue 和 Amazon EC2 组件的日志生成与集成
实时日志流式传输
CloudWatch 订阅筛选器提供了日志存储与分析之间的桥梁。配置后,这些筛选器立即开始将实时日志数据从选定的日志组流式传输到 Amazon OpenSearch Service。这种方法意味着数据不需要复制或重复。订阅筛选器创建了一个实时流式传输管道,在日志到达时对其进行索引。
过程
- 在每个 CloudWatch 日志组上配置订阅筛选器,以匹配传入的日志事件。
- AWS Lambda 函数解压 gzip 编码的日志数据,解析和丰富记录,并将其格式化为 OpenSearch Bulk API 所需的格式。
- 转换后的数据被批量索引到 Amazon OpenSearch Service 域索引(
airflow-logs-*、glue-logs-*、ec2-logs-*、unified-etl-*)。
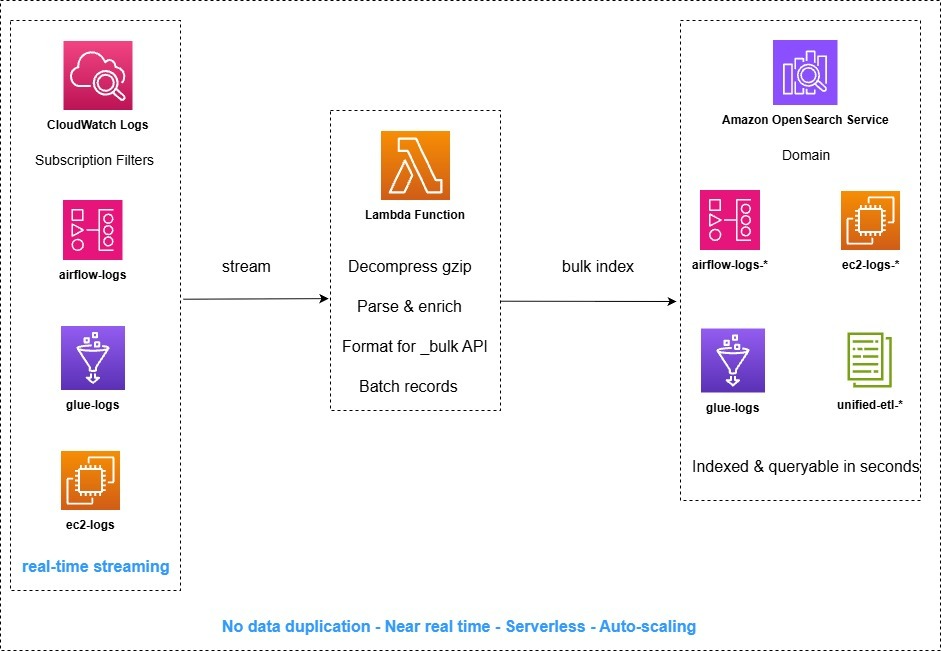
图 3:从 CloudWatch 通过 AWS Lambda 到 Amazon OpenSearch Service 索引的实时日志流式传输
AI 驱动的分析与 MCP 接口
在 OpenSearch 中,ML Connector 框架与 Amazon Bedrock 集成,以在日志索引上提供基于 LLM 的推理。然后,OpenSearch MCP(Model Context Protocol)服务器将这些能力暴露给 AI 助手,因此用户可以使用自然语言查询其管道日志,以识别错误、理解故障模式并接收上下文相关的修复建议。
过程
- 用户通过 AI 助手提交自然语言查询(例如,“Glue 作业为什么在凌晨 3 点失败?”)。
- MCP 服务器将查询转换为具有 ML 增强排序和语义搜索的 OpenSearch DSL。
- ML Connector 调用 Amazon Bedrock(Claude)进行语义理解、日志摘要和模式检测。
- AI 助手向用户返回根因分析以及具体的修复步骤。
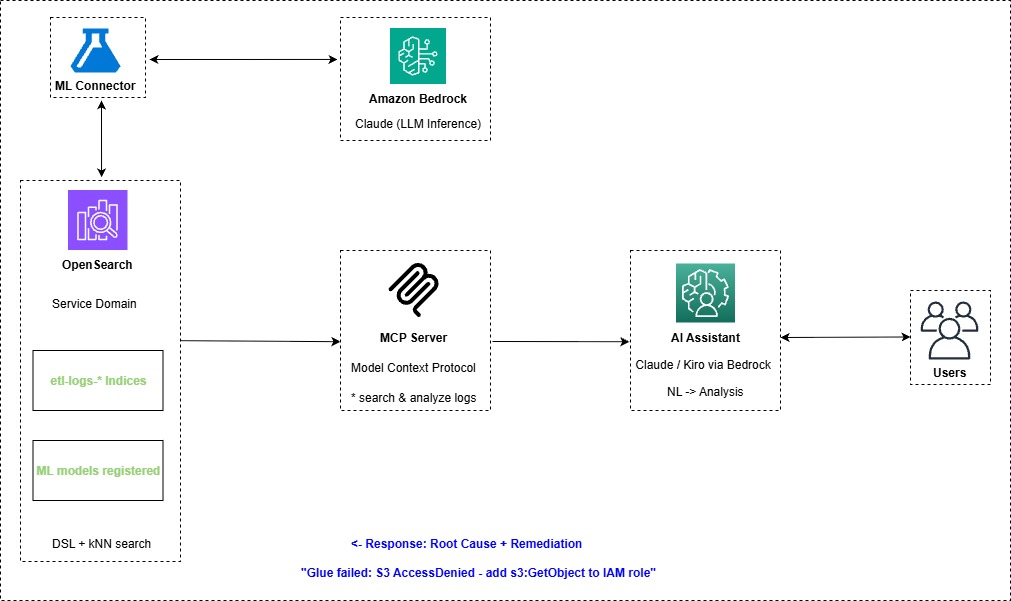
图 4:从自然语言查询到根因和修复指导的 AI 驱动日志分析流程
关键架构优势
- 零数据重复:订阅筛选器直接流式传输数据,无需批量导出、S3 暂存或数据复制。
- 近实时:日志在源系统中生成后不久即在 OpenSearch 中被索引。
- 自然语言:用户通过 MCP 以对话方式查询日志,无需手动编写 OpenSearch DSL。
- 缩短平均解决时间:根因和修复建议在单次查询中交付,缩短了平均解决时间。
- 统一视图:ETL 组件可通过单一搜索界面进行可观测。
- 托管服务:无需预置、修补或维护基础设施。
CloudFormation 堆栈
该解决方案分为三个 CloudFormation 堆栈。每个模板提供管道的一个不同层。
| 堆栈 | 模板文件 | 部署时间 | 用途 |
| opensearch-cfn | opensearch_cfn.yaml | ~15–20 分钟 | OpenSearch 域、SageMaker AI 笔记本、IAM 角色 |
| etl | etl.yaml | ~25–30 分钟 | VPC、Amazon MWAA、AWS Glue、Amazon EC2、日志流式传输管道 |
| agentcore-mcp-server | agentcore-mcp-server.yaml | ~8–12 分钟 | 带有 Amazon Cognito 身份验证的 Amazon Bedrock AgentCore MCP Server |
堆栈 1:opensearch-cfn(opensearch_cfn.yaml)
此堆栈预置基础 OpenSearch 域以及用于交互式探索的经典 SageMaker AI 笔记本实例。此堆栈创建:
- 具有细粒度访问控制的 Amazon OpenSearch Service 域(OpenSearch 3.5)。
- 预加载了研讨会实验笔记本的 SageMaker AI 笔记本实例。
- 用于 ETL 数据、DAG 等的 S3 存储桶。
- 用于笔记本和 Amazon Bedrock 访问的 IAM 角色。
- 用于 OpenSearch 凭据的 Secrets Manager 密钥。
| 参数 | 默认值 | 描述 |
| OpenSearchUsername | admin | OpenSearch 集群的管理员用户名 |
| OpenSearchPassword | (安全) | 管理员密码(8–32 个字符,字母 + 数字 + 符号) |
堆栈 2:etl(etl.yaml)
此堆栈预置 ETL 资源:为 OpenSearch 提供数据的网络、编排、计算和日志流式传输管道。此堆栈创建:
- 具有私有子网和 NAT 网关的 VPC,用于 Amazon MWAA 网络。
- 运行 Airflow DAG 的 Amazon MWAA 环境。
- 一个 AWS Glue ETL 作业(读取 XLSX,删除一列,写入 JSON)。
- 运行并行 Python ETL 脚本的 Amazon EC2 实例。
- 用于聚合的 Amazon MWAA Serverless 工作流。
- 用于 DAG 存储和 ETL 数据的 S3 存储桶。
| 参数 | 默认值 | 描述 |
| EC2InstanceType | t3.micro | ETL 脚本的 EC2 实例类型 |
| VpcCIDR | 10.192.0.0/16 | Amazon MWAA VPC 的 CIDR 块 |
| OpenSearchStackName | opensearch-cfn | OpenSearch 堆栈的名称(用于跨堆栈导入) |
堆栈 3:agentcore-mcp-server(agentcore-mcp-server.yaml)
此堆栈部署一个 Amazon Bedrock AgentCore MCP Server,它公开 OpenSearch 工具(ListIndexTool、IndexMappingTool、SearchIndexTool)以支持自然语言日志查询。它包含 Amazon Cognito 身份验证以及通过 CodeBuild 构建的容器化 MCP 服务器。此堆栈创建:
- 托管 OpenSearch MCP 服务器的 Amazon Bedrock AgentCore 运行时。
- 用于 OAuth 身份验证的 Amazon Cognito 用户池。
- 用于 MCP 服务器容器的 Amazon ECR 存储库。
- 用于构建和部署容器的 CodeBuild 项目。
| 参数 | 默认值 | 描述 |
| MultimodalStackName | opensearch-cfn | OpenSearch 堆栈名称(用于导入域端点) |
| AgentCoreMCPServerName | opensearch_mcp_server | MCP 服务器名称(最多 35 个字符,附加唯一 ID) |
| AmazonOpenSearchEndpoint | (自动导入) | 留空以从 opensearch-cfn 堆栈自动导入 |
| ExecutionRole | (自动创建) | 留空以创建新角色 |
| ECRRepository | (自动创建) | 留空以创建新的 ECR 存储库 |
| OAuthDiscoveryURL | (自动创建 Cognito) | 留空以创建新的 Amazon Cognito 用户池 |
部署顺序: opensearch-cfn,然后是 etl 和 agentcore-mcp-server。etl 和 agentcore-mcp-server CloudFormation 模板使用 opensearch-cfn 的输出。
实现
按顺序部署每个 CloudFormation 堆栈
- 为 opensearch-cfn 部署 OpenSearch 基础设施。
- 转到 AWS CloudFormation 控制台,确认您位于 us-east-1,并确认 Amazon Bedrock 可用。 图 5:在 AWS CloudFormation 控制台中确认 us-east-1 区域
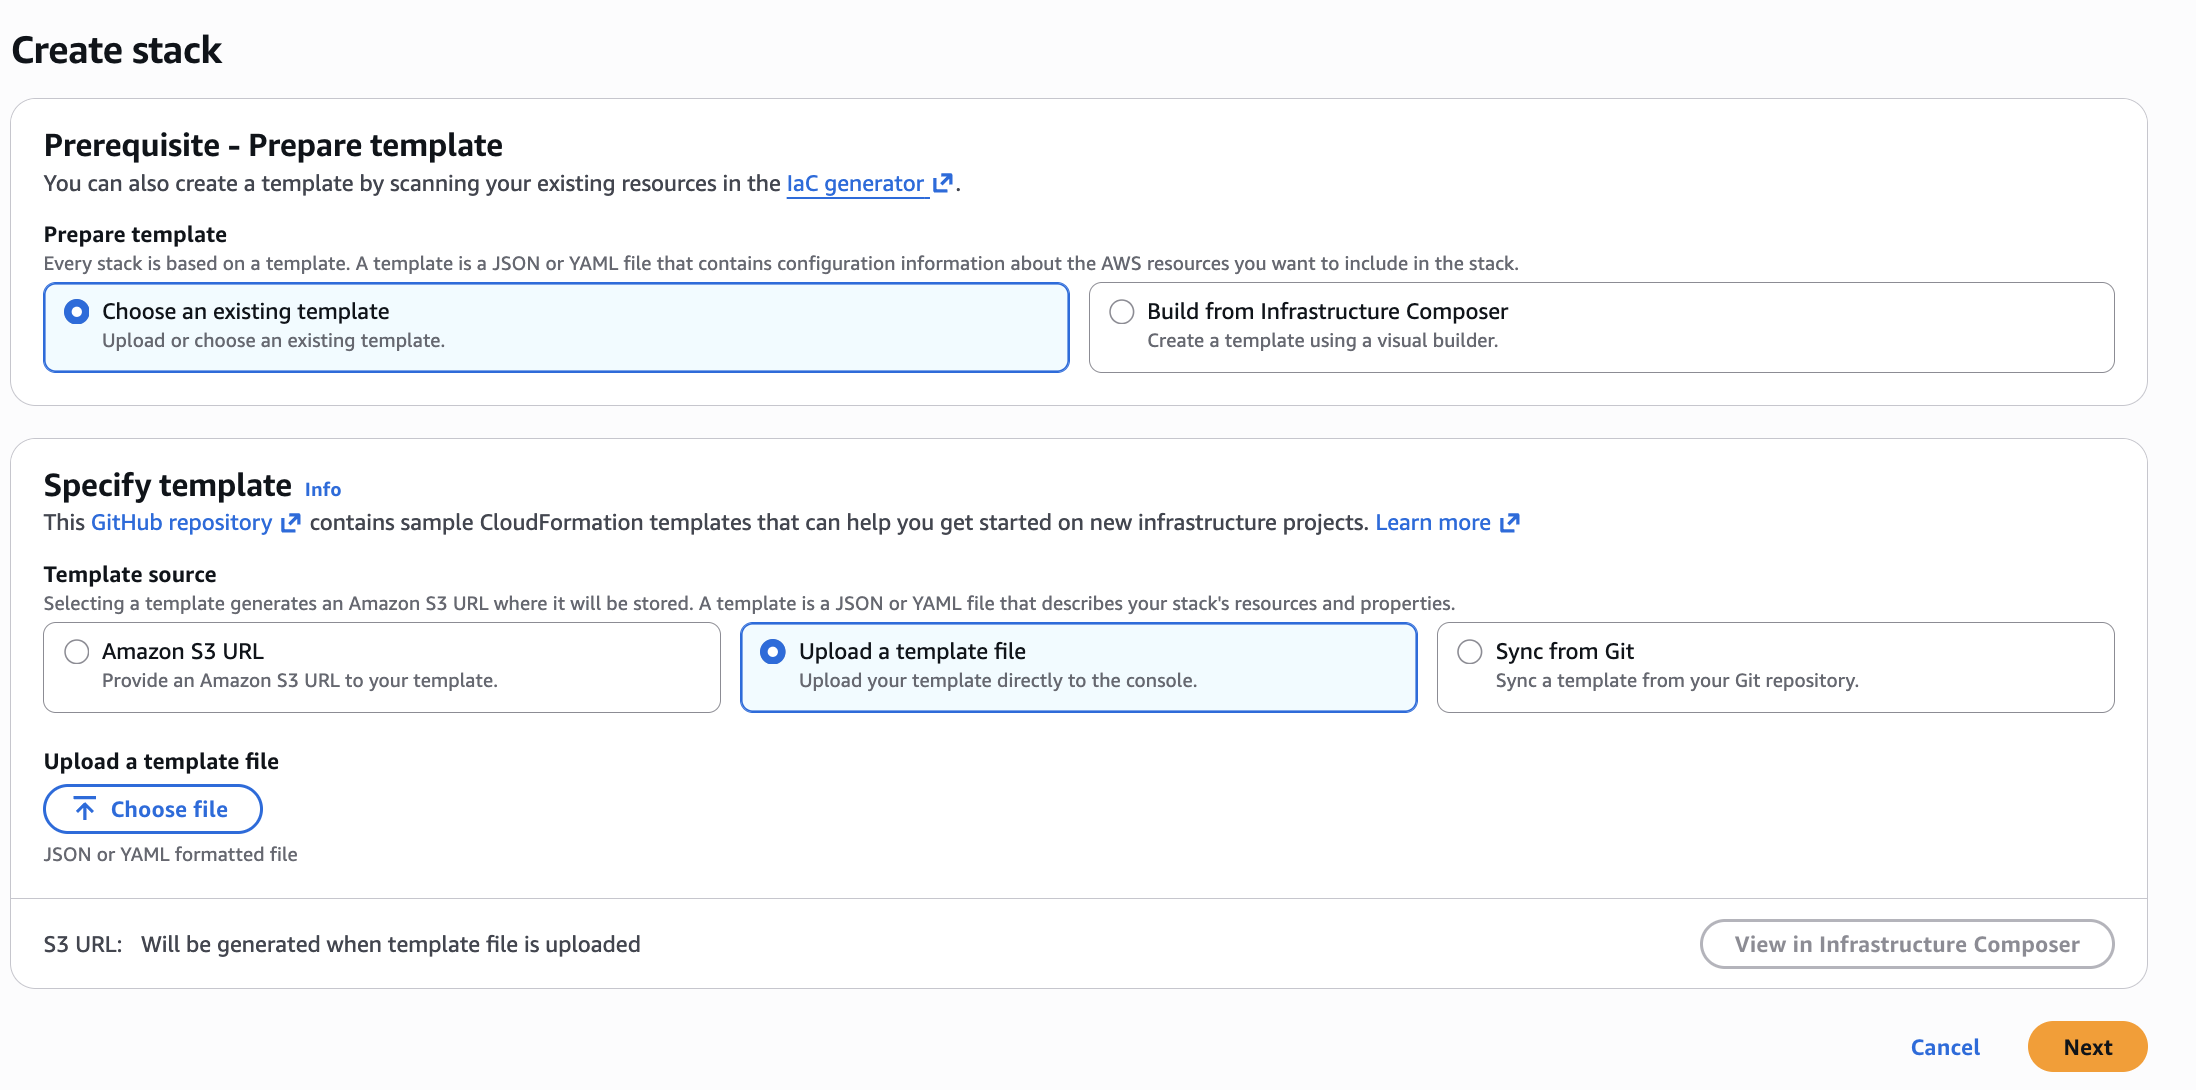
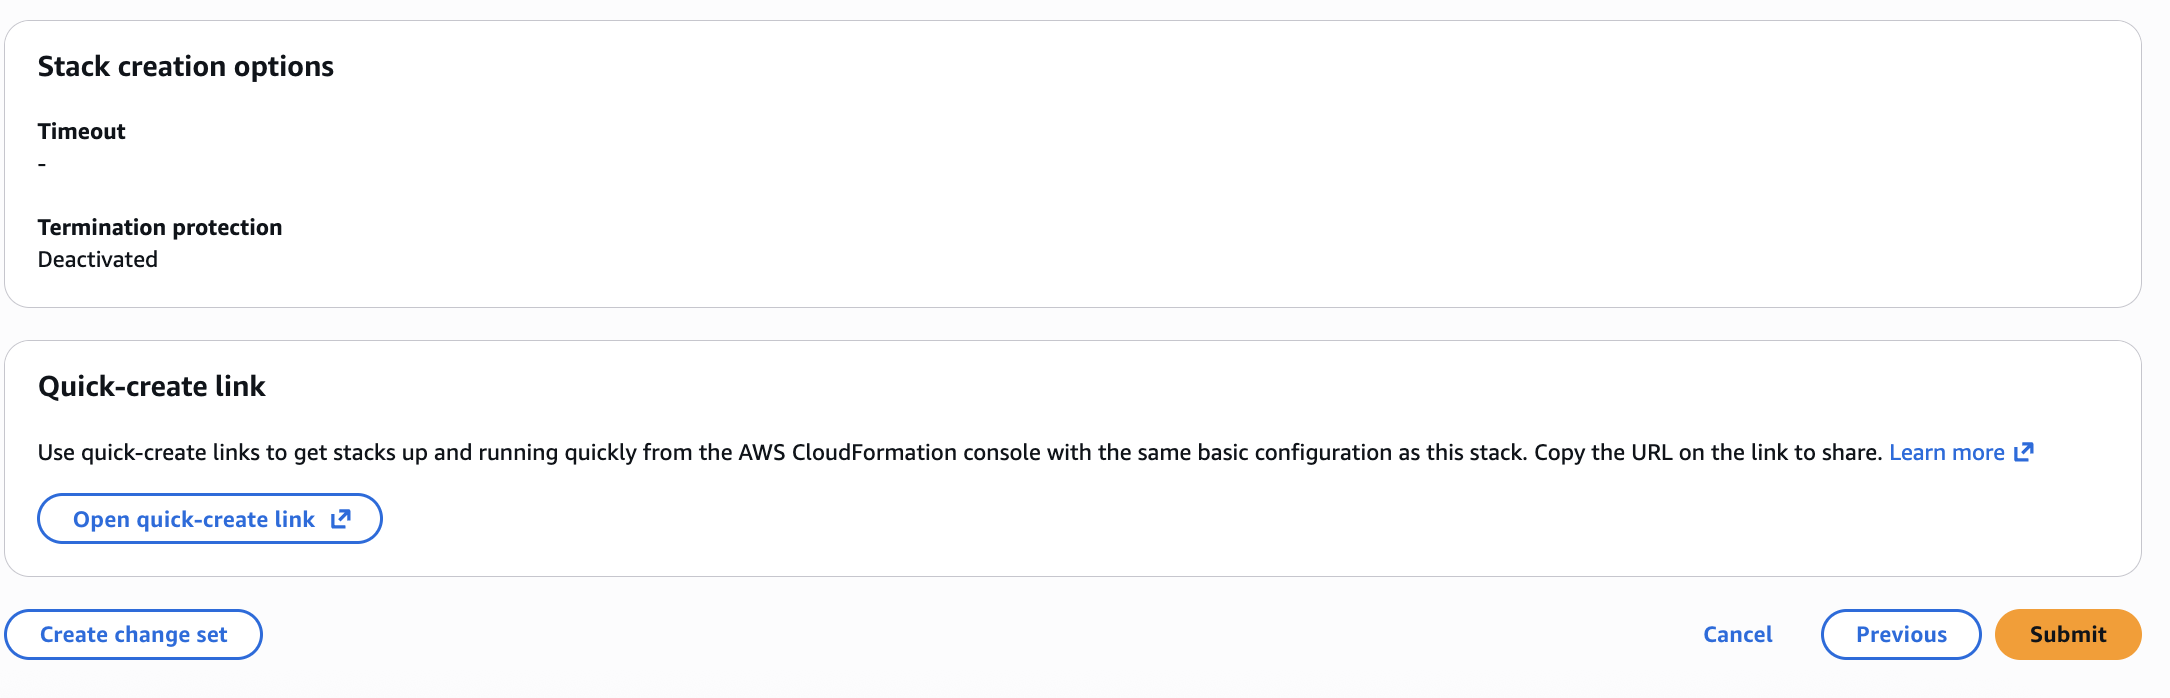
- 创建堆栈。选择 创建堆栈(使用新资源),然后选择现有模板。选择 上传模板文件,选择 opensearch-cfn YAML 文件,然后选择 下一步。 图 6:在创建堆栈页面上传 opensearch-cfn 模板
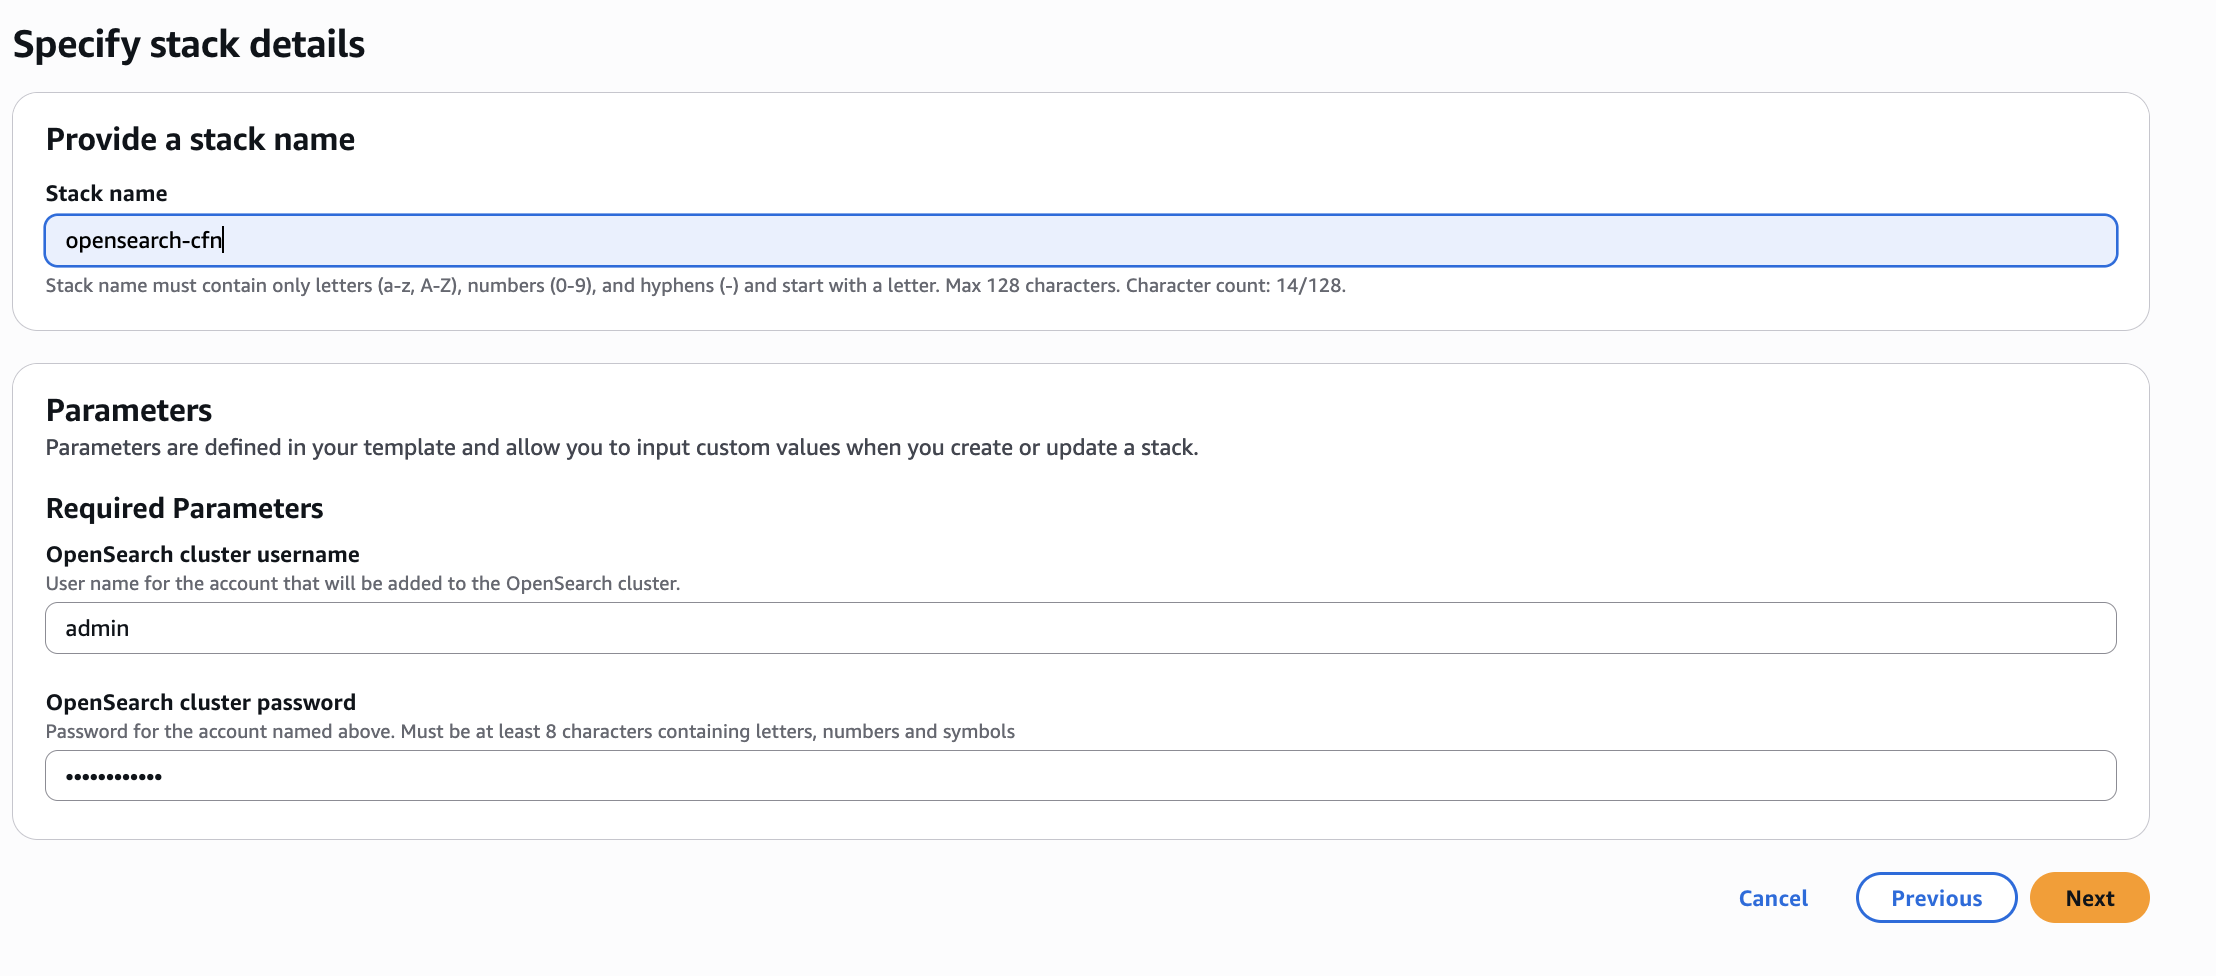
- 配置堆栈选项。对于堆栈名称,输入
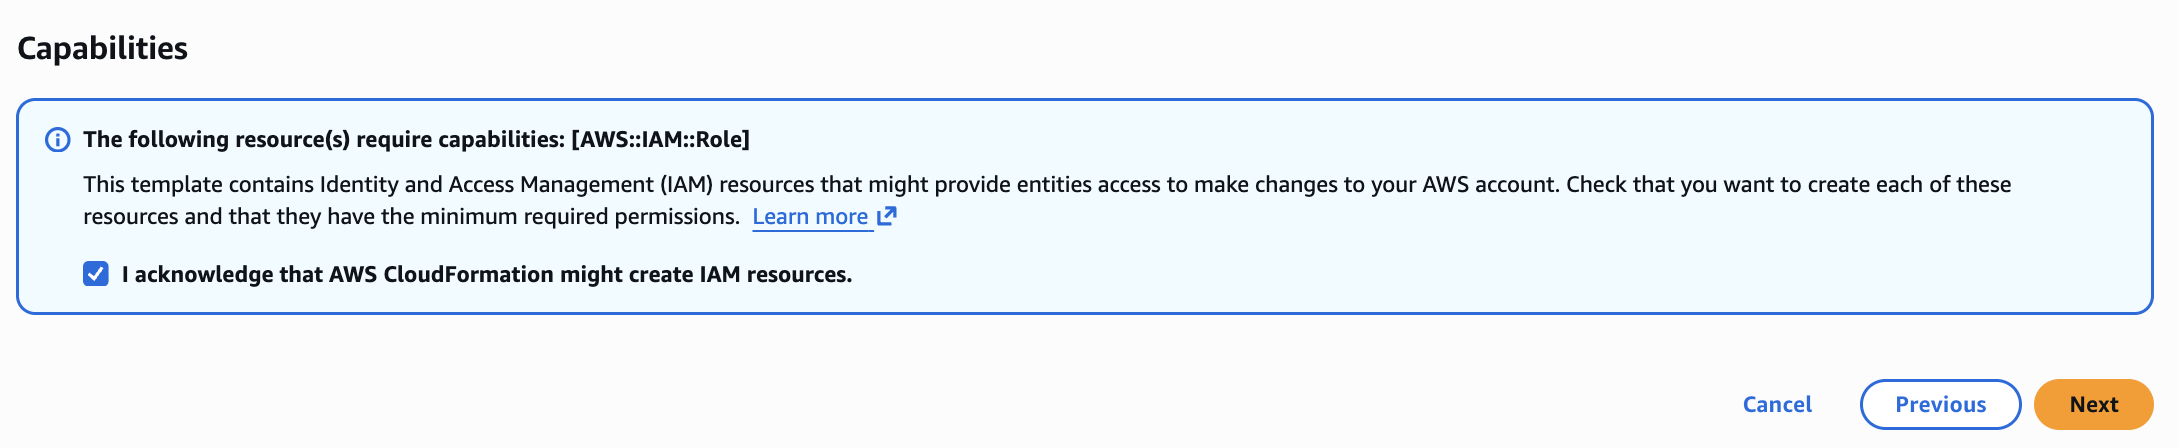
opensearch-cfn,将参数保留为默认值,然后选择 下一步。 图 7:在配置堆栈选项页面输入堆栈名称 - 审核并部署。审核参数摘要,然后滚动到底部并选择 我确认 AWS CloudFormation 可能会创建具有自定义名称的 IAM 资源。选择 下一步,然后选择 提交。 图 8:在审核页面上确认 IAM 资源创建 图 9:审核并提交堆栈 等待堆栈完成,直到其状态变为 CREATE_COMPLETE。
- 以相同方式部署 ETL 堆栈。将堆栈名称设置为
etl,将参数保留为默认值,并等待状态变为 CREATE_COMPLETE。 - 以相同方式部署 agentcore-mcp-server 堆栈。将堆栈名称设置为
agentcore-mcp-server,将参数保留为默认值,并等待状态变为 CREATE_COMPLETE。
使用 SageMaker AI 笔记本
- 打开 SageMaker AI 笔记本。转到 AWS 管理控制台中的 AWS CloudFormation,然后选择 opensearch-cfn 堆栈。
- 选择 输出 选项卡,向下滚动,然后打开 SageMaker AI 笔记本的 URL。
- SageMaker AI 加载后,从左侧菜单中选择 Lab-OpenSearch-Observability.ipnyb 以打开笔记本。
- 按顺序运行每个单元格。为此,请选择该单元格,然后选择播放按钮(向右的三角形)。
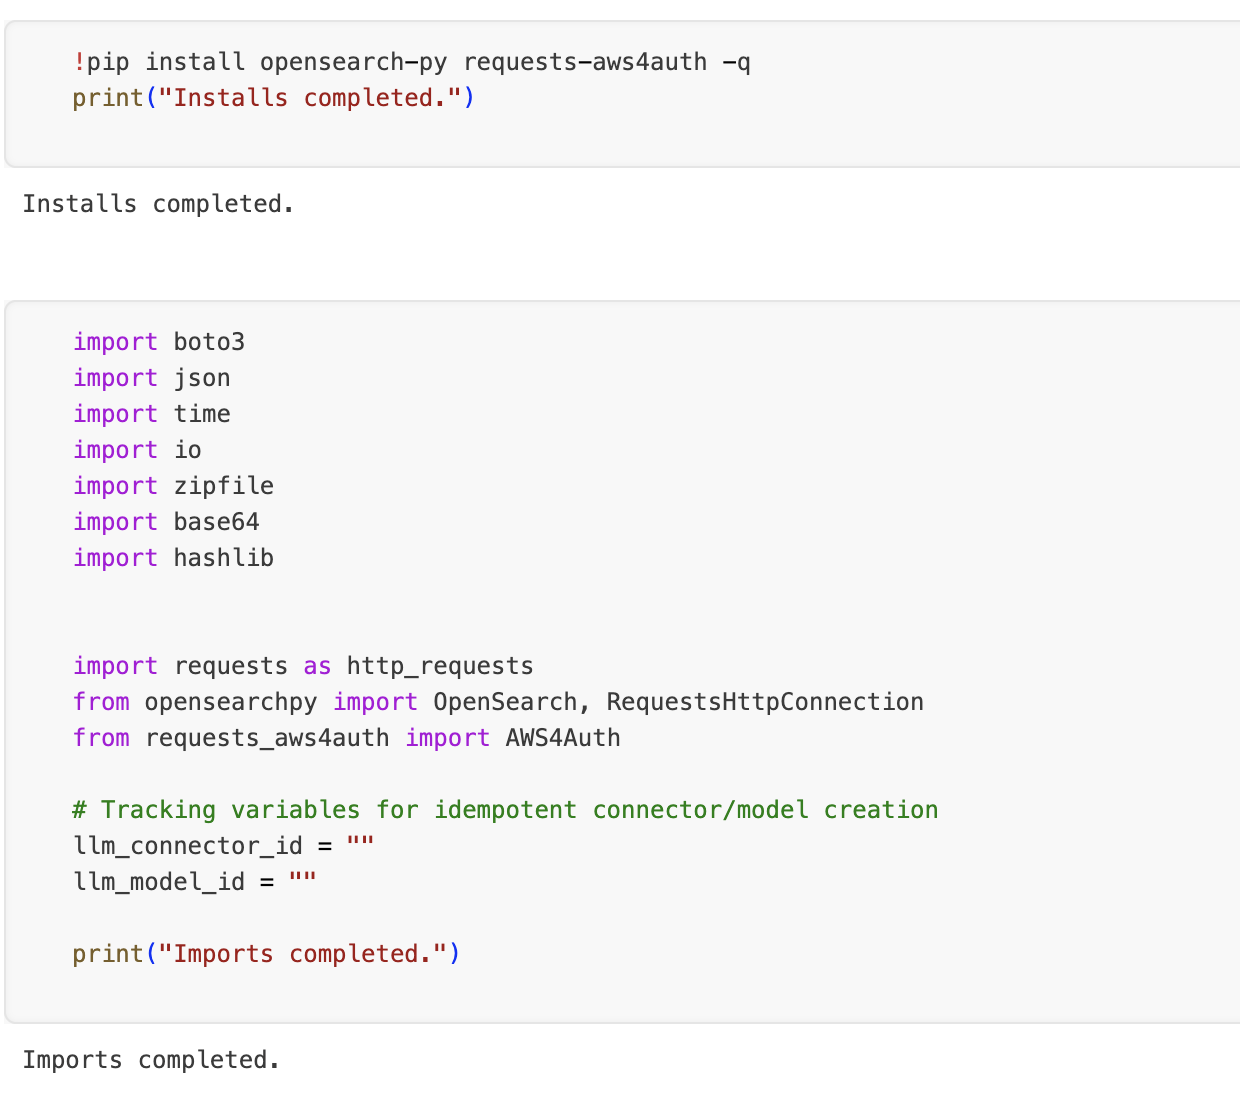
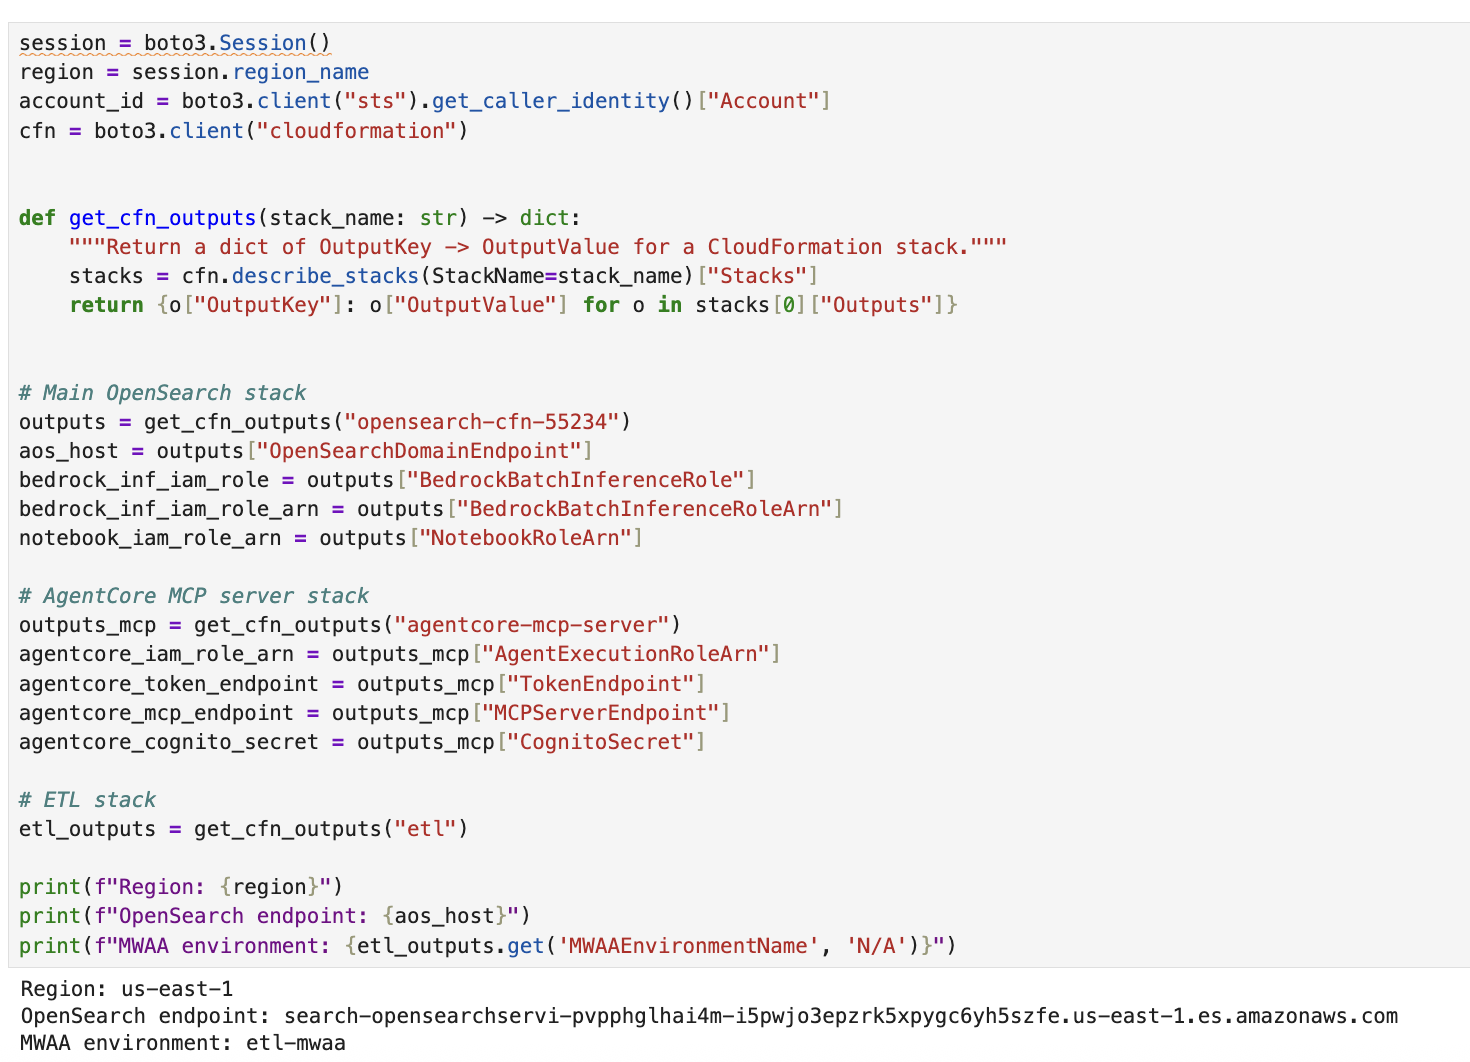
- 完成先决条件。笔记本的第 1 部分加载运行此笔记本中代码所需的 Python 模块。它还检索 CloudFormation 堆栈所创建资源的资源元数据。在进入第 2 部分之前,需要先运行这些单元格。 图 10:加载所需库并导入 Python 模块 图 11:加载 CloudFormation 堆栈输出
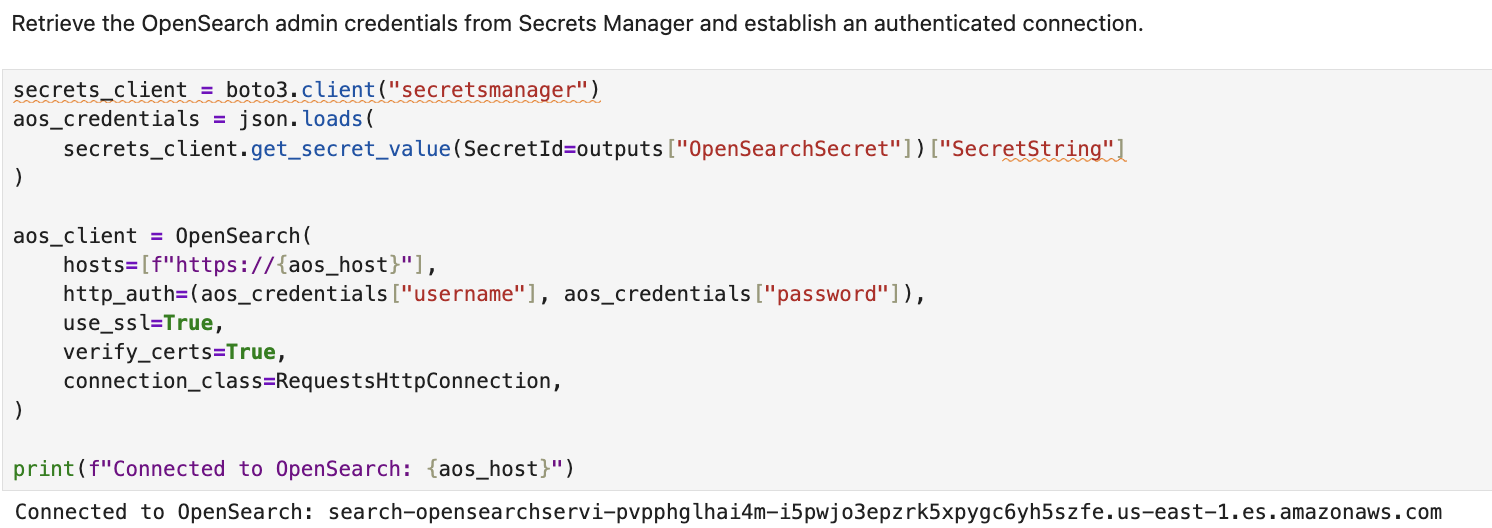
- 第 2 部分:连接到 OpenSearch。 图 12:通过从 Secrets Manager 检索 OpenSearch 管理员凭据进行身份验证 图 13:向笔记本角色和 AgentCore 执行角色授予访问权限 图 14:切换为基于 IAM 的身份验证 图 15:持久保存连接变量,以便在后续单元格和笔记本中使用
- 第 3 部分:将 CloudWatch Logs 流式传输到 OpenSearch。 图 16:创建 Lambda 函数和 CloudWatch 订阅筛选条件,将 ETL 相关日志组流式传输到 OpenSearch 索引 图 17:为 Lambda 函数创建 IAM 角色 图 18:创建 Lambda 函数 图 19:授予 CloudWatch Logs 调用 Lambda 函数的权限 图 20:将 Lambda 执行角色映射到 OpenSearch all_access 角色
- 第 4 部分:触发 ETL DAG。 通过
USE_SERVERLESS标志触发 ETL DAG 并生成日志,以选择您首选的运行时环境。当设置为 False(默认值)时,observability_etl_dagDAG 在预置的 Amazon MWAA 上运行,并行运行 AWS Glue 和 Amazon EC2 任务。当设置为 True 时,observability_blog_aggregationDAG 在 Amazon MWAA Serverless 上运行,执行 AWS Glue 聚合作业。 图 21:触发 ETL DAG 图 22:验证 DAG 已停止运行 图 23:验证日志摄取 - 在 OpenSearch 中创建一个 ML 连接器,该连接器调用 Amazon Bedrock 上的 Anthropic Claude 模型(
us.anthropic.claude-sonnet-4-20250514-v1:0),通过 Converse API 调用,使用 SigV4 身份验证和代入的 IAM 角色。 - 注册并部署该模型,以便 OpenSearch 可将其用于 ML 驱动的功能,例如检索增强生成(RAG)和对话式搜索。
图 24:创建指向 Claude 模型的机器学习连接器
图 25:在 OpenSearch 中注册并部署该模型
第 6 节:向 OpenSearch MCP 服务器注册 AI 代理。
- 安装代理库(
mcp、strands-agents、uv)。 - 加载用于向 AgentCore MCP Server 进行身份验证的 Amazon Cognito 凭证。
- 选择部署模式。选项 A(本地)通过
uvx将 OpenSearch MCP 服务器作为子进程运行,用于开发。
图 26:将 OpenSearch MCP 服务器作为子进程在本地运行
选项 B(AgentCore)使用 OAuth 2.0 客户端凭证连接到 Amazon Bedrock AgentCore 上的生产 MCP 服务器。
图 27:连接到 Amazon Bedrock AgentCore 上的生产 MCP 服务器
d. 创建 ETL 分析代理。
图 28:创建 ETL 分析代理
结果
在 Notebook 的第 7 节中,你可以就 ETL 管道提问。Notebook 中包含一个示例问题:“你在日志中看到什么错误”。尝试提出有关 ETL 管道及相关服务的其他问题。该代理会自主搜索索引、关联事件,并返回错误分析及修复指导。
自然语言查询示例
| 你想查找的内容 | 示例提示 |
| 各来源中的错误 | 向我显示 ERROR 级别的日志 |
| AWS Glue 作业成功日志 | 查找成功完成的 AWS Glue ETL 作业 |
| Amazon EC2 脚本失败 | 向我显示带堆栈跟踪的 Amazon EC2 ETL 脚本错误 |
| Amazon MWAA 任务失败 | 查找失败的 Amazon MWAA DAG 任务 |
| Amazon MWAA Serverless 工作流日志 | 向我显示来自 Amazon MWAA Serverless 聚合工作流的日志 |
| 近期活动 | 向我显示来自任意来源的最近 20 条日志条目 |
| 特定时间范围 | 向我显示过去 30 分钟的日志 |
以下截图显示通过 MCP 客户端向 search_agent 发送自然语言查询,该代理使用多个工具(ListIndexTool、IndexMappingTool、SearchIndexTool)来发现索引、理解意图,并从 pipeline-logs 索引返回结构化发现结果。
图 29:自然语言查询示例以及代理的结构化发现结果
结果
在一次 CloudFormation 部署和五个步骤之后,你就拥有了一个管道:通过并行 ETL 路径处理表格数据、聚合结果,并将运维日志整合到单个可搜索索引中。当出现故障时,你打开一个控制面板,输入你要查找的内容,即可得到答案。无需在多个标签页之间来回切换,无需匹配时间戳,也无需猜测是哪个服务抛出了错误。
Amazon MWAA 用于编排、OpenSearch 用于日志聚合、Amazon Bedrock 用于自然语言访问,三者结合为你提供了一个团队真正会使用的可观测性层,因为它比替代方案更快。
清理
要移除本解决方案中使用的服务,请使用 AWS CloudFormation 控制台删除这三个堆栈,或在 AWS CLI 中运行以下命令:
aws cloudformation delete-stack --stack-name <stack name>这会移除已预置的资源,包括 OpenSearch 域、Amazon MWAA 环境、AWS Glue 作业、Amazon EC2 实例以及关联的 IAM 角色。
结论
多服务 ETL 管道的可观测性并不意味着必须手动拼接多个 CloudWatch 日志组。通过将每个组件的日志流式传输到单个 OpenSearch 索引,并在其前面放置一个 Amazon Bedrock 模型,你就把“我需要找到正确的日志组并编写筛选表达式”变成了“向我显示过去一小时来自 AWS Glue 的错误”。
下一步方向:
- 添加告警:配置 OpenSearch 告警规则,当 ERROR 级别日志超过阈值时,通过 Amazon Simple Notification Service(Amazon SNS)通知你的团队。
- 扩展索引:通过创建新的 CloudWatch 订阅筛选器,添加来自其他组件(AWS Step Functions、AWS Lambda 以及其他 AWS Glue 作业)的日志。
- 构建仪表板:使用 OpenSearch UI 进行可视化,例如随时间变化的错误率、按来源划分的日志量,以及 DAG 触发与作业完成之间的延迟。
- 微调 Amazon Bedrock 模型:调整 ML 连接器中的提示模板以包含你的索引映射,从而提高针对领域特定问题的查询准确性。
- 直接从 OpenSearch UI 使用 OpenSearch Ask AI。
目标很明确:当你的管道失败时,你应该把时间花在修复问题上,而不是寻找问题上。在你自己的环境中尝试该解决方案,并在评论中告诉我们你的想法。
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏