CloudSearch 迁移至 OpenSearch Serverless 指南
有效阅读仅保存在当前浏览器,用于「为你」推荐;暂停或清除记录。
DataHot 速览
这篇 AWS 官方博客介绍如何把 Amazon CloudSearch 域迁移到 Amazon OpenSearch Serverless。文中先评估 CloudSearch 配置,再创建带显式索引映射的 OpenSearch Serverless collection,转换文档和查询、配置安全策略,并用 Amazon OpenSearch Ingestion 载入数据,最后在切换前验证迁移。文章强调 OpenSearch Serverless 的索引与搜索计算可独立扩展,collection 空闲时计算可缩容至零而存储仍需计费,并采用分层安全模型。适用前提包括 AWS 账户、已有 CloudSearch 域、S3 或 DynamoDB 中的源数据、IAM 权限和摄取管道。
为什么值得关注:对使用 AWS 搜索服务的数据团队,这是一份可直接照做的迁移实践,涵盖索引映射、数据摄取、安全策略与切换验证。
本文目录 15 节
译文
AI 逐段翻译如果你在Amazon CloudSearch上运行搜索,现在是规划迁移到Amazon OpenSearch Serverless的时候了。现代搜索已经发展到超越 CloudSearch 所提供的能力:语义搜索和混合搜索、检索增强生成(RAG)以及代理式搜索。OpenSearch Serverless 以按使用量付费的方式自动扩缩容,为你提供所有这些能力。你无需选择或维护基础设施。OpenSearch Serverless 保持了 CloudSearch 那种无需干预、运维简单的特性。
本文介绍如何将你的 CloudSearch 域迁移到Amazon OpenSearch Serverless集合。我们将引导你评估 CloudSearch 配置、创建具有显式索引映射的 OpenSearch Serverless 集合、转换文档和查询、配置安全策略、使用 Amazon OpenSearch Ingestion 加载数据,并在切换之前验证迁移。
需要注意的主要差异
- 独立扩缩容 – OpenSearch Serverless 独立扩展索引计算和搜索计算,并可在集合空闲时将计算容量缩减到零(你仍需为存储付费)。关于成本结构,请参阅管理 Amazon OpenSearch Serverless 的容量限制。
- 分层安全模型 – OpenSearch Serverless 在不同层应用加密、网络和数据访问策略。关于安全模型,请参阅Amazon OpenSearch Serverless 中的安全性。
先决条件
要跟随本文操作,你需要以下内容:
- 一个 AWS 账户。
- 一个现有的、已索引数据的 Amazon CloudSearch 域。
- 源数据存在于持久存储中,例如Amazon Simple Storage Service(Amazon S3)或Amazon DynamoDB(CloudSearch 不提供内置的导出或备份功能,因此需要你的原始源数据来重新摄取到 OpenSearch 中)。
- 创建和管理 Amazon OpenSearch Serverless 集合、加密策略、网络策略和数据访问策略所需的 AWS Identity and Access Management(IAM)权限。
- 用于加载数据的 Amazon OpenSearch Ingestion 管道(或其他摄取方法)。
规划迁移
规划阶段是决定成功标准的阶段:最小停机时间、无数据丢失、保留当前功能以及沿用自定义配置。你无需为基础设施做规划,因为 OpenSearch Serverless 会为你预置和扩展计算资源。你的主要规划任务是评估当前的 CloudSearch 配置,以便在目标端复现其行为。
从 Amazon CloudSearch 控制台记录你现有的设置。记录当前的实例类型、分区数和副本数。记录总文档数和整体数据大小,并记录每个字段定义,包括字段类型以及每个字段的搜索、分面和排序设置。记录任何分析器、同义词、停用词或自定义排名表达式。记录你使用的是 2011 还是 2013 CloudSearch API 版本,因为 2013 API 增加了分面和过滤功能,会改变你为目标的建模方式。
对于大多数 CloudSearch 工作负载,OpenSearch Serverless 是合适的目标,但并非所有工作负载都是如此。如果你的工作负载需要极低的写后读延迟(较短的刷新间隔)、严格且可预测的查询响应时间,或对实例配置的直接控制,请选择Amazon OpenSearch Service 托管集群部署,并根据你的工作负载特征确定其规模。
迁移涉及四个主要方面:源数据格式、查询、字段定义和访问策略。在规划细节之前,先整体了解整个迁移过程会有所帮助。下图将迁移映射到四个阶段:源 CloudSearch 环境、转换并移动数据的迁移管道、OpenSearch Serverless 目标,以及切换和运维。
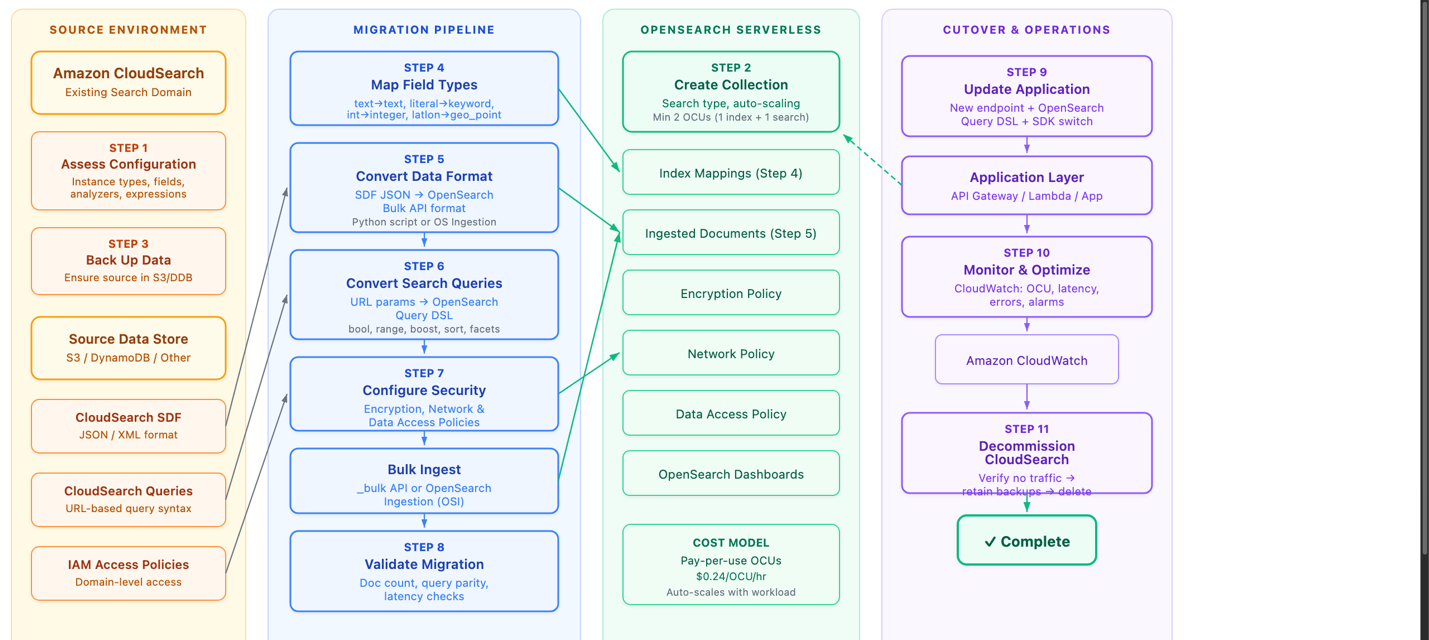
图 1:跨四个阶段的迁移工作流
在源环境中,你评估 CloudSearch 配置并备份源数据(Amazon S3、Amazon DynamoDB 或其他存储)。记录源数据格式(SDF)、基于 URL 的查询语法以及需要沿用的 IAM 访问策略。在迁移管道中,你映射字段类型、将数据格式从 CloudSearch JSON 转换为 OpenSearch 兼容的 JSON、将查询转换为 OpenSearch 查询领域特定语言(DSL)、配置安全、批量摄取数据并验证结果。OpenSearch Serverless 目标包含集合、索引映射、已摄取文档以及加密、网络和数据访问策略,并按按使用量付费的方式随工作负载扩缩容。在切换和运维中,你将应用程序更新到新的终端节点和客户端,使用Amazon CloudWatch进行监控,并在没有流量后停用 CloudSearch。
在 OpenSearch Service 中为数据建模
OpenSearch Service 使用索引映射来定义索引中的字段和数据类型。由于你了解 CloudSearch 架构,请在创建索引时显式定义目标映射。在单个请求中创建索引并设置其映射,并将dynamic设置为strict,以便 OpenSearch 拒绝任何包含你未定义的字段的文档。严格映射会在摄取时捕获架构漂移,避免 OpenSearch 默认为未定义字段创建新映射的行为。
PUT /imdb_movies
{
  "mappings": {
    "dynamic": "strict",
    "properties": {
      "title": {
        "type": "text",
        "fields": {
          "keyword": { "type": "keyword" }
        }
      },
      "genres": { "type": "keyword" },
      "rating": { "type": "float" },
      "release_date": { "type": "date" }
      ...
    }
  }
}
字段类型映射
下表将 CloudSearch 字段类型映射到其 OpenSearch Service 对应类型。
| CloudSearch | OpenSearch Service 对应类型 | 说明 |
| text | text | 文本会被分词。适用于词干提取、同义词和停用词。适合匹配用户词项。 |
| literal | keyword | 不分词。适合精确匹配搜索。 |
| int | integer | 用于排名、分面和缩小范围。 |
| double | float 或 double | 。 |
| date | date | 。 |
| boolean | boolean | 。 |
| latlon | geo_point | 。 |
| text-array | text | OpenSearch 原生支持数组,因此映射到基础 text 类型。 |
| literal-array | keyword | OpenSearch 原生支持数组,因此映射到基础 keyword 类型。 |
| 多值 | 嵌套或对象 | 。 |
| long | long | 。 |
| binary | binary | 。 |
有两个映射细节值得注意。首先,选择适合你数据的最小数值类型,而不是照搬 CloudSearch 使用的宽度。CloudSearch 将整数存储为 64 位值,但很少有数据集包含那么大的数字。一个 long 或一个 double 比一个 integer、一个 short 或一个 float 占用更多磁盘空间,而当值很小时毫无益处。评估每个字段的实际范围,并选择能容纳它的最窄类型。将 long 保留给真正超过 integer 约 21 亿上限的值,并使用 float 而不是 double,除非你需要双精度。更小的类型会缩小你的索引并加快查询速度。
其次,如果你要对 text 字段进行排序或聚合,请添加一个 keyword 子字段。前面的示例映射为 keyword 子字段对应 title 字段。你使用点号表示法访问该字段:title.keyword。OpenSearch 默认不会对经过分析的 text 字段进行排序或聚合。
如前所述,如果你运行多个 CloudSearch 域,请将每个域建模为单个 OpenSearch Serverless 集合内的独立索引,以便整合它们。
迁移你的数据
迁移到 OpenSearch Service 是一次重新摄取:你转换源文档并将它们索引到你创建的集合中。CloudSearch 不提供内置的备份或快照功能。它依赖你通过索引过程发送的文档,因此在迁移之前,请确保你的源数据存储在持久化存储中,例如 Amazon S3、Amazon DynamoDB 或其他数据库。
转换是一种格式翻译。CloudSearch 接受 SDF 格式的数据,可以是 JSON 或 XML,其中文档批次是添加和删除操作的集合。CloudSearch 使用的 JSON 与 OpenSearch Service 期望的 JSON 不同,因此你必须将每个源文档转换为 OpenSearch 文档,其字段与你之前定义的索引映射匹配。处理映射指出的相同细节:输出每个数值,使其适合你为其字段选择的窄类型,而不是宽的 long 或 double,格式化日期以匹配你的 date 映射,并删除或重命名你的严格映射未定义的任何字段。
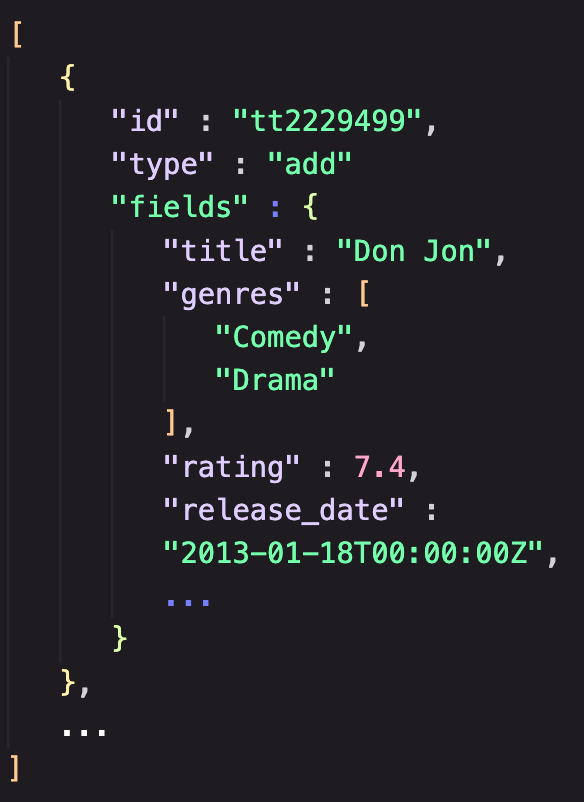
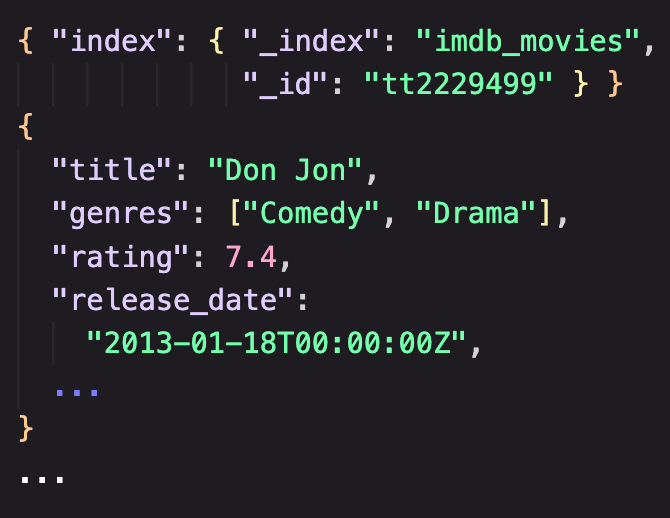
图 2:CloudSearch 批处理格式(左)与 OpenSearch 批处理格式(右)对比
你可以编写一个小型转换脚本。让脚本将其输出写入 Amazon S3 存储桶,以便转换后的文档存放在持久化存储中,你可以根据需要多次重新摄取。
将转换后的文档放入 Amazon S3 后,使用 Amazon OpenSearch Ingestion 来加载它们。Amazon OpenSearch Ingestion 是 Amazon OpenSearch Service 的一项功能,你可以使用它来摄取、过滤、转换、丰富数据并将数据路由到 Amazon OpenSearch Service 域或 OpenSearch Serverless 集合。配置一个带有 Amazon S3 源的 OpenSearch Ingestion 管道(你可以使用 OpenSearch Ingestion 蓝图来入门),以读取你转换后的文档。让它的内置处理器在管道写入你的集合之前应用任何最终转换。从 Amazon S3 读取的托管管道为你提供了可重复、可重启的加载,而无需操作摄取基础设施,这使其成为大多数迁移的推荐路径。
如果你更愿意直接加载数据,OpenSearch Service 公开了 REST API,因此你可以使用标准客户端(如 curl)或使用适用于多种语言的 OpenSearch 客户端库 来索引文档。直接索引对于小型数据集或快速测试很方便,但对于生产迁移,使用 Amazon S3 源配合 OpenSearch Ingestion 是更好的选择。
转换你的查询
CloudSearch 使用基于 URL 的查询格式。你在 URL 中传递查询参数,并提交简单字符串搜索或 JSON 格式的查询。OpenSearch Service 使用 REST API 和请求正文中的 OpenSearch 查询 DSL,这为你提供了复合查询、函数评分和更丰富的相关性控制。你可以使用生成式 AI 编码助手来帮助完成此转换。提供你的 CloudSearch 查询模式,模型会生成等效的 OpenSearch 查询 DSL,然后你根据测试用例进行验证。
查询语法变化
CloudSearch 将诸如 sort 之类的参数附加到查询 URL,而 OpenSearch 将排序、过滤和提升表达为请求正文的显式元素。例如,在 CloudSearch 中搜索标题“shakespeare”如下所示。
https://my-cloudsearch-domain.us-east-1.cloudsearch.amazonaws.com/2013-01-01/search?q=shakespeare&size=10在 OpenSearch Service 中,等效查询使用查询 DSL。
GET /imdb_movies/_search
{
  "query": {
    "match": { "title": "shakespeare" }
  }
}为了使迁移后的结果集保持一致,在 OpenSearch 中将默认运算符设置为 AND,以匹配 CloudSearch 的默认查询行为。下表显示了常见的 CloudSearch 查询模式及其 OpenSearch Service 等效项,使用示例 IMDB 电影数据集。
| 查询类型 | CloudSearch(Lucene 语法) | OpenSearch Service 查询 DSL |
| 复合 AND | title:"Inception" AND genres:"Sci-Fi" | {"query":{"bool":{"must":[{"match":{"title":"Inception"}},{"match":{"genres":"Sci-Fi"}}]}}} |
| 复合 NOT | title:"Star Wars" AND NOT genres:"Comedy" | {"query":{"bool":{"must":[{"match":{"title":"Star Wars"}}],"must_not":[{"match":{"genres":"Comedy"}}]}}} |
| 通配符 | title:Batman* | {"query":{"wildcard":{"title":{"value":"batman*"}}}} |
| 数值范围 | rating:[7 TO 9] | {"query":{"range":{"rating":{"gte":7,"lte":9}}}} |
| 日期范围(之后) | release_date:[2015-01-01T00:00:00Z TO *] | {"query":{"range":{"release_date":{"gte":"2015-01-01T00:00:00Z"}}}} |
| 提升 | title:"The Matrix"^6 OR genres:"Sci-Fi"^4 | {"query":{"bool":{"should":[{"query_string":{"query":"title": \"The Matrix\"^6","fields":["title"]}},{"query_string":{"query":"genres:\"Sci-Fi\"^4","fields":["genres"]}}]}}} |
| 排序 | title:"Batman" sort=release_date desc | {"query":{"match":{"title":"Batman"}},"sort":[{"release_date":{"order":"desc"}}]} |
排序与提升
当您希望某些字段或词项在相关性评分中具有更大权重时,Boosting 就很有用。更高的 boost 值意味着该词项对评分的贡献更大。OpenSearch 还支持按 _score(相关性)排序,当您未指定排序时,这是默认设置。有关完整的查询语言,请参阅 OpenSearch 查询 DSL 文档。
配置安全
CloudSearch 使用 AWS Identity and Access Management 策略来控制对其配置和域服务 API 的访问。您将基于用户的策略附加到 IAM 角色、用户或组,这些策略中的文档、搜索和建议操作控制对 CloudSearch API 的访问。
OpenSearch Serverless 通过多个层面的策略来应用安全。
- 集合:默认情况下静态加密,使用 AWS 拥有的密钥或加密策略中定义的客户托管密钥。
- 网络策略:定义集合是可以通过虚拟私有云(VPC)终端节点私有访问,还是通过互联网访问。
- 数据访问策略:控制哪些 IAM 主体和安全断言标记语言(SAML)身份可以创建索引以及在集合中读取或写入数据。
Amazon OpenSearch Service 预置域也提供精细访问控制,具有基于角色的访问控制以及索引、文档和字段级别的安全性。对于 OpenSearch Serverless,数据访问策略提供集合级和索引级权限,控制哪些 IAM 主体和 SAML 身份可以在集合内创建、读取或写入数据。
验证迁移
验证可在您将生产流量发送到 OpenSearch Serverless 之前确认迁移已完成且正确。请完成五种验证。
- 文档:检查您的文档数量。您的 OpenSearch Serverless 索引应与您的 CloudSearch 索引具有相同的数量。
- 查询:转换您最重要的查询,并针对您的集合手动运行它们。抽查输出中是否存在重要结果。
- 排名:检查结果的顺序,尤其是对于具有自定义排名函数或字段权重的查询。结果可能不会完全匹配,因此请查找任何不正确的内容。
- 延迟:理想情况下,您应该将生产流量分流到您的 Serverless 集合,以获得真实的延迟指标。最坏的情况下,至少在所有查询类型中生成 100,000 个合成查询并运行它们。使用 Amazon CloudWatch 监控 OpenSearch 计算单元(OCU)消耗,以了解您的成本概况。
要验证搜索功能,请对两个系统运行相同的查询并比较结果。重用转换步骤中的查询对,以便直接检验语法差异。例如,要针对示例 IMDB 电影数据集检查数值范围,请在 CloudSearch 中运行以下查询。
https://my-cloudsearch-domain.us-east-1.cloudsearch.amazonaws.com/2013-01-01/search?q=rating: [7 TO 9]&size=10针对您的 OpenSearch Serverless 集合运行等效的查询 DSL。
GET /imdb_movies/_search
{
  "query": {
    "range": { "rating": { "gte": 7, "lte": 9 } }
  }
}
确认两个查询返回相同的电影集。然后对一个检验相关性的查询重复比较,例如转换步骤中的 boosted 查询,并确认顶部结果以相同的顺序出现。
GET /imdb_movies/_search
{
  "query": {
    "bool": {
      "should": [
        { "match": { "title": { "query": "The Matrix", "boost": 6 } } },
        { "match": { "genres": { "query": "Sci-Fi", "boost": 4 } } }
      ]
    }
  }
}
切换和运行
当验证通过时,更新您的应用程序以使用 OpenSearch Serverless 终端节点和查询 DSL,并从 CloudSearch SDK 切换到 OpenSearch 客户端库。切换后,确认没有应用程序仍指向 CloudSearch 终端节点,将源数据备份保留在 Amazon S3 中以备回滚,然后删除 CloudSearch 域。
在生产中运行 OpenSearch Serverless 比运行域更轻松,因为 OpenSearch Serverless 会为您扩展计算,您无需调整分片、实例类型或容量。您的重点转向成本和搜索质量。使用 Amazon CloudWatch 监控 OCU 消耗和搜索延迟,并对您关心的阈值设置告警。查看 OCU 使用模式以了解成本并寻找优化机会,并对集合设置容量限制以限制其可消耗的最大 OCU。有关指导,请参阅 管理 Amazon OpenSearch Serverless 的容量限制 和 监控 Amazon OpenSearch Serverless。
成本考虑因素
使用 OpenSearch Serverless,您只需为您工作负载消耗的计算和存储付费,并且 OpenSearch Serverless 分别对计算和存储收费。OpenSearch Serverless 独立扩展索引计算和搜索计算,因此写入密集型或读取密集型工作负载仅扩展其需要的维度,并且当集合空闲时计算可以扩展到零,在这种情况下您只需为存储付费。要在工作负载之间共享硬件,请将集合放在一个集合组中,以便它们从相同的计算中获取资源,而不是各自预置自己的计算。有关定价和单位详细信息,请参阅 Amazon OpenSearch Service 定价。
清理
因为您正在迁移到 OpenSearch Serverless,您创建的资源很可能会成为您的生产资源。如果不是这样,请删除您创建的任何 OpenSearch Serverless 集合和 S3 存储桶,以避免产生持续成本。
结论
在这篇文章中,您了解了 Amazon CloudSearch 和 Amazon OpenSearch Serverless 的比较,以及您在 CloudSearch 中依赖的概念(字段类型、查询语法、自动扩展和访问控制)如何转换为 OpenSearch Service。您评估您的 CloudSearch 配置,使用显式 OpenSearch 映射对数据进行建模,使用 OpenSearch Ingestion 将转换后的文档移入集合,将基于 URL 的查询转换为 OpenSearch 查询 DSL,配置安全,并在切换前进行验证。OpenSearch Serverless 为您提供与 CloudSearch 一样的免运维运营模式,并增加了更丰富的查询功能、精细的数据访问策略和自动扩展。要开始使用,请在 AWS 管理控制台上创建一个 OpenSearch Serverless 集合,并按照本文中的步骤操作。
要了解更多信息,请参阅以下资源:
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏