构建Claude Code的教训:提示缓存至关重要
DataHot 速览
Anthropic分享了在Claude Code中优化提示缓存的实践,包括如何有效组织提示、使用工具以及分层压缩。Claude Code的整个框架都围绕提示缓存构建,高缓存命中率可降低成本并提高速率限制。文章强调了静态内容在前、动态内容在后的提示结构,以最大化缓存命中,并指出了如时间戳或工具排序变动等可能破坏缓存的问题。
为什么值得关注:该文章聚焦于AI Agent技术实现中的提示缓存优化,与本站五大领域中的Data Agent相关,但话题更偏向模型推理性能而非数据场景,故不收录。
译文
AI 逐段翻译工程中常说“缓存主宰一切”,这个规则同样适用于智能体。
像 Claude Code 这样的长期运行的智能体产品之所以可行,是因为提示缓存 它允许我们复用先前往返的计算,从而显著降低延迟和成本。
在 Claude Code,我们围绕提示缓存构建了整个框架。高提示缓存命中率降低了成本,并帮助我们为订阅计划制定更慷慨的速率限制,因此我们对提示缓存命中率设置警报,如果太低就宣布严重事件。
以下是我们从大规模优化提示缓存中学到的(往往不直观的)经验。
为缓存布置好提示

提示缓存通过前缀匹配工作——API 缓存从请求开始到每个cache_control 断点之间的所有内容。这意味着你放入内容的顺序极其重要,你希望尽可能多的请求共享一个公共前缀。
提示的结构方式不仅影响缓存命中,也影响输出质量——提示工程基础是这一学科的另一半。
最好的做法是先静态内容,后动态内容。对于 Claude Code,结构如下:
- 静态系统提示 & 工具(全局缓存)
- CLAUDE.md(项目内缓存)
- 会话上下文(会话内缓存)
- 对话消息
这样我们就能最大化多个会话共享缓存命中。
但这种方法可能出乎意料地脆弱。我们曾因多种原因破坏过这种顺序,包括:在静态系统提示中放置详细时间戳、非确定性地打乱工具顺序定义、以及更新工具的参数(例如,Agent 工具可以调用哪些代理)。
使用消息进行更新
有时你放入提示中的信息可能会过时,例如你有时间或用户更改了文件。你可能会想更新提示,但那会导致缓存未命中,并可能最终对用户来说非常昂贵。
考虑是否可以改为在代理的下一轮中通过消息传递这些信息。在 Claude Code 中,我们在下一条用户消息或工具结果中添加<system-reminder>标签,附上更新的信息给模型,这有助于保持缓存。
不要在会话中途更换模型
提示缓存是模型独有的,这会让提示缓存的数学运算变得相当不直观。
例如,如果你与 Opus 的对话已有10万token,想问一个相当容易回答的问题,切换到 Haiku 实际上比让 Opus 回答更昂贵,因为我们需要为 Haiku 重建提示缓存。
如果需要切换模型,最好的方式是通过子代理;扩展上面的例子,你可以部署一个子代理,提示 Opus 准备一条“交接”消息给另一个模型,说明需要完成的任务。我们在 Claude Code 的探索代理中经常这样做,它使用 Haiku。
切勿在会话中途添加或移除工具
在对话中途更改工具集是人们破坏提示缓存的最常见方式之一。这看起来很直观——你应该只给模型你认为它当前需要的工具。但由于工具是缓存前缀的一部分,添加或移除工具会使整个对话的缓存失效。
使用计划模式围绕缓存设计
计划模式是围绕缓存约束设计功能的绝佳例子。直观的做法是:当用户进入计划模式时,将工具集替换为只包含只读工具,但那会破坏缓存。
相反,我们始终在请求中保留所有工具,并使用 EnterPlanMode 和 ExitPlanMode 作为工具本身。当用户开启计划模式时,代理会收到一条系统消息,说明它处于计划模式以及指令:探索代码库、不编辑文件、计划完成后调用 ExitPlanMode。工具定义从不改变。
这有一个额外好处:因为 EnterPlanMode 是模型可以自己调用的工具,它可以在检测到难题时自主进入计划模式,而不会破坏缓存。
使用工具搜索延迟加载而不是移除
同样的原则也适用于我们的工具搜索工具。Claude Code 可以加载数十个 MCP 工具,在每个请求中都包含它们会很昂贵,但在对话中途移除它们会破坏缓存。
我们的解决方案:defer_loading。我们不移除工具,而是发送轻量级存根(仅工具名称,带有defer_loading: true),模型可以在需要时通过工具搜索“发现”它们。完整的工具模式只有在模型选择它们时才加载。这保持了缓存的稳定,因为相同的存根总是以相同的顺序存在。
你也可以通过我们的 API 使用工具搜索工具来简化这一点。
在不破坏缓存的情况下压缩
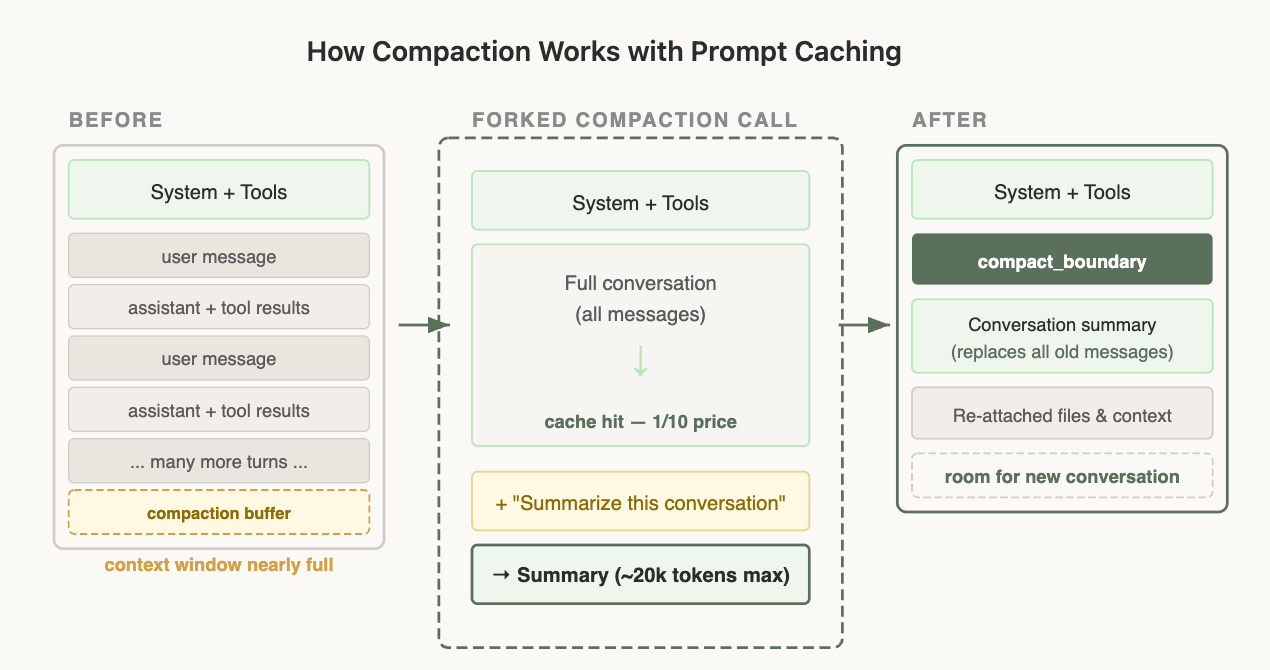
压缩是指当上下文窗口用完时发生的情况。我们总结到目前为止的对话,并用该总结继续新的会话。
压缩与提示缓存的交互方式很容易出错。要压缩对话,您必须将完整对话发送给模型,以便它编写摘要。最简单的方法是使用独立的API调用,带有自己的系统提示(如“总结此内容”)且不附加任何工具,但这正是成本陷阱所在。提示缓存仅在请求的前缀与已缓存的内容从开头逐字节匹配时才适用。您的主对话在一个系统提示和工具集下被缓存;而摘要调用使用不同的系统提示且无工具,因此前缀在第一个标记处就分道扬镳,缓存完全不适用。最终,您将为发送的整个对话支付完整的、未缓存的输入费率——而对话越长(即您首先需要压缩的程度越大),这一次调用的成本就越高。
解决方案:缓存安全的分叉
当我们执行压缩时,我们使用与父对话完全相同的系统提示、用户上下文、系统上下文和工具定义。我们前置父对话的消息,然后在末尾附加压缩提示作为新的用户消息。
从API的角度来看,此请求看起来与父对话的上一个请求几乎相同——相同的前缀、相同的工具、相同的历史——因此缓存的前缀被重用。唯一的新令牌是压缩提示本身。
但这意味着我们需要保存一个“压缩缓冲区”,以便在上下文窗口中有足够的空间容纳压缩消息和摘要输出令牌。
压缩很棘手,但幸运的是,您不必自己学习这些教训——基于我们从Claude Code中学到的经验,我们将压缩直接内置到API中,以便您可以在自己的应用程序中应用这些模式。
经验教训
以下是我们发现在构建代理时优化提示缓存的一些有用模式:
- 提示缓存是前缀匹配。前缀中的任何更改都会使之后的所有内容失效。围绕此约束设计整个系统。正确排序,大部分缓存将自动生效。
- 使用消息而不是系统提示更改。您可能倾向于编辑系统提示以执行诸如进入计划模式、更改日期等操作,但更好的做法是在对话期间将这些插入到消息中。
- 不要在对话中途更改工具或模型。使用工具来建模状态转换(如计划模式),而不是更改工具集。延迟加载工具而不是移除工具。
- 像监控正常运行时间一样监控缓存命中率。我们对缓存破坏发出警报并将其视为事故。几个百分点的缓存未命中率会显著影响成本和延迟。
- 分叉操作需要共享父对话的前缀。如果您需要运行侧计算(压缩、摘要、技能执行),请使用相同的缓存安全参数,以便在父对话的前缀上获得缓存命中。
Claude Code从第一天起就围绕提示缓存构建;为了在构建代理时获得最佳效果,我们建议您也这样做。
立即开始使用Claude Code。
本文由Thariq Shihipar撰写,他是Claude Code团队的技术人员。
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏