Amazon EMR 8.1.0 支持多目录跨账户跨格式查询
DataHot 速览
Amazon EMR 8.1.0 推出 multi-catalog 支持,通过 RedirectingSessionCatalog(RSC)作为 Spark 默认 catalog,自动从 AWS Glue 元数据识别表格式并路由到对应处理器。它允许在单一统一 catalog 中查询 Iceberg、Hudi、Delta Lake 和 Hive 表,并支持跨 AWS 账户访问多个 AWS Glue Data Catalog。用户无需复制数据即可跨账户 join 表,并可在查询时动态发现远程 catalog。该方案面向数据网格中域团队分散持有数据、分析集中运行的常见场景。
为什么值得关注:对使用 AWS EMR 与 Glue 的数据平台团队,它直接解决多开放表格式和多账户数据网格下的统一查询与跨账户 join 痛点,减少数据拷贝和复杂权限变通。
本文目录 14 节
译文
AI 逐段翻译AWS 上的分析团队通常将数据存储在不止一种开放表格式中,而这些数据又往往分布在不止一个 AWS 账户中。由此带来两个问题:跨表格式查询而不增加目录层面的复杂性,以及跨账户联接数据而不复制数据。这在数据网格中很常见,其中各领域团队在各自独立的 AWS 账户中拥有数据,而分析工作负载集中运行。Amazon EMR 8.1.0 中的多目录支持同时解决了这两个问题。
Amazon EMR 8.1.0 版本通过多目录支持同时应对这两项挑战。RedirectingSessionCatalog (RSC) 是一个可选择启用的目录,你可以将其设置为 Spark 默认目录。它从 AWS Glue 元数据中自动检测每张表的格式,将查询路由到正确的格式处理器,并支持跨 AWS 账户的多个 AWS Glue Data Catalog。借助多目录支持,你可以通过单一统一目录查询 Iceberg、Hudi、Delta Lake 和 Hive 表。你还可以跨 AWS 账户联接表而无需复制数据,并在查询时动态发现远程目录。
在本文中,我们展示如何使用 Amazon EMR Serverless 将这些能力付诸实践。
Spark 单目录约束
多种格式。 Spark 默认目录(spark_catalog)一次只接受一个 CatalogExtension:用于 Iceberg 的 SparkSessionCatalog、用于 Delta Lake 的 DeltaCatalog,或用于 Hudi 的 HoodieCatalog。你配置其中一个,而针对其他格式表的查询就会失败,除非这些表注册在单独的、特定格式的目录中。
多个账户。 Spark V1 元存储(ExternalCatalog)是一个单例,绑定到某一个账户中的某一个 AWS Glue Data Catalog。Spark V2 目录 API 支持命名目录,但只有 Iceberg 使用它。Delta Lake、Hudi 和 Hive 表仍然依赖 V1。因此,这些格式的跨账户访问需要复杂的多步骤变通方案。这些方案包括 AWS Lake Formation 授权、AWS Resource Access Manager (AWS RAM) 共享、资源链接以及逐表权限。
Amazon EMR 8.1.0 通过 RedirectingSessionCatalog 解决了这两项约束,下一节将对此进行介绍。
RedirectingSessionCatalog
RedirectingSessionCatalog 提供三项可选择启用且向后兼容的能力。将 RSC 设置为默认目录,即可运行多格式查询而无需特定格式前缀。声明一个命名 RSC 目录,即可跨账户联接而无需复制数据。开启 AWS Glue Data Catalog 解析器,即可在查询时发现并注册远程目录,无需预先进行 spark.sql.catalog.* 配置。以下各节将逐一介绍每项能力。
多格式支持
在 Amazon EMR 8.1.0 中,你将默认目录设置为 RedirectingSessionCatalog (RSC)。在解析表时,RSC 会调用 AWS Glue Data Catalog,从表的元数据中读取其格式,缓存结果,并委派给匹配的特定格式目录(Iceberg、Delta Lake、Hudi 或 Hive)。
没有此功能时,你必须为每种格式注册单独的目录,并为每个表引用添加前缀:
# One catalog per format, all pointing at the same Glue metastore
spark.sql.catalog.spark_catalog = org.apache.iceberg.spark.SparkSessionCatalog
spark.sql.catalog.delta_catalog = org.apache.spark.sql.delta.catalog.DeltaCatalog
spark.sql.catalog.hudi_catalog = org.apache.spark.sql.hudi.catalog.HoodieCatalog

# Queries must use format-specific catalog prefixes
SELECT * FROM spark_catalog.db.iceberg_table;
SELECT * FROM delta_catalog.db.delta_table;
SELECT * FROM hudi_catalog.db.hudi_table;
有了多格式支持,这减少为一个目录属性:
你设置的内容:
# Replace the default catalog with RedirectingSessionCatalog.
# RSC auto-detects each table's format from Glue metadata.
spark.sql.catalog.spark_catalog = org.apache.spark.sql.connector.catalog.\
redirecting.RedirectingSessionCatalog
你查询的方式:
-- No format prefixes needed. RSC resolves the format at query time.
SELECT * FROM db.iceberg_table;
SELECT * FROM db.delta_table;
SELECT * FROM db.hudi_table;

-- Cross-format joins work in a single statement.
SELECT i.id, d.val, h.val
FROM db.iceberg_table i
JOIN db.delta_table d ON i.id = d.id
JOIN db.hudi_table h ON i.id = h.id;
在解析表时,RSC 会:
- 调用 AWS Glue Data Catalog 以读取表元数据。
- 检查表的 Parameters 映射以确定格式(Iceberg、Delta Lake、Hudi 或 Hive/Parquet)。
- 将操作委派给相应的特定格式目录实现。
下图展示了单个查询如何流经 RedirectingSessionCatalog 到达正确的格式处理器。
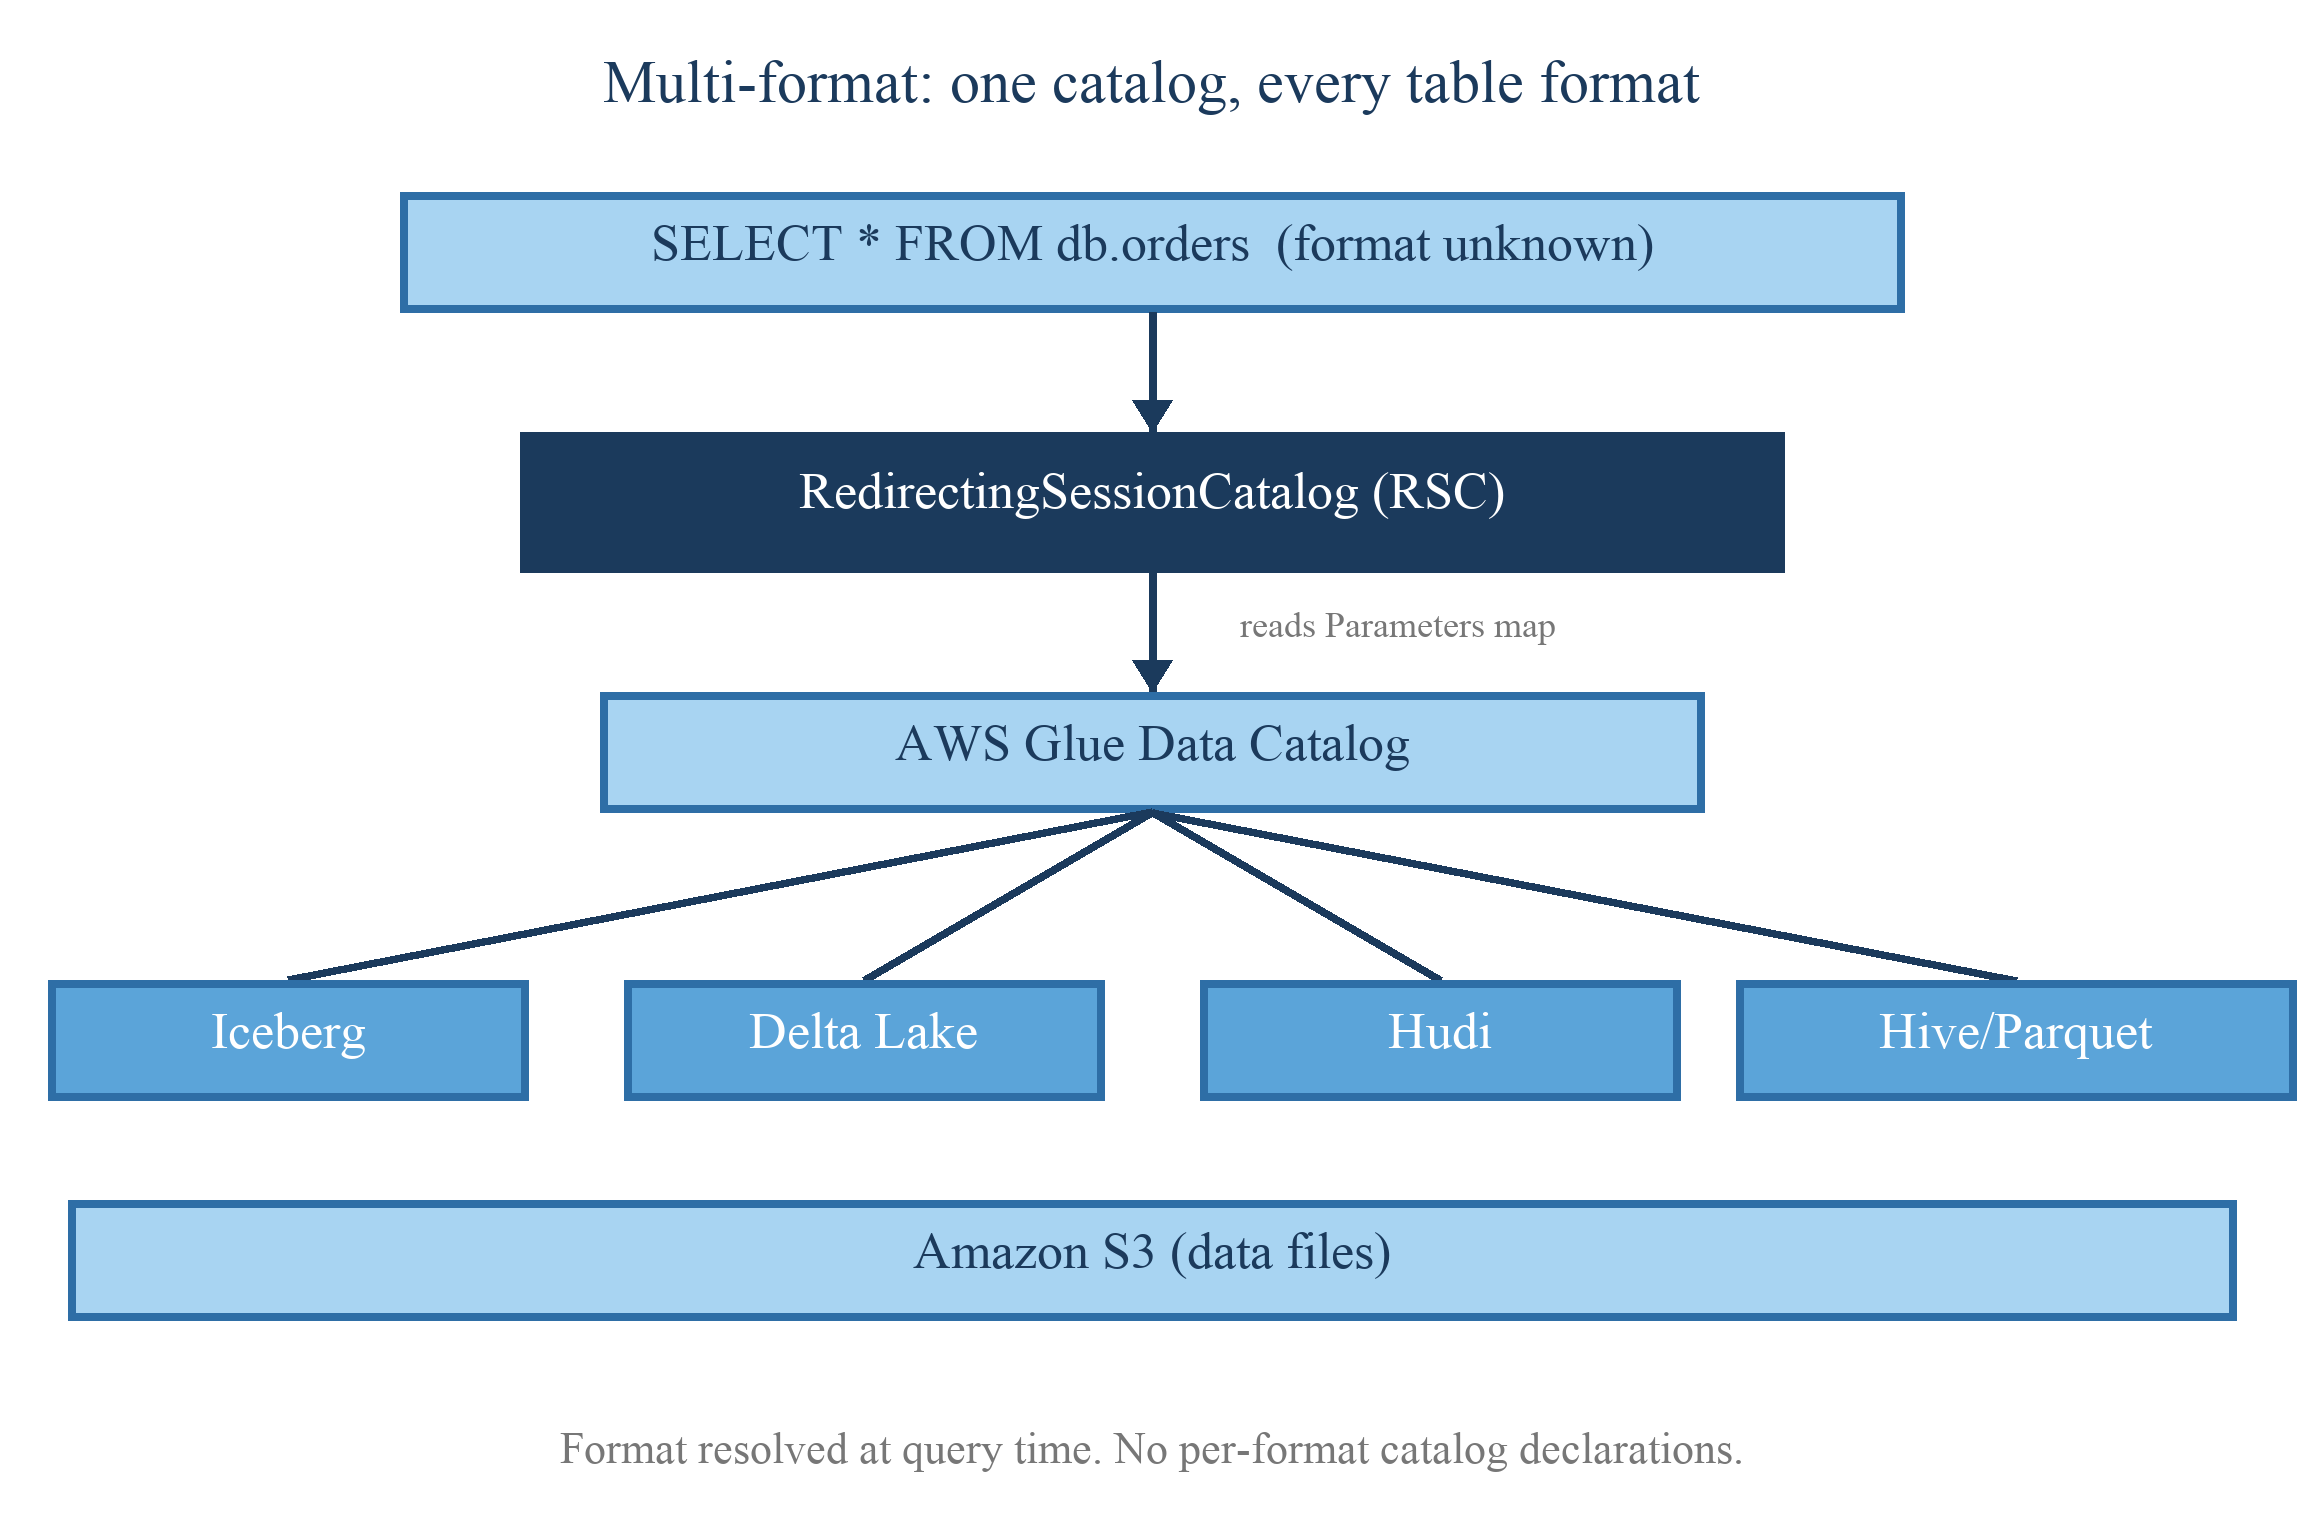
图 1:多格式路由。单个查询进入 RedirectingSessionCatalog,后者调用 AWS Glue Data Catalog 读取每张表的格式,然后将该表路由到匹配的特定格式处理器(Iceberg、Delta Lake、Hudi 或 Hive),以便结果通过一个目录返回
如图所示,查询通过 spark_catalog(即 RSC)进入。RSC 从 AWS Glue Data Catalog 读取每张表的格式,并将操作路由到匹配的引擎:Iceberg、Delta Lake、Hudi 或 Hive/Parquet。这四个格式处理器从 Amazon Simple Storage Service (Amazon S3) 读取底层数据文件。调用方发出一个查询,无需特定格式的目录前缀。
多目录:跨账户访问
当生产数据与你的分析计算位于不同的 AWS 账户时,你可以声明一个命名 RSC 目录,指向该账户的 AWS Glue Data Catalog。RSC 解析远程账户中表的方式与解析本地表相同,因此单个查询可以跨账户联接而无需复制数据。
此前,跨账户表解析仅适用于 Iceberg(V2 目录)。另一账户中的 Hive、Delta Lake 和 Hudi 表需要手动配置 Lake Formation 和 AWS RAM,而不是目录级解析。使用 Amazon EMR 8.1.0,你可以为远程账户声明一个命名 RSC 目录:
配置:
# Declare a named catalog pointing at the remote account's Glue catalog.
# "prod" is any name you choose for this catalog.
spark.sql.catalog.prod = org.apache.spark.sql.connector.catalog.\
redirecting.RedirectingSessionCatalog

# Tell it to use Glue as the metastore backend.
spark.sql.catalog.prod.metastore.type = glue

# Point it at the remote account's Glue catalog ID.
spark.sql.catalog.prod.metastore.hadoop.hive.metastore.glue.catalogid = 111122223333
查询:
-- Join local and remote tables directly. No data copy.
SELECT o.order_id, f.status
FROM spark_catalog.analytics.orders o -- local Iceberg table
JOIN prod.salesdb.fulfillment f -- remote Hudi table (account 111122223333)
ON o.order_id = f.order_id;
每个命名 RSC 实例都会创建自己的 V1 元存储委托,并将其注册到全局 SessionCatalog,从而消除了单例限制。
下图展示了单个查询如何通过命名目录跨两个 AWS 账户联接表。
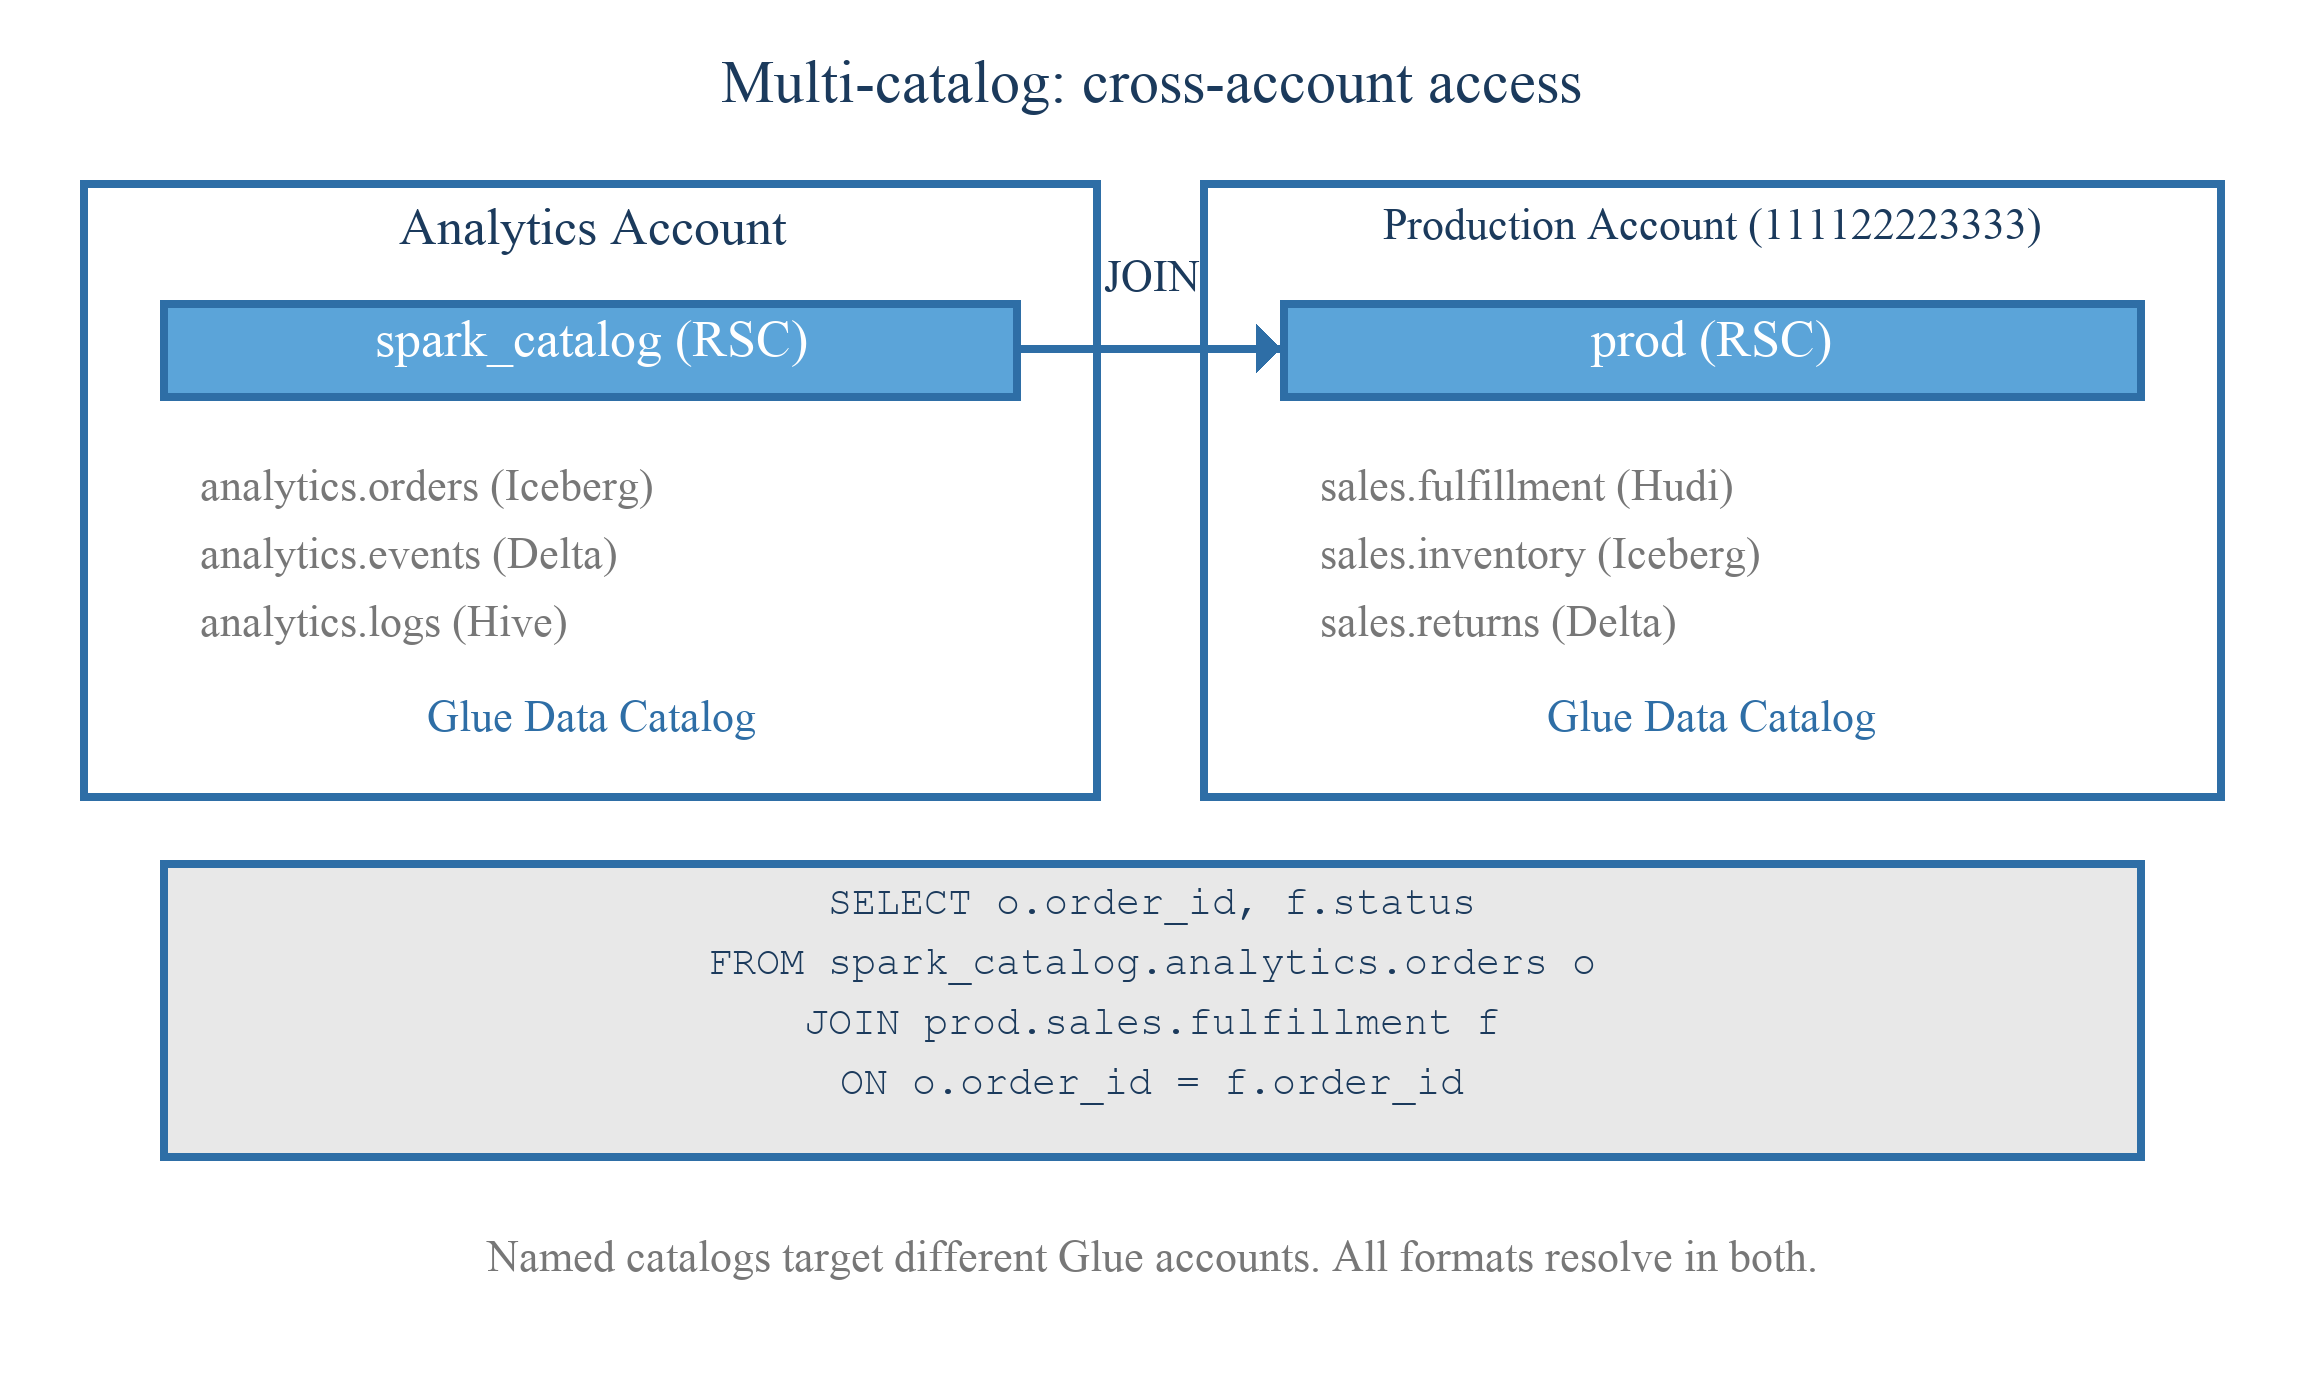
图 2:跨账户访问。本地账户中的查询引用一个命名 RSC 目录,该目录指向第二个账户的 AWS Glue Data Catalog,因此本地表和远程表可在一次查询中联接,而无需在账户之间复制数据
如图所示,分析账户使用 spark_catalog(即 RSC)访问其本地 Glue Data Catalog,而一个命名目录(prod)指向生产账户的 Glue Data Catalog。该查询在单条语句中将本地表与远程表联接,如两个账户之间的 JOIN 所示。每个账户保留自己的 Glue Data Catalog,账户之间不复制任何数据。
自动装配
前面的多目录设置要求你在 spark.sql.catalog.* 属性中预先声明每个远程目录。Amazon EMR 8.1.0 中的自动装配在两个层面消除了这一要求。
在 Amazon EMR 8.1.0 之前,你需要显式声明解析器、每种格式的处理器以及每个处理器的委托类:
# Declare the resolver, a per-format handler, and each handler's delegate catalog
spark.sql.catalog.spark_catalog.table-format-resolver = \
com.amazonaws.glue.catalog.redirecting.GlueTableFormatResolver
spark.sql.catalog.spark_catalog.handler.iceberg = \
org.apache.spark.sql.connector.catalog.redirecting.DefaultTableFormatCatalogHandler
spark.sql.catalog.spark_catalog.handler.delta = \
org.apache.spark.sql.connector.catalog.redirecting.DefaultTableFormatCatalogHandler
spark.sql.catalog.spark_catalog.handler.hudi = \
org.apache.spark.sql.connector.catalog.redirecting.DefaultTableFormatCatalogHandler
spark.sql.catalog.spark_catalog.iceberg.delegate-class = org.apache.iceberg.spark.SparkCatalog
spark.sql.catalog.spark_catalog.iceberg.catalog-impl = org.apache.iceberg.aws.glue.GlueCatalog
spark.sql.catalog.spark_catalog.delta.delegate-class = \
org.apache.spark.sql.delta.catalog.DeltaCatalog
spark.sql.catalog.spark_catalog.hudi.delegate-class = \
org.apache.spark.sql.hudi.catalog.HoodieCatalog

# Manually declare every remote catalog you might query
spark.sql.catalog.prod = ...RedirectingSessionCatalog
spark.sql.catalog.prod.metastore.type = glue
spark.sql.catalog.prod.metastore.hadoop.hive.metastore.glue.catalogid = 111122223333
spark.sql.catalog.staging = ...RedirectingSessionCatalog
spark.sql.catalog.staging.metastore.type = glue
spark.sql.catalog.staging.metastore.hadoop.hive.metastore.glue.catalogid = 444455556666
自动装配将其简化为:
配置:
# Set the default catalog. EMR auto-registers Iceberg, Delta, Hudi handlers.
# No handler.* properties needed.
spark.sql.catalog.spark_catalog = org.apache.spark.sql.connector.catalog.\
redirecting.RedirectingSessionCatalog

# Enable catalog discovery. The resolver inspects the connection type and
# registers the catalog at query time, with no upfront spark.sql.catalog.* config.
spark.sql.catalogResolver = com.amazonaws.glue.catalog.\
redirecting.GlueCatalogResolver

# Optional. Falls back to the SDK default region chain. Set this to query Glue catalogs in a specific region.
spark.sql.catalogResolver.region = us-east-1
查询:
-- Reference a remote catalog by its account ID. No prior declaration exists.
-- EMR calls Glue GetCatalog, determines the type, registers it on the spot.
SELECT o.order_id, f.status
FROM spark_catalog.analytics.orders o
JOIN `111122223333`.sales.fulfillment f
ON o.order_id = f.order_id;
AWS Glue Data Catalog 解析器采用选择加入方式。启用后,每当查询引用尚未注册的目录时,Amazon EMR 都会发出一次 AWS Glue GetCatalog API 调用。默认情况下不启用此功能,以避免对不存在的目录名称发出意外的 API 调用。
在处理器层面,将默认目录设置为 RedirectingSessionCatalog 即可。Amazon EMR 会自动填充 Iceberg、Delta 和 Hudi 处理器,因此你无需编写 handler.* 属性。
在目录层面,当你启用 Glue 目录解析器时,Amazon EMR 会按需发现新目录。当查询首次引用未声明的目录时,Amazon EMR 会调用 AWS Glue GetCatalog API,检查连接类型,并在查询时注册该目录。
动态发现在 Amazon EMR 8.1.0 中对三种目录类型可用。对于标准跨账户 AWS Glue 目录,解析器会注册一个重定向目录,并应用多格式路由。对于 Amazon S3 Tables(Amazon S3 的一项能力),解析器会读取联邦 AWS Glue 元数据,并通过 Iceberg 进行读写路由。它还支持 Amazon Redshift Managed Storage。
下图展示了 GlueCatalogResolver 如何在查询首次引用目录时发现并注册它。
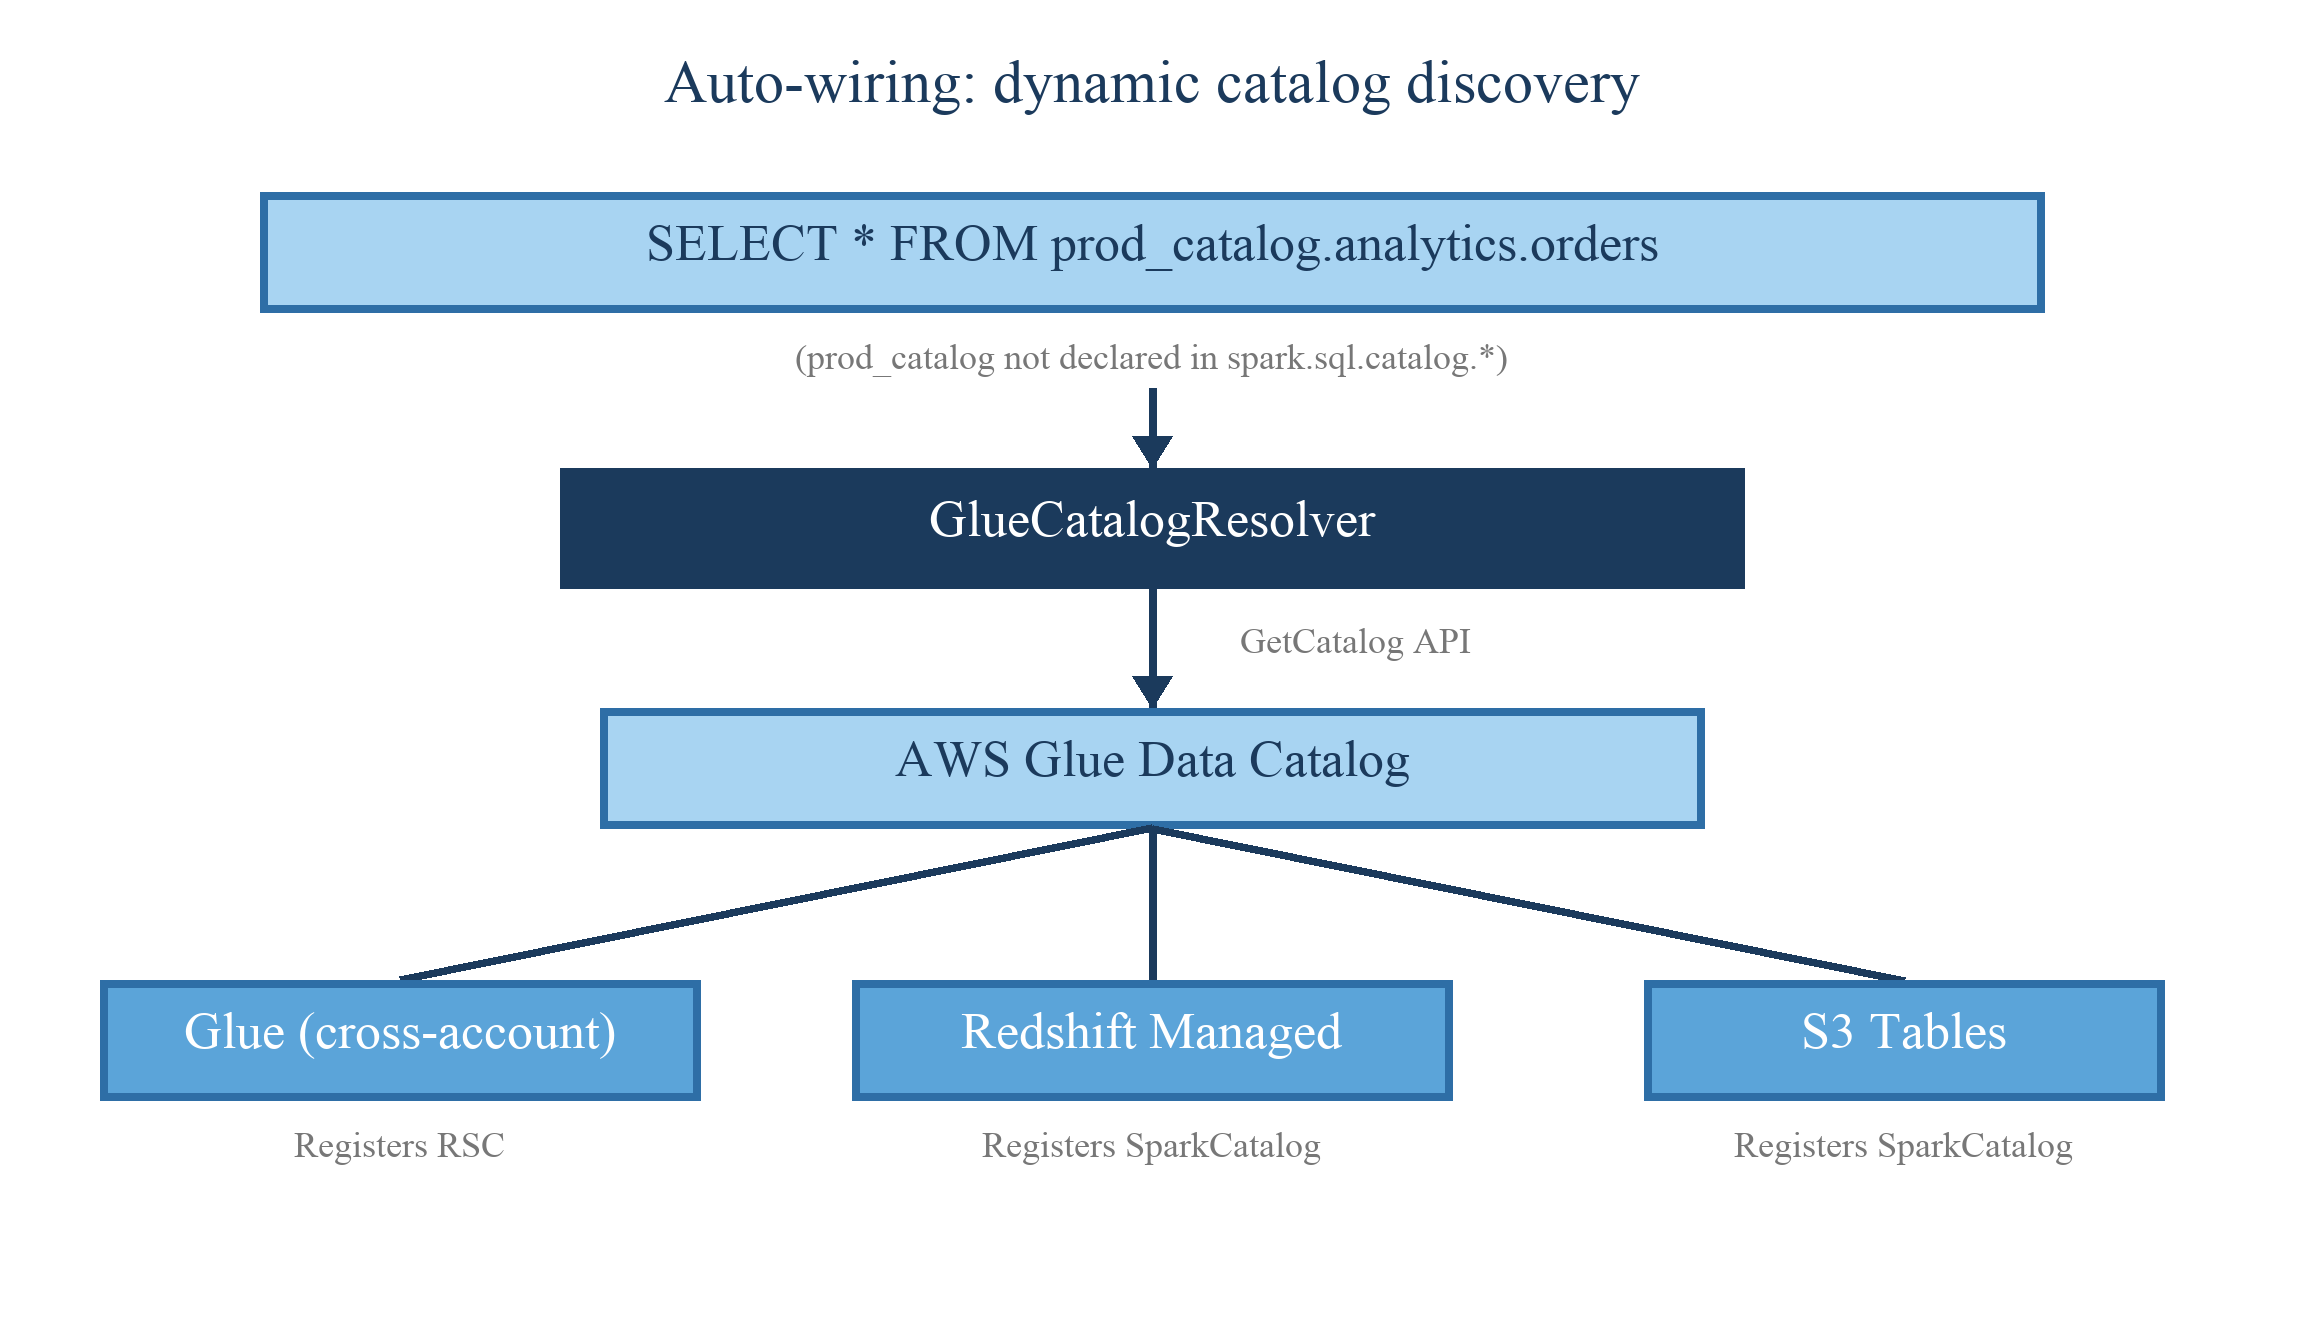
图 3:自动装配。当查询引用未声明的目录时,Glue 目录解析器会调用 AWS Glue GetCatalog API,检查连接类型,并在查询时注册该目录,因此无需预先进行目录配置
如图所示,查询引用了一个尚未声明的目录,这引发了目录未找到的状况。GlueCatalogResolver 会拦截该情况,并通过 GetCatalog API 调用 AWS Glue Data Catalog。根据连接类型,解析器会注册相应的目录:对于跨账户 AWS Glue Data Catalog 注册重定向目录,对于 Redshift Managed Storage 注册下推目录,对于 Amazon S3 Tables 注册 Spark 目录。注册在查询时进行,无需预先配置。
快速开始
按照以下步骤在现有的 Amazon EMR 8.1.0 应用程序上启用多目录支持:
1. 将 spark_catalog 设置为 RedirectingSessionCatalog:
spark.sql.catalog.spark_catalog = org.apache.spark.sql.connector.catalog.\
redirecting.RedirectingSessionCatalog
注意: 如果使用 Delta Lake 或 Hudi,还需添加开放表格式(OTF)会话扩展。Hudi 还需要 KryoSerializer。
注意: 要查询另一个 AWS 账户,请添加一个指向该账户 AWS Glue Data Catalog 的命名目录。
2.(可选)启用 Glue 目录解析器:
spark.sql.catalogResolver = com.amazonaws.glue.catalog.\
redirecting.GlueCatalogResolver
对于仅 Iceberg 的多格式查询,步骤 1 就足够了。注释指出了 Delta Lake、Hudi 或跨账户场景的额外配置。步骤 2 通过在查询时解析目录,消除了预先声明目录的需要。
亲自尝试
以下演练会创建四个表(每种格式一个),运行跨格式联接,并扩展到跨账户查询。随附的示例脚本处理资源创建、作业提交和清理。随附的代码位于 aws-emr-utilities 仓库。
先决条件
- 一个拥有 Amazon EMR Serverless、AWS Glue Data Catalog 和 Amazon S3 权限的 AWS 账户。
- 一个运行 emr-spark-8.1.0(Spark)版本的 Amazon EMR Serverless 应用程序。多目录功能也适用于 Amazon EMR on EC2 和 Amazon EMR on EKS。
- 一个作用域限定为特定 AWS Glue 数据库和 S3 前缀的 Amazon EMR Serverless 作业执行角色。
- 一个用于脚本和输出的 S3 存储桶(本文使用
s3://amzn-s3-demo-bucket/multicatalog/)。 - (用于跨账户)一个配置了 Lake Formation 授权、AWS Glue 资源策略、Amazon S3 存储桶策略和 AWS Key Management Service(AWS KMS)密钥策略的生产者账户。
逐步实施
步骤 1: 克隆仓库并进行配置
git clone https://github.com/aws-samples/aws-emr-utilities.git
cd aws-emr-utilities/examples/emr-multi-catalog
cp env.template .env
# Edit .env with your application ID, role ARN, bucket, and region
该仓库包含两个阶段:单账户多格式和跨账户。.env 文件存储所有脚本引用的资源标识符。
步骤 2: 引导环境
./scripts/bootstrap.sh此脚本会创建 AWS Glue 数据库,将 PySpark 脚本上传到 S3,并验证你的 Amazon EMR Serverless 应用程序处于 CREATED 状态。如果你尚未在 .env 中设置应用程序 ID,请记下输出中的应用程序 ID。
步骤 3: 跨四种格式创建表
./scripts/run_demo.sh --phase setup设置阶段会提交一个 PySpark 作业,在同一个 AWS Glue 数据库中创建每种格式(Iceberg、Delta Lake、Hudi、Hive/Parquet)各一个表,并共用 id/val 模式。每个 CREATE TABLE 使用不同的 USING 子句,但都通过同一个 spark_catalog。RSC 会将每个表路由到正确的引擎。
作业配置包括 RedirectingSessionCatalog、用于 Delta 和 Hudi 的 OTF 会话扩展,以及用于 Hudi 的 KryoSerializer。如果你的工作负载仅使用 Iceberg,可以省略这些扩展和序列化器。
步骤 4: 运行跨格式联接
./scripts/run_demo.sh --phase query这会提交一个仅通过 database.table 引用四个表的查询,没有格式前缀。该查询通过单个目录联接所有四个表,没有特定于格式的配置:
SELECT i.id, i.val AS iceberg, d.val AS delta, h.val AS hudi, p.val AS hive
FROM salesdb.orders_iceberg i
JOIN salesdb.returns_delta d ON i.id = d.id
JOIN salesdb.shipments_hudi h ON i.id = h.id
JOIN salesdb.products_hive p ON i.id = p.id;
预期输出:
+---+---------+-------+-------+------+
| id| iceberg | delta | hudi | hive |
+---+---------+-------+-------+------+
| 1| ice-1 | dl-1 | hu-1 | hv-1 |
| 2| ice-2 | dl-2 | hu-2 | hv-2 |
| 3| ice-3 | dl-3 | hu-3 | hv-3 |
+---+---------+-------+-------+------+
每一列都来自不同的表格式,在一个查询中联接,没有特定于格式的目录配置。
步骤 5:(可选)扩展到跨账户
跨账户访问需要拥有数据账户的授权。在每个账户中运行一次引导:
# In the consumer account (where EMR runs):
./scripts/bootstrap_consumer.sh --region us-east-1 \
--producer-account 111122223333

# In the producer account (which owns the data):
./scripts/bootstrap_producer.sh \
--consumer-role <ROLE_ARN from previous step>
然后,回到消费者账户,运行跨账户阶段:
./scripts/run_demo.sh --phase xacct-autowire \
--producer-account 111122223333 --producer-table fulfillment
结果在单个查询中将生产者账户的表与本地 Iceberg 表联接,无需复制数据。
有关完整的跨账户策略设置(Lake Formation 授权、AWS Glue 资源策略、S3 存储桶策略和 AWS KMS 密钥策略),请参阅跨账户设置部分。
提示: 向任一引导脚本添加 –dry-run,可在不创建任何内容的情况下预览它将执行的每项操作(存储桶、角色、策略、应用程序)。
清理
为避免持续产生费用,请运行清理脚本或按照仓库 README 中的步骤操作:
./scripts/cleanup.sh这将删除 S3 数据、AWS Glue 数据库和表、Lake Formation 权限以及 Amazon EMR Serverless 应用程序。
跨账户设置
跨账户访问需要在四项服务中进行配置。以下示例展示了 AWS Glue 资源策略。随附的 bootstrap_producer.sh 脚本配置了全部四项,因此您无需手动编写每个策略。
1. AWS Lake Formation: 向使用方主体授予数据库和表上的权限。
2. AWS Glue 资源策略: 允许对目录元数据进行跨账户访问。
3. Amazon S3 存储桶策略: 允许访问底层数据文件。
4. AWS KMS 密钥策略: 使用客户托管密钥(aws/glue 托管密钥不支持跨账户授权)。
示例:AWS Glue 资源策略
{ "Version": "2012-10-17", "Statement": [{
"Effect": "Allow",
"Principal": {"AWS": "arn:aws:iam::444455556666:role/EMRExecutionRole"},
"Action": ["glue:GetCatalog","glue:GetDatabase","glue:GetDatabases",
"glue:GetTable","glue:GetTables","glue:GetPartition","glue:GetPartitions"],
"Resource": ["arn:aws:glue:us-east-1:111122223333:catalog",
"arn:aws:glue:us-east-1:111122223333:database/*",
"arn:aws:glue:us-east-1:111122223333:table/*/*"]
}]}
选择合适的配置
| 您的情况 | 应设置的内容 |
| Lake 中有 Iceberg、Delta 和 Hudi 表 | spark.sql.catalog.spark_catalog = RedirectingSessionCatalog(Delta 和 Hudi 需要额外的 spark.sql.extensions。请参阅快速入门) |
| 分析在一个账户中,数据在另一个账户中 | spark.sql.catalog.<name> 指向远程 Glue 账户(请参阅多目录部分) |
| 多个账户,希望零前期配置 | spark.sql.catalogResolver = GlueCatalogResolver |
| 以上全部 | 全部三项。它们可以组合使用。 |
注意: 多目录是查询时解析。它不会在账户之间复制数据、复制表或授予访问权限。跨账户读取仍需要 Lake Formation 授权、AWS Glue 资源策略、Amazon S3 存储桶策略,以及(如果加密)AWS KMS 密钥策略。
结论
在这篇文章中,我们配置了 RedirectingSessionCatalog 作为 Amazon EMR 8.1.0 上的默认 Spark 目录。通过一个配置属性,RSC 通过一个目录解析 Iceberg、Delta Lake、Hudi 和 Hive 表,而无需特定格式的前缀。然后我们声明了一个命名目录以跨两个 AWS 账户联接表,并启用了 GlueCatalogResolver 以在查询时发现远程目录,而无需预先声明的 spark.sql.catalog.* 属性。
多目录支持已在 Amazon EMR 8.1.0 上适用于所有部署模式:Amazon EMR Serverless、Amazon EMR on EC2 和 Amazon EMR on EKS。要复现此演练,请克隆 aws-samples/aws-emr-utilities 仓库并按照快速入门部分中的步骤操作。
要了解更多信息并开始使用,请探索以下资源:
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏