AWS OpenSearch智能摄取简化S3到RAG索引
有效阅读仅保存在当前浏览器,用于「为你」推荐;暂停或清除记录。
DataHot 速览
AWS发布Amazon OpenSearch intelligent ingestion,面向Amazon OpenSearch Serverless(NextGen)提供全托管、无服务器的摄取能力。用户可从Amazon S3指向文档数据,自动完成解析、图像描述、分块、向量嵌入和索引,无需配置管道或管理文档处理基础设施。该能力支持PDF、Word、Markdown等文档,并保留布局和表格,还可用视觉语言模型生成图表、示意图、截图描述,以支持语义与混合搜索。适合构建RAG助手和企业搜索的团队降低从原始文档到可搜索索引的复杂度。
为什么值得关注:关注RAG数据接入与索引自动化,涉及S3文档解析、多模态描述、分块嵌入到OpenSearch向量索引,对AI数据平台与RAG基础设施从业者有参考价值。
译文
AI 逐段翻译组织的大部分最有价值的知识都存放在合同、产品手册、研究报告、支持运行手册和财务申报文件等文档中。这些内容以结构化数据(JSON、NDJSON 和 JSON 数组)和非结构化数据(PDF、Word、文本和 Markdown)的形式存储在 Amazon Simple Storage Service(Amazon S3)中。生成式 AI 应用、检索增强生成(RAG)助手和企业搜索体验的效果,取决于它们对这些内容的访问能力。然而,这往往是最难被发掘和搜索的数据。为了提取这些数据,客户必须运行包含多个步骤的复杂摄取管道:
- 运行文档解析器,在提取文本的同时保留布局、阅读顺序和表格。
- 提取并解读这些文档中的图表、示意图和截图。
- 对提取的文本进行分块,通过嵌入模型处理,并将结果写入向量索引。
每一层都有各自的基础设施、扩缩容决策和故障模式。复杂性不断叠加,许多组织需要花费数周时间才能实现端到端运行。
今天,我们很高兴地宣布推出 Amazon OpenSearch intelligent ingestion,这是 Amazon OpenSearch Serverless(NextGen)中的一项完全托管且无服务器的摄取能力。您从自己的集合开始,指向 Amazon S3 中的数据,并选择希望如何处理。随后智能摄取会处理其余工作:它从 S3 发现您的内容,解析文档,生成图像描述,对内容进行分块,生成向量嵌入,并将结果建立索引。无需配置管道,无需运维文档处理基础设施,也无需提前规划容量。
借助智能摄取,您可以:
- 无需手动管道,即可从原始文档实现语义搜索。 摄取 PDF、Word 和 Markdown 文件,在保留布局和表格完整性的情况下进行解析,并写入已准备好进行语义搜索和混合搜索的索引。
- 让视觉内容可被搜索。 当文档包含图表、示意图、截图或照片时,视觉语言模型会撰写详细的文本描述。随后您就可以找到仅出现在图像中的信息。
- 无需管道代码即可摄取结构化数据。 加载 JSON、NDJSON 和 CSV 数据,并在摄取期间应用转换,还可选启用语义搜索增强。
- 选择一次性或持续摄取流。 使用 Ingestion Jobs 进行一次性或周期性加载,例如迁移和回填。使用 Ingestion Streams 在新对象到达您的存储桶时,保持索引持续同步。
- 仅为活跃处理付费。 容量随您的工作负载自动扩缩,空闲摄取容量不收费。
在本文中,我们将解释智能摄取的工作原理,以及何时使用 Ingestion Jobs 或 Ingestion Streams。然后,我们将演示如何从 Amazon S3 摄取一批非结构化文档,并将其内容处理为 Amazon OpenSearch Serverless(NextGen)中可供 RAG 使用的智能信息。您可以使用相同的工作流摄取日志和结构化数据。从 Amazon S3 加载 JSON、NDJSON 和 JSON 数组数据(例如应用程序日志、审计跟踪或产品目录),并在摄取期间应用转换,还可选启用语义增强。您的 RAG 知识库和日志分析可以共享同一套摄取体验。
解决方案概述
智能摄取在 Amazon OpenSearch Serverless(NextGen)集合内运行,并管理从您的 S3 存储桶到索引的整个路径。当您创建 Ingestion Job 或 Ingestion Stream 时,只需指定两项内容:
- 源 – 包含您数据的 Amazon S3 存储桶和前缀。
- 目标 – Amazon OpenSearch Serverless(NextGen)集合中接收处理后数据的索引。
之后,智能摄取会为您执行以下步骤。
- 数据发现: 智能摄取会自动扫描您 S3 前缀下的对象。对于 Ingestion Streams,它会使用 Amazon Simple Queue Service(Amazon SQS)通知来检测新到达的对象。
- 文档解析: 当检测到 PDF 和 Word 文件时,智能摄取会自动将其解析为结构化内容,保留标题、阅读顺序和表格。
- 图像理解: 当它在 PDF 和 Word 文件中检测到图像时,会生成丰富的文本描述,以便视觉内容能与周围文本一起被索引。
- 分块和嵌入: 智能摄取将内容拆分为适合检索的块,并使用 OpenSearch Automatic Semantic Enrichment 生成向量嵌入。
- 索引: 智能摄取将块、稀疏嵌入和元数据写入您的索引,并在集合组预定义的 OpenSearch Compute Unit(OCU)限制内,根据工作负载扩缩容量。
Ingestion Jobs 或 Ingestion Streams
| Ingestion Jobs | Ingestion Streams | |
| 使用时机 | 您有一个固定的数据集需要加载一次 | 您的数据持续到达或发生变化 |
| 典型场景 | 初始加载、迁移、回填、概念验证 | 不断增长的知识库、持续更新的文档库 |
| 行为 | 摄取前缀下的所有对象,然后完成 | 在新对象到达时保持索引同步 |
先决条件
要跟随本文操作,您需要:
- 一个具有创建和管理 Amazon OpenSearch Serverless(NextGen)集合权限的 AWS 账户。
- 一个包含您数据的 Amazon S3 存储桶。
- 一个 AWS Identity and Access Management(IAM)角色,以及智能摄取从 Amazon S3 读取数据所需的权限。
工作原理
从 Amazon OpenSearch Serverless 的 AWS 管理控制台页面开始,您现在可以看到一个新的 Ingestion 选项卡。您可以先选择 Create ingestion job,或在此选项卡上查看现有作业。
图 1:Amazon OpenSearch Service 控制台上的 Ingestion 选项卡
智能摄取支持三种模式,适用于不同的源配置。对于 Amazon S3 上的静态数据集,请选择 One-time batch 以执行一次性摄取,摄取作业在完成后会自动终止。
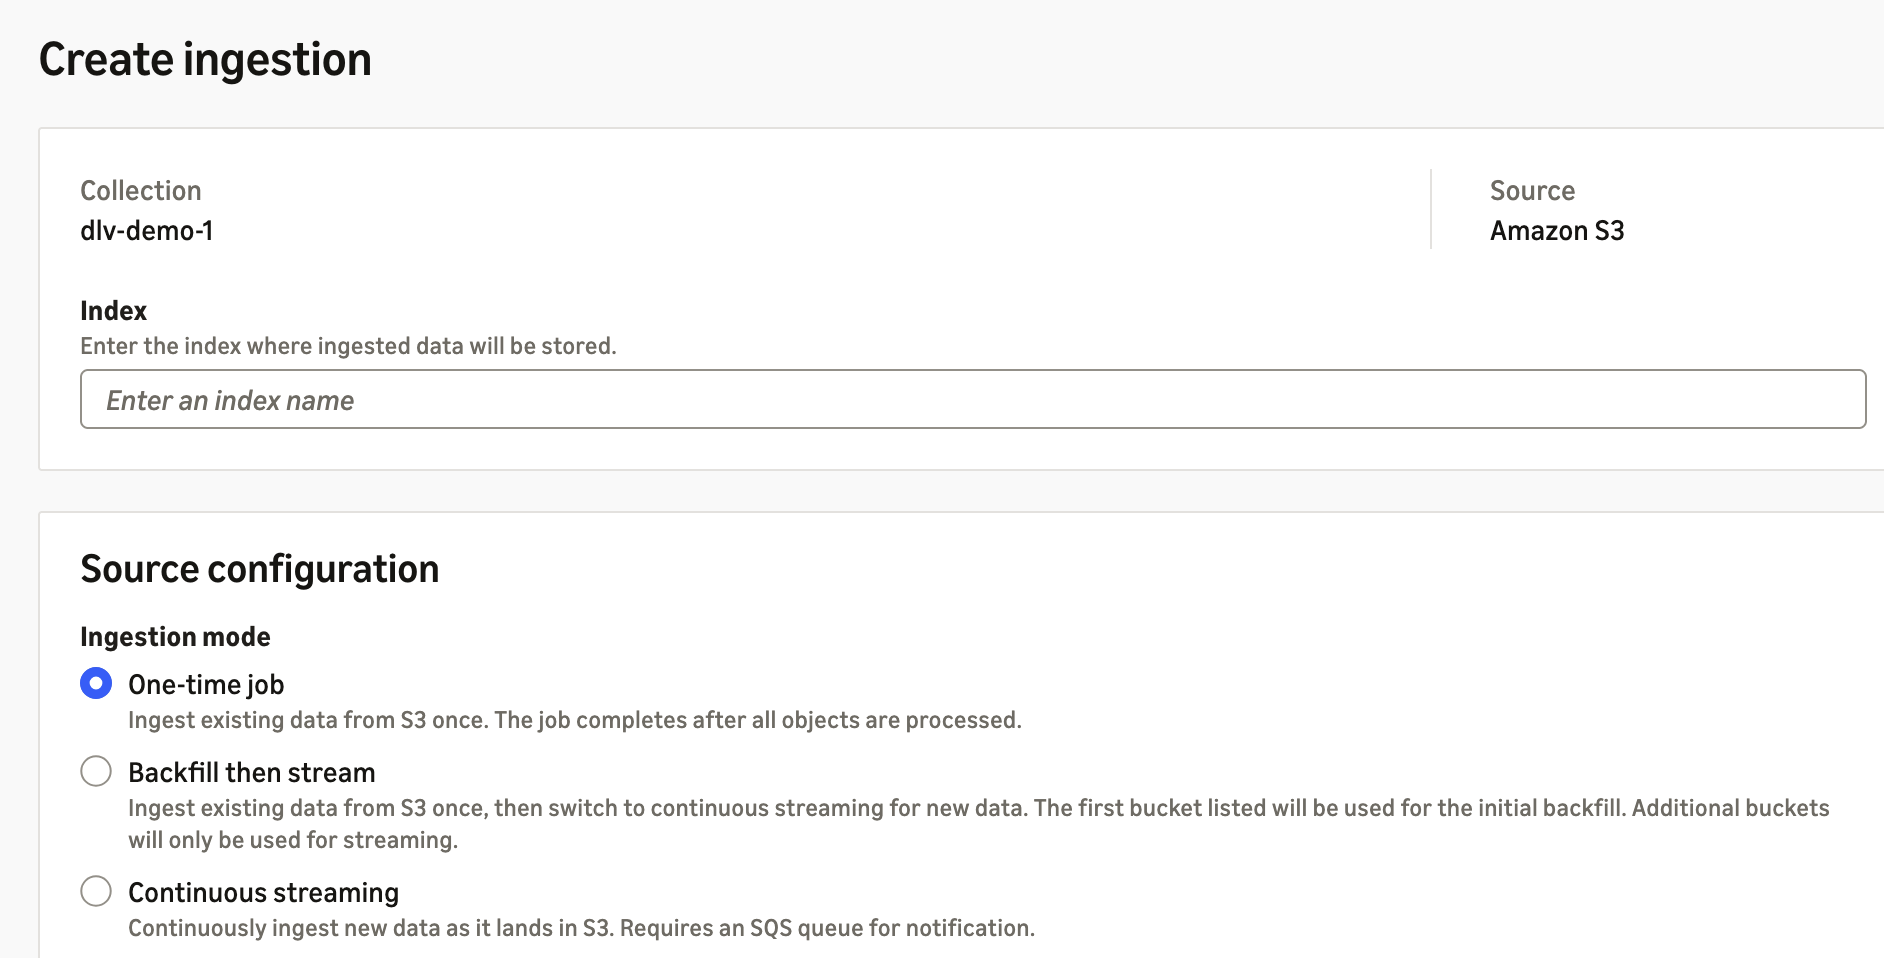
图 2:选择 One-time batch 摄取模式
对于即将接收新数据输入的新的 S3 存储桶,请选择 Continuous streaming 以持续监控通知并在新数据可用时进行摄取。如果 S3 存储桶中已有部分数据,请选择 Batch then stream 以摄取现有数据,然后切换到持续流式传输模式。对于这两种场景,智能摄取都依赖您的 Amazon SQS 队列来接收 Amazon S3 对象通知,并且需要提供 IAM 角色的 Amazon Resource Name (ARN) 以代入该角色并操作它进行数据摄取。
图 3:使用 Amazon SQS 队列和 IAM 角色配置持续流式传输
Backfill then stream 是另外两种模式的组合。您可以指定一个存储桶用于初始回填,并指定额外的存储桶用于流式传输新数据。
智能摄取功能可自动用于同一 AWS 账户内的 S3 存储桶。您可以在此页面上浏览 S3 存储桶,并可选择性地定义前缀,以指定应摄取存储桶中的哪些文件夹或文件。智能摄取也适用于不同 AWS 账户中的 S3 存储桶。对于跨账户场景,您需要提供另一个 AWS 账户 ID,以及该账户中的 Amazon S3 存储桶、IAM 角色 ARN 和可选的 Amazon SQS,以访问这两种资源。
图 4:选择 Amazon S3 存储桶和可选的跨账户访问
要开始使用,请选择 Create ingestion job 并完成配置,然后选择 Validate and continue。在此页面上,查看配置,为摄取作业或流输入名称,并启动摄取。随后,摄取作业或流会出现在 Amazon OpenSearch Serverless (NextGen) 集合的 Ingestion 选项卡上,供管理查看。
图 5:在启动前审查并命名摄取作业
启动后,智能摄取首先会扫描 S3 存储桶以识别数据类型,并确定内容的处理机制(结构化数据、非结构化数据或含图像的数据)。智能摄取会自动处理摄取任务。您可以在同一页面上监控其已扫描和索引的文档数量。您的数据现在可在 Amazon OpenSearch Serverless 中搜索。
图 6:监控已扫描和索引的文档
成本
智能摄取仅按您实际使用的量收费。
诸如 JSON 之类的结构化数据可以直接处理并摄取到 OpenSearch Serverless 进行索引。对于每个正在积极运行的数据摄取工作节点,您需要按标准 OCU 付费。摄取作业完成后会自动终止并停止计费。
诸如 PDF 和 Word 文档之类的非结构化数据需要额外的解析、分块,在某些情况下还需要图像理解。智能摄取可以自动使用无服务器索引 OCU(在您预定义的限额内)来提取文本并将页面分块为结构化数据。它按标准 OCU 费率收费,例如在美国东部(弗吉尼亚北部)为每小时 $0.24。这会在结构化数据摄取的基础上产生额外费用。根据我们的内部测试,一个额外的 OCU 每小时可处理 600 个 PDF 页面,即每处理 1,000 个可供摄取的 PDF 页面为 $0.40。智能摄取使用 Amazon Nova 2 Lite 将 PDF 和 Word 文件中的图像转换为语义含义。Amazon Bedrock 模型推理成本与 Amazon Bedrock 上的公开费率 对于 Nova 2 Lite 完全一致:每 100 万输入 token $0.30,每 100 万输出 token $2.50。根据我们的内部测试,每 1,000 张图像平均消耗 50 万输入 token,平均消耗 50 万输出 token。处理 1,000 张图像大约需要支付 $1.40。
清理
为避免未来产生费用,请删除您为本演练创建的资源。删除您创建的任何 Ingestion Streams,然后删除 OpenSearch 集合以及 S3 存储桶中的示例文档(如果不再需要)。摄取作业在完成后会停止消耗容量。
结论
在本文中,我们展示了 Amazon OpenSearch 智能摄取如何将 Amazon S3 中的企业文档转化为可供 RAG 使用的智能数据,而无需管理摄取管道。您选择源、处理行为和目标。随后,智能摄取会解析您的文档、描述其中的图像、对内容进行分块、生成向量嵌入并对结果建立索引。它随您的工作负载扩展,并且仅对活跃处理收费。曾经需要数周管道工程才能完成的工作,现在只需几次点击或一次 API 调用,因此您的团队可以专注于用户所需的搜索和生成式 AI 体验。智能摄取现已在六个受支持的 AWS 区域中,为以 Amazon S3 为数据源的 Amazon OpenSearch Serverless (NextGen) 集合提供。
准备好让您的文档可搜索了吗?打开 Amazon OpenSearch Service 控制台,选择您的集合,并创建您的第一个 Ingestion Job。先从小部分文档开始,几分钟内即可看到结果,然后添加 Ingestion Stream,以便在内容增长时保持索引同步。要了解更多信息,请参阅 Amazon OpenSearch Service 开发人员指南中的智能摄取。有关定价详情,请参阅 Amazon OpenSearch Service 定价。
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏