用AWS DevOps Agent加速EMR上的Spark调试
AWS DevOps Agent + Spark Troubleshooting Agent
要解决的问题Spark 作业失败的线索散落在告警、日志、事件记录和代码中,内置云 API 又看不到执行器内存等 Spark 内部证据。
功能模块
- Agent Space 能力管理
- MCP Server 工具选择
- 调查启动面板
- 工具调用时间线
- 根因与修复计划
关键交互
- 在 Agent Space 中添加受管 MCP 服务器并勾选所需工具
- 从 CloudWatch 告警或单条聊天指令发起调查
- 在时间线中查看云 API 与 MCP 工具如何交替执行
- 打开 Root cause 标签查看影响、根因、关键证据和缓解方案
官方说明
- AWS DevOps Agent 可将自定义 MCP 服务器注册为能力提供者,并在一次调查中交替使用内置 AWS API 工具与 MCP 工具。
- 官方演练使用 AWS 托管的 Apache Spark Troubleshooting Agent,通过 PrivateLink 连接,MCP 流量不经过公网。
- 演练中 Agent 从 CloudWatch 告警开始,生成精确到代码行的根因与缓解计划,全流程约两分钟。
DataHot 解读
- 配置流程先选能力、再选工具,是把“插件已连接”与“Agent 可使用哪些权限”分层表达。
- 调查结果用时间线保留过程、用根因页压缩结论,同时服务于工程师复盘和负责人快速决策。
收益与代价
- MCP 扩展弥补了内置 API 的证据盲区,也引入了新的网络、身份和工具权限边界。
- 约两分钟的自动调查比手工排查快,但修复仍应保留人工确认,特别是生产变更。
可以借鉴
- 可扩展 Agent 的配置 UI 应分开“连接服务”与“授予具体工具”两个步骤。
- 故障调查产品应同时提供压缩后的根因结论和可回放的证据时间线。
不宜照搬
- 官方演示基于一个刻意制造的 Spark 内存故障,不代表所有 EMR 故障都能在相同时间内解决。
- 本案例依赖 AWS 账户、指定区域与多项 IAM/VPC 前置配置,不是零配置的通用 Agent 调试器。
“官方说明”仅记录公开材料明确表达的事实;“DataHot 解读”是基于界面与流程的产品判断。
DataHot 速览
AWS 官方博客介绍如何将托管的 Apache Spark Troubleshooting Agent(MCP 服务器)注册为 AWS DevOps Agent 的自定义能力提供者,并通过 PrivateLink 确保私网连接。从一个聊天提示出发,Agent 可自主调查 EMR 上 Spark 作业失败,生成根因与修复计划,整个过程约两分钟。文章还指出内置 API 工具无法访问 Spark History Server 事件日志、执行器内存等内部工件,需借助 MCP 扩展弥补。它提供了完整的部署前置条件和集成步骤,适合数据团队参考。
为什么值得关注:Spark 作业失败排查是数据平台运维的高频痛点,本文展示了用 Agent 自动化根因分析的可行路径,可显著降低人工排查成本。
本文目录 20 节
- 前提条件
- AWS DevOps Agent 如何通过 MCP 发现自定义工具
- 为什么 Spark 内部可见性很重要
- 将 AWS DevOps Agent 与 Apache Spark Troubleshooting MCP 集成
- 工作原理
- 设置演示环境
- 第1步:克隆存储库
- 第2步:部署AWS CloudFormation堆栈
- 第3步:创建代理空间
- 第4步:创建AWS DevOps Agent私有连接
- 第5步:注册Apache Spark故障排查MCP服务器作为能力提供者
- 第6步:将MCP服务器添加到代理空间
- 实际运行效果
- 失败的作业
- 提交失败作业
- 观察 CloudWatch 告警触发
- 要求 AWS DevOps Agent 进行调查
- 查看根因和修复
- 清理
- 结论
译文
AI 逐段翻译当 Apache Spark 作业在 Amazon EMR 上失败时,根本原因可能隐藏在 executor 日志、内存配置文件或应用程序代码中。随着数据管道日益复杂,跨多个服务关联日志、指标和追踪需要大量的运维工作。AWS DevOps Agent 自主执行调查,同时让操作员参与审查发现并批准修复。仅从一个聊天提示词,无需人工干预(除初始问题外),它就能生成根本原因和缓解计划。
AWS DevOps Agent 中的原生 AWS API 工具无法深入 Spark 内部工件。有时这些工具无法获取能确定根本原因的证据:Spark History Server 事件日志、executor Python worker 内存,或分配过多内存的代码行。在这些情况下,AWS DevOps Agent 可以描述症状(例如“executor 以代码 1 退出”),但无法识别导致这些症状的实际反模式。
本文介绍如何扩展 AWS DevOps Agent,以调查 Amazon EMR 上 Apache Spark 工作负载的故障。您注册Apache Spark Troubleshooting Agent for Amazon EMR(一个由 AWS 托管的托管 Model Context Protocol (MCP) 服务器)作为 AWS DevOps Agent 空间中的自定义能力提供者。您通过 AWS PrivateLink 路由流量,使 MCP 调用永不经过公共互联网。然后,您观察一个代理聊天会话在约两分钟内调查一个故意失败的 Spark 作业,从 Amazon CloudWatch 告警到带有行号的根本原因。
前提条件
开始之前,请确保您具备以下条件:
- 一个 AWS 账户,具有部署AWS CloudFormation 栈的权限,这些栈创建AWS Identity and Access Management (IAM) 角色和Amazon Virtual Private Cloud (Amazon VPC) 资源。
- 最新版本的AWS Command Line Interface (AWS CLI)、Boto3 和 Botocore,已安装并配置了同一账户和 AWS 区域的凭证。
- 本演练假定您熟悉 AWS DevOps Agent,并知道如何触发调查。有关介绍,请参阅 Getting started with AWS DevOps Agent。
AWS DevOps Agent 如何通过 MCP 发现自定义工具
Model Context Protocol (MCP)是一个开放标准,定义了 AI 代理如何发现和调用外部工具。AWS DevOps Agent 支持连接到自定义 MCP 服务器,这意味着您可以向其公开新功能,而无需修改代理本身。当您将 MCP 服务器连接到 AWS DevOps Agent 时,代理会自动发现可用工具、理解其模式,并在其调查工作流程中调用它们。您构建并连接 MCP 服务器,其余部分由代理处理。
MCP 工具与代理内置的 AWS API 工具并列。在单个调查中,代理可以交错调用cloudwatch.describe-alarms、emr-serverless.get-job-run以及自定义 MCP 工具,如analyze_spark_workload。代理为每个子任务选择正确的工具。您扩展了代理的触达范围,而不替换其现有功能。
对于此集成,您无需构建 MCP 服务器。Apache Spark Troubleshooting Agent for Amazon EMR 本身就是一个托管 MCP 服务器,由 AWS 在区域端点托管。您的工作是将该端点注册到 AWS DevOps Agent,并授权代理调用它。这需要从代理到端点的网络路径,以及用于 AWS Signature Version 4 请求签名的 IAM 角色。
为什么 Spark 内部可见性很重要
Spark 失败的实际根本原因通常位于任何这些 API(如 Amazon CloudWatch Logs Insights、AWS CloudTrail 或 Amazon EMR 步骤状态调用)都无法触及的地方:
Apache Spark Troubleshooting Agent for Amazon EMR 会读取以下来源。
Spark History Server 事件日志是存储在 Amazon Simple Storage Service (Amazon S3) 中的按作业归档,包含阶段时序、任务级指标、executor 利用率、shuffle 读写量和垃圾回收暂停。Amazon EMR 通过 Amazon EMR Serverless、Amazon EMR on Amazon Elastic Compute Cloud (Amazon EC2) 和 Amazon EMR on Amazon Elastic Kubernetes Service (Amazon EKS) 上的 Spark UI 公开这些数据,但解释数据倾斜、executor 内存压力或耗时远超预期的阶段等信号需要熟悉 Spark 内部机制。
- Spark 查询计划——由 driver 编译的逻辑和物理计划。没有它,您无法识别反模式,例如不必要的数据重新分区或缺失的广播提示,这些会触发昂贵的 shuffle。
- 应用程序源代码在 Amazon S3 中——作业运行的
.py或.jar代码工件。没有它,您无法引用引发问题的行,例如mapPartitions用户定义函数或低效的collect()。 - Python worker 进程遥测——PySpark worker 是独立于 Java 虚拟机 (JVM) 托管内存的 Python 子进程。当它因
spark.executor.pyspark.memory耗尽而崩溃时,JVM driver 看到的是通用的“executor 意外退出”消息。实际原因在标准 JVM 级日志中不可见。
当代理在调查期间调用 analyze_spark_workload 时,它返回一个结构化分析,其中包含在行级识别的反模式、孤立的故障阶段以及具体的修复:包括代码更改和配置更改。
将 AWS DevOps Agent 与 Apache Spark Troubleshooting MCP 集成
本节说明 AWS DevOps Agent 如何通过私有 MCP 端点连接到 Apache Spark Troubleshooting Agent,并编排调查工作流程。
工作原理
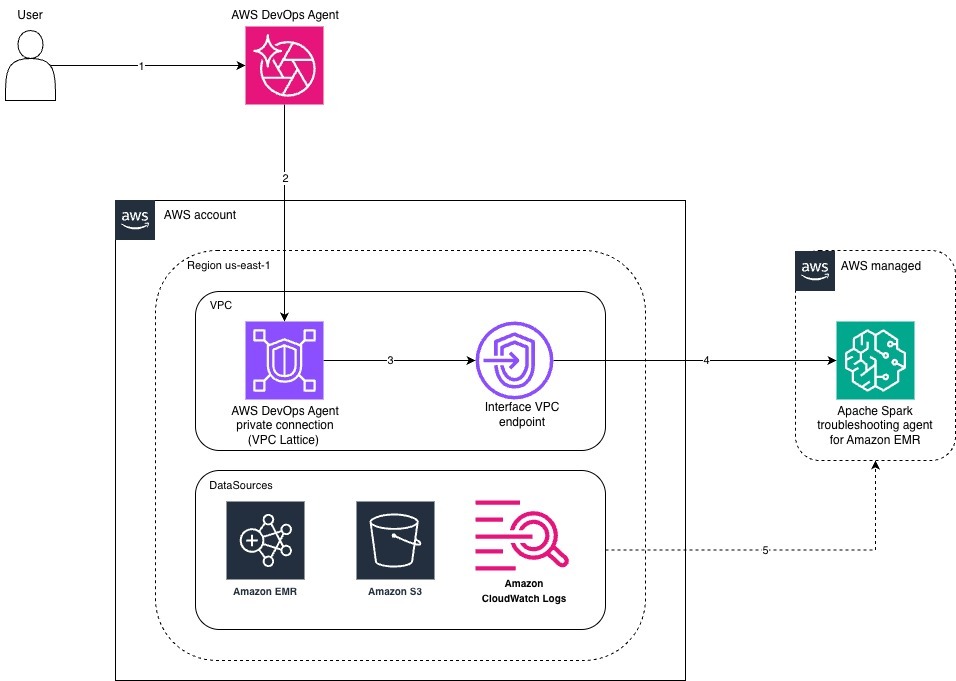
图 1:AWS DevOps Agent 与 Apache Spark Troubleshooting Agent for Amazon EMR 通过 AWS PrivateLink 的集成架构
- 您在 AWS DevOps Agent 中提交调查提示词。
- AWS DevOps Agent 通过 AWS DevOps Agent 私有连接向您的 Amazon VPC 发送 SigV4 签名的 MCP 调用。
- 私有连接将请求转发到接口VPC终端节点。
- 终端节点通过AWS PrivateLink将请求路由到由AWS管理的Amazon EMR Apache Spark故障排查代理。
- MCP服务使用AWS DevOps Agent为调用所采用的相同IAM角色,从您的数据源(Amazon EMR、Amazon S3、Amazon CloudWatch Logs)读取数据。
- 当CloudWatch告警变为ALARM状态(例如,您的Amazon EMR Serverless应用程序的失败作业告警)时,AWS DevOps Agent会自动触发调查,无需人工干预。
- AWS DevOps Agent根据提示词决定调用哪些工具。对于Spark故障,这可能包括Apache Spark故障排查MCP服务器您注册为能力提供者。
- 每个MCP请求都使用分配给能力提供者的IAM角色,通过AWS签名版本4进行签名。请求从AWS DevOps Agent通过私有连接进入您的Amazon VPC。此私有连接是您在设置期间创建的托管VPC Lattice资源网关。
- 从资源网关,请求流向接口VPC终端节点,用于Amazon SageMaker Unified Studio MCP服务,然后到Apache Spark故障排查代理。流量完全保持在AWS网络上。
- MCP服务器使用您在MCP服务器注册期间分配给能力提供者的IAM角色,从您的AWS账户读取其所需的输入。该角色授予对Amazon S3中Spark历史服务器事件日志和应用程序源代码、Amazon CloudWatch Logs中驱动程序和执行程序的stdout流以及Amazon EMR Serverless中作业运行元数据的访问权限。
- MCP服务器将诊断结果返回给AWS DevOps Agent。代理随后分析结果,识别根本原因,并在聊天中展示推荐的修复方案,包括代码级和配置级。
设置演示环境
作为此演示的一部分,本文包含一个示例AWS CloudFormation模板,已在us-east-1区域测试,该模板配置了以下资源用于演练:
- 一个专用的Amazon Virtual Private Cloud(Amazon VPC),在支持Amazon EMR Apache Spark故障排查代理的可用区中包含两个私有子网。
- 一个用于Amazon EMR Apache Spark故障排查代理的接口VPC终端节点。
- 一个IAM角色,AWS DevOps Agent假定该角色来调用Apache Spark故障排查MCP服务器,并使用AWS签名版本4。
- 一个故意失败的PySpark工作负载,运行在Amazon EMR Serverless上,包括Amazon EMR Serverless应用程序、Spark执行角色以及存储在Amazon S3存储桶中的演示日志。
- 一个Amazon CloudWatch告警,在演示作业失败时触发。此告警用作本节后续代理调查的触发器。
第1步:克隆存储库
克隆git 存储库,用于CloudFormation模板、PySpark脚本和Parquet数据。
git clone https://github.com/aws-samples/sample-aws-data-processing-and-analytics.git第2步:部署AWS CloudFormation堆栈
使用以下AWS CLI命令部署模板。
cd sample-aws-data-processing-and-analytics/blogs/devops-agent-spark-mcp-integration

aws cloudformation create-stack \
  --stack-name spark-troubleshooting-demo \
  --template-body file://cloudformation/spark-troubleshooting-devops-agent-blog.yaml \
  --capabilities CAPABILITY_NAMED_IAM \
  --region us-east-1
堆栈达到 CREATE_COMPLETE 大约需要4-6分钟。完成后,捕获以下堆栈输出,您将在接下来的两个步骤中粘贴到AWS DevOps Agent控制台中:
DemoVpcId— 用于AWS DevOps Agent私有连接的VPC ID。DemoSubnetIds— 用于AWS DevOps Agent私有连接的两个子网ID。SMUSVpcEndpointSecurityGroupId— 安全组ID。TroubleshootingRoleArn— IAM角色Amazon资源名称(ARN)。MCPEndpointURL— 要注册的MCP终端节点URL。FailedJobsAlarmName— 在您的调查提示中引用的CloudWatch告警名称。DemoBucket— 您将演示脚本和Parquet数据复制到的S3存储桶名称。
要一次检索所有输出,请使用以下AWS CLI命令。
aws cloudformation describe-stacks \
  --region us-east-1 \
  --stack-name spark-troubleshooting-demo \
  --query "Stacks[0].Outputs" --output table
# Get your bucket name from the stack outputs
DEMO_BUCKET=$(aws cloudformation describe-stacks --stack-name spark-troubleshooting-demo --region us-east-1 --query 'Stacks[0].Outputs[?OutputKey==`DemoBucket`].OutputValue' --output text)
# Copy the script
cd sample-aws-data-processing-and-analytics/blogs/devops-agent-spark-mcp-integration
aws s3 cp scripts/customer_events_aggregator.py s3://$DEMO_BUCKET/customer_events_aggregator.py
# Copy the Parquet data
aws s3 cp data/ s3://$DEMO_BUCKET/data/ --recursive第3步:创建代理空间
代理空间定义代理监控哪个AWS账户和区域,它假设哪个IAM角色,以及它可以调用哪些能力提供者,包括MCP服务器。
按照 创建代理空间 中的步骤,在AWS DevOps Agent用户指南中。完成这些步骤时,使用以下值:
| 参数 | 值 |
| 名称 | data-pipeline-troubleshooting |
| 区域 | us-east-1 |
| 代理空间角色 | 选择自动创建新的DevOps Agent角色 — 控制台会生成一个附加了AIOpsAssistantPolicy的DevOpsAgentRole-AgentSpace*角色 |
| 可选集成 | 不需要 |
在代理空间达到 Active 状态后,继续创建私有连接。
第4步:创建AWS DevOps Agent私有连接
AWS DevOps Agent使用私有连接访问您的Amazon VPC。按照 连接到私有托管的工具 中的步骤,在AWS DevOps Agent用户指南中。您可以使用控制台或AWS CLI命令,该命令在 创建私有连接 下记录。
完成这些步骤时,使用CloudFormation堆栈输出中的以下值:
| 参数 | 值 |
| 名称 | 描述性名称(例如,spark-private) |
| VPC | 堆栈输出中的DemoVpcId |
| 子网 | DemoSubnetIds中的两个子网ID |
| 安全组 | SMUSVpcEndpointSecurityGroupId |
| TCP端口范围(高级配置) | 443 |
| 主机地址(服务目标详细信息) | sagemaker-unified-studio-mcp.us-east-1.api.aws |
| DNS解析 | 在VPC内(私有DNS) |
| 证书公钥 | 无 |
在连接达到 Active 状态后,继续第5步。
第5步:注册Apache Spark故障排查MCP服务器作为能力提供者
在私有连接就绪后,将MCP服务器注册为能力提供者。按照 在账户级别注册MCP服务器 中的步骤,在AWS DevOps Agent用户指南中。
完成这些步骤时,使用以下值:
| 参数 | 值 |
| 名称 | spark-troubleshooting |
| 终端节点URL | 堆栈输出中的MCPEndpointURL |
| 使用私有连接连接到终端节点 | 已选择 |
第6步:将MCP服务器添加到代理空间
注册 MCP 服务器后,你需要一个运行调查的工作空间。代理空间定义了代理监控的 AWS 账户和区域、它扮演的 IAM 角色,以及它可以调用的能力提供者(包括 MCP 服务器)。
- 在 MCP 服务器 部分,选择 添加。
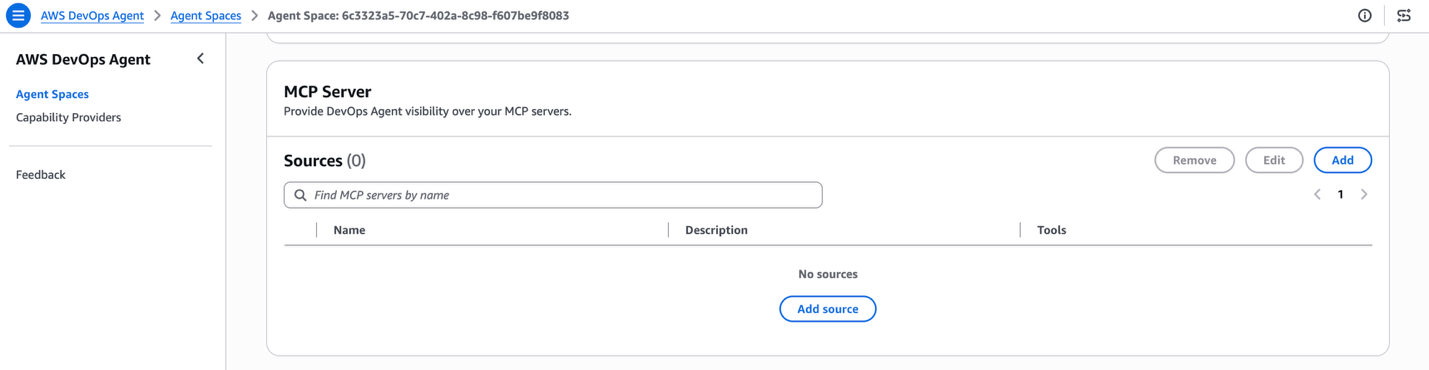
图 2:代理空间详情页中的 MCP 服务器部分
- 在 添加能力 对话框中,找到
spark-troubleshooting在已注册的 MCP 服务器列表中,并选择 添加。
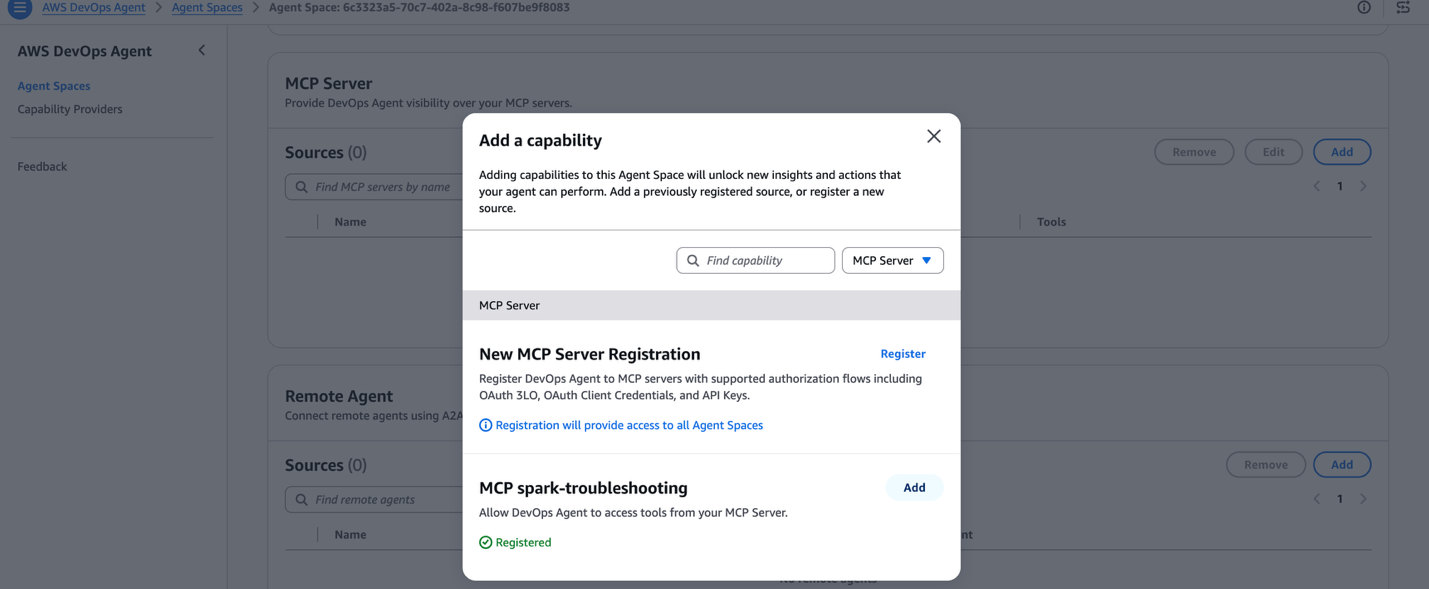
图 3:添加能力,列出 spark-troubleshooting MCP 服务器
- 在 选择 MCP 服务器工具 页面上,列出了 Apache Spark Troubleshooting Agent for Amazon EMR 发布的两个工具:
analyze_spark_workload和analyze_spark_history_server_endpoint。选中两个复选框,然后选择 保存。
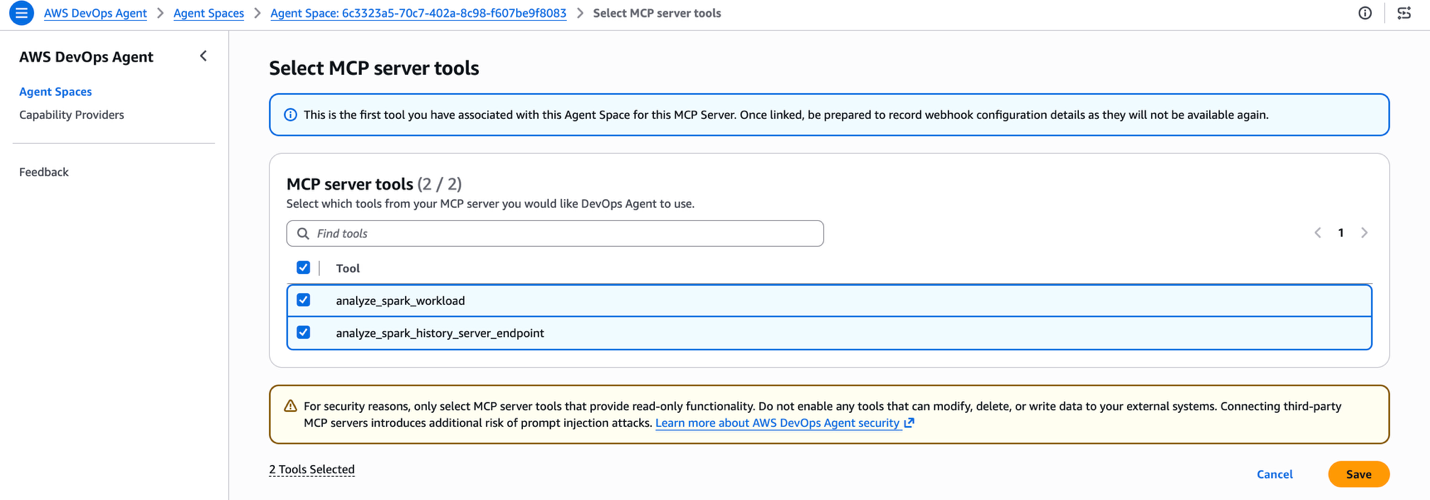
图 4:“选择 MCP 服务器工具”页面,选中两个 Spark 故障排除工具
代理空间连接到 MCP 服务器,列出其工具,并显示 2 可用 / 2 已连接。这两个工具现在都是你的代理目录的一部分。
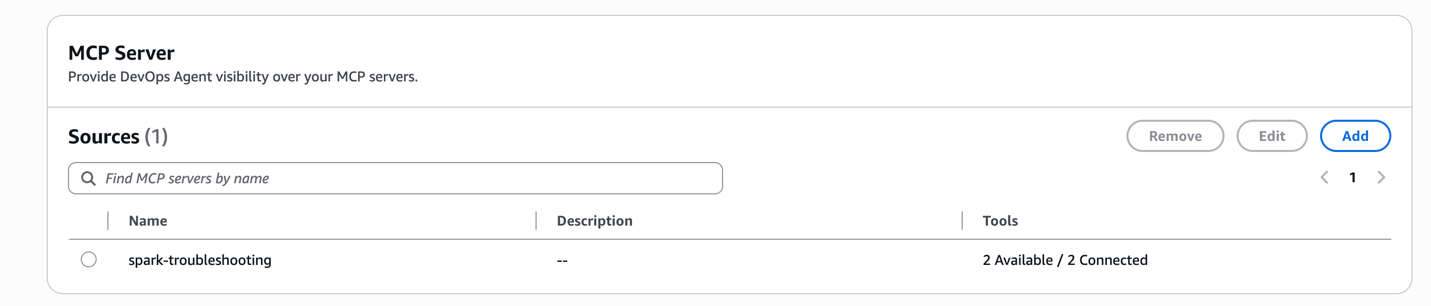
图 5:MCP 服务器部分显示 spark-troubleshooting 已连接,两个工具均可用
实际运行效果
为了查看端到端的集成,你提交一个 PySpark 作业,观察 CloudWatch 告警变为 ALARM,然后要求 AWS DevOps Agent 使用告警名称进行调查。
失败的作业
CloudFormation 模板预置了一个名为 analytics-events-platform 的 Amazon EMR Serverless 应用程序,并配置了一个示例 PySpark 作业 customer_events_aggregator.py。该脚本模拟了一个常见的 Python 端内存错误:一个 mapPartitions 用户定义函数在产生结果之前,在内存中的 Python 列表中累积每个输入行的 11 份副本,而作业运行时的 spark.executor.pyspark.memory=256m。Python worker 进程超过 256 MB 的限制,内核将其杀死,Spark 重试四次,阶段被标记为失败。
提交失败作业
运行 DemoSubmitJobCommand 从你的终端中的堆栈输出。它看起来像这样:
aws emr-serverless start-job-run \
  --region us-east-1 \
  --application-id <DemoApplicationId> \
  --execution-role-arn <DemoExecutionRoleArn> \
  --name daily-customer-events-rollup \
  --job-driver '{"sparkSubmit":{"entryPoint":"s3://<DemoBucket>/customer_events_aggregator.py","entryPointArguments":["<DemoBucket>"],"sparkSubmitParameters":"--conf spark.executor.cores=2 --conf spark.executor.memory=1g --conf spark.executor.pyspark.memory=256m --conf spark.executor.instances=2"}}' \
  --configuration-overrides '{"monitoringConfiguration":{"s3MonitoringConfiguration":{"logUri":"s3://<DemoBucket>/logs/"}}}'
该命令返回一个 jobRunId。记下来。稍后你会在代理的调查中看到它。
作业经过 PENDING 到 SCHEDULED 到 RUNNING 到 FAILED,大约四分钟后达到 FAILED 状态。
观察 CloudWatch 告警触发
CloudFormation 模板还创建了一个名为 <DemoApplicationId>-FailedJobs 的 CloudWatch 告警(确切名称在 FailedJobsAlarmName 堆栈输出中)。该告警监视 FailedJobs 指标,在 AWS/EMRServerless 命名空间中,限定到你的演示应用程序,并在作业失败后一两分钟内变为 ALARM。
打开 Amazon CloudWatch 控制台,选择 告警 在左侧导航窗格中,并确认告警处于 In alarm 状态。
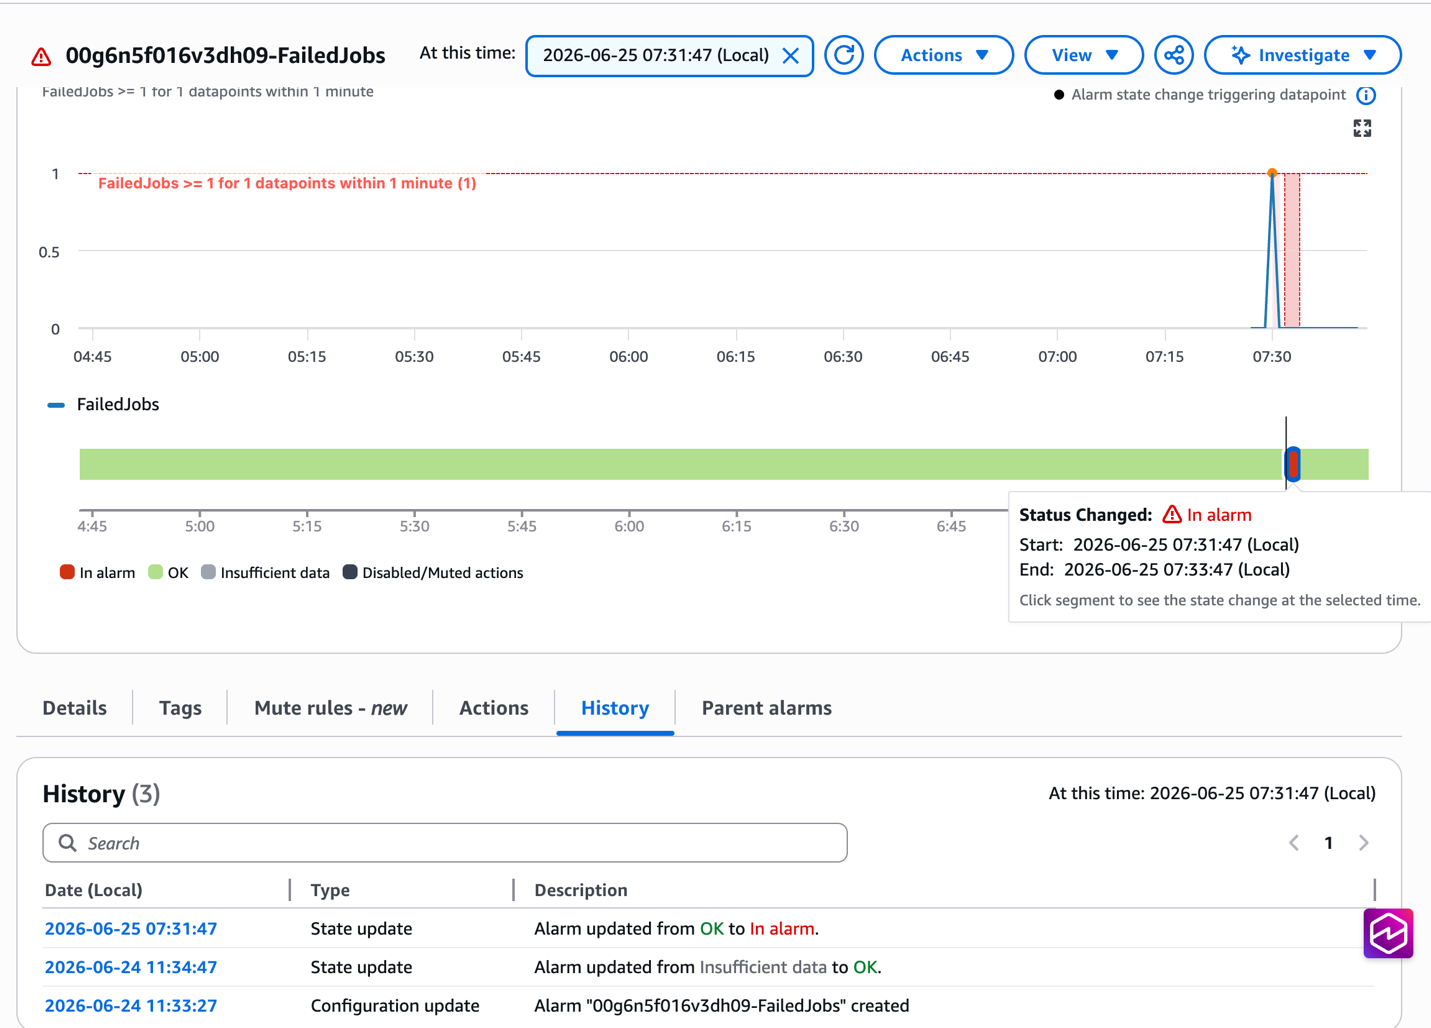
图 6:Amazon CloudWatch 告警详情页显示 FailedJobs 告警处于 In alarm 状态
要求 AWS DevOps Agent 进行调查
- 打开你的 AWS DevOps Agent 空间。
- 在左侧导航窗格中,选择 操作员访问,然后选择 事件。
- 选择 开始调查。
- 粘贴以下提示,替换
<FailedJobsAlarmName>为你的堆栈输出中的值:
us-east-1 中的 CloudWatch 告警刚刚进入 ALARM 状态。调查原因并推荐修复方案
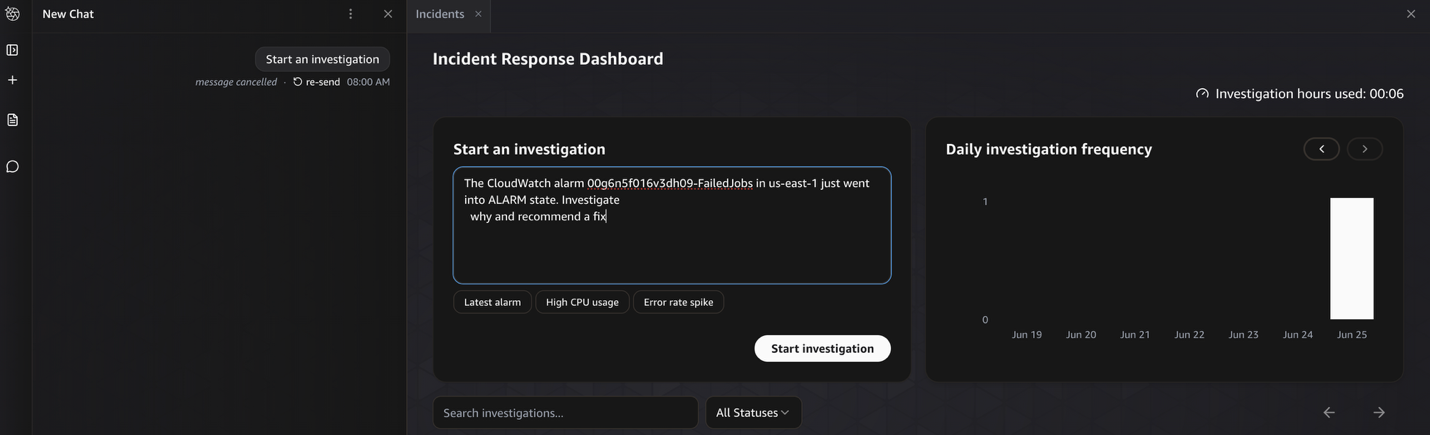
图 7:AWS DevOps Agent 开始调查面板,输入了 Amazon CloudWatch 告警调查提示
代理的调查将原生的 AWS API 工具和你注册的 Apache Spark Troubleshooting MCP 工具串联起来:
use_aws cloudwatch describe-alarms— 获取告警定义并读取其指标维度,识别出该告警限定到 Amazon EMR Serverless 应用程序<DemoApplicationId>。use_aws emr-serverless list-job-runs— 找到该应用程序上最近的 FAILED 作业运行。use_aws emr-serverless get-job-run— 拉取 FAILED 运行的元数据和最后已知错误。spark-troubleshooting analyze_spark_workload— 通过 MCP 能力提供者调用 Apache Spark Troubleshooting Agent for Amazon EMR,传递应用程序 ID 和作业运行 ID。这是进行深入分析的地方。
查看根因和修复
当调查完成时,AWS DevOps Agent 在两个标签页中呈现结果:调查时间线 和 根因。
The 调查时间线 显示代理采取的每一步:加载的技能、原生的 AWS API 调用,以及调用 analyze_spark_workload MCP 工具分析失败的 Spark 作业的时刻。每个条目都可展开,以便你审计输入和输出。
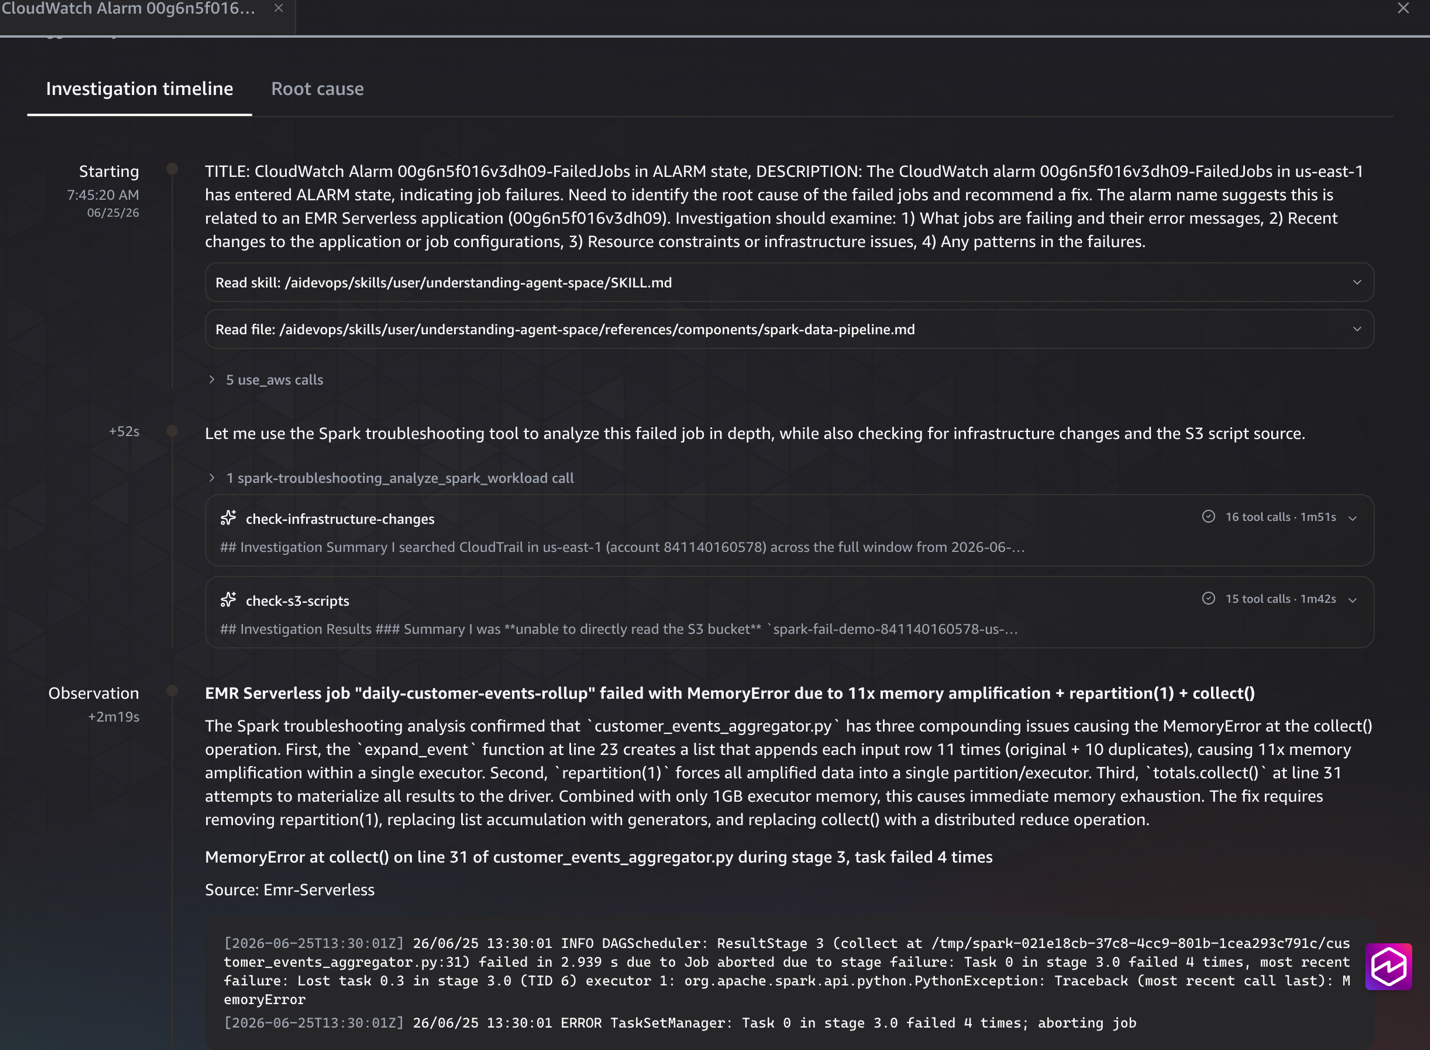
图 8:调查时间线标签页显示代理工具调用序列和 spark-troubleshooting MCP 调用
The 根因 标签页是答案所在。它分为三个部分,反映了一位经验丰富的工程师在事件报告中所写的内容:
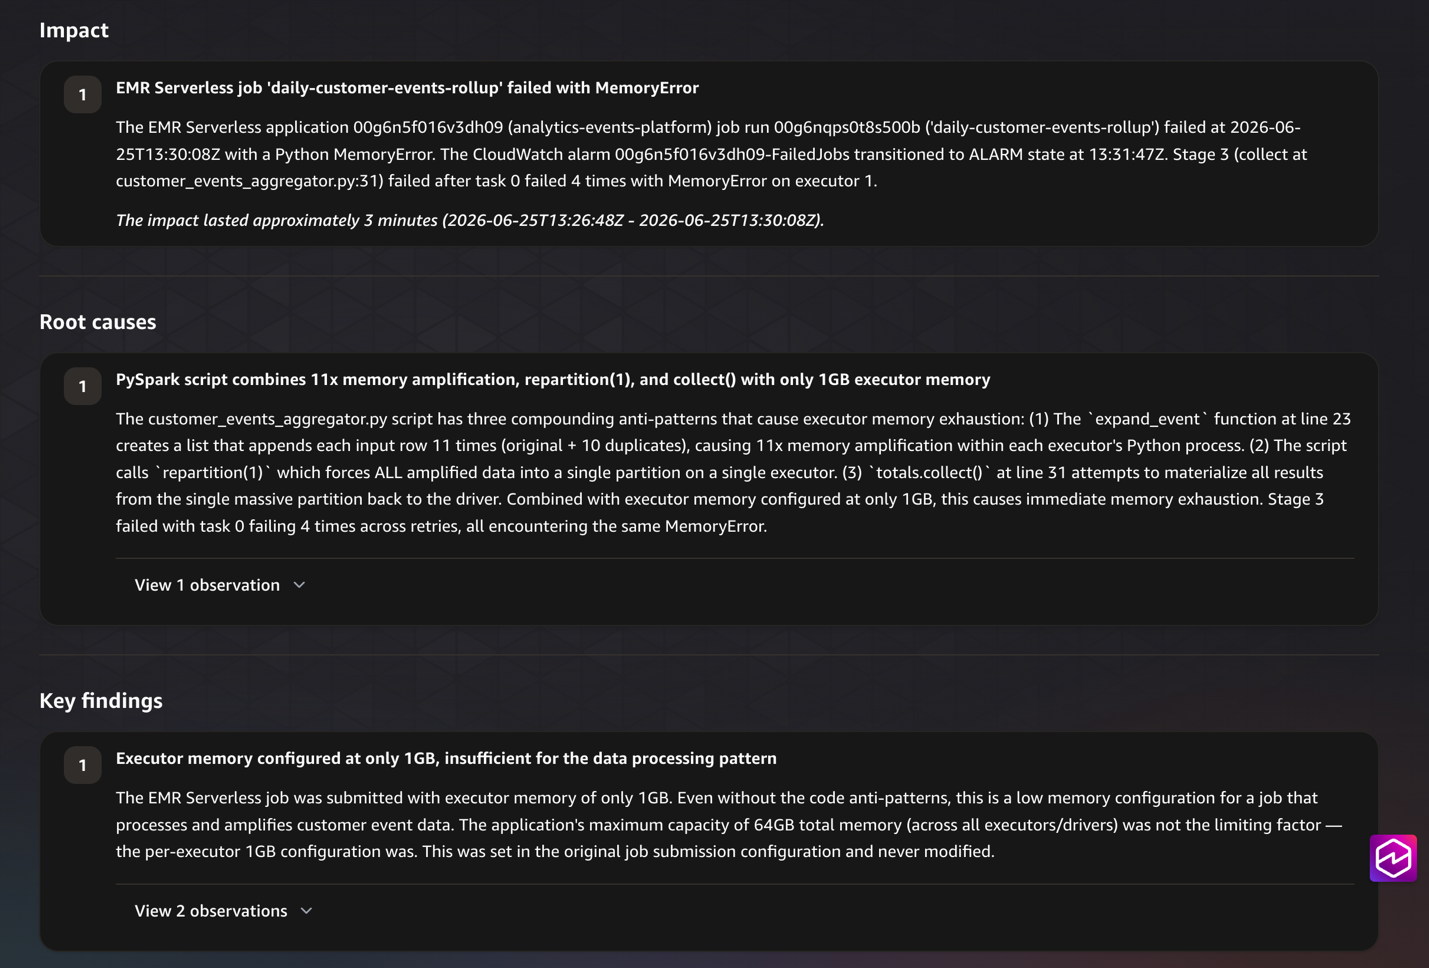
图 9:根因标签页显示影响摘要、确定的根因和 Spark 内存耗尽故障的关键发现
- 影响 — 什么失败了,何时,持续多久。对于我们的演示,这部分指出
daily-customer-events-rollup作业在analytics-events-platform应用程序上失败,并带有MemoryError,并且告警在失败时转换为 ALARM 状态。 - 根因 — 实际的反模式。代理识别出
customer_events_aggregator.py结合了三个叠加的问题:一个expand_event函数(第 23 行)将每个输入行放大 11 倍,一个repartition(1)将所有数据汇聚到单个执行器上的单个分区,以及一个collect()(第31行)将放大后的数据集拉回驱动程序。所有三个都仅使用1 GB的执行器内存运行。 - 关键发现——诊断背后的支持事实,包括执行器内存配置、应用程序的最大容量,以及代理如何从分析的工件中确认每个事实。
反模式识别和支持证据都来自代理只能通过MCP工具访问的工件:Amazon S3中的应用程序源代码、Spark历史服务器事件日志和查询计划。如果没有接入Apache Spark Troubleshooting Agent for Amazon EMR,AWS DevOps Agent会停在“执行器因内存错误退出”这一步。
清理
为避免持续产生费用,请删除您创建的资源。有些资源由AWS DevOps Agent控制台管理,必须先从那里移除。否则,CloudFormation堆栈删除将失败。
- 在AWS DevOps Agent控制台中,打开您的
data-pipeline-troubleshooting代理空间,选择MCP服务器部分,选择spark-troubleshooting,然后选择移除。 - 从代理空间列表中,选择
data-pipeline-troubleshooting并选择删除。 - 在能力提供者中,选择
spark-troubleshooting并选择注销。 - 在能力提供者→私有连接中,选择
smus-spark-private并选择删除。 - 删除AWS CloudFormation堆栈。这将移除Amazon VPC、接口VPC终端节点、安全组、IAM角色、Amazon EMR Serverless应用程序、Spark执行角色、Amazon CloudWatch告警和演示日志存储桶。
aws cloudformation delete-stack \
  --region us-east-1 \
  --stack-name spark-troubleshooting-demo
结论
在本文中,您将Apache Spark Troubleshooting Agent for Amazon EMR作为自定义MCP能力提供者连接到AWS DevOps Agent。您通过AWS PrivateLink将流量保持在AWS网络上,并运行了一个失败的PySpark作业以查看端到端集成。CloudWatch告警触发后,您让代理进行调查,一个聊天会话就返回了根本原因以及代码和配置修复。
您可以将此模式扩展到演示场景之外。考虑将MCP服务器连接到监控生产Amazon EMR环境的代理空间。任何写入历史服务器事件日志的Spark作业都可以通过相同的工作流程进行诊断。
要继续学习,请探索以下资源:
- AWS DevOps Agent文档——了解如何创建代理空间、配置集成和管理调查。
- Apache Spark Troubleshooting Agent for Amazon EMR设置指南——MCP服务器的详细先决条件和配置选项。
- 将MCP服务器连接到AWS DevOps Agent——注册其他MCP服务器以扩展代理的能力。
- GitHub上的示例代码——克隆本演练中使用的CloudFormation模板、PySpark脚本和Parquet数据。
如果您已经将Apache Spark Troubleshooting Agent集成到运营工作流程中,或者正在探索AWS DevOps Agent的其他基于MCP的扩展,我们希望听到您的经验。请在评论中分享您的想法和问题。
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏