Delivery Hero 用 Apache Flink 重建实时广告测量
有效阅读仅保存在当前浏览器,用于「为你」推荐;暂停或清除记录。
DataHot 速览
Delivery Hero 与 AWS 合作,将其广告测量管道从小时级批处理迁移到 Amazon Managed Service for Apache Flink 的实时流处理。该平台每秒处理数万条消息、每天数十亿广告事件,支撑 2025 年近 15 亿欧元的广告收入,覆盖约 65 个国家和超过 150 万餐厅及本地商户。新管道把基础设施成本降低一半以上,并达到旧系统无法实现的数据质量。旧系统按处理时间而非事件发生时间分桶,并通过同步 API 查询活动元数据,扩展后暴露出事件时间语义缺失和处理缓慢等结构性问题。
为什么值得关注:这是实时流处理在广告计费与测量场景中的一线工程实践,展示了事件时间语义、成本优化和数据质量之间的具体权衡,对构建实时数据平台有参考价值。
本文目录 11 节
译文
AI 逐段翻译本文由 Delivery Hero 的 Kirill Tishenkov、Alexandru Pisarenco、Upendra Kambhampati 和 Sabariesh Ganesan 共同撰写。
实时广告衡量是广告领域较难的流式处理问题之一。每一次曝光和点击都必须足够准确,以便向供应商计费;同时又要足够新鲜,以便广告服务器据此采取行动。在本文中,我们介绍 Delivery Hero 如何将其广告衡量管道从每小时批处理迁移到基于 Amazon Managed Service for Apache Flink 的实时处理。Delivery Hero 总部位于德国柏林,是全球领先的本地配送平台之一,业务遍及亚洲、欧洲、拉丁美洲、中东和北非。Delivery Hero 与约 65 个国家/地区的超过 150 万家餐厅合作伙伴和本地供应商合作,每天处理数百万份食品、杂货和日常必需品的订单。
Delivery Hero 业务的核心是一个广告平台,它将供应商和品牌与数百万活跃消费者连接起来。该平台每秒处理数万条消息,每天处理数十亿个广告事件,支撑着 2025 年达到近 15 亿欧元的广告收入流。每一次投放的曝光和记录的点击都必须同时满足两个要求。数据必须足够准确,以便公平地向供应商计费;同时又要足够新鲜,以便广告服务器实时采取行动。Delivery Hero 用基于 Amazon Managed Service for Apache Flink 构建的全实时管道替换了面向批处理的衡量系统。新管道将基础设施成本削减了一半以上,并达到了旧系统无法企及的数据质量水平。
旧系统面临的挑战
旧版广告衡量系统从消息队列中消费曝光、点击和订单事件。它通过同步 API 调用获取广告活动元数据和产品查找信息来丰富这些事件,然后将每小时聚合的指标写入报告数据库。这种设计在中等规模下可以正常工作,但随着流量增长,出现了五个结构性问题。
没有事件时间语义,且处理速度慢。该管道按处理事件的时间而非事件发生的时间对事件进行分桶,因为大多数事件到达时没有可用的事件时间戳。结果在内部是一致的,但每当摄取滞后或事件乱序到达时,结果就会发生偏差。这扩大了每个对时间敏感的指标的误差范围,包括广告支出回报率(ROAS)。更大的代价是速度。指标按每小时批次汇总,因此事件发生时间与记录时间之间的平均间隔为 61 分钟。平台对点击和曝光的反应最多滞后一小时,对于预算节奏控制或广告投放来说太晚了。
同步丰富限制了系统的扩展能力。丰富是将业务上下文附加到原始广告事件的步骤:它属于哪个广告活动、由哪个供应商拥有,以及宣传的是哪个产品。在旧系统中,每个事件都会触发一连串阻塞式外部 API 调用来获取该上下文。在流量高峰期间,例如限时抢购或返校季激增,耗尽的连接池会同时级联影响计费、广告投放和报告。没有背压机制,也无法独立于事件摄取来扩展丰富步骤。
管道背后的数据库是为一种截然不同的访问模式构建的。该管道将其工作数据保存在一个 NoSQL 文档数据库中:去重键、归因历史和累计总计。平台从其前流式处理时代继承了该数据库,当时广告衡量看起来就像文档存储和检索。随后工作负载演变为持续去重、多日归因查找和滚动聚合。每个事件最终都会触发一次完整的文档读写,而该数据库是为偶尔访问而非逐事件变更设计的。读写放大存储的数据远超逻辑所需,每次写入都会触发索引更新和集合扫描,存储成本与查询延迟同步增长。在峰值负载下,这常常导致生产中断。
重新处理是一项工程,而不是一种能力。从 bug、流量激增或损坏的上游批次中恢复,需要为每个消费系统使用不同的工具。计费重放是 Google Cloud BigQuery 表、Pub/Sub 主题和自定义 CLI 脚本的手工组合。报告重放作为单独的每日 Airflow 作业运行,每天花费一小时,时间跨度六个月。广告活动和积分事件则完全没有重放路径。每次恢复都是一次跨团队的协调工作。每一种无法重放的事件类型,都代表着一类只能在事后手动修补的问题。
不完整的事件上下文破坏了下游数据质量。丰富是同步且尽力而为的,因此管道仍会写入查找失败或到达时格式错误的事件,使其字段留空。管道没有机制在之后恢复缺失的上下文。其中三个缺口最为重要:
- 缺失会话率:即到达时没有可用会话 ID 的事件占比,导致该交互无法关联到其所属的用户浏览会话。在 30–40% 的情况下,大约三分之一的事件无法追溯到会话,破坏了任何会话范围的分析或功能。
- 缺失客户标识符(ID):即没有客户 ID 的事件占比,切断了广告交互与产生该交互的客户之间的联系,削弱了归因和个性化。
- 缺失曝光时间戳:即缺少可靠事件时间戳的曝光事件占比(与前面描述的处理时间回退的根因相同)。在 91% 的情况下,大多数曝光没有可信的事件时间,迫使采用处理时间近似,并扩大了每个基于时间的指标的误差范围。
这些遗漏悄然传播到报告指标以及机器学习(ML)模型所消费的会话级特征中,这些模型用于广告活动排序、转化率估算和异常检测。
为什么选择 Amazon Managed Service for Apache Flink
团队设定了三项不可妥协的要求。第一,容错数据处理,以消除数据丢失。第二,有状态流处理,能够在低成本、低延迟的存储中保存多天的交互历史。第三,全托管基础设施,使工程师能够专注于应用逻辑而非集群运维。
团队选择了 Apache Flink,因为它原生地满足了全部三项要求,无需外挂外部系统。其事件时间水位线模型有助于将乱序事件放入正确的时间窗口,即使它们迟到也是如此。其 RocksDB 状态后端将大量键控状态保存在磁盘上,而不给 Java 虚拟机(JVM)堆带来压力。
团队选择了 Amazon Managed Service for Apache Flink,而非在 Amazon Elastic Kubernetes Service(Amazon EKS)上自托管 Flink,以消除管理 JobManager、TaskManager 和检查点存储的运维负担。Amazon Kinesis Data Streams 作为上游事件总线,包含两个流:一个用于用户事件动作(展示和点击),一个用于订单。团队在此拓扑下选择了 Kinesis Data Streams 而非 Amazon Managed Streaming for Apache Kafka(Amazon MSK),以实现成本效益。
Amazon DynamoDB 保存广告活动和产品参考数据,通过 Flink 的 Async I/O API 查询以丰富事件,而不会阻塞处理管道。AWS Secrets Manager 存储广告事件解密密钥,在作业启动时获取一次。Amazon Simple Storage Service(Amazon S3)以 Avro 格式存储细粒度事件日志,并作为 Flink 状态的增量检查点存储。Amazon EventBridge Pipes 在最小可行产品(MVP)阶段将 Amazon Simple Queue Service(Amazon SQS)桥接到 Kinesis,无需任何自定义代码,将投产时间缩短了两周。
解决方案架构
下图展示了端到端管道。
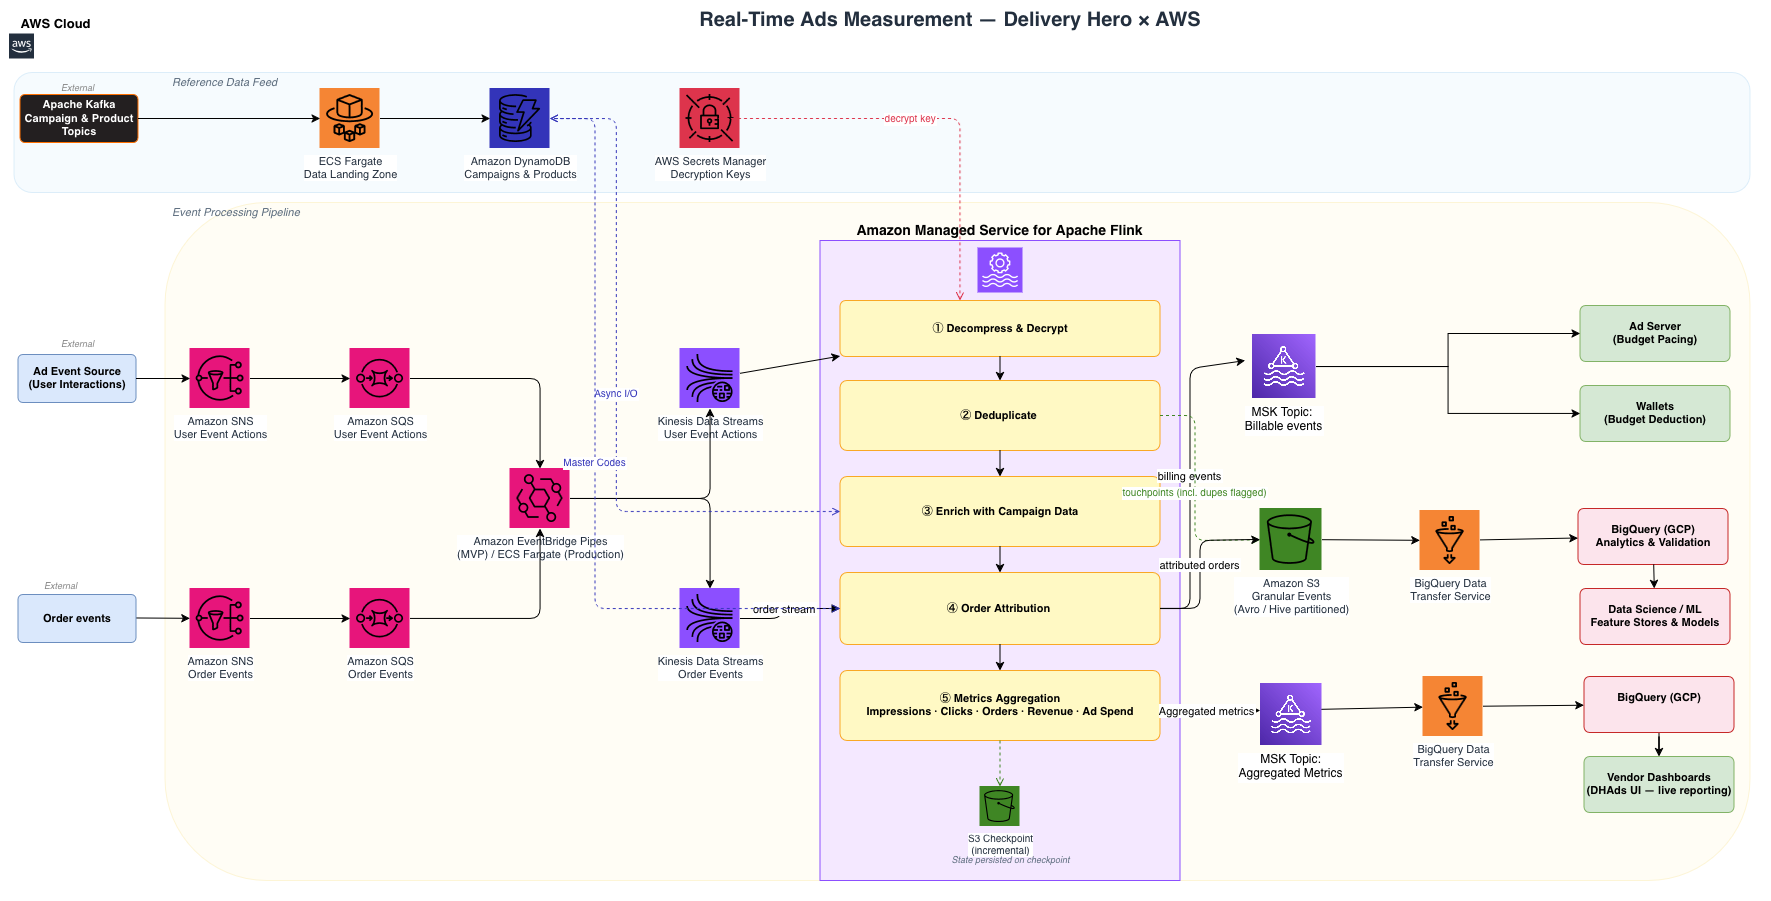
图 1:实时广告测量管道的端到端架构
两个 Amazon Simple Notification Service(Amazon SNS)主题接收事件:一个接收用户事件动作(包含广告活动、供应商和展示位置元数据的压缩加密广告令牌),另一个接收订单事件。Amazon SQS 对两者进行缓冲,然后 Amazon EventBridge Pipes(MVP)或 AWS Fargate 服务(生产)将它们转发到 Kinesis。
Amazon Managed Service for Apache Flink 运行一个五阶段 Java 管道:
- 解压和解密。 管道使用来自 AWS Secrets Manager 的密钥解密广告事件令牌。
- 去重。 管道以实体、广告、事件和客户标识符的组合为键对事件进行键控。Flink 的 RocksDB 状态在 30 小时窗口内跟踪已见事件(约 20 GB 状态),过滤重复项,同时将其保留在 Amazon S3 中以供审计。
- 丰富。 Flink 的 Async I/O API 并发查询 Amazon DynamoDB 以获取广告活动元数据和产品主代码,由 AWS Fargate 消费者从上游 Kafka 主题持续填充。
- 归因。 多天的键控区间连接在实体、客户、供应商和广告活动维度上将用户事件动作与后续订单匹配(约 100 GB 状态)。此阶段将已归因订单输出到 Amazon S3。
- 聚合。 管道在 RocksDB 状态中累计展示、点击、订单、收入和广告支出指标,然后每 5 分钟批量更新插入到报告数据库。
管道将计费事件(每千次展示成本(CPM)展示和有效每次点击成本(CPC)点击)输出到 Apache Kafka 主题。广告服务器和预算服务实时消费这些主题。Flink 将所有状态增量检查点到 Amazon S3,因此作业在失败后从最后一个检查点恢复。Kinesis Data Streams 和上游源提供至少一次投递,第 2 步中的去重阶段会丢弃恢复期间重放的任何事件。因此,尽管底层传输是至少一次,计费实际上是恰好一次。
结果和影响
重新设计的架构在数据保真度、处理吞吐量和运营支出方面实现了可量化的性能提升,同时引入了在遗留模型下无法实现的能力。
处理延迟:从小时级窗口到实时
事件发布到被记录之间的平均间隔从 61 分钟降至 1.2 秒。预算节奏和聚合指标现在反映的是几秒内的活动,而不是下一个小时。下游广告投放和预算节奏系统基于实时信号行动,而不是事后对账。
成本效率
迁移将每月运营成本降低了约 57%,使该管道的年度运行成本减少了一半以上。节省的同时可靠性更强,而不是以牺牲可靠性为代价。
系统可靠性
持久的归因窗口。 多天归因窗口存在于 RocksDB 支持的键控状态中,本地 TaskManager 磁盘上约 100 GB,增量检查点到 Amazon S3。无论状态大小如何,按键查找都保持在低毫秒范围内,崩溃或分片重新平衡会从最后一个检查点恢复状态,而不是触发对账作业。
弹性取代脆弱性。针对 DynamoDB 的异步 I/O 移除了此前对每个事件进行门控的同步富化链。该管道在峰值时每秒可维持 20,000 条消息,且不会将背压泄漏到广告投放或计费中,富化也可独立于摄入进行扩展。闪购和季节性高峰不再威胁上游系统。
可重放的历史记录。该管道在每条原始事件到达的瞬间便将其以 Avro 格式持久化到 Amazon S3,而 Kinesis Data Streams 会将源流保留最多 7 天。当出现逻辑缺陷或下游契约发生变化时,团队会针对原始输入确定性地重新处理受影响的时间范围。无需定制的回填作业,也无需与外部系统进行对账。过去的数据是一等输入,而非冻结的产物。
源头的数据质量
下表比较了迁移前后三个数据质量缺口。
| 指标 | 迁移前 | 迁移后 |
| 缺失会话率 | 30–40% | 0% |
| 缺失客户 ID | 5% | 0.8% |
| 缺失曝光时间戳 | 91% | 0.2% |
下游应用程序现在可接收完全富化的事务和会话上下文。机器学习模型使用会话范围内的特征进行广告活动排名、转化率估算和异常检测。该管道现在从完整的事件流中计算这些特征,而不再是那个约三分之一事件缺失会话上下文、91% 的曝光缺失可靠时间戳的事件流。
下一步计划
此处描述的管道是计划迁移到 Amazon Managed Service for Apache Flink 的多个项目中的第一个。团队正在将相同的架构扩展到更多广告形式,并将实时 Flink 聚合直接连接到广告投放层,以实现亚秒级预算节奏控制。为衡量而构建的实时数据层也可作为 AI 驱动用例的基础。团队计划探索实时用户交互流,为个性化排名模型和基于事实的大语言模型(LLM)推荐提供数据,这些在以批处理为导向的基础设施中是不切实际的。
结论
Delivery Hero 迁移到 Amazon Managed Service for Apache Flink 表明,有效实现精确一次计费、多天有状态归因和可管理的运营复杂性并非相互竞争的目标。使其奏效的组合是:用于摄入的 Kinesis Data Streams、用于低延迟富化的 DynamoDB、用于事件存储和检查点的 Amazon S3,以及用于快速交付 MVP 的 Amazon EventBridge Pipes。它们共同构建了一个比其所替代的系统更准确、更具弹性且成本更低的系统。对于计费准确性和归因正确性属于商业必需品的广告平台而言,该架构提供了一条从批处理近似到实时衡量的可复制路径。
要开始在 AWS 上使用 Apache Flink,请参阅 Amazon Managed Service for Apache Flink 开发人员指南。
其他资源
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏