AWS 在 Amazon EMR on EKS 上支持 Spark Connect
DataHot 速览
AWS 宣布在 Amazon EMR on EKS 上支持 Spark Connect,起始版本为 EMR 7.14(Apache Spark 3.5.8)与 emr-spark-8.1(Apache Spark 4.1.1)。开发者可在 VS Code、PyCharm、Jupyter、SageMaker Unified Studio 等本地工具中构建、测试和调试 PySpark 应用,实际计算则路由到 EKS 上的 Spark 集群执行。该能力基于客户端-服务端架构,通过 gRPC/TLS 连接,旨在解决本地环境与远程集群之间的依赖冲突和规模性能差异。每个 Spark Connect 会话可使用独立的 IAM 执行角色与自定义标签,便于权限隔离和成本追踪,AWS 还提供了端到端示例 notebook。
为什么值得关注:Spark Connect 把交互式开发与 EKS 上弹性 Spark 计算解耦,是数据平台在湖仓处理与开发体验上的基础设施级变化,影响 CI/CD 数据质量测试、Notebook 交互开发等工程实践。
本文目录 20 节
译文
AI 逐段翻译今天,我们宣布在 Amazon EMR on EKS 上支持 Spark Connect,从 EMR 版本 7.14(Apache Spark 3.5.8)和 emr-spark-8.1(Apache Spark 4.1.1)开始。现在,你可以使用自己偏好的工具(例如 VS Code、PyCharm、Jupyter notebooks、Amazon SageMaker Unified Studio)构建、测试和调试 Spark 应用程序。同时,你的全规模 Spark 操作运行在 Amazon Elastic Kubernetes Service (Amazon EKS) 上。
从本地开发环境将 Spark 应用程序部署到远程 Amazon EKS 集群,往往意味着要处理环境差异、依赖冲突以及规模化时的性能差距。Spark Connect 消除了这种摩擦。它将你的应用程序客户端与 Spark 服务器分离,因此你可以在本地开发和调试,而 Spark Connect 会将你的操作路由到运行在 Amazon EKS 上的可扩展 Spark 集群。
这种客户端-服务器架构支持一系列用例,包括从 notebooks 和 IDE 进行交互式开发、在 Web 服务中嵌入 Spark,以及持续集成和持续交付(CI/CD)数据质量测试。所有这些都运行在你现有的 EKS 基础设施上。每个 Spark Connect 会话使用自己的 AWS Identity and Access Management (IAM) 执行角色、自定义标签和成本跟踪。有关更多信息,请参阅 Amazon EMR on EKS 文档。
以下是在 Amazon SageMaker Unified Studio Notebooks 和 VS Code 本地 IDE 中使用 Spark Connect 的两个演示:
Amazon SageMaker Unified Studio Notebooks 演示:
本地 IDE 演示:
如需在 IDE 中运行可执行的端到端示例,请尝试 Spark Connect 示例 notebook,它位于 aws-emr-utilities 仓库中。其中包含一个由 AWS 架构师构建的客户端封装解决方案,用于简化连接:
Spark Connect 如何在 Amazon EMR on EKS 上工作
Spark Connect 使用客户端-服务器架构,将应用程序代码与 Spark 引擎分离:
- 客户端 – 一个运行在你的环境中(例如 IDE 或 notebook)的轻量级 PySpark 库。它不需要安装 Spark、不需要直接访问数据,也不需要按工作负载规模配置资源。
- 连接(EMR 托管端点)– 客户端通过安全的 gRPC/TLS 通道将 Spark 操作发送到 Spark Connect 服务器。
- 服务器 – 在你的 Amazon EMR on EKS 命名空间中运行 Spark pods,最少从两个执行器(可调整)开始,并具有自动扩缩能力。服务器使用 EKS 计算资源执行 Spark 操作,并通过作业执行角色访问数据存储,例如 Amazon Simple Storage Service (Amazon S3) 存储桶。
- 结果 – 服务器通过 gRPC 将查询结果以 Apache Arrow 编码的行批次流式传回客户端。
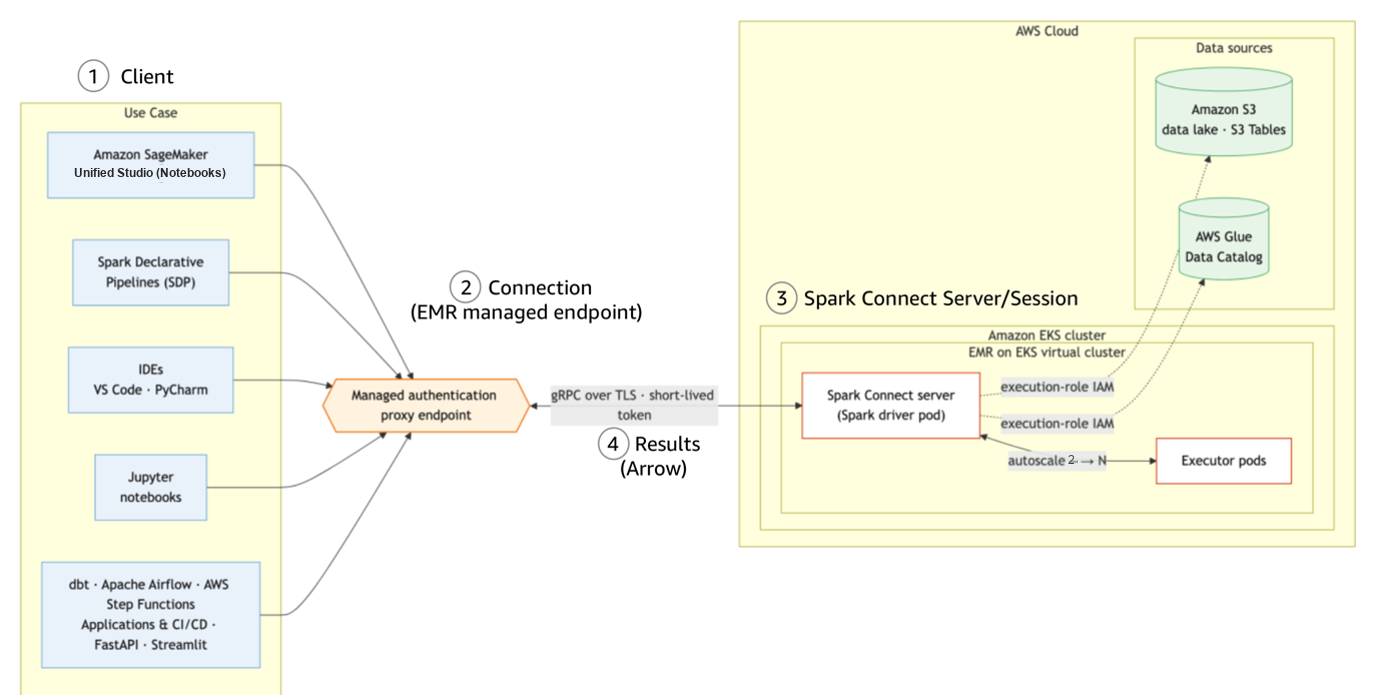
图 1:Spark Connect 的客户端-服务器架构
在创建端点时,Amazon EMR on EKS 会将 Spark Connect 服务器作为 pods 启动在 EKS 上,并返回一个由 Elastic Load Balancing (ELB) 支持的端点以及一个短期令牌。你无需手动配置任何服务器或网络。由于 Spark Connect 服务器运行在你已经运营的 EKS 集群上,它会继承节点类型、容器镜像和 Spark 配置。你在客户端开发 Spark 应用程序时看到的内容,就是 EKS 环境中规模化运行的内容。
为了提供安全、简化的体验,Amazon EMR on EKS 在 EKS 集群上首次使用 Spark Connect 时会额外配置两个组件:

图 2:EKS 集群上的共享 Envoy 路由器和 Secret Agent 服务
- 托管身份验证代理路由器 – 一个共享 Envoy 路由器,默认有三个副本(可调整),前端是 Network Load Balancer (NLB)。它将客户端流量路由到正确的服务器 pods,终止 TLS,并验证会话令牌。一个路由器服务于 EKS 集群上的 Spark Connect 端点。
- Secret Agent 服务 – 一个轻量级、长期运行的 pod,用于管理会话身份验证的短期凭证。每个 EMR 安全配置一个服务。
这些组件长期运行并在端点之间共享。Amazon EMR on EKS 会在集群上创建第一个端点时自动创建它们。由于路由器是集群范围的,而 Secret Agent 是命名空间范围的,删除托管端点不会移除它们。它们会继续运行,以便新端点可以在一分钟内启动。路由器的副本数可调整。对于非生产环境,可以缩减以降低成本,或者扩展以提高吞吐量。
要完全移除这些组件:
- 终止所有活动的托管端点及其引用 Secret Agent 安全配置的虚拟集群,然后删除该安全配置。
- 一旦最后一个启用会话的虚拟集群被删除,身份验证代理路由器及其底层资源(包括 NLB 和 VPC 端点)将自动移除。
- 或者,删除 EKS 集群以一次性移除所有集群内组件。
为什么在 Amazon EMR on EKS 上使用 Spark Connect
借助 Amazon EMR on EKS,团队可以在共享 Kubernetes 集群上与其他应用程序一起运行 Spark,并利用现有基础设施、运维工具和系统专业知识。Spark Connect 将这一价值扩展到交互式、嵌入式和自助式 Spark 工作负载。你的客户端保持轻量,而 Spark 代码在 EKS 上受治理且可扩展的服务器 pods 中运行。
在共享 Kubernetes 集群上进行交互式开发
数据工程师和数据科学家在 notebooks 或本地 IDE 中逐单元格迭代 Spark 代码。Spark 引擎远程运行在 EKS 上,因此验证运行在与你的批处理工作负载相同的引擎上。在 Spark Connect 客户端上验证后,相同的 Spark 代码无需更改即可作为批处理 StartJobRun 部署。
Spark Connect 会话作为 pods 运行在你现有的集群上。它们复用你的 EKS RBAC、网络策略、节点自动扩缩容以及可观测性堆栈(Prometheus、Grafana、Amazon CloudWatch Container Insights)。无需单独运维计算层和监控层。
在应用程序和服务中嵌入 Spark
Spark Connect 客户端是一个紧凑的 PySpark 库。团队可以将 Spark 操作直接嵌入到 Python 应用程序中,例如 Web 服务、仪表板、自动化脚本或后端 API。繁重的处理在 EKS 上运行,而应用程序保持轻量。
团队还可以将 Spark Connect 作为自助式能力暴露在其内部应用程序上。业务用户从 Web UI 提交 Spark SQL 脚本。计算在 EKS 上的 Spark Connect 服务器上运行,因此团队可以集中管理容量、安全和升级。
带治理的多租户数据探索
每个 Spark Connect 会话使用你配置的数据用户的 IAM 权限,将其访问限制在已授权的 AWS 服务、数据湖表和 S3 路径内。每个会话都带有用户、项目、终端节点和虚拟集群 ID 的标签,直接用于计费和合规报告。与此同时,数据生产者对源数据维护防护栏,而不会阻碍自助式探索。
为了跨团队管理资源消耗,Amazon EMR on EKS 虚拟集群提供命名空间级别的隔离。每个租户将其 Spark Connect 终端节点绑定到具有独立 IAM 角色的虚拟集群(命名空间)。使用 资源配额 和 限制范围(在 EKS 上),你可以通过控制 Spark Connect 会话可以使用的计算资源来保护每个虚拟集群。重要的是,激活 EKS 拆分成本分配 标签有助于在多租户环境中进行计费分摊报告。
可复用的容器镜像和可扩展的部署
团队通常维护带有专有库的自定义容器镜像,包括内部特征存储、合规工具包、UDF 或机器学习(ML)框架。借助 Amazon EMR on EKS 上的 Spark Connect,团队可以复用这些相同的镜像作为交互式会话的 Spark 运行时。无需单独的依赖列表。同一镜像既可用于批处理作业,也可用于 Spark Connect 会话。
除了镜像本身之外,你还可以通过 Pod 模板和 托管终端节点 API 在 Amazon EMR on EKS 中控制 Spark Pod 的调度,并在你的环境中进行扩展。例如,你可以:
- 通过 Pod 模板将服务器 Pod 固定到特定的节点类型。例如,使用 Spot 以节省成本。
- 应用 Spark 动态资源分配(DRA)来为每个交互式会话分配合适的资源。
- 使用 GPU 节点池来加速 Spark RAPIDS 或 ML。
cat > /tmp/spark-connect-endpoint.json << EOF
{
  "name": "spark-connect-custom-config",
  "virtualClusterId": "$VC_ID",
  "type": "SPARK_CONNECT",
  "releaseLabel": "emr-7.14.0-latest",
  "executionRoleArn": "$ROLE_ARN",
  "configurationOverrides": {
    "applicationConfiguration": [{
      "classification": "spark-defaults",
      "properties": {
        "spark.kubernetes.container.image": "${CUSTOM_IMAGE_URI}",
        "spark.kubernetes.executor.podTemplateFile": "s3://$S3BUCKET/exec-pod-template.yaml",
        "spark.kubernetes.node.selector.karpenter.sh/nodepool": "gpu-pool",
        "spark.dynamicAllocation.enabled": "true",
        "spark.dynamicAllocation.minExecutors": "0"
      }
    }]
  }
}
EOF

aws emr-containers create-managed-endpoint \
--cli-input-json file:///tmp/spark-connect-endpoint.json
多集群、多区域和混合架构
在多个 AWS 账户、AWS 区域或与本地 Kubernetes 组成的混合环境中运行 EKS 集群的企业,可以使用 Spark Connect 在数据处理所在的位置查询数据。轻量级客户端只需要能够访问 Spark Connect 终端节点,而不需要访问底层 S3 存储桶或 AWS Glue 数据目录。这意味着无需 VPC 对等连接或通往每个数据存储的直接网络路径。
客户端-服务器分离是 Amazon EMR on EKS 上 Spark Connect 的核心架构优势。VPN 后面笔记本电脑上的开发者、集中式服务账户中的 CI/CD 部署管道,或跨区域编排的 Airflow DAG,都可以连接到 EKS 上的远程 Spark 服务器。无论客户端本身在哪里运行,这都可行。这种解耦简化了跨区域或跨账户分析,而无需复制数据或要求直接访问每个数据存储。
开始使用
要在 Amazon EMR on EKS 上创建 Spark Connect 终端节点,请完成以下步骤:
- 在 EKS 上创建 EMR 命名空间。
- 创建 EMR 安全配置。
- 使用该安全配置创建虚拟集群。
- 创建 Spark Connect 托管终端节点。
- 获取会话令牌。
- 从你的应用程序进行连接。
先决条件
要继续阅读本文,请确保你具备以下条件:
- 一个有效的 AWS 账户 并具有创建 Amazon EMR on EKS 资源的权限。
- 一个 Amazon EKS 集群
- 一个 AWS Load Balancer Controller 已安装在你的 EKS 集群上。
- AWS 命令行界面(AWS CLI)2.x >=2.35.23,boto3 >=1.43.48。
- 在 Python 3.8+ 环境中使用 pyspark[connect]==3.5.8(EMR 7.14 的客户端库)。
- 或者在 Python 3.10+ 环境中使用 pyspark[connect]==4.1.1(emr-spark-8.1 的客户端库)。
- 一个作业执行 IAM 角色。
步骤 1:创建 EMR 命名空间
# set environment variables
export EKS_CLUSTER_NAME=my-eks-cluster
export USER_NAMESPACE=spark-connect-1
export SYS_NAMESPACE=spark-connect-1-system
export AWS_REGION=us-west-2
# connect to your EKS cluster
aws eks update-kubeconfig --name $EKS_CLUSTER_NAME --region $AWS_REGION
kubectl create namespace $USER_NAMESPACE
kubectl create namespace $SYS_NAMESPACE
步骤 2:创建安全配置
cat > /tmp/sec-config.json << EOF
{
  "name": "spark-connect-1-sc",
  "securityConfigurationData": {
    "authenticationConfiguration": {
      "identityCenterConfiguration": { "enableIdentityCenter": false }
    }
  },
  "containerProvider": {
    "type": "EKS",
    "id": "$EKS_CLUSTER_NAME",
    "info": { "eksInfo": { "namespace": "$SYS_NAMESPACE" } }
  }
}
EOF

SEC_CONFIG_ID=$(aws emr-containers create-security-configuration \
--region $AWS_REGION \
--cli-input-json file:///tmp/sec-config.json \
--query id \
--output text)
echo "Security Configuration ID: $SEC_CONFIG_ID"
步骤 3:使用该安全配置创建虚拟集群
cat > /tmp/vc.json << EOF
{
  "name": "spark-connect-demo",
  "containerProvider": {
    "id": "$EKS_CLUSTER_NAME",
    "type": "EKS",
    "info": {"eksInfo": {"namespace": "$USER_NAMESPACE"}}
  },
  "securityConfigurationId": "$SEC_CONFIG_ID",
  "sessionEnabled": true
}
EOF

VC_ID=$(aws emr-containers create-virtual-cluster \
--region $AWS_REGION \
--cli-input-json file:///tmp/vc.json \
--query 'id' \
--output text)
# validate the virtual cluster
echo "Virtual Cluster ID: $VC_ID"
aws emr-containers describe-virtual-cluster --region $AWS_REGION --id $VC_ID
步骤 4:创建 Spark Connect 托管终端节点
在你的虚拟集群上启动交互式会话。提供一个作业执行角色,授予会话访问你的数据源的权限。
# reuse an existing execution role
ROLE_ARN="arn:aws:iam::YOUR_ACCOUNT_ID:role/EMRonEKSExecutionRole"
cat > /tmp/spark-connect-endpoint.json << EOF
{
  "name": "spark-connect-demo",
  "virtualClusterId": "$VC_ID",
  "type": "SPARK_CONNECT",
  "releaseLabel": "emr-7.14.0-latest",
  "executionRoleArn": "$ROLE_ARN",
  "sessionIdleTimeoutInMinutes": 1440,
  "configurationOverrides": {
    "applicationConfiguration": [{
      "classification": "spark-defaults",
      "properties": {
        "spark.dynamicAllocation.enabled": "true",
        "spark.dynamicAllocation.minExecutors": "0",
        "spark.dynamicAllocation.maxExecutors": "2"
      }
    }]
  }
}
EOF

EP_ID=$(aws emr-containers create-managed-endpoint \
--region $AWS_REGION \
--cli-input-json file:///tmp/spark-connect-endpoint.json \
--query 'id' \
--output text)
# Validate
echo "Endpoint ID: $EP_ID"
export EP_URL=$(aws emr-containers describe-managed-endpoint \
--region $AWS_REGION \
--virtual-cluster-id $VC_ID \
--id $EP_ID \
--query 'endpoint.authProxyUrl' \
--output text)
echo "Endpoint URL: $EP_URL"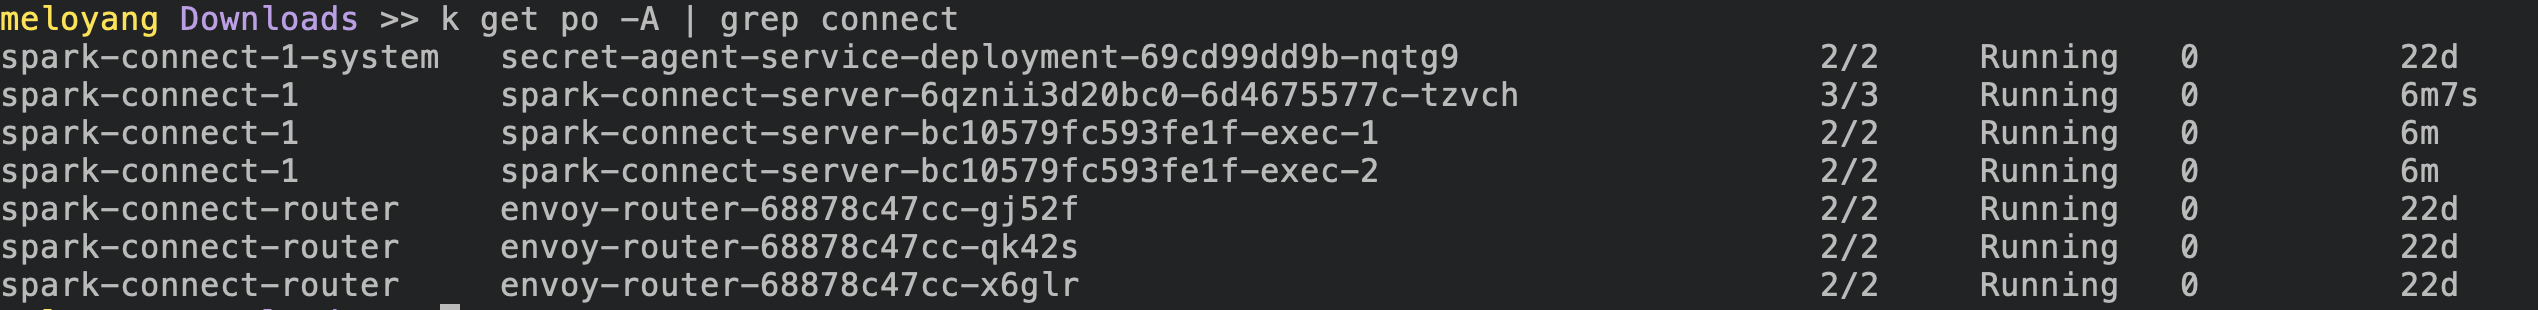
图 3:带有终端节点 ID 和 URL 的托管终端节点创建输出
你可以选择性地传递一些自定义配置覆盖项和标签:
aws emr-containers create-managed-endpoint \
--type SPARK_CONNECT \
--virtual-cluster-id $VC_ID \
--name more-endpoint \
--execution-role-arn $ROLE_ARN \
--release-label emr-7.14.0-latest \
--configuration-overrides '{
"applicationConfiguration": [{
"classification": "spark-defaults",
"properties": {
"spark.executor.instances": "1",
"spark.executor.memory": "4g",
"spark.executor.cores": "1",
"spark.sql.extensions": "org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions"
}
}]
}' \
--tags '{
"team": "data-engineering",
"project": "customer-analytics"
}'
步骤 5:获取会话令牌
在托管终端节点处于活动状态后请求会话令牌:
# get a session token with a 12-hour expiry (adjustable)
export TOKEN=$(aws emr-containers get-managed-endpoint-session-credentials \
--region $AWS_REGION \
--virtual-cluster-identifier $VC_ID \
--endpoint-identifier $EP_ID \
--execution-role-arn $ROLE_ARN \
--credential-type TOKEN \
--duration-in-seconds 43200 \
--query 'credentials.token' \
--output text)
echo "Session Token: $TOKEN"安全说明:你的环境与 Spark Connect 服务器之间的通信使用 TLS 加密。身份验证令牌是有时间限制的(默认 15 分钟)。对于长时间运行的会话,请通过再次调用 get-managed-endpoint-session-credentials 定期刷新令牌。考虑使用 AWS Secrets Manager 以编程方式存储和检索令牌。
步骤 6:从你的应用程序进行连接
使用返回的终端节点 URL 和令牌,从兼容 PySpark 的环境进行连接。以下 Python 代码展示了如何建立 Spark Connect 会话:
import os
from pyspark.sql import SparkSession
session_endpoint = os.environ["EP_URL"]
auth_token = os.environ["TOKEN"]
spark_conn_url = (f"{session_endpoint};use_ssl=true;x-aws-proxy-auth={auth_token}")
spark = SparkSession.builder
.remote(spark_conn_url)
.getOrCreate()
# verify the connection
print(f"Connected remotely! Spark version: {spark.version}")
# query data through the AWS Glue Data Catalog
df = spark.sql("SELECT * FROM my_catalog.my_database.my_table LIMIT 10")
df.show()
连接后,你可以:
- 交互式调试 – 在操作远程运行于 EKS 上时,在你的 IDE 或笔记本中设置断点、检查 DataFrame,并逐步执行 Spark 代码。
- 结合本地和远程处理– 将查询结果以 pandas 或 PyArrow DataFrame 的形式拉回客户端,用于本地分析、可视化或 ML(scikit-learn、notebook 小组件),然后在同一会话中将进一步的 Spark 操作推送回服务器。繁重处理留在 Amazon EMR on EKS 上。只有你请求的结果会通过网络传输。
- 不丢失状态地重新连接– 托管端点独立于单个客户端运行,具有可配置的空闲超时(默认:60 分钟)。在连接之间,你的 Spark 会话、缓存数据和临时视图都保留在服务器上。当会话令牌过期时(默认:15 分钟,可配置至最多 12 小时),请求新令牌并重新连接到同一端点,即可从上次中断处继续。
- 跨工作负载类型复用– 相同的客户端连接模式在 Python 运行的任何地方都适用:notebook、IDE、批处理脚本、Airflow 运算符或 Web 服务。一个端点,一种连接模式,多种工作负载类型。
验证
创建端点后,通过 Amazon EMR on EKS API 和标准 Kubernetes 工具验证 Spark Connect 服务器正在运行且可访问:
# get endpoint status
aws emr-containers describe-managed-endpoint --virtual-cluster-id $VC_ID --id $EP_ID
# inspect the server pods (driver + executors) in your namespace
kubectl get pods -n $USER_NAMESPACE -l "emr-containers.amazonaws.com/managed-endpoint-id=$EP_ID"
# View driver logs
kubectl logs -n $USER_NAMESPACE <driver-pod-name> -c spark-kubernetes-driver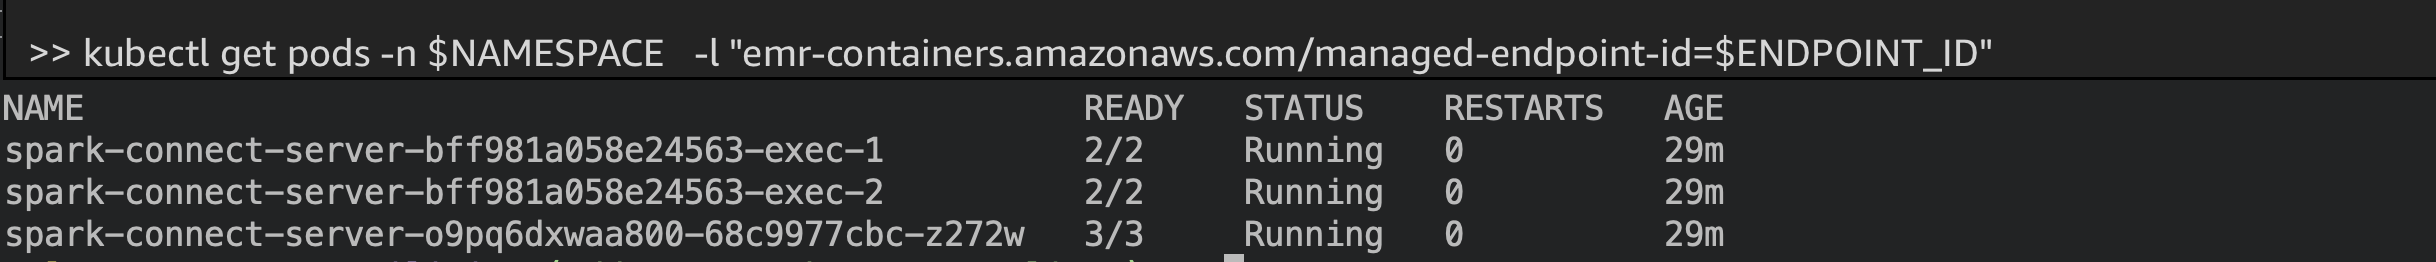
图 4:端点状态以及正在运行的驱动程序和 executor pod
# to view the live Spark UI, port-forward your driver pod:
DRIVER_POD=$(kubectl get pods -n $USER_NAMESPACE \
-l "emr-containers.amazonaws.com/managed-endpoint-id=$EP_ID,emr-containers.amazonaws.com/component=driver" \
-o name)
kubectl port-forward -n $USER_NAMESPACE "$DRIVER_POD" 4040:4040
# Open http://localhost:4040 in your browser
图 5:Spark Connect 会话的实时 Spark UI
Spark Connect 端点作为 pod 在你的 EKS 集群上运行。现有的 Kubernetes 可观测性栈(例如 CloudWatch Container Insights、Prometheus 和 Grafana)会与其他集群工作负载一起捕获 Spark Connect 端点指标。
清理资源
完成后终止会话,以避免持续产生费用:
# (OPTIONAL) Endpoints are auto-deleted after the idle timeout (default: 60 minutes).
aws emr-containers delete-managed-endpoint \
--virtual-cluster-id $VC_ID \
--id $EP_ID
# Delete the virtual cluster only when no active endpoints remain
aws emr-containers delete-virtual-cluster --id $VC_ID
# Delete Security Configuration
aws emr-containers delete-security-configuration --id $SEC_CONFIG_ID
# remove the remaining EKS namespaces
kubectl delete namespace $USER_NAMESPACE $SYS_NAMESPACE spark-connect-router
删除托管端点或使其超时,会自动移除其对应的驱动程序和 executor pod。Envoy 路由器和 Secret Agent 服务在 EKS 集群上的各端点之间共享,并在单个端点终止时继续运行。若要完全移除这些共享组件,请删除虚拟集群以移除其对应的 Secret Agent 服务。在此之前,请确保虚拟集群中没有活动的托管端点。终止最后一个启用了会话的虚拟集群会自动从 EKS 集群中移除 Envoy 路由器。
可用性和定价
Amazon EMR on EKS 上的 Spark Connect 在 EMR 发行版 7.14(Apache Spark 3.5)和 emr-spark-8.1(Apache Spark 4.1)中可用,在 Amazon EMR on EKS 可用的所有 AWS 区域均可使用,但 AWS GovCloud(美国)区域和中国区域除外。Amazon SageMaker Unified Studio 体验在 受支持的区域 可用。
除了标准的 Amazon EMR on EKS 定价外,Spark Connect 托管端点不收取额外费用。你需要为底层 Amazon EKS 资源(例如 EC2 和 ELB)付费。对于超时或终止的托管端点,EMR 会自动从 EKS 集群中移除其 Spark pod。
成本效率建议:
- 使用 Karpenter(或 Cluster Autoscaler)根据会话工作负载需求调整集群容量。这会在端点需要时预置节点,并在空闲时移除它们,从而使成本与实际使用量保持一致。
- 将交互式会话 pod 调度到 按需实例 上以实现持久计算。
- 使用 AWS Graviton 处理器 以获得 Spark 工作负载的更好性能。
- 激活 Amazon EMR on EKS 成本分配 标签,以在细粒度级别跟踪每个团队和每个项目的支出。
- 在集群上保留一个单一、共享的 Envoy 路由器和 NLB 来服务所有 Spark Connect 端点(默认值)。根据你的可用性要求,将路由器副本数(默认三个)调整为合适的大小。
注意事项和限制
在基于 Amazon EMR on EKS 的 Spark Connect 进行构建之前,请查看 Amazon EMR on EKS 文档中的注意事项和限制。
结论
在这篇文章中,我们展示了如何借助 Amazon EMR on EKS 上的 Spark Connect,使用你已经在使用的工具(IDE、notebook、Amazon SageMaker Unified Studio 或 Airflow)构建、测试和调试 Spark 应用程序。你的工作负载在你现有的 Kubernetes 集群上大规模运行,无需更改应用程序代码。
对于已经运行 Amazon EMR on EKS 的团队,Spark Connect 将你的虚拟集群扩展到交互式和嵌入式工作负载。运行批处理 StartJobRun 作业的同一虚拟集群现在也提供 Spark Connect 会话。每个会话作为 pod 在你的 EKS 集群上运行,继承你的节点组、容器镜像和 Spark 配置。每个会话还带有自己的 IAM 执行角色和成本标签。这将对 Amazon EMR on EKS 的投资所具备的安全性、多租户和可观测性扩展到更广泛的用户和用例。
要开始使用,请访问 Amazon EMR on EKS 上的 Spark Connect 文档,尝试 Amazon SageMaker Unified Studio 入门指南,并查看 EMR 7.14 的 Amazon EMR on EKS 发行说明。
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏