用iPhone跑TPC-H:DuckDB对比Databricks集群
DataHot 速览
作者在iPhone 17 Pro上用DuckDB运行TPC-H基准测试(25/50/100/200 GB),对比Databricks Serverless SQL的XS/S/M集群。结果显示iPhone在多数规模下更快,最大规模也具竞争力。Databricks最小集群有24核CPU、128GB内存,成本4.2美元/小时。原因包括DuckDB单节点设计避免shuffle,以及查询规划编译固定成本占比高。
为什么值得关注:这篇实测挑战了大数据必须分布式的假设,用具体基准和成本数据说明现代单机硬件能处理多数实际分析负载,对数据平台选型与成本优化有直接参考价值。
译文
AI 逐段翻译大数据已死。我们这些在过去十年里一直从事数据管理系统工作的人都知道,现实世界的业务数据集要小得多,远不及那些在基准测试中被谈论的数据集。而人们了解得更少的是,日常硬件已经变得快了多少。曾经需要分布式系统才能完成的工作负载,如今在一部 iPhone 上就能运行。为了证明这不是夸张,我直接就这么做了。
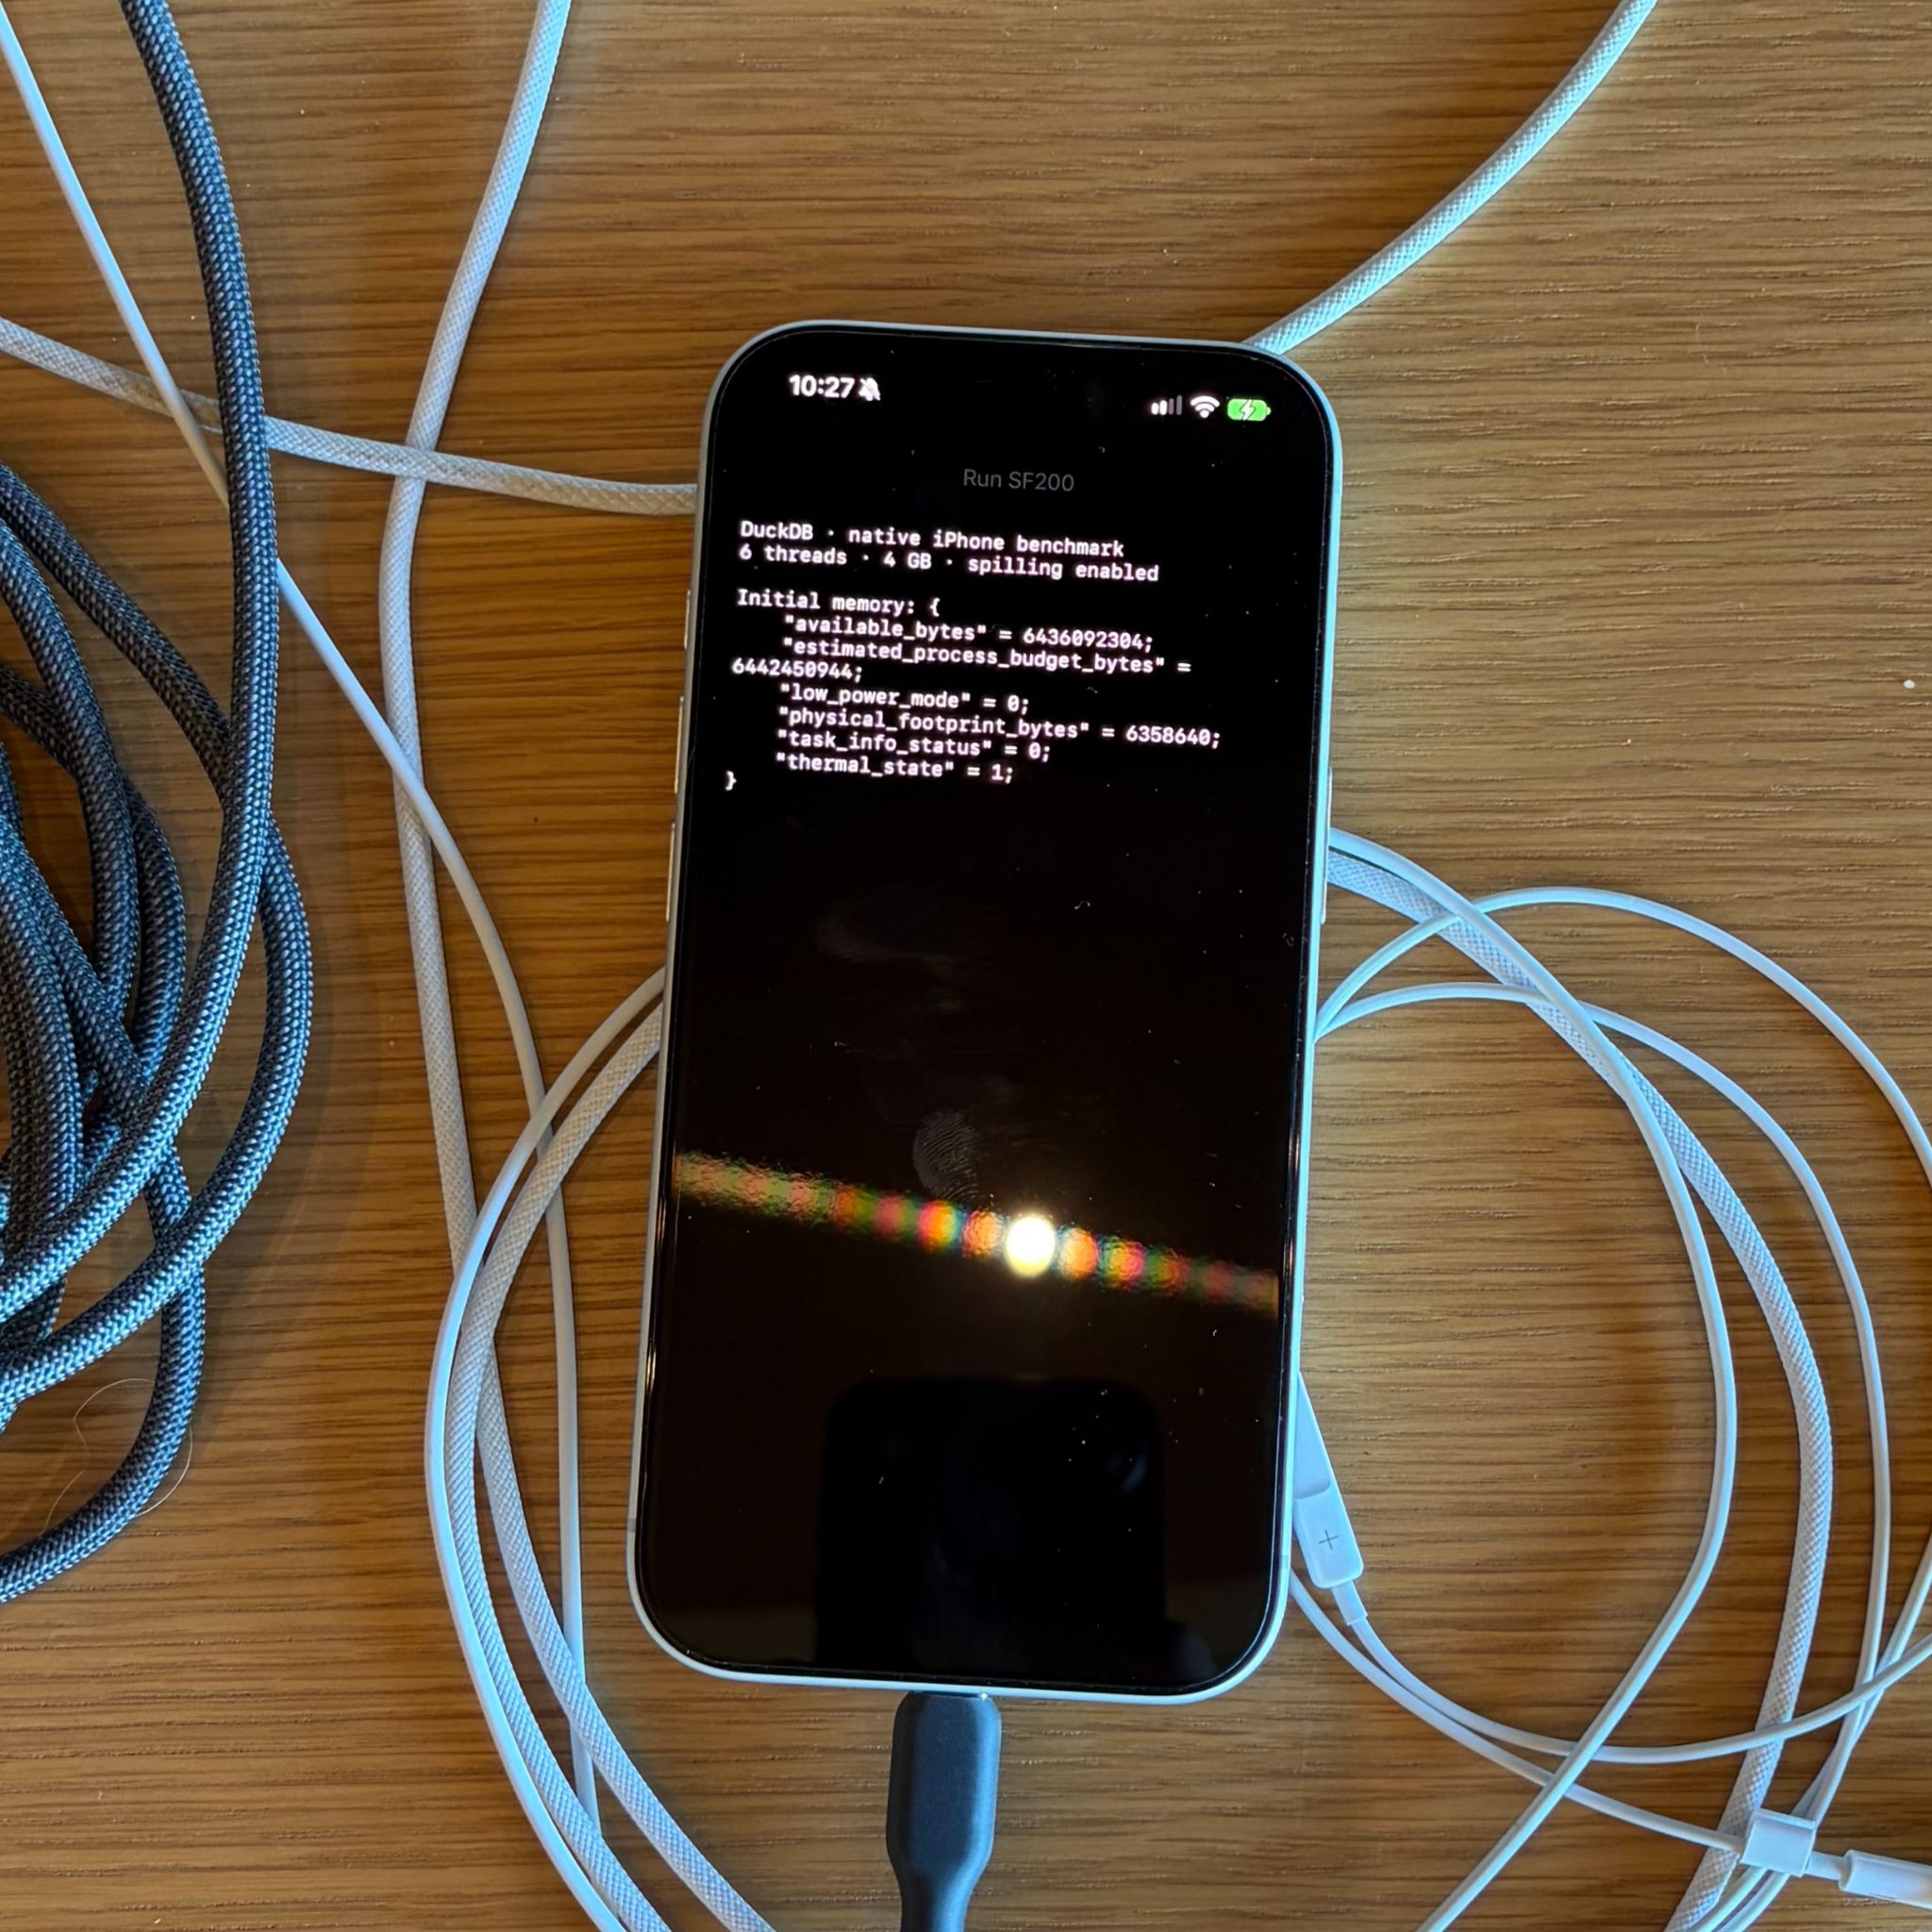
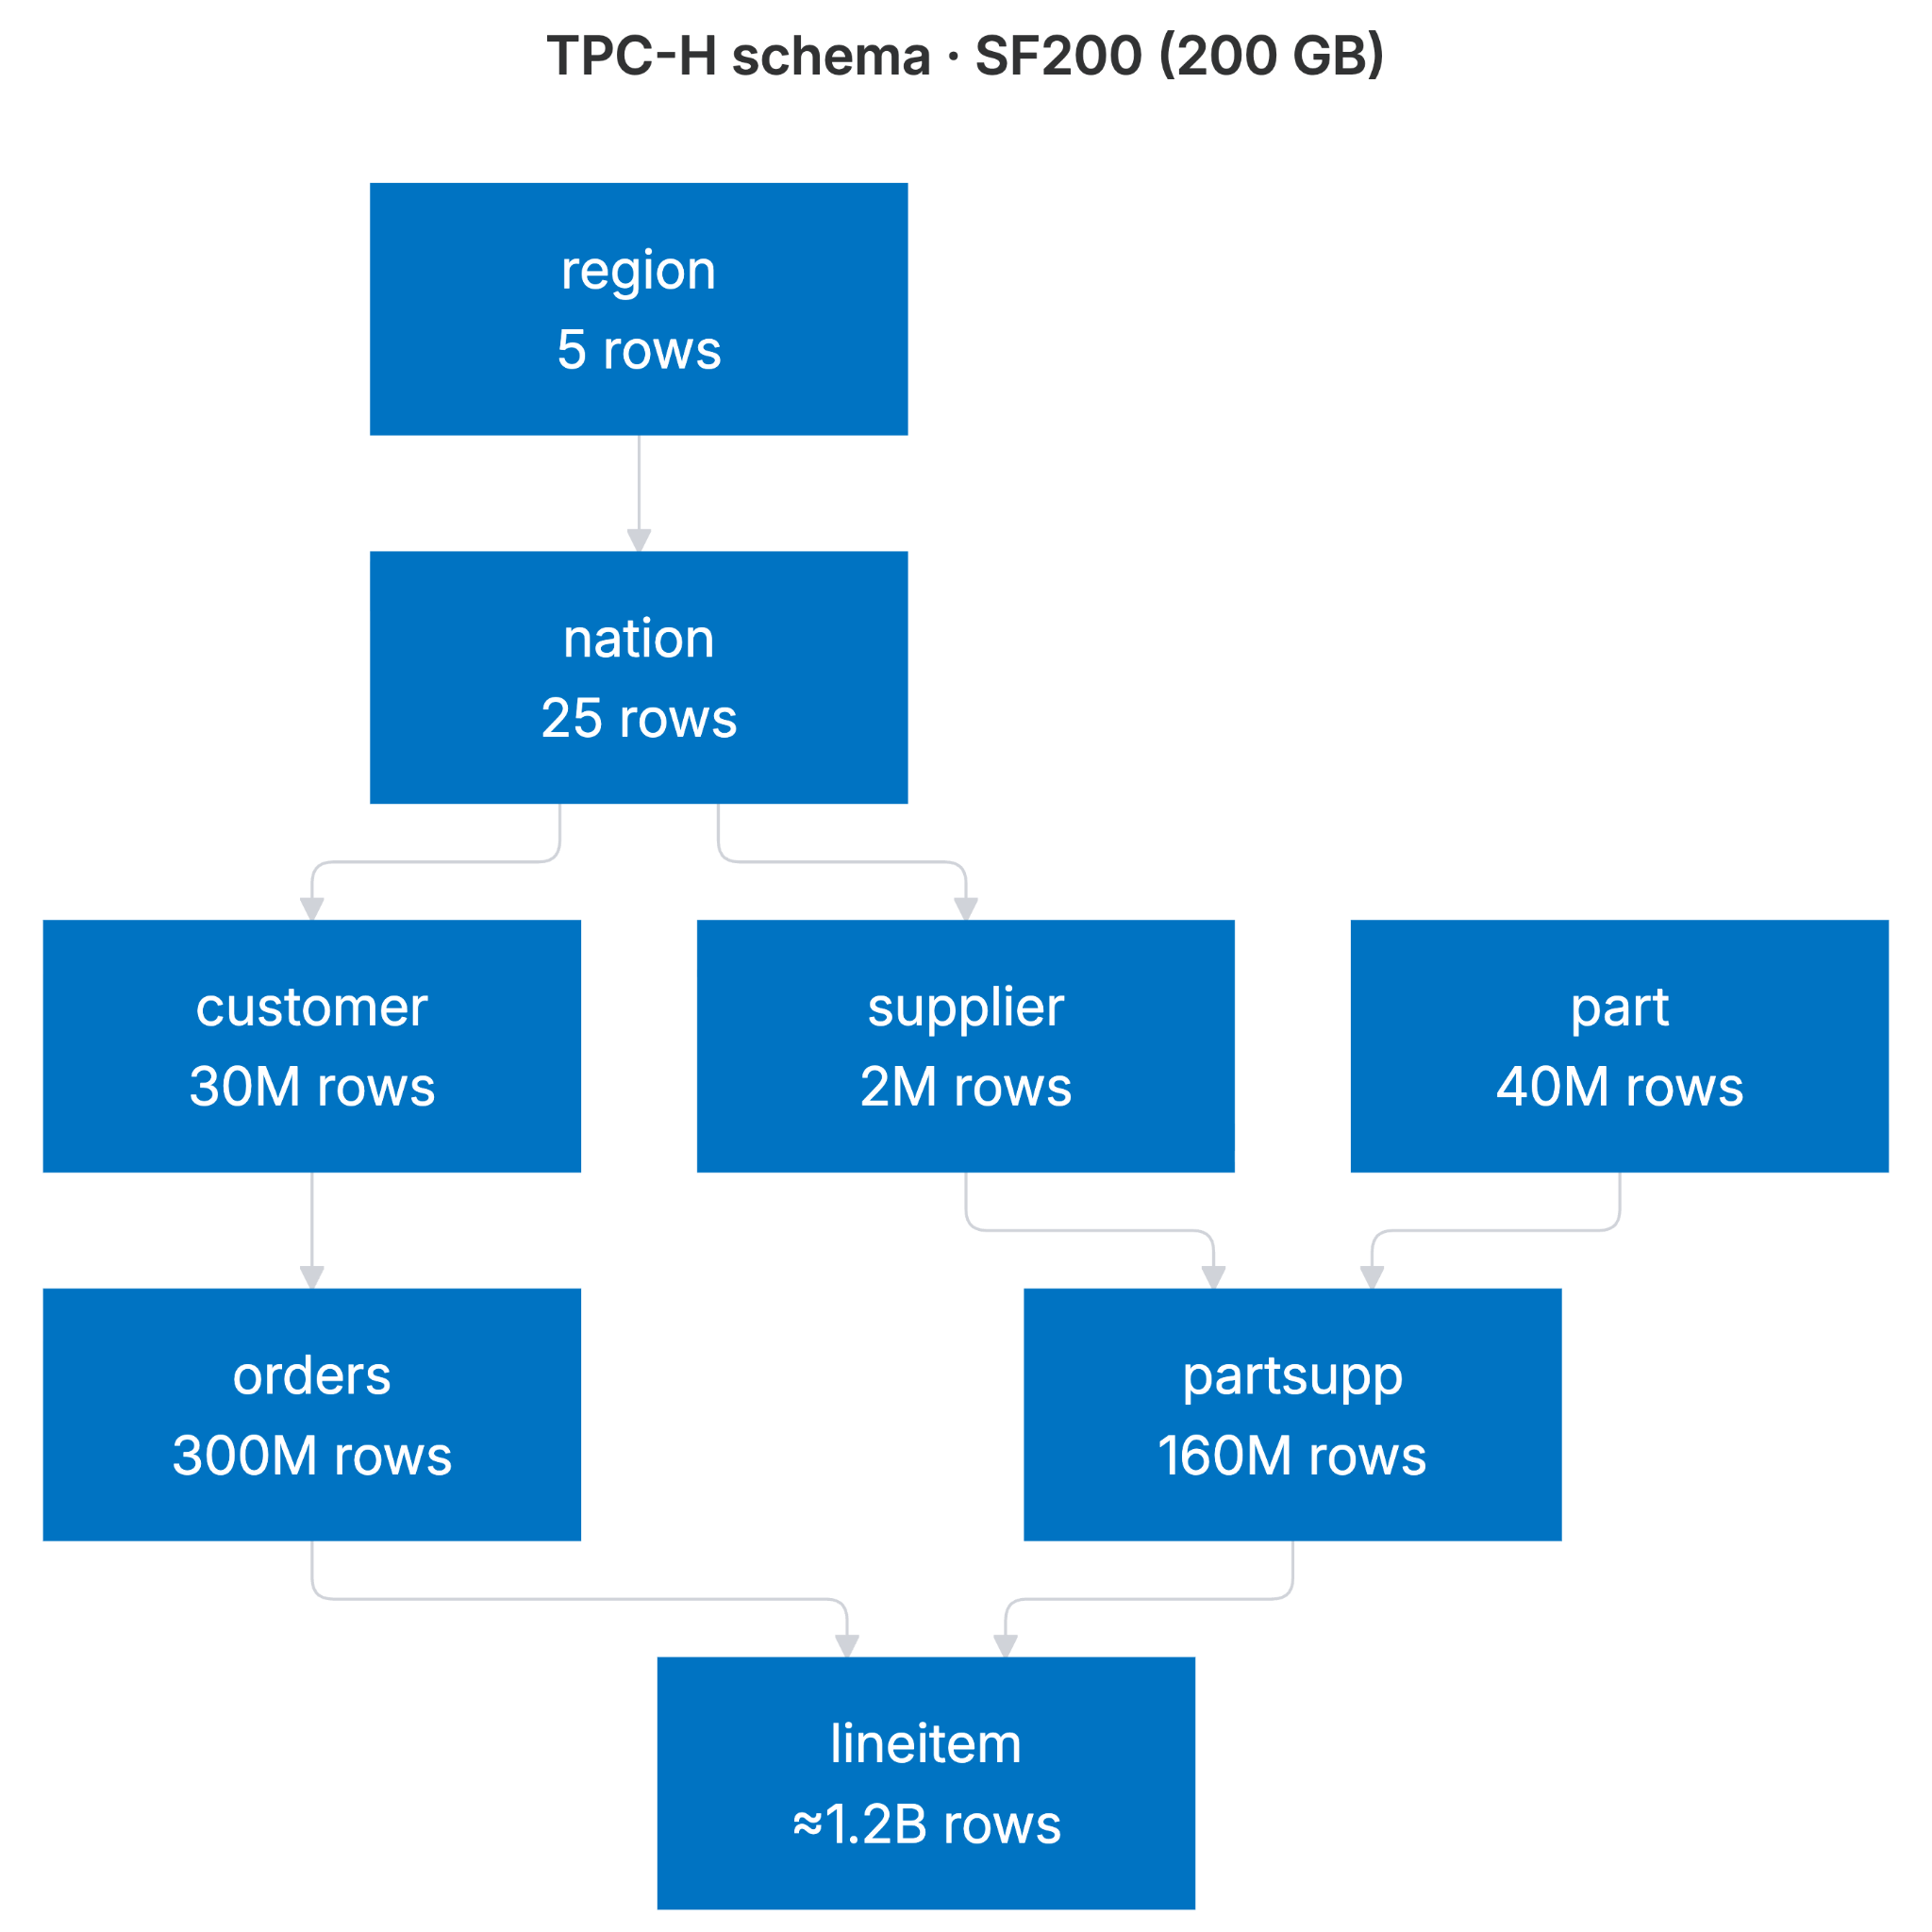
我选择的工作负载是 TPC-H。TPC-H 是一组针对一个虚构批发供应商数据库的 22 条分析查询。
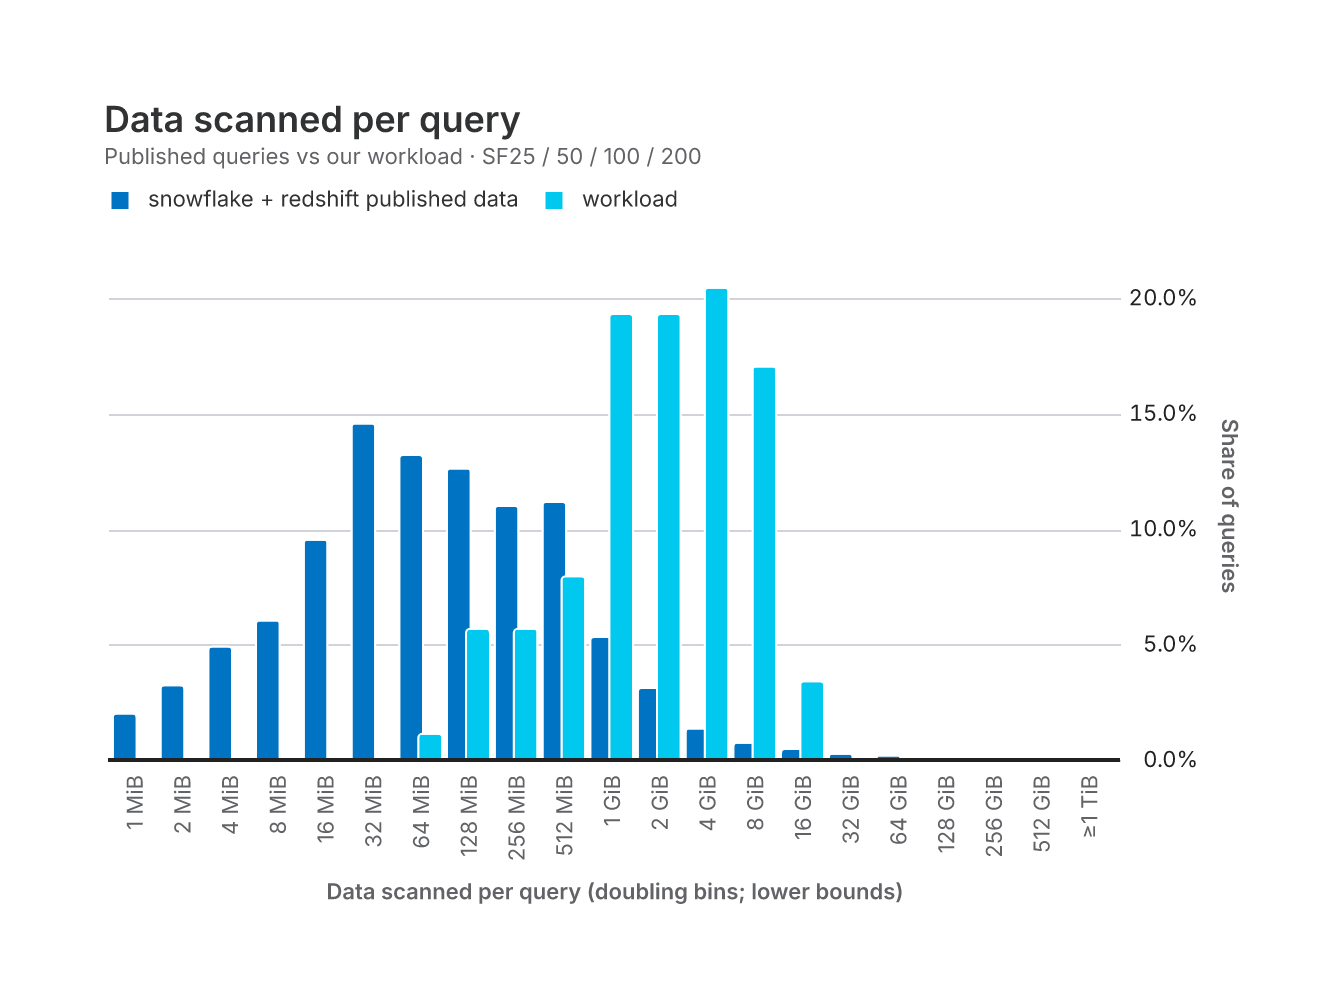
TPC-H 可以按不同规模生成。我想选择一个能代表现实业务用户工作负载高端的规模。Snowflake 和 Amazon 都公布过关于查询规模在现实世界中分布的统计数据,我们可以用它来校准我们的基准测试。我运行了 4 个规模,25、50、100 和 200 GB,以近似现实世界分布的高端。
我在手机上使用DuckDB运行这些查询,并在 3 种不同规格的 Databricks 集群(XS、S 和 M)上使用 Databricks Serverless SQL 运行。我的 iPhone 上的 DuckDB 在除最大规模之外的所有规模上都比 Databricks 集群更快,即使在最大规模上也很有竞争力。
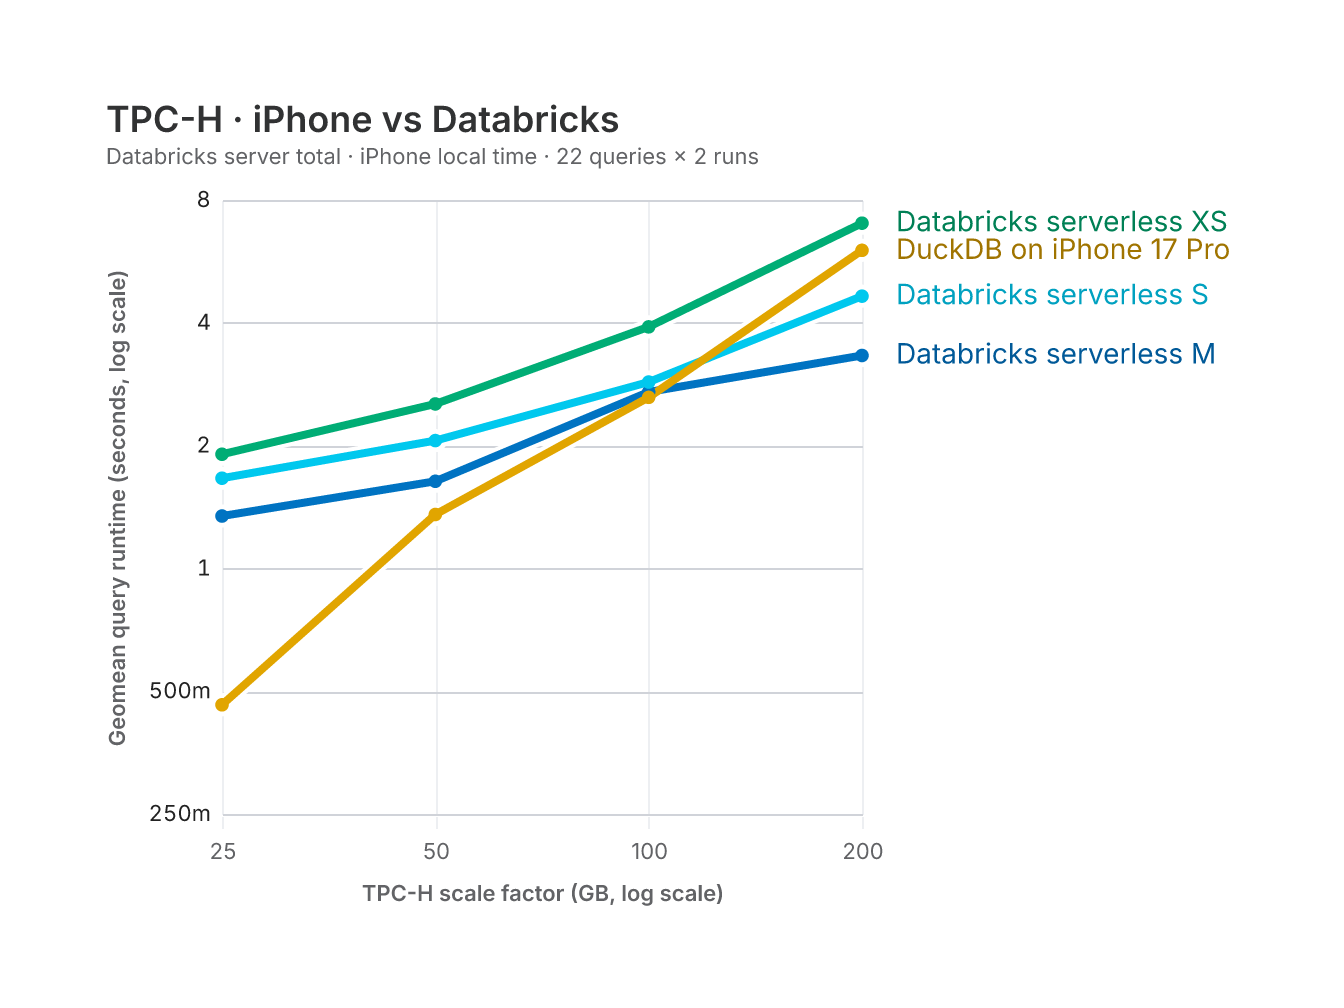
这令人惊讶:即使是最小的 Databricks 集群,其 CPU 核心数也比一部 iPhone 多:
| Databricks XS | Databricks S | Databricks M | iPhone 17 Pro | |
|---|---|---|---|---|
| CPU | 24 | 40 | 80 | 6 |
| 内存(GB) | 128 | 224 | 448 | 12 |
| 成本/小时(美元) | 4.20 | 8.40 | 16.80 | 不适用 |
这些结果有 2 个原因。首先,尽管这一工作负载按现实世界业务分析的标准来看很大,但与现代 CPU 的能力相比,它其实很小。因此在这个基准测试中,查询规划和编译的固定成本很大。DuckDB 的设计擅长快速运行小查询。
其次,DuckDB 是单节点数据库,而即使是 Databricks XS 也是多节点系统。在每一个大型JOIN和GROUP BY上,Databricks 都必须执行 shuffle 来将数据分布到各个节点:
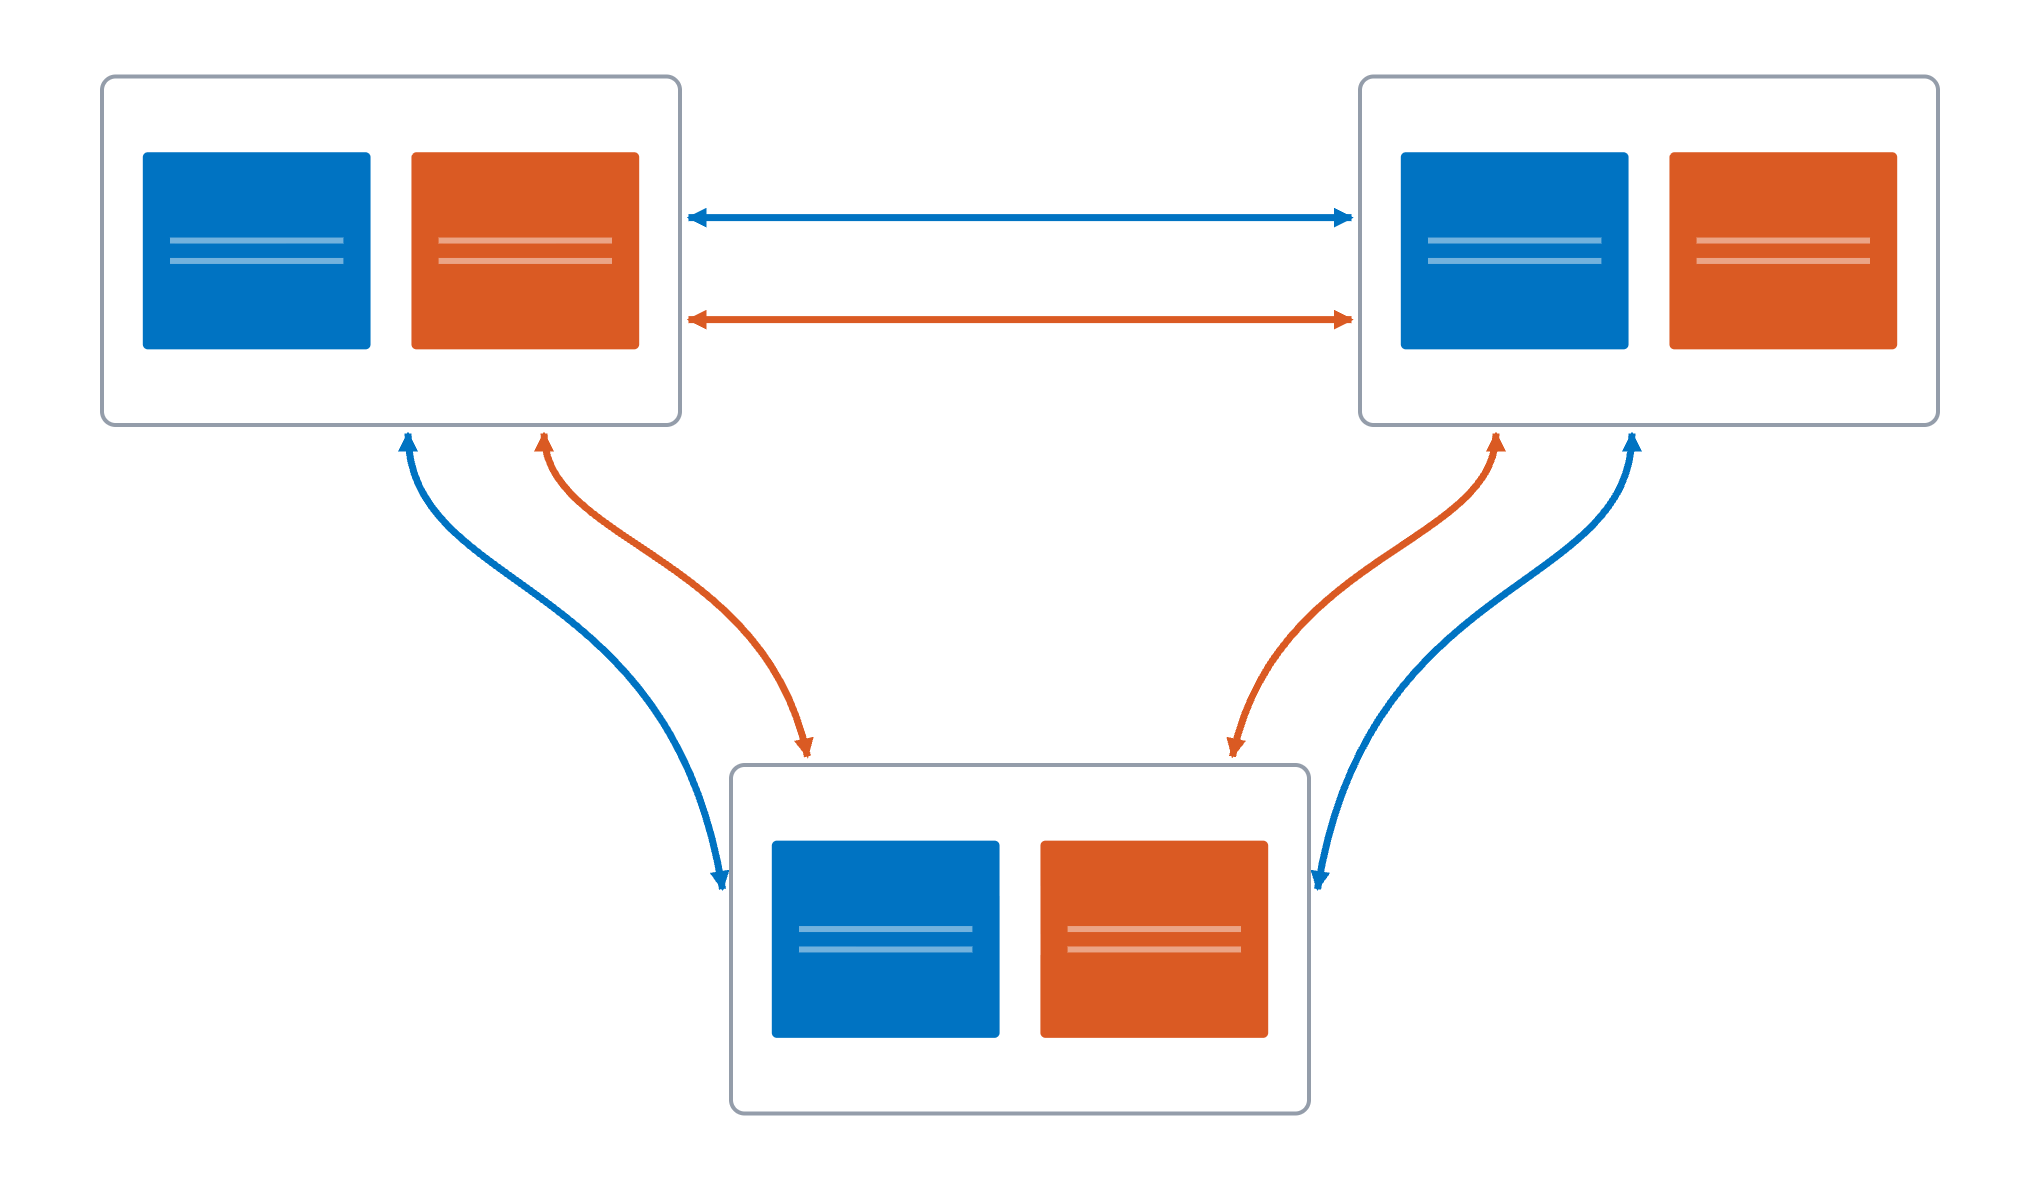
如果你的查询可以放在单个节点上,那么避免这些成本会更高效。如今已经很少有查询无法放在单个节点上了:AWS c9 系列可提供 192 个 Graviton5 核心。
这一发现最重要的影响在于成本。如果你使用 Databricks 或 Snowflake 这样的系统仅仅是为了针对业务数据运行 SQL 查询或 Python dataframe,那么你正在为底层计算支付非常高的加价。
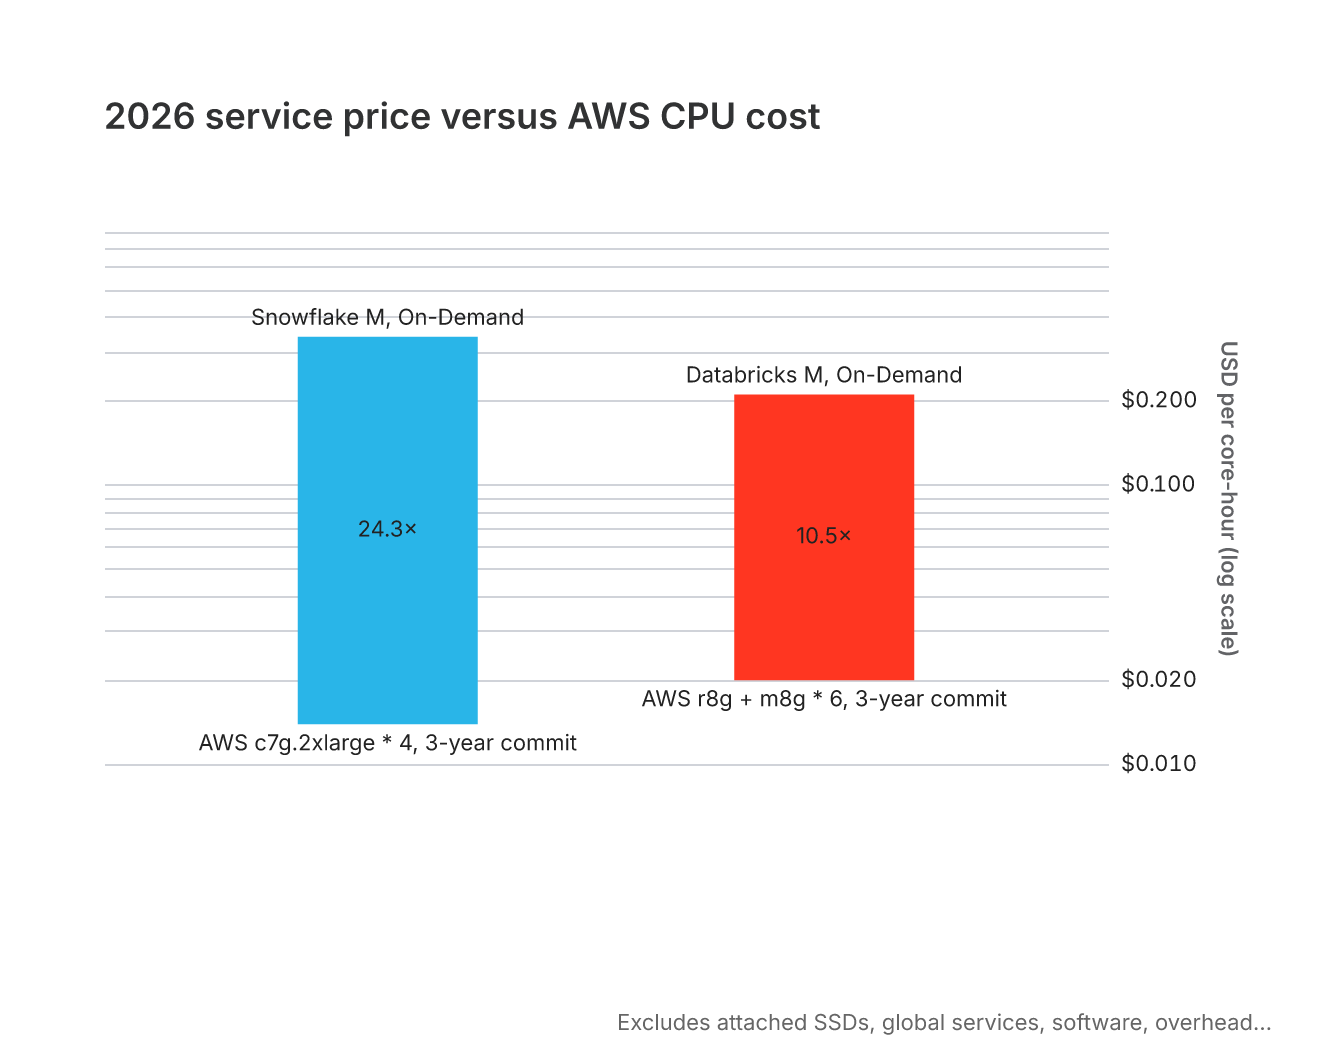
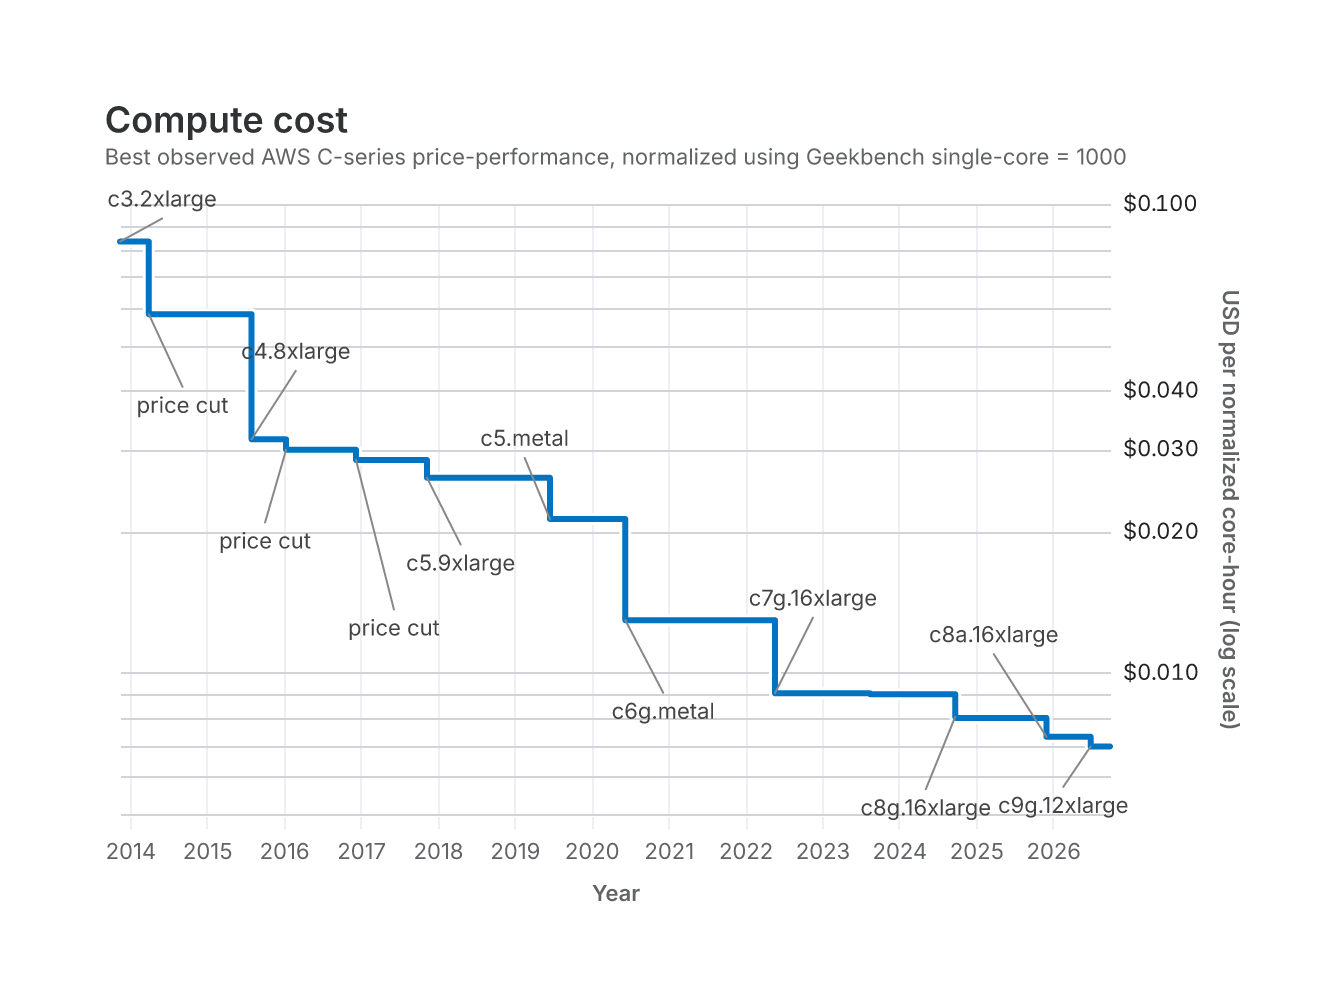
在过去 10 年里,云计算的成本暴跌了 10 倍,而主要数据基础设施提供商的利润率却在增长,结果就是我们今天看到的巨额加价。
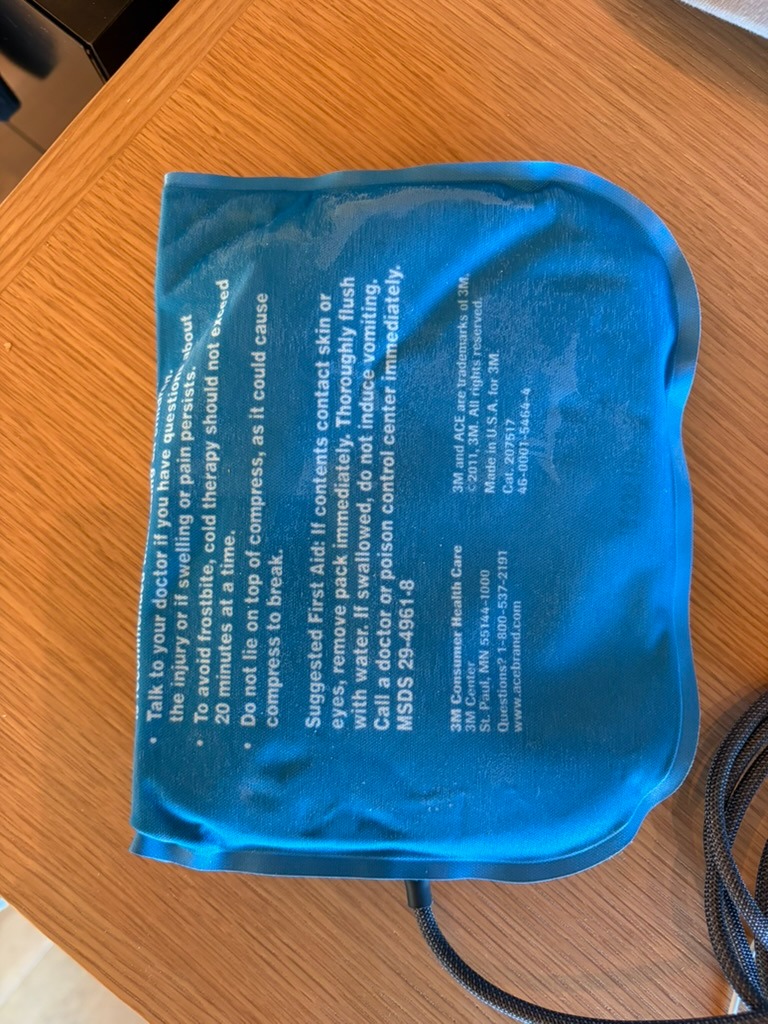
在 iPhone 上运行 TPC-H 是一种有趣的噱头。大多数公司不会采用 iPhone 作为他们的数据仓库——不过如果你这么做,我建议你把它放进冰袋里,否则你会因为热降频损失大约 30% 的性能。
这个噱头向我们展示的是,现实的业务工作负载对现代计算机来说根本不算什么挑战。大多数现实世界的工作负载都可以在单台机器上运行,使用像 DuckDB 和 Polars 这样旨在利用非分布式执行效率的执行引擎。重要的是,使用单节点执行引擎并不意味着你整个公司的工作负载都必须在一台机器上运行。来自许多用户的查询可以分布到许多工作节点上。
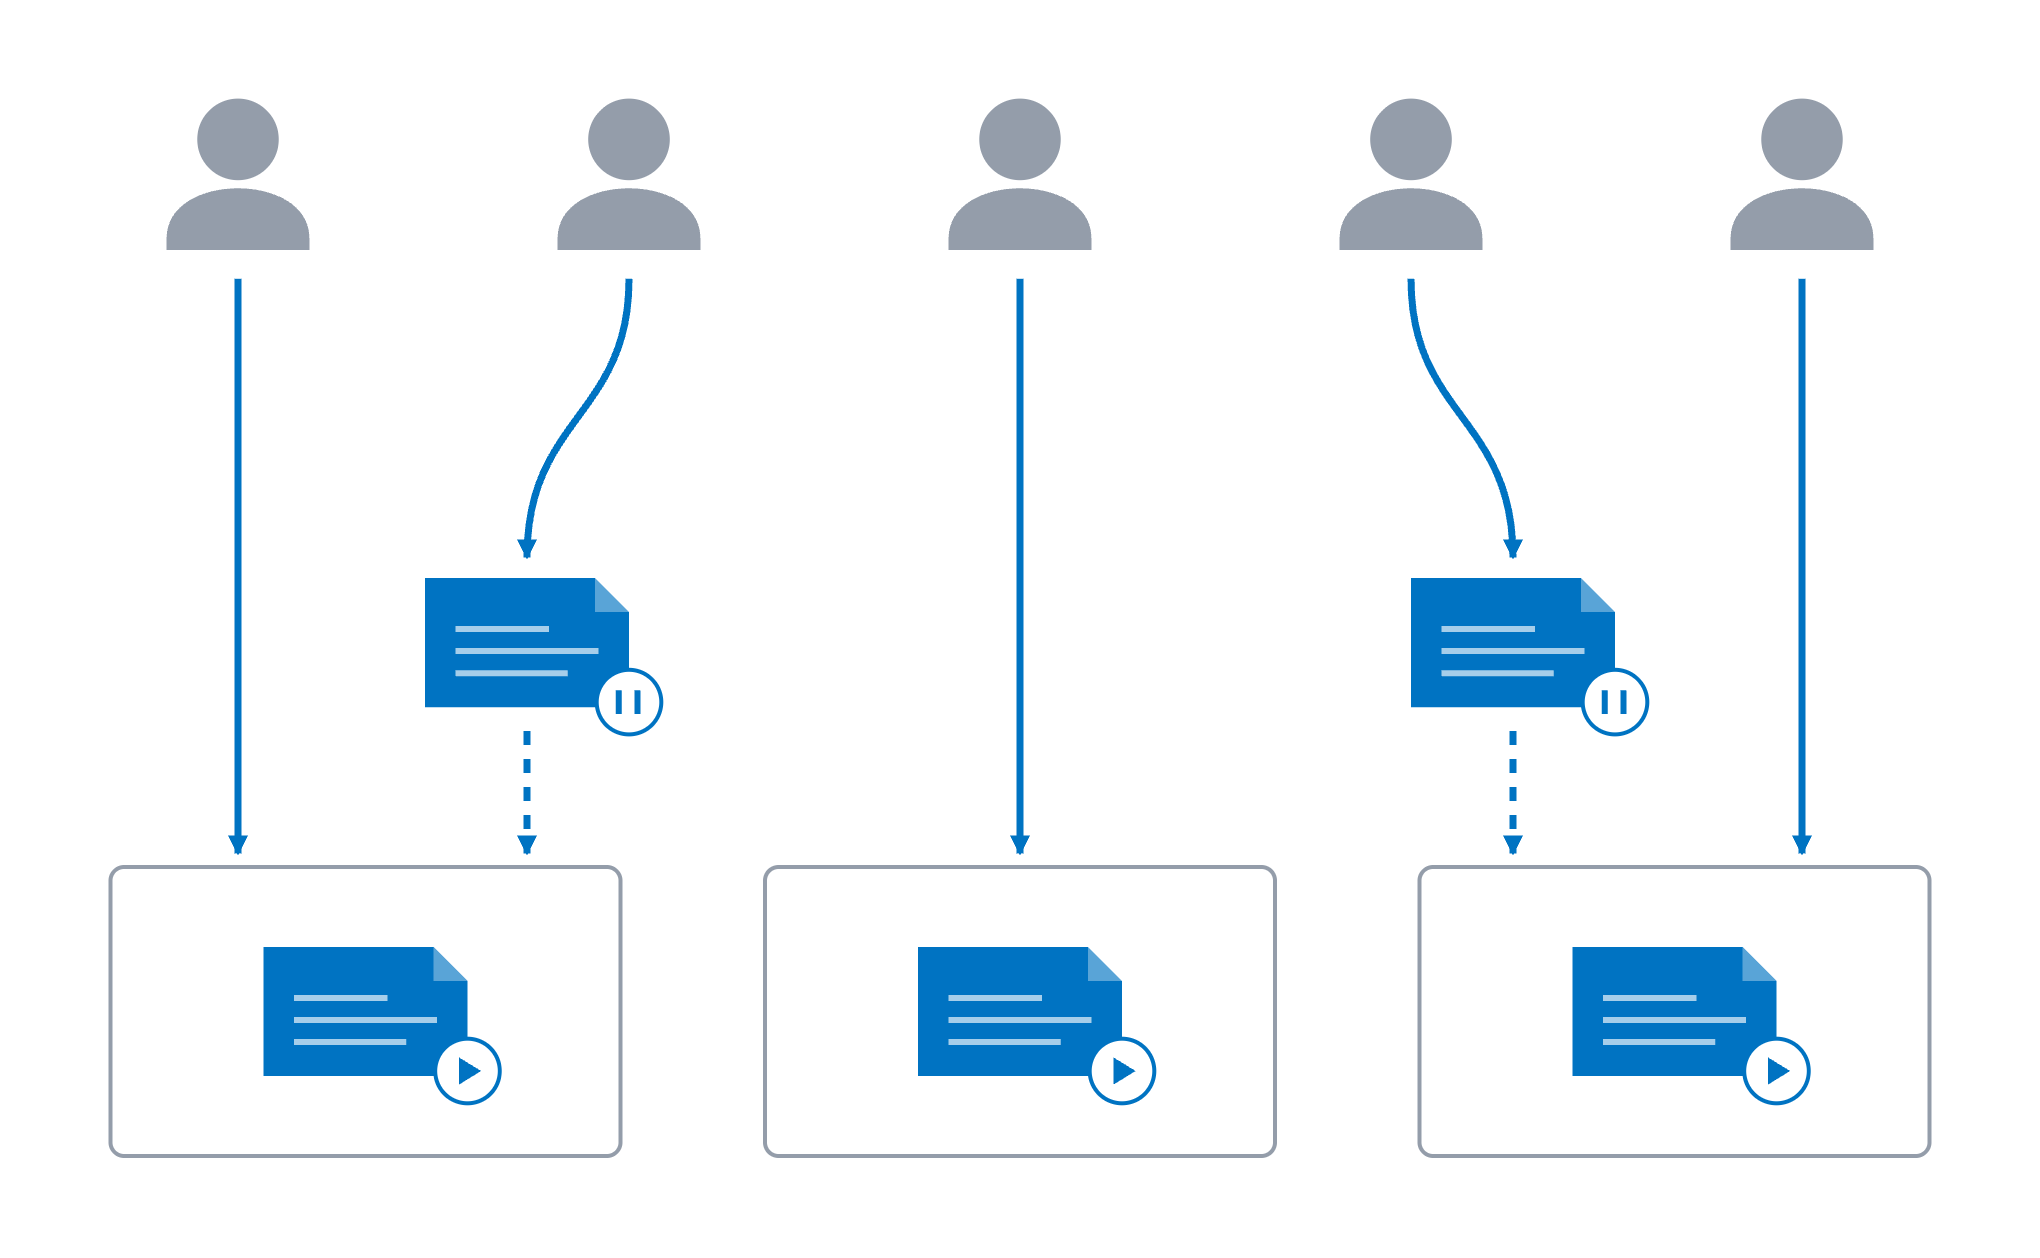
这就是我们的Lake Compute服务的工作方式:我们有一个很大的工作节点池,但每个工作节点一次只处理一个客户的 dbt 模型。评估你的工作负载是否适合单节点执行引擎很容易:所有主要数据平台现在都内置了对话式分析,所以直接问就行了!
“给我一张我的生产数据仓库中查询所读取数据大小的直方图,x 轴使用对数刻度,单位为 GB。”
我保证你会震惊于你的绝大多数查询有多小。我们都在为那些本可以在 iPhone 上运行的查询使用昂贵的分布式执行引擎。我们要利用更便宜计算的方式,就是转向一种新架构,让湖仓中的所有参与者都直接与存储层通信。
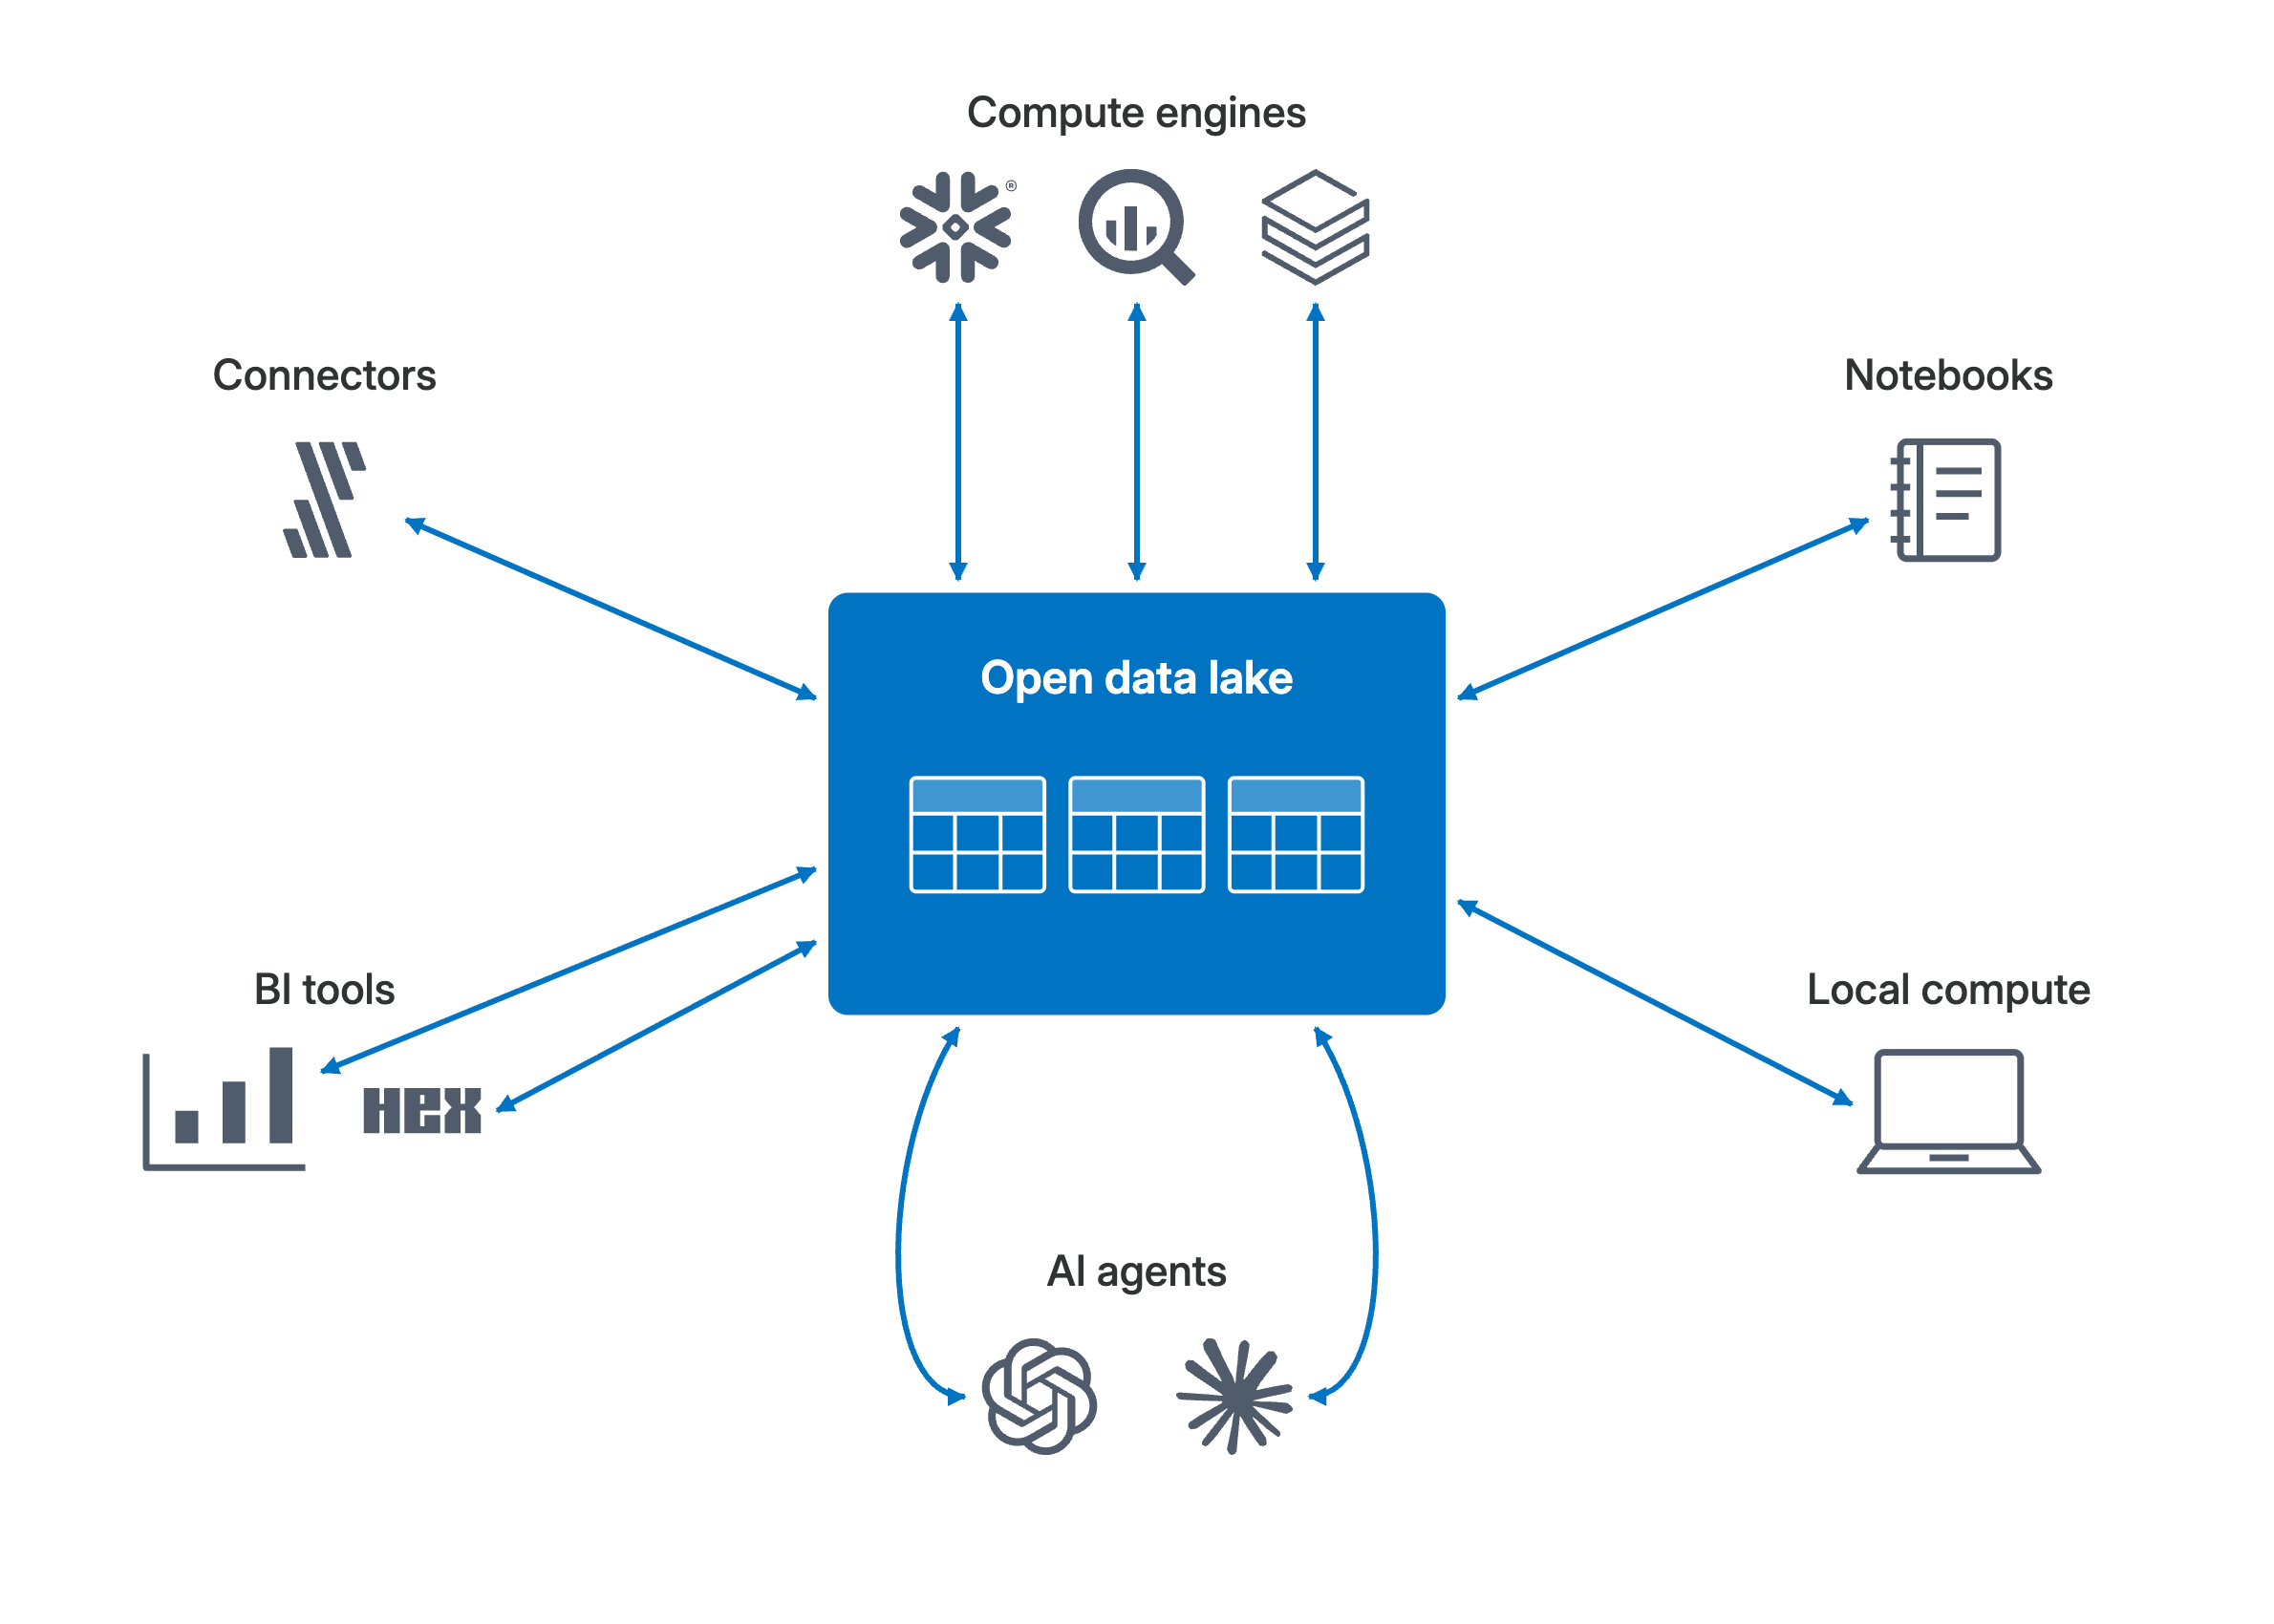
你以循序渐进、逐层推进的方式采用这种架构。
- 将你的数据摄取改为写入 Iceberg 表。如果你是 Fivetran 用户,你可以使用我们的 Managed Data Lake 迁移工作流,将你现有的表(包括历史数据)转换为 Iceberg。你数据仓库中现有的表将被透明地迁移为外部表,因此你的查询可以继续工作。
- 重新配置你的转换,使其输出到 Iceberg。所有主要计算引擎都支持输出到 Iceberg,所以这主要只是改一个设置的问题。如果你是 dbt 用户,你可以使用我们的Lake Compute服务来执行 dbt 模型。它在实现中使用了 DuckDB 和单节点执行。
- 将选定的读取工作负载,如 notebook 和即席查询,改为使用本地计算。最便宜的 CPU 就是你桌上的那个!
利用廉价和免费的计算不仅仅是为了省钱。它意味着你不再需要为用户配给计算资源。AI 代理已经给了每个人自己的分析师,可以回答他们能想到的任何问题,但前提是他们不会因为共享一个小而昂贵的计算集群而成为瓶颈。如果我们要把 AI 与数据连接起来,我们就需要开放的数据基础设施,去利用廉价的算力,这些算力就在我们身边,甚至就在我们的口袋里。
复现此基准测试的详细信息见 github.com/fivetran/iphone_benchmark
[CTA_MODULE]
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏