Redshift Iceberg 写入支持 Part 3:模式与分区演进
DataHot 速览
AWS 官方博客 Part 3 以客户和订单数据集为例,演示如何通过 ALTER 操作演进 Amazon Redshift 中的 Apache Iceberg 表模式与分区布局。操作包括重命名/新增/删除列、扩展列类型、设置表属性,以及新增/删除/替换分区字段,这些变更均为元数据操作,无需重写数据或重建管道。文章还介绍在 Amazon S3 Tables 目录中创建 AWS Lake Formation 资源链接,以单一权限模型向其他分析引擎共享表。该系列前两部分分别覆盖 Iceberg 表创建与写入,以及 DELETE/UPDATE/MERGE 行级修改。
为什么值得关注:Redshift 对 Iceberg 的写入与 ALTER 演进能力,关系到湖仓架构中多引擎共享、模式变更和权限治理的实现方式。数据平台从业者可借此了解如何避免重写数据和重建管道来维护 Iceberg 表。
本文目录 25 节
译文
AI 逐段翻译生产数据始终在演进。表会增删列、超出其数据类型,并随着查询模式的变化而重新分区。多个引擎通常需要读取相同的数据。这些变化过去意味着昂贵的数据重写或重建管道。Apache Iceberg使这些操作仅涉及元数据,而Amazon Redshift现在通过 ALTER 语句支持演进的模式和分区布局,无需数据重写,也无需重建管道。您还可以在AWS Lake Formation中创建资源链接,位于Amazon S3 Tables的目录中,这是 Amazon Simple Storage Service (Amazon S3) 的一项能力,用于集中式跨引擎治理。
在第 1 部分中,您创建了 Apache Iceberg 表,并直接从 Amazon Redshift 写入数据到您的数据湖,设置了外部模式,在Amazon Simple Storage Service (Amazon S3)和 Amazon S3 Tables 中创建了表,并执行了完全符合 ACID(原子性、一致性、隔离性、持久性)的 INSERT 操作。在第 2 部分中,您执行了 DELETE、UPDATE 和 MERGE 操作,以在行级别修改数据并同步暂存表和生产表。
在本文中,您使用前几篇文章中的customer和orders数据集,通过 ALTER 操作来演进 Iceberg 表的模式和分区。您还可以在 S3 Tables 目录中创建 AWS Lake Formation 资源链接,以在单一集中式权限模型下与其他分析引擎共享表。
解决方案概述
此解决方案演示了在 Amazon Redshift 中对 Apache Iceberg 表执行 ALTER 操作,以及为 S3 Tables 目录创建 Lake Formation 资源链接。本演练包括以下关键操作:
- ALTER TABLE RENAME COLUMN – 重命名现有列,而不更改数据类型或分区规范。
- ALTER TABLE ADD/DROP COLUMN – 以仅涉及元数据的操作添加新列或删除现有列。
- ALTER TABLE ALTER COLUMN – 扩大列数据类型(例如,从 INT 到 BIGINT),而无需重写数据。
- ALTER TABLE SET TABLE PROPERTIES – 更改未来写入的压缩类型。
- ALTER TABLE ADD/DROP/REPLACE PARTITION FIELD – 演进分区规范,而无需对现有数据重新分区。
- Lake Formation 资源链接 – 在 S3 Tables 目录中创建资源链接,以实现集中式访问治理。
下图展示了端到端架构:
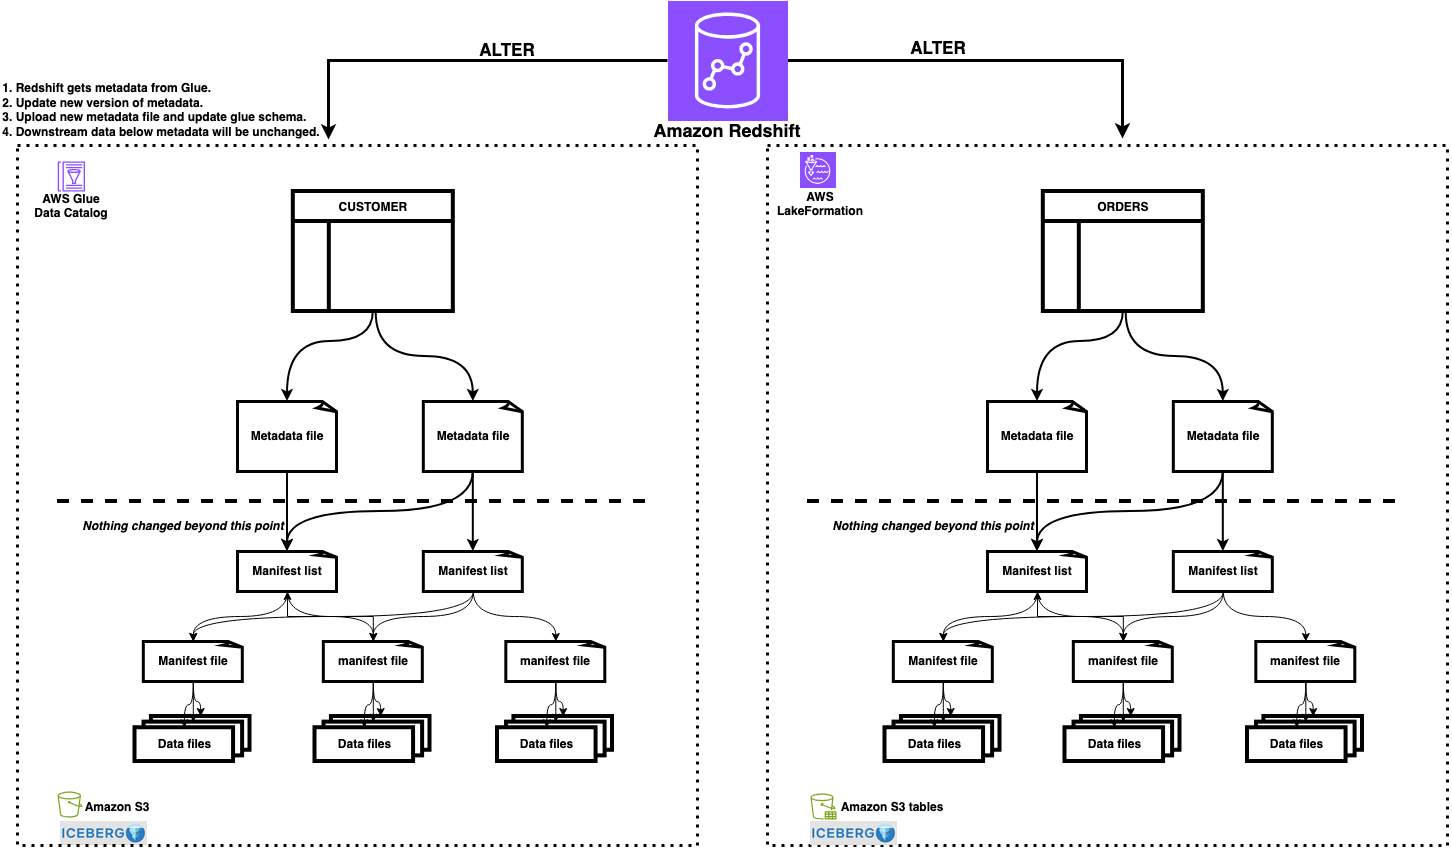
图 1:展示 Amazon Redshift 对 S3 Tables 中的 Iceberg 表执行 ALTER 操作的架构,其中 Lake Formation 资源链接提供来自 Amazon Athena 和其他引擎的访问
先决条件
- 一个 Amazon Redshift 数据仓库(预置型或无服务器型),运行在补丁 201或更高版本上。
- 具有 Amazon S3、
RedshifticebergRole权限的 AWS Identity and Access Management (IAM) 角色,以及AWS Glue Data Catalog和 Lake Formation 的权限。 - 位于标准 Amazon S3 存储桶中的
customer表(AWS Glue 目录:customer_db)。 - 位于 Amazon S3 表存储桶中的
orders表(iceberg-write-blog@s3tablescatalog)。 - 访问作为 Lake Formation 数据湖管理员的 IAM 角色。
- 与 S3 Tables 集成的 AWS Glue Data Catalog(
s3tablescatalog存在)。
使用 ALTER TABLE 进行模式演进
使用 ALTER TABLE,您可以更改 Iceberg 表定义,包括模式、分区规范和属性,而无需重写存储的数据。每个操作仅更新元数据。表结构立即更改,而现有数据文件保持不变。这有助于使模式演进、分区调整和属性更新在生产表上安全运行。
添加列
您可以使用 ALTER TABLE 向 Iceberg 表添加新列。每个新列都添加有一个唯一的字段 ID,Iceberg 使用该 ID 在模式演进过程中跟踪列。现有行对于新添加的列返回 NULL。
验证当前模式:
SHOW TABLE dev.demo_iceberg.customer;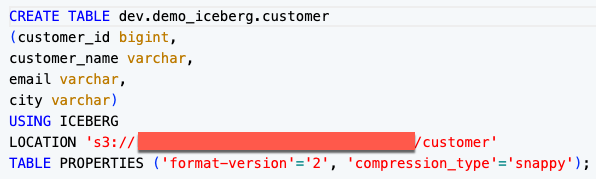
图 2:SHOW TABLE 输出显示当前 customer 表模式
添加列:
-- Add a loyalty_tier column to the customer table
ALTER TABLE dev.demo_iceberg.customer
ADD COLUMN loyalty_tier VARCHAR;
验证模式更改:
SHOW TABLE dev.demo_iceberg.customer;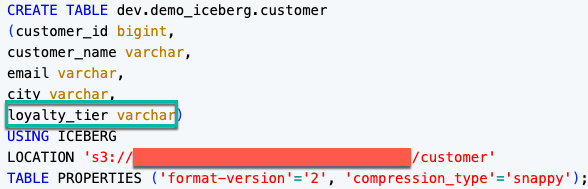
图 3:SHOW TABLE 输出显示添加到模式中的 loyalty_tier 列
以下输出显示现有行的新 loyalty_tier 列为 NULL:
SELECT customer_id, customer_name, city, loyalty_tier
FROM dev.demo_iceberg.customer
ORDER BY customer_id;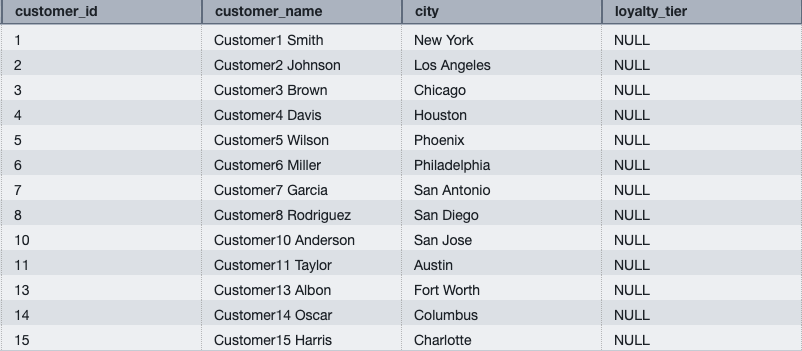
图 4:查询结果显示现有行的 loyalty_tier 为 NULL
通过聚合 S3 Tables 中orders表的订单总额来填充新列:
-- Set loyalty_tier based on total spend from orders
UPDATE dev.demo_iceberg.customer
SET loyalty_tier = CASE
WHEN a.total_spend > 300 THEN 'Gold'
ELSE 'Silver'
END
FROM (
SELECT customer_id, SUM(total_order_amt) AS total_spend
FROM "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders
GROUP BY customer_id
) AS a
WHERE dev.demo_iceberg.customer.customer_id = a.customer_id;
以下输出显示更新后的客户忠诚度等级:
SELECT customer_id, customer_name, loyalty_tier
FROM dev.demo_iceberg.customer
ORDER BY customer_id;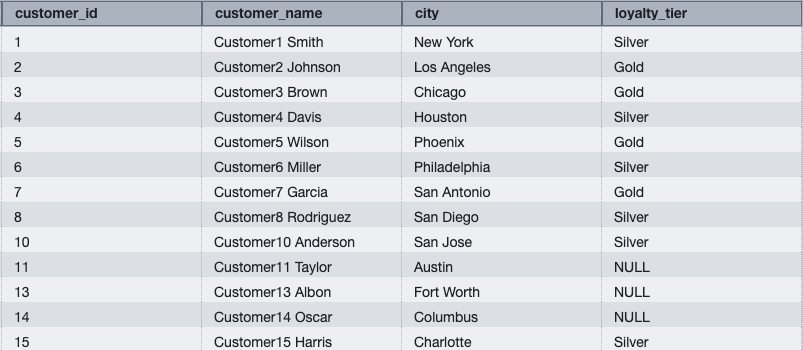
图 5:客户表显示 Gold 和 Silver 忠诚度等级
注意: 客户 ID 11、13 和 15 的loyalty_tier 显示为 NULL,因为它们在orders表中没有匹配的订单。
删除列
删除不再需要的列。该列会从当前模式中移除,但现有文件中的数据保持不变,只是对查询变得不可见。
验证当前模式:
SHOW TABLE dev.demo_iceberg.customer;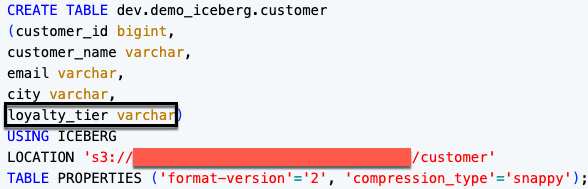
图 6:SHOW TABLE 输出显示删除 loyalty_tier 之前的当前 customer 表模式
删除列:
-- Drop the loyalty_tier column
ALTER TABLE dev.demo_iceberg.customer
DROP COLUMN loyalty_tier;
验证模式更改:
SHOW TABLE dev.demo_iceberg.customer;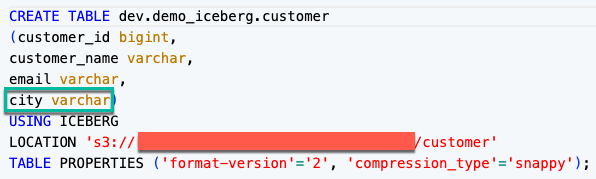
图 7:SHOW TABLE 输出显示删除 loyalty_tier 之后的 customer 表模式
验证列已删除:
SELECT * FROM dev.demo_iceberg.customer
ORDER BY customer_id;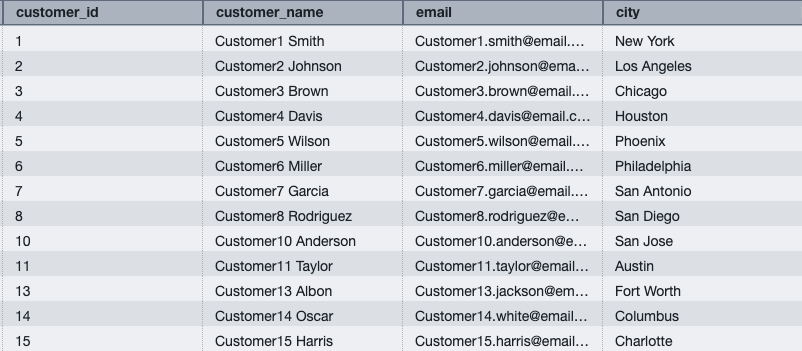
图 8:查询结果确认 loyalty_tier 列已被删除
注意: 要删除当前分区规范中使用的列,请先删除或替换分区字段,然后再删除该列。
重命名列
重命名列,而不影响数据类型或分区规范:
-- Rename city to location
ALTER TABLE dev.demo_iceberg.customer
RENAME COLUMN city TO location;
以下输出确认该列已重命名为 location:
SELECT customer_id, customer_name, location
FROM dev.demo_iceberg.customer
ORDER BY customer_id;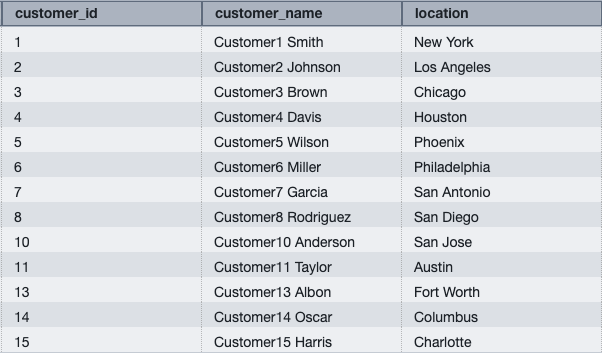
图 9:显示重命名后的列 location 的查询结果
拓宽列类型
在不重写数据的情况下拓宽列的数据类型。当数据超出原始精度时,这很有用,例如当订单金额超出原始 decimal 范围时。
验证当前列类型:
SHOW TABLE "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders;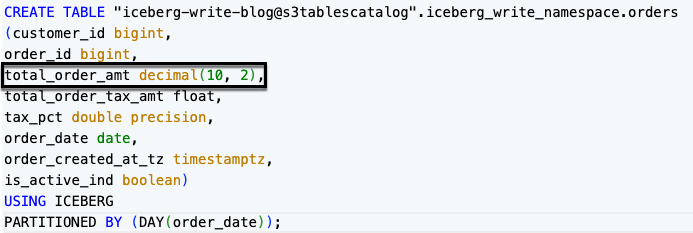
图 10:显示 total_order_amt 为 DECIMAL(10,2) 的 SHOW TABLE 输出
现在运行 ALTER 来拓宽该列:
-- Widen total_order_amt to support larger order values
ALTER TABLE "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders
ALTER COLUMN total_order_amt TYPE DECIMAL(18,2);
验证更新后的列类型:
SHOW TABLE "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders;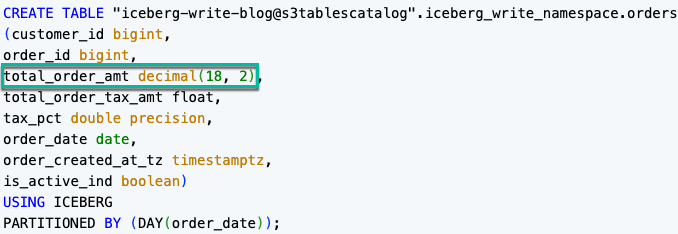
图 11:确认 total_order_amt 已拓宽为 DECIMAL(18,2) 的 SHOW TABLE 输出
注意: Amazon Redshift 支持安全的类型提升(例如,INT 到 BIGINT、FLOAT 到 DOUBLE、DECIMAL(10,2) 到 DECIMAL(18,2))。请相应地规划列类型以适应未来的增长。
设置表属性
更改未来写入的压缩类型:
验证当前压缩类型:
SHOW TABLE "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders;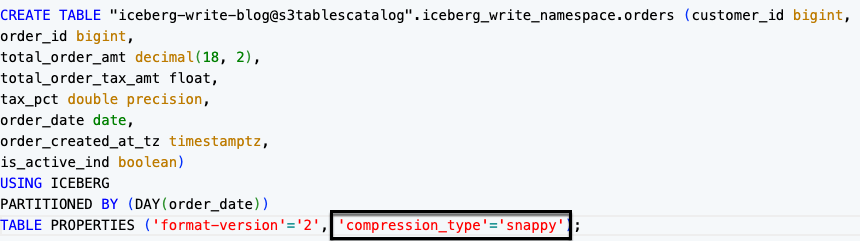
图 12:显示更新前当前压缩类型的 SHOW TABLE 输出
现在运行 ALTER 来更改压缩类型:
-- Switch to zstd compression for better ratios
ALTER TABLE "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders
SET TABLE PROPERTIES ('compression_type'='zstd');
以下 SHOW TABLE 输出确认了更新后的压缩设置:
SHOW TABLE "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders;图 13:显示 compression_type 设置为 zstd 的 SHOW TABLE 输出
注意: 这仅影响未来的写入。现有数据文件保留其原始压缩。
分区演进
Iceberg 的一个强大功能是分区演进,即在不重写现有数据的情况下更改表分区方式的能力。Amazon Redshift 使用更新后的分区方案写入新数据,而现有数据则保留在旧布局中。查询引擎会透明地处理两种布局。
添加分区字段
第 1 部分中的 orders 表按 DAY(order_date) 分区。添加一个额外的 bucket 分区,将数据分布到哈希桶中:
验证当前分区规范:
SHOW TABLE "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders;图 14:显示添加分区字段前当前分区规范的 SHOW TABLE 输出
添加分区字段:
-- Add bucket partitioning on customer_id
ALTER TABLE "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders
ADD PARTITION FIELD bucket(16, customer_id);
此更改后,新数据将同时按 DAY(order_date) 和 bucket(16, customer_id) 分区,而现有数据则保留在原始的仅按天布局中。
验证更新后的规范:
SHOW TABLE "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders;图 15:显示更新后的分区规范为 DAY(order_date) 和 bucket(16, customer_id) 的 SHOW TABLE 输出
替换分区字段
与其分别删除和添加,不如使用 REPLACE PARTITION FIELD 作为单个原子操作。当在同一源列上用另一种转换替换一种转换时,这是推荐的做法,因为它明确了意图,并避免了操作之间表处于未分区状态的瞬态。
验证当前分区规范:
SHOW TABLE "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders;图 16:显示当前分区规范为 DAY(order_date) 和 bucket(16, customer_id) 的 SHOW TABLE 输出
替换分区字段:
-- Replace daily partitioning with monthly
ALTER TABLE "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders
REPLACE PARTITION FIELD DAY(order_date) WITH MONTH(order_date);
此更改后:
- 现有数据保留在基于天的分区文件夹中。
- Amazon Redshift 将新数据写入基于月的分区文件夹中。
- 查询引擎会透明地读取两种布局。
确认新的分区规范:
SHOW TABLE "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders;图 17:确认分区字段已替换为 MONTH(order_date) 的 SHOW TABLE 输出
插入新数据并验证两种分区布局均可查询:
-- New data follows monthly partitioning
INSERT INTO "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders
(order_date, order_id, customer_id, total_order_amt, total_order_tax_amt,
tax_pct, order_created_at_tz, is_active_ind)
VALUES
('2025-01-15', 1018, 3, 210.00, 16.80, 0.08, '2025-01-15 09:00:00-06:00', true);
-- Query spans both old (daily) and new (monthly) layouts transparently
SELECT order_id, order_date, total_order_amt
FROM "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders
WHERE order_date >= '2024-11-01'
ORDER BY order_date;
图 18:跨两种分区布局的查询结果
转换为多级分区
Iceberg 支持多级(复合)分区规范,其中数据按多个分区字段组织。你可以通过一次添加一个分区字段,将现有的单级规范演进为多级规范。每个 ADD PARTITION FIELD 都是轻量级元数据操作,不会重写任何数据。
该 orders 表当前按 MONTH(order_date) 和 bucket(16, customer_id) 分区。再添加一个分区字段以创建三级规范:
验证当前分区规范:
SHOW TABLE "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders;图 19:显示当前 MONTH(order_date) 和 bucket(16, customer_id) 两级分区规范的 SHOW TABLE 输出
添加分区字段以构建三级规范:
-- Add a day-level partition field on order_created_at_tz
ALTER TABLE "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders
ADD PARTITION FIELD day(order_created_at_tz);
验证新的多级分区规范:
SHOW TABLE "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders;图 20:显示 MONTH(order_date)、bucket(16, customer_id) 和 day(order_created_at_tz) 三级分区规范的 SHOW TABLE 输出
这些更改后:
- 现有数据保留在原始的单一层次布局(基于月的文件夹)中。
- Amazon Redshift 将新数据写入多级布局(月,然后 bucket,然后 day 文件夹)。
- 查询引擎会透明地读取两种布局。
从多级分区中删除分区字段
你也可以朝相反方向演进,从多级规范中删除分区字段以简化分区布局。与添加字段一样,删除分区字段是仅元数据操作,并且每条语句删除一个字段。
验证当前多级分区规范:
SHOW TABLE "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders;图 21:显示删除字段前三級分区规范的 SHOW TABLE 输出
一次删除一个分区字段:
-- Drop the bucket partition field
ALTER TABLE "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders
DROP PARTITION FIELD bucket(16, customer_id);
-- Drop the day-level partition field
ALTER TABLE "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders
DROP PARTITION FIELD day(order_created_at_tz);
验证表已恢复为其原始单级规范:
SHOW TABLE "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders;图 22:确认表已恢复为单级 MONTH(order_date) 分区规范的 SHOW TABLE 输出
删除分区字段后:
- 在已删除字段布局下写入的数据保留在原位,并且仍可查询。
- Amazon Redshift 仅使用剩余的分区字段写入新数据。
- 对已删除字段进行筛选的查询仍然可以正常工作,但对于新写入的数据,它们不再受益于该字段上的分区修剪。
支持的分区转换
下表列出了 Amazon Redshift 中 Iceberg 表可用的分区转换:
| 分区转换 | 语法示例 | 作用 |
| 年 | year(order_date) | 根据日期或时间戳列将数据分组为按年分区。 |
| 月 | month(order_date) | 根据日期或时间戳列将数据分组为按月分区。 |
| 日 | day(order_date) | 根据日期或时间戳列将数据分组为按日分区。 |
| 小时 | hour(event_ts) | 根据时间戳列将数据分组为按小时分区。 |
| 桶 | bucket(16, customer_id) | 将数据分布到 N 个哈希桶中,以便在高基数上实现均匀分布。 |
| 截断 | truncate(3, zip_code) | 将列值截断为固定宽度 W,以便将相似值分组在一起。 |
| 标识 | identity(region) | 按确切的列值进行分区,不应用任何转换。 |
注意: 已属于现有分区字段的列不能用于新的分区字段。请先删除或替换现有字段。
使用外部架构访问 S3 Tables
Lake Formation 资源链接通过集中治理为您的 S3 Tables 提供跨引擎访问。您在默认 AWS Glue Data Catalog 中创建指向 S3 Tables 数据库的资源链接。Amazon Redshift、Amazon Athena、Amazon EMR 以及其他引擎随后可以使用单一权限模型发现和查询这些表。
图 23:S3 Tables 与 AWS Glue Data Catalog 和 Lake Formation 的集成
有关完整的设置演练,包括 Lake Formation 先决条件、资源链接创建和权限授予,请参阅 使用 Amazon Redshift 优化 Amazon S3 Tables 查询。有关资源链接和 S3 Tables 目录集成的概念性详细信息,请参阅 关于资源链接 和 创建 S3 Tables 目录。
以下步骤展示了在完成所引用博客中的设置后,如何通过资源链接查询 S3 Tables。
授予对资源链接的访问权限
在 Lake Formation 控制台中,资源链接显示为一个名为 iceberg_write_blog_rl 的数据库(类型:资源链接)。要授予对资源链接的访问权限:
- 在 Lake Formation 控制台中,选择 Databases。
- 找到
iceberg_write_blog_rl(类型:资源链接)。 - 选择 Actions,然后选择 Grant。
- 向 RedshiftIcebergRole 授予 DESCRIBE 权限。
创建外部架构
资源链接就位后,在 Amazon Redshift 中创建外部架构,以便使用两部分表示法访问。
对于 IAM 联合用户:
CREATE EXTERNAL SCHEMA s3tables_iceberg
FROM DATA CATALOG
DATABASE 'iceberg_write_blog_rl'
CATALOG_ID '<ACCOUNT_ID>'
IAM_ROLE 'SESSION';
对于数据库用户和商业智能(BI)工具:
CREATE EXTERNAL SCHEMA s3tables_iceberg
FROM DATA CATALOG
DATABASE 'iceberg_write_blog_rl'
IAM_ROLE 'arn:aws:iam::<ACCOUNT>:role/RedshifticebergRole';
向特定用户或角色授予访问权限:
-- Grant to the IAM role used in this walkthrough
GRANT USAGE ON SCHEMA s3tables_iceberg TO "IAMR:RedshifticebergRole";
图 24:可通过外部架构使用的 S3 Tables
使用两部分表示法进行查询
创建外部架构后,使用两部分表示法查询 S3 Tables:
-- Instead of: "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders
SELECT * FROM s3tables_iceberg.orders;
图 25:通过外部架构使用两部分表示法从 S3 Tables 获取的查询结果
访问方法比较
下表比较了在 Amazon Redshift 中访问 Iceberg 表的可用方法:
| 访问方法 | 查询语法 | 身份验证 | 最适用于 |
| S3 Tables 三部分表示法 | "bucket@s3tablescatalog".namespace.table | 仅 IAM 联合身份 | 在 Query Editor v2 中进行直接目录访问的交互式查询。 |
| 通过资源链接的外部架构 | schema_name.table | 任意(架构中定义的 IAM 角色) | BI 工具、Data API、JDBC/ODBC 应用程序以及共享团队访问。 |
| awsdatacatalog | awsdatacatalog.database.table | 仅 IAM 联合身份 | 在单个会话中进行多数据库访问,无需创建外部架构。 |
整合在一起
在单个工作流中将架构演化与跨引擎访问相结合。以下示例向 orders 表添加一列,并立即通过外部架构查询它:
-- 1. Add a column to the S3 Tables orders table
ALTER TABLE s3tables_iceberg.orders
ADD COLUMN fulfillment_status VARCHAR;
-- 2. Update the new column
UPDATE s3tables_iceberg.orders
SET fulfillment_status = 'shipped'
WHERE order_date < '2024-11-01';
UPDATE s3tables_iceberg.orders
SET fulfillment_status = 'pending'
WHERE order_date >= '2024-11-01';
-- 3. Query immediately via the external schema (no schema recreation needed)
SELECT o.order_id, o.order_date, o.fulfillment_status, c.customer_name
FROM s3tables_iceberg.orders o JOIN demo_iceberg.customer c
ON o.customer_id = c.customer_id
ORDER BY o.order_date DESC;
图 26:跨目录联接显示通过外部架构立即可见已演化的架构
新列可通过三部分表示法和外部架构两者看到,无需任何额外配置,因为 Iceberg 中的架构演化会自动传播。
最佳实践
- 先在非生产环境中测试 ALTER 操作。 尽管仅涉及元数据,架构更改会立即影响所有读取者。
- 使用 REPLACE PARTITION FIELD 而不是 DROP + ADD。 原子操作可避免出现临时的未分区状态。
- 使用 SHOW TABLE 监控分区规范更改。 在任何分区演化后验证当前规范。
- 根据查询模式选择分区转换。 对时间范围筛选使用
month()或day()。对高基数联接键使用bucket()。 - 在批量加载前设置表属性。 在大型 INSERT 操作前更改压缩类型(
zstd可获得更好压缩比,snappy可获得更快速度)。 - 在变更后运行表维护。 在执行多次 UPDATE、DELETE 或 MERGE 操作后,运行 AWS Glue 表优化器 以压缩删除文件并提高读取性能。
- 使用 Lake Formation 进行细粒度访问。 可通过 Lake Formation 对通过资源链接访问的表应用列级和行级安全性。
- 向特定用户或角色授予架构访问权限。 避免授予 PUBLIC。使用命名 IAM 角色或数据库用户以实现最小权限访问。
- 监控查询性能。 使用 Amazon Redshift 查询监控功能跟踪写入操作的性能,并根据需要优化分区策略。
注意事项
在 Iceberg 表上使用 ALTER TABLE 和分区演化时,请牢记以下事项:
- 为仅元数据行为做好规划。 ALTER TABLE 操作会立即更新元数据,现有数据文件保持不变。操作完成后,所有读取者会立即看到新的 schema。
- 在删除分区列之前先删除分区字段。 要删除当前分区规范中使用的列,请先删除或替换分区字段,然后再删除该列。
- 为 ALTER COLUMN TYPE 使用安全的类型提升。 Amazon Redshift 支持在兼容类型族内进行拓宽(INT 到 BIGINT、FLOAT 到 DOUBLE、DECIMAL(10,2) 到 DECIMAL(18,2))。规划列类型时应考虑未来的增长。
- 考虑演进后的混合分区布局。 分区演进不会对现有数据重新分区。旧文件保持其原始布局,查询引擎会透明地读取两种布局。
- 使用外部 schema 以便数据库用户访问。 自动挂载的三段式表示法(
"bucket@s3tablescatalog")需要 IAM 联合身份验证。对于数据库用户和 BI 工具,请使用显式 IAM 角色创建外部 schema。 - 使用带 awsdatacatalog 的完整三段式表示法。 awsdatacatalog 不支持 USE 语句,因此请始终指定完整路径。
- 删除表后单独清理 S3 数据。 删除 Iceberg 表只会从 AWS Glue Data Catalog 中移除目录条目。请单独删除底层 S3 数据文件,或使用 AWS Glue 表优化器移除孤立文件。
清理
为避免持续产生费用,请运行以下命令:
-- Drop the fulfillment_status column added during testing
ALTER TABLE "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders
DROP COLUMN fulfillment_status;
-- Restore original partition spec (if changed)
ALTER TABLE "iceberg-write-blog@s3tablescatalog".iceberg_write_namespace.orders
REPLACE PARTITION FIELD MONTH(order_date) WITH DAY(order_date);
-- Drop external schema
DROP SCHEMA IF EXISTS s3tables_iceberg;
结论
在本文中,您使用 ALTER TABLE 操作演进 Apache Iceberg 表 schema。您添加、删除和重命名了列,拓宽了数据类型,更改了压缩方式,并演进了分区规范,所有这些都是仅元数据操作,无需重写数据。您还创建了 Lake Formation 资源链接,以提供对 S3 Tables 的受治理的跨引擎访问,并通过外部 schema 简化了查询语法。
本系列三篇文章到此结束,该系列介绍了如何在 Amazon Redshift 中开始使用 Apache Iceberg 写入支持:
- 第 1 部分:创建 Iceberg 表并执行 INSERT 操作。
- 第 2 部分:运行 DELETE、UPDATE 和 MERGE 进行行级修改。
- 第 3 部分:使用 ALTER TABLE 演进 schema,并通过 Lake Formation 资源链接添加跨引擎访问。
如果您对本系列有任何问题或反馈,请在这篇文章下留言。
其他资源
- Amazon Redshift Iceberg 集成 – 完整语法参考。
- 写入 Apache Iceberg 表 – 详细示例。
- Iceberg 的 ALTER TABLE – 完整 ALTER 参考。
- Amazon S3 Tables – 托管的 Iceberg 存储。
- AWS Lake Formation – 集中式数据治理。
- 使用 Amazon Redshift 优化 S3 Tables 查询 – 资源链接和性能调优。
这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏