AWS Glue 6.0支持Iceberg v3地理空间与变体类型
DataHot 速览
AWS Glue 6.0 基于 Apache Spark 4.1,引入 Spark Declarative Pipelines,让开发者声明目标数据集而非手写 DAG 编排。演示作业把 S3 中的原始订单 CSV 按 bronze、silver、gold 三层加工为分析就绪表,并自动注册到 Glue Data Catalog,可用 Athena 查询。相比用 MWAA 或 Step Functions 人工协调各阶段,单个声明式作业可自动解析依赖、管理检查点并决定执行顺序,减少生产 ETL 的衔接成本。
为什么值得关注:声明式 ETL 把湖仓中常见的 medallion 分层管线的依赖、检查点和重试逻辑交给框架,能显著降低大规模管道维护成本;AWS 生态的数据团队可据此评估从 Airflow/Step Functions 编排向 SDP 迁移的收益。
本文目录 25 节
- 解决方案概述
- 构建管道的两种方式
- 运行和刷新管道
- 物化视图:具有自动依赖解析的批处理转换
- SQL 与 Python 共存
- 构建管道:分步指南
- 步骤 1 – 先决条件
- 管道的 IAM 角色
- 设置演练变量
- 步骤 2 – 设置示例数据
- 步骤 3 – 构建管道文件
- 3a. spark-pipeline.yml
- 3b. transformations/01_bronze.py
- 3c. transformations/02_silver.py
- 3d. transformations/03_gold.sql
- 第 4 步 – 打包项目
- 第 5 步 – 创建数据库
- 第 6 步 – 配置作业
- 第 7 步 – 验证(试运行)
- 第 8 步 – 运行管道
- 第 9 步 – 查询结果
- 成本考虑
- 步骤 10 – 清理
- 后续步骤
- 结论
译文
AI 逐段翻译数据团队通常会构建提取、转换和加载(ETL)管道,将原始订单事件转换为可供分析师使用的聚合数据,采用青铜、白银和黄金的序列,即奖章架构。青铜层保存原始摄入记录,白银层保存经过清洗和验证的数据,黄金层保存分析师查询的业务级聚合数据。如今,你需要在 AWS Glue 上构建此流程,并使用诸如 Amazon Managed Workflows for Apache Airflow(Amazon MWAA)或 AWS Step Functions 之类的编排器来协调各个阶段。许多团队正是以这种方式运行生产管道。随着管道增长,协调工作也随之增长:你需要连接作业依赖关系、管理中间检查点,并逐阶段添加重试逻辑。
AWS Glue 6.0 由 Apache Spark 4.1 提供支持,引入了 Spark 声明式管道(SDP),进一步简化了这一过程。无需手动编排作业,你只需声明每个数据集应包含什么,让声明式框架自动解析依赖关系、管理检查点并编排执行顺序。结果作为单个声明式作业运行,无需手动编写有向无环图(DAG)连接或命令式编排代码。
在这篇文章中,你将构建一个 AWS Glue 6.0 作业,通过青铜、白银和黄金序列将原始订单记录转换为经过验证、聚合、可供分析的表。你无需编写任何编排逻辑即可完成此操作。本演练使用 AWS 命令行界面(AWS CLI),相同的操作也可通过 AWS SDK 使用。
解决方案概述
你构建一个 AWS Glue 6.0 作业,从 Amazon Simple Storage Service(Amazon S3)中的 CSV 文件读取原始订单记录。该作业将这些记录流经三个声明式数据集。这些数据集分别是青铜物化视图(按原样摄入)、白银物化视图(类型化、验证和分类)以及黄金 SQL 物化视图(按区域聚合)。启用 AWS Glue Data Catalog 集成后,三者都作为 Data Catalog 表落地,可使用标准 SQL 工具(如 Amazon Athena)进行查询。SDP 根据代码中的数据集引用解析依赖顺序,因此你无需自行编排步骤。
构建管道的两种方式
在构建管道之前,让我们通过快速比较命令式和声明式方法,来理解这种编写 ETL 管道的新方式。
使用命令式方法,你需要三个 AWS Glue 作业,外加一个编排器来处理排序和错误处理。因此,典型的管道有两层:编排层和 ETL 处理层。下图展示了这种两层命令式管道。
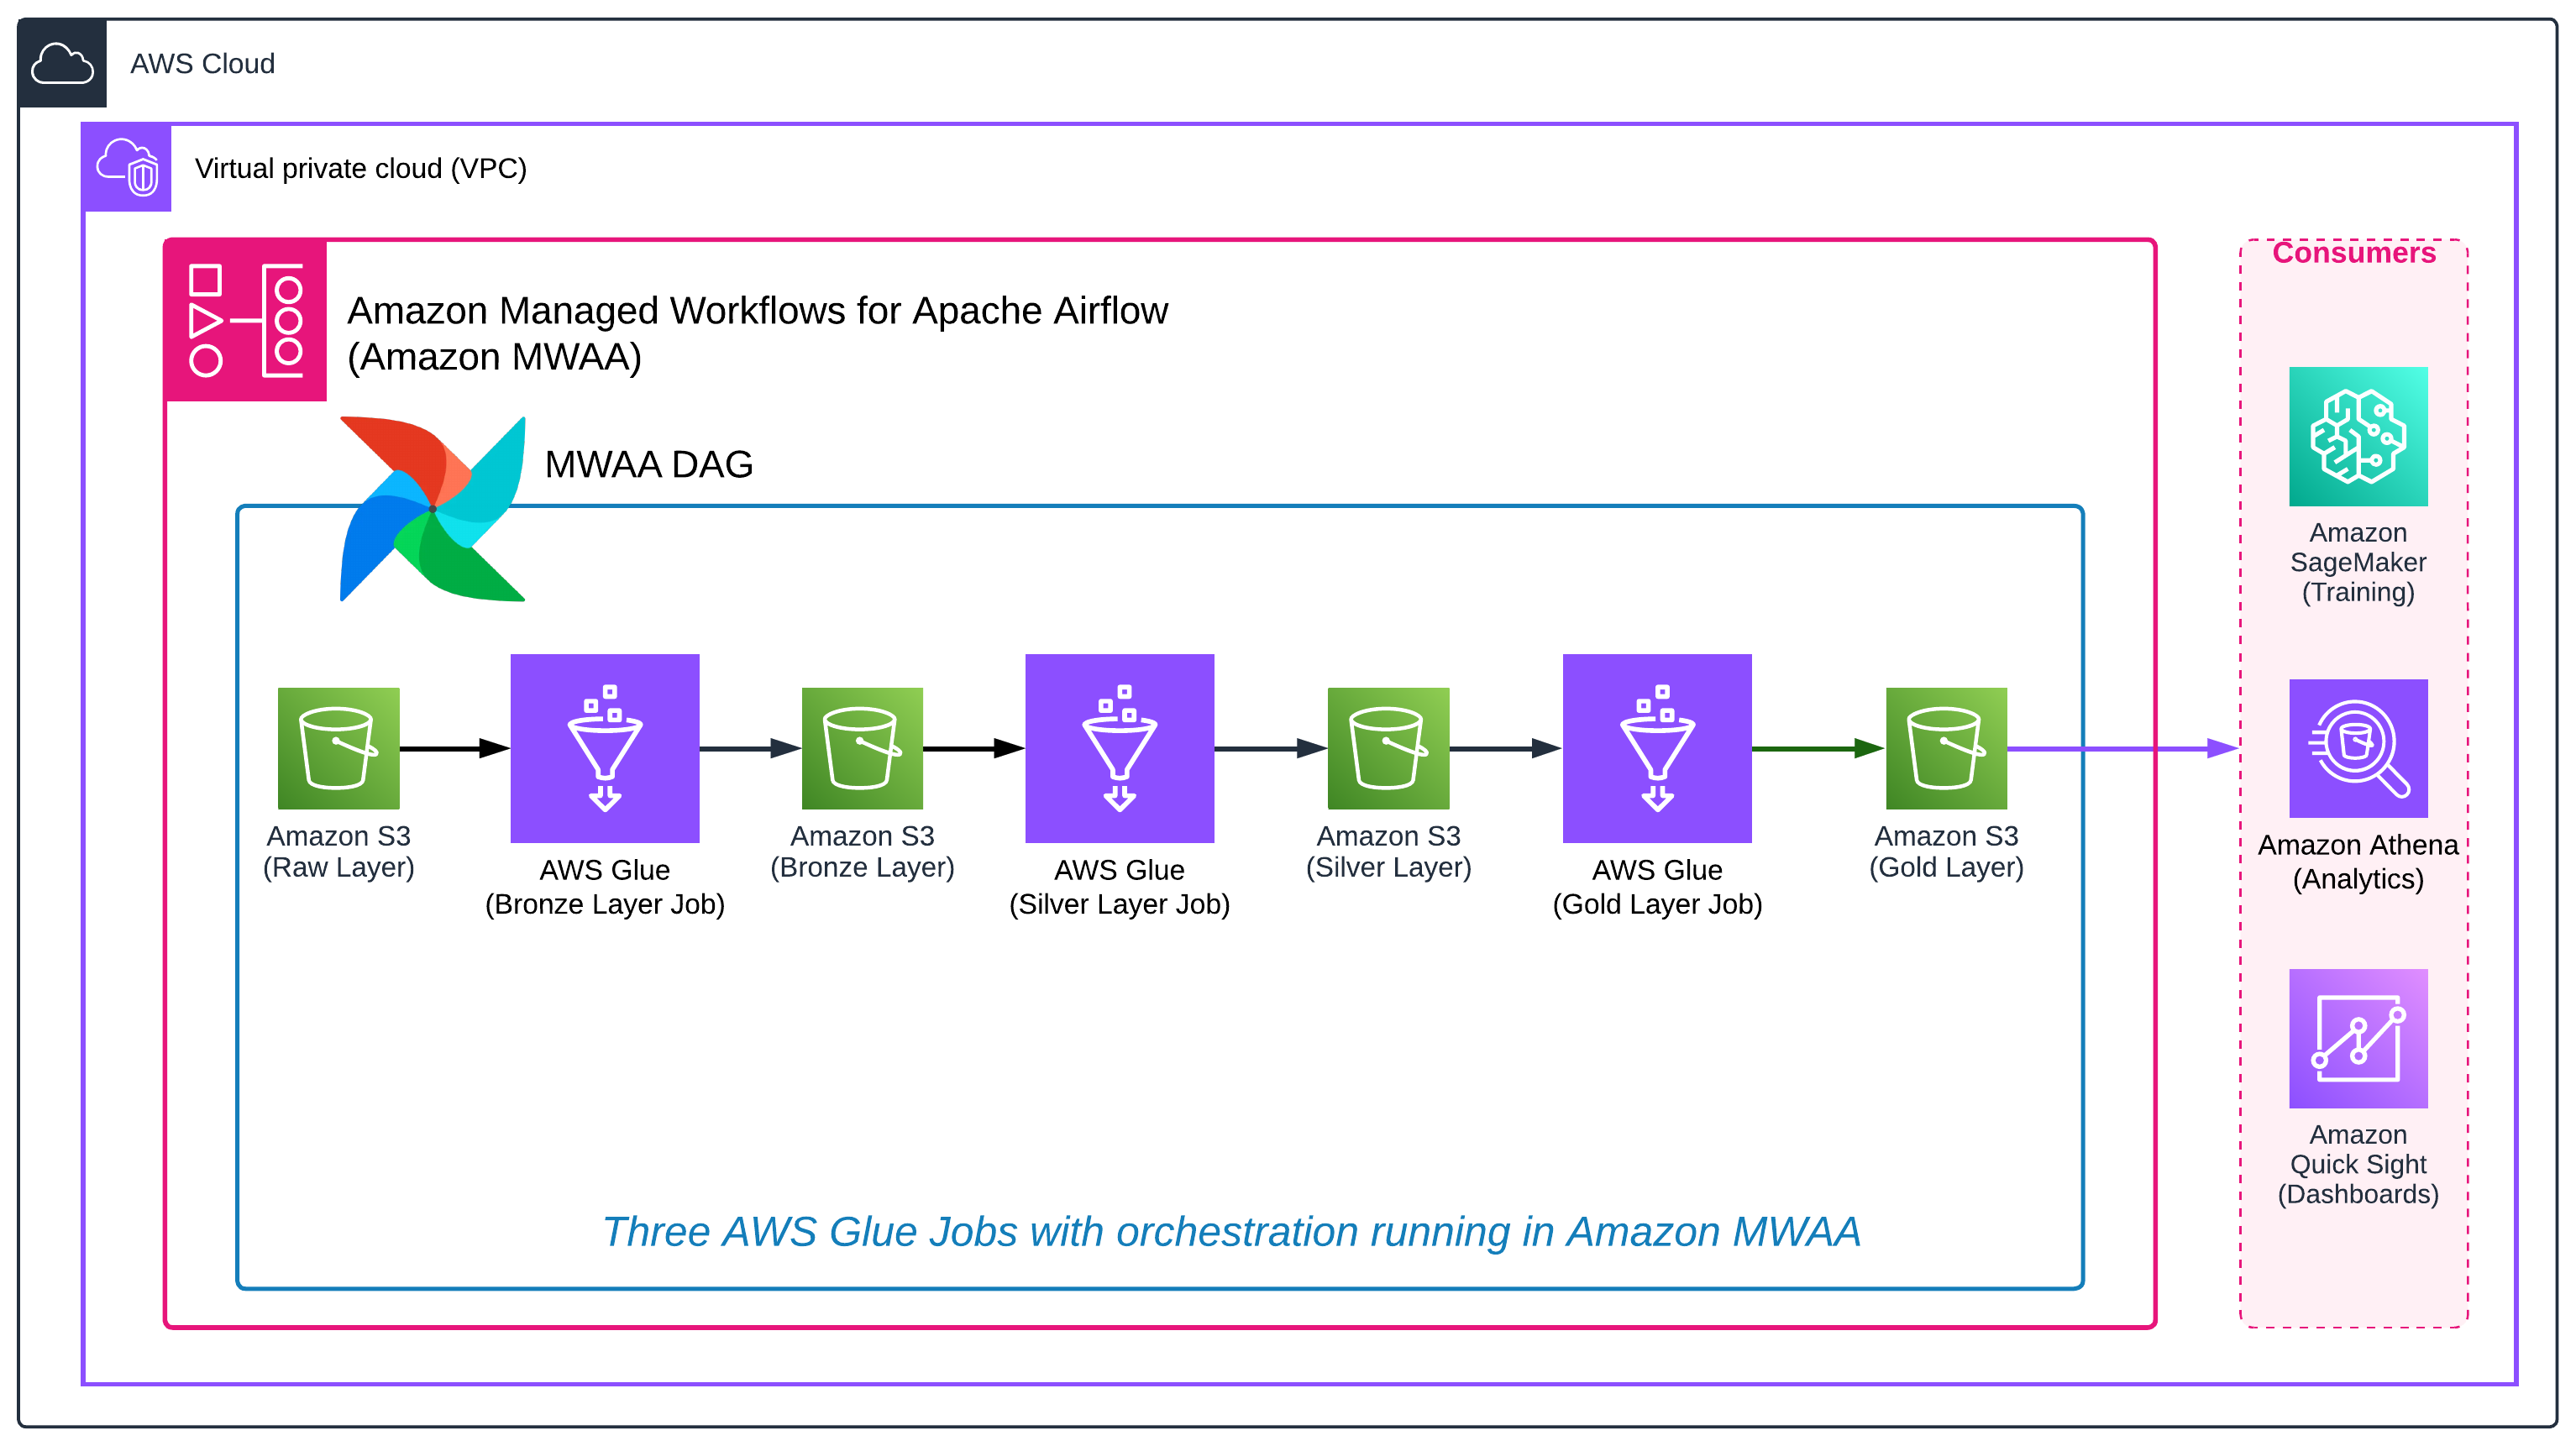
图 1:两层命令式管道,由编排器协调的三个 AWS Glue 作业。
与此相比,声明式方法使用 SDP 作为单个 ETL 作业运行。下图与上一图类似,但这里是一个单一的 AWS Glue ETL 作业,而不是三个作业加一个编排器。
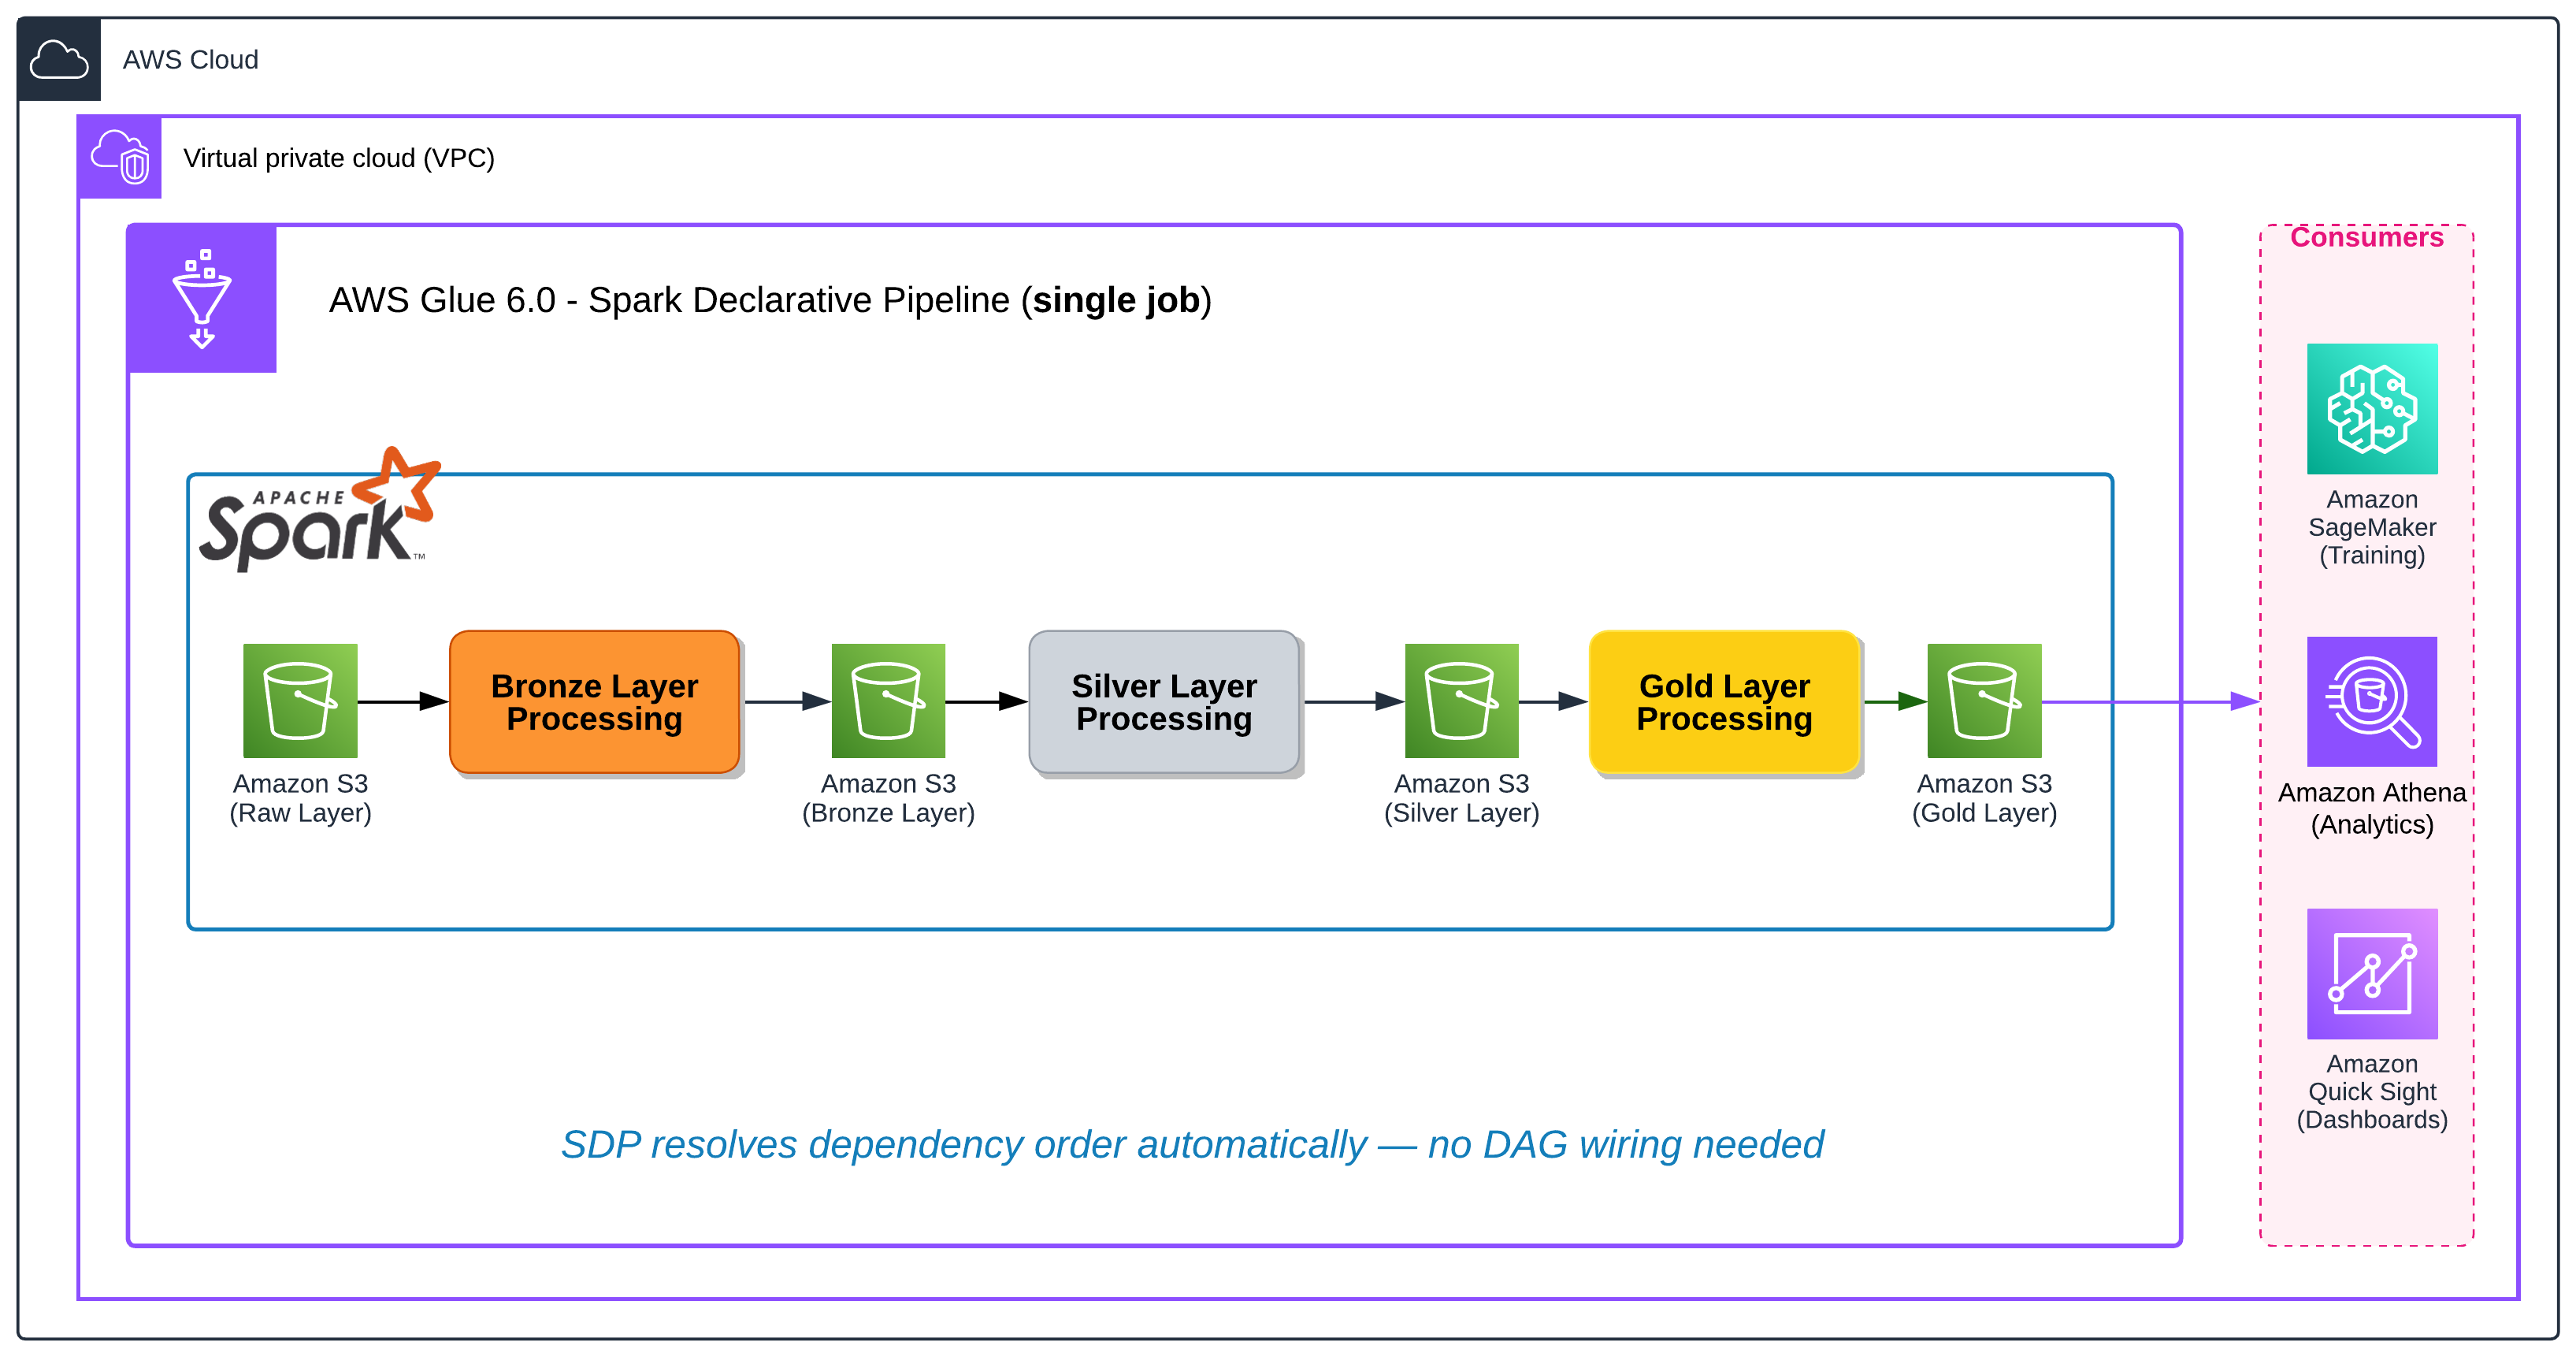
图 2:声明式管道,一个使用 SDP 运行青铜、白银和黄金层的单一 AWS Glue 作业。
声明式方法减少的不仅仅是作业数量。它还消除了围绕作业的样板代码。诸如 Amazon MWAA 或 AWS Step Functions 之类的编排器已经处理重试和并行性,但仅以整个作业为粒度。为了获得更细粒度的控制,团队通常将管道拆分为多个作业,然后手动连接它们之间的依赖关系。使用 SDP,你不再需要手动连接 DAG、管理每阶段检查点或将管道拆分为单独的作业以实现重试和并行性。SDP 从你的表引用中推导出依赖图,并在单个表的级别协调执行。当更广泛的工作流需要时,你仍然可以从编排器调用 SDP 作业,但管道的内部协调不再是你编写和维护的代码。
SDP 将 做什么 与 如何做 分离:你声明 数据集(你想要的输出),SDP 构建产生它们的 流,并将它们作为一个 管道 运行,自动解析依赖关系和执行顺序。
你通过 Python 装饰器声明这些抽象。本文涵盖其中三个,@dp.table、@dp.materialized_view 和 @dp.temporary_view,每个都有其特定用途:
@dp.table定义流式表,在每次运行时增量处理新数据。典型用例是原始事件摄入和变更数据捕获(CDC)数据源。@dp.materialized_view为批处理用例定义物化视图。目前,此数据集类型在每次运行时完全重新计算。常见用途包括解析、聚合和机器学习(ML)特征工程。@dp.temporary_view用于临时计算和聚合。它作用域限于管道,不会持久化到管道之外。用于丰富查找和子查询。
流式表仅追加新到达的数据。物化视图完全重新计算。本文对所有三层都使用 @dp.materialized_view,以使演练保持专注。在生产环境中,你通常会使用 @dp.table 处理青铜层,以便仅处理新到达的文件,而不是每次运行都重新读取完整源数据。
运行和刷新管道
当你重新运行管道时,并不总是希望发生相同的工作。有时你只想在花费计算资源之前确认管道格式正确。其他时候,你希望运行它但仅重新计算已更改的数据集,而不是整个图。SDP 通过两个独立的控件处理这两种情况,将它们分开会有所帮助:
- 执行模式(即
spark.glue.sdp.jobMode键)回答 运行还是仅验证? - 刷新范围(即
spark.glue.sdp.runMode键)回答 既然我在运行,我重新计算什么?
执行模式。 VALIDATE 以 dry-run 模式运行管道:SDP 检查 YAML 语法、依赖解析以及 SQL 和 Python 编译,而不写入任何数据。在投入计算之前,用它来验证你的管道格式是否正确。RUN(默认值)正常执行管道,解析依赖图并物化数据集。
# Dry run: validate the graph, write nothing
aws glue start-job-run \
  --job-name "${JOB_NAME}" \
  --arguments '{"--conf":"spark.glue.sdp.jobMode=VALIDATE"}' \
  --region "${AWS_REGION}"

# Normal execution
aws glue start-job-run \
  --job-name "${JOB_NAME}" \
  --arguments '{"--conf":"spark.glue.sdp.jobMode=RUN"}' \
--region "${AWS_REGION}"刷新范围。默认情况下,RUN会重新计算每个物化视图。你可以通过以下方式缩小或扩大该范围:spark.glue.sdp.runMode:
--refresh <datasets>仅更新指定的数据集(以逗号分隔,不含空格)。--full-refresh <datasets>仅重置并重新计算指定的数据集(对于流式表,这还会清除其检查点)。--full-refresh-all重置并重新计算管道中的每个数据集。
# Selective refresh of named datasets
aws glue start-job-run \
  --job-name "${JOB_NAME}" \
  --arguments '{"--conf":"spark.glue.sdp.jobMode=RUN --conf spark.glue.sdp.runMode=--refresh silver_orders,gold_sales_summary"}' \
  --region "${AWS_REGION}"

# Full reset and recompute of the entire pipeline
aws glue start-job-run \
  --job-name "${JOB_NAME}" \
  --arguments '{"--conf":"spark.glue.sdp.jobMode=RUN --conf spark.glue.sdp.runMode=--full-refresh-all"}' \
--region "${AWS_REGION}"选择性刷新在开发期间很有用,这样你就可以在单个层上进行迭代,而无需重新处理整个图。请注意,--refresh 和 --full-refresh 各自接受一个明确的数据集列表。要重置整个管道,请使用 --full-refresh-all。由于物化视图不保存增量状态,重置物化视图和刷新物化视图都会完全重新计算它。重置与刷新的区别对流式表很重要,因为刷新只处理新数据,而重置会清除检查点并从头重新处理。
多个值作为单个 --conf 参数字符串传入("spark.glue.sdp.jobMode=RUN --conf spark.glue.sdp.runMode=...")。这是 AWS Glue SDP 模式对运行所期望的序列化形式。
物化视图:具有自动依赖解析的批处理转换
物化视图在每次运行时重新计算其完整结果集。SDP 从表引用中推断依赖关系:在此管道中,silver_orders 引用 bronze_orders,因此 SDP 首先运行 bronze,如下图所示。
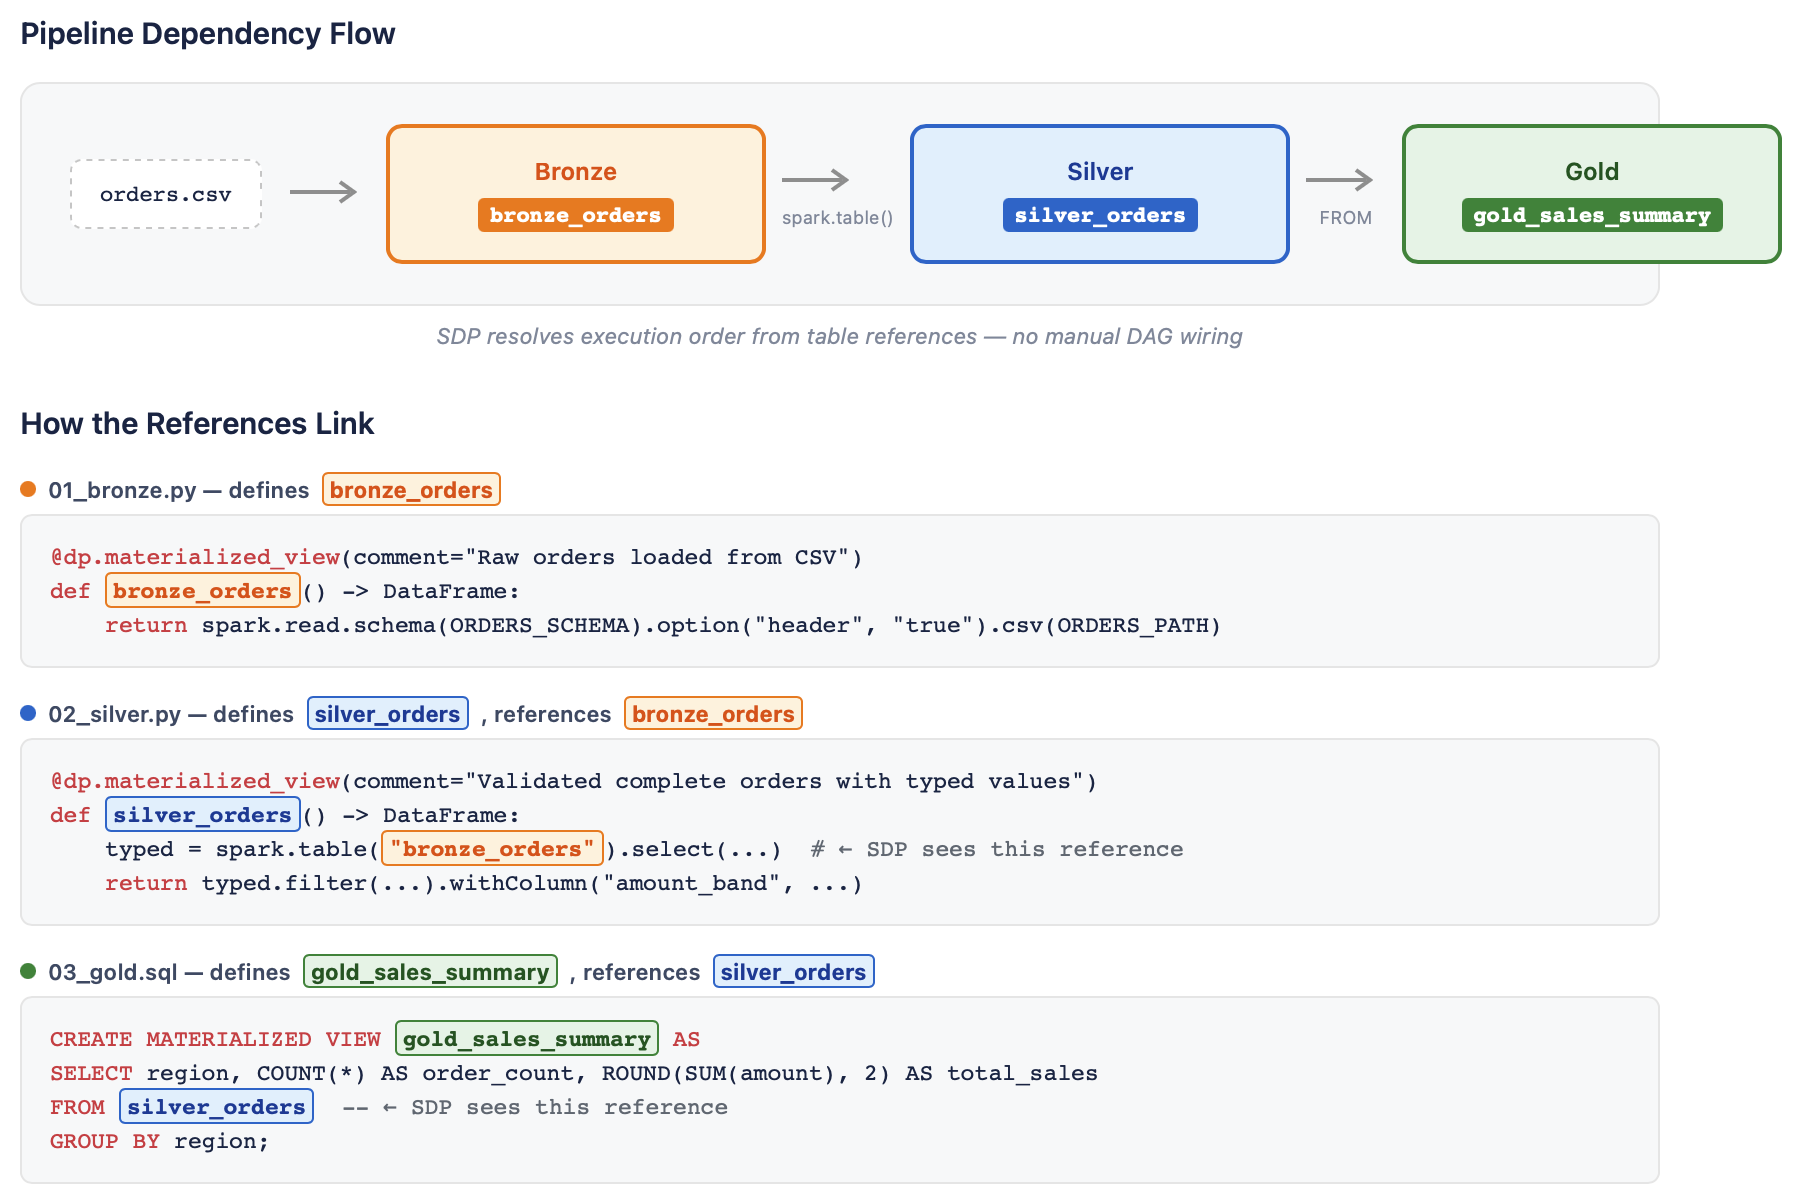
图 3:SDP 从表引用中推断依赖顺序,并在 silver 之前运行 bronze。
核心模式是一个返回 DataFrame 的装饰函数:
@dp.materialized_view(comment="Raw orders loaded from CSV")
def bronze_orders() -> DataFrame:
    return spark.read.schema(ORDERS_SCHEMA).option("header", "true").csv(ORDERS_PATH)
silver 层通过 bronze_orders 引用 spark.table("bronze_orders"),而没有显式声明依赖。SDP 通过分析代码中的表引用来构建 DAG,并自动先运行 bronze。
Bronze 按设计将每一列都读取为字符串:bronze 层保留原始源数据而不进行强制转换。类型转换、验证和过滤在 silver 层中进行。
SQL 与 Python 共存
SDP 在同一管道项目中同时支持 Python 和 SQL 定义。SQL 物化视图可以直接引用 Python 定义的表,例如 gold 层聚合 silver 表:
CREATE MATERIALIZED VIEW gold_sales_summary
COMMENT 'Completed-order metrics by region'
AS
SELECT
  region,
  COUNT(*) AS order_count,
  CAST(ROUND(SUM(amount), 2) AS DECIMAL(10, 2)) AS total_sales,
  CAST(ROUND(AVG(amount), 2) AS DECIMAL(10, 2)) AS average_order_value
FROM silver_orders
GROUP BY region;
在本文中,Python 文件定义摄取和验证逻辑,SQL 文件定义报告视图和聚合。SDP 通过管道规范中的 libraries glob 模式发现两者,并自动解析跨语言依赖。所有三个层的完整源代码将在分步演练中给出。
构建管道:分步指南
本文的其余部分是一个动手演练。你构建一个单一的 AWS Glue 6.0 作业,它读取 orders.csv 并通过 bronze、silver 和 gold 层处理它。步骤如下:
- 先决条件:AWS 账户、AWS Identity and Access Management (IAM) 角色和 S3 存储桶。
- 设置示例数据:创建
orders.csv并将其上传到 Amazon S3。 - 构建管道文件(
spark-pipeline.yml规范加上三个转换文件)。 - 打包管道为 zip 文件并上传到 Amazon S3。
- 创建数据库:带有 S3 位置的 Data Catalog 数据库。
- 配置作业:创建带有 SDP 标志的 AWS Glue 6.0 作业。
- 验证:以 dry-run 模式运行以验证图。
- 运行管道以物化所有数据集。
- 查询结果:使用 Amazon Athena 检查表。
- 清理:删除你创建的资源。
步骤 1 – 先决条件
要跟随操作,你需要:
- 一个有权访问 AWS Glue 6.0 的 AWS 账户。
- 一个由
glue.amazonaws.com信任的专用 IAM 角色(在下一节中设置)。 - 一个启用了 Block Public Access 的私有加密 Amazon S3 存储桶。
- 配置了非生产账户凭据的 AWS CLI。
管道的 IAM 角色
创建一个 AWS Glue 可以代入的角色,使用以下信任策略:
{
  "Version": "2012-10-17",
  "Statement": [{
    "Effect": "Allow",
    "Principal": { "Service": "glue.amazonaws.com" },
    "Action": "sts:AssumeRole"
  }]
}
附加 AWS 托管策略 AWSGlueServiceRole,它授予作业所需的 AWS Glue Data Catalog 和 Amazon CloudWatch Logs 访问权限。然后添加一个内联策略,将 Amazon S3 访问范围限定为你的存储桶,涵盖输入数据、管道 zip、管道存储(状态)路径和仓库位置:
{
  "Version": "2012-10-17",
  "Statement": [{
    "Effect": "Allow",
    "Action": ["s3:GetObject", "s3:PutObject", "s3:DeleteObject", "s3:ListBucket"],
    "Resource": [
      "arn:aws:s3:::amzn-s3-demo-bucket",
      "arn:aws:s3:::amzn-s3-demo-bucket/*"
    ]
  }]
}
有关基线权限的完整细分,请参阅 为 AWS Glue 设置 IAM 权限。
设置演练变量
设置以下变量,将示例值(us-east-1、amzn-s3-demo-bucket、账户 ID 111122223333 和角色名称)替换为你自己的值:
export AWS_REGION="us-east-1"
export BUCKET="amzn-s3-demo-bucket"
export PREFIX="simple-sdp-demo"
export DATABASE="simple_sdp_demo_db"
export ROLE_ARN="arn:aws:iam::111122223333:role/AWSGlueServiceRole-sdp-demo"
export JOB_NAME="simple-sdp-demo"
步骤 2 – 设置示例数据
管道读取一个订单记录 CSV。将以下内容保存为 orders.csv:
order_id,customer_id,region,amount,status,order_ts
O-1001,C-101,EMEA,120.50,COMPLETE,2026-07-23T08:00:00Z
O-1002,C-102,AMER,750.00,COMPLETE,2026-07-23T08:15:00Z
O-1003,C-103,EMEA,-10.00,INVALID,2026-07-23T08:30:00Z
O-1004,C-104,APAC,320.25,COMPLETE,2026-07-23T09:00:00Z
O-1005,C-105,AMER,250.00,COMPLETE,2026-07-23T09:15:00Z
O-1006,C-106,EMEA,90.00,COMPLETE,2026-07-23T09:30:00Z
将文件上传到项目前缀下的 input/ 位置,这是 bronze 层读取它的位置(ORDERS_PATH 在 01_bronze.py 中,如步骤 3 所示)。使用你在步骤 1 中导出的变量:
aws s3 cp orders.csv \
  "s3://${BUCKET}/${PREFIX}/input/orders.csv" \
  --region "${AWS_REGION}"
该文件包含一个无效订单(O-1003,负数金额),silver 层会将其过滤掉以演示验证步骤。AMER 和 EMEA 区域各有两个已完成订单,因此 gold 层的 order_count 和 average_order_value 是有意义的聚合,而不是单行直通。
步骤 3 – 构建管道文件
该管道项目使用前面介绍的结构:一个 transformations/ 文件夹,包含三个层定义(01_bronze.py、02_silver.py、03_gold.sql),加上 spark-pipeline.yml 规范。以下截图显示了代码编辑器中的此布局。
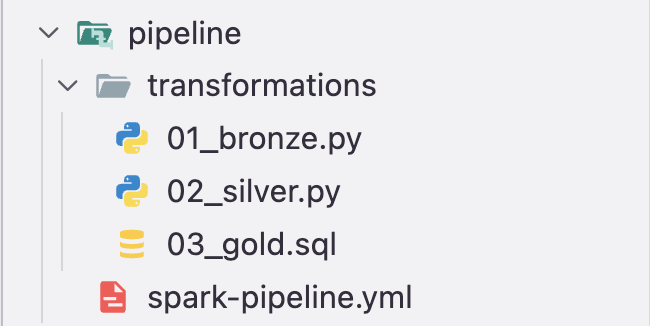
图 4:代码编辑器中的管道项目布局。
每个文件的完整内容如下。
3a. spark-pipeline.yml
该规范为管道命名,指向 Data Catalog 数据库,配置状态存储,并发现转换文件。与转换文件一样,它使用 __DATABASE__、__BUCKET__ 和 __PREFIX__ 令牌,你在第 4 步打包时替换它们:
name: simple_sdp_demo
catalog: spark_catalog
database: __DATABASE__
storage: s3://__BUCKET__/__PREFIX__/state/
libraries:
  - glob:
      include: transformations/**
configuration:
  spark.sql.shuffle.partitions: "4"
3b. transformations/01_bronze.py
Bronze 将原始源保留为字符串。不进行强制转换,不进行过滤:
"""Bronze layer: preserve source order records as strings."""
from pyspark import pipelines as dp
from pyspark.sql import DataFrame, SparkSession
from pyspark.sql.types import StringType, StructField, StructType

spark = SparkSession.active()

ORDERS_PATH = "s3://__BUCKET__/__PREFIX__/input/orders.csv"

ORDERS_SCHEMA = StructType([
    StructField("order_id", StringType(), True),
    StructField("customer_id", StringType(), True),
    StructField("region", StringType(), True),
    StructField("amount", StringType(), True),
    StructField("status", StringType(), True),
    StructField("order_ts", StringType(), True),
])


@dp.materialized_view(comment="Raw orders loaded from CSV")
def bronze_orders() -> DataFrame:
    return (
        spark.read
        .schema(ORDERS_SCHEMA)
        .option("header", "true")
        .csv(ORDERS_PATH)
    )
该路径使用令牌 __BUCKET__ 和 __PREFIX__,而不是硬编码值。AWS Glue 在运行时从打包的 zip 中读取这些文件,因此像 ${BUCKET} 这样的 shell 变量不会在它们内部展开。你在第 4 步打包项目时用真实值替换这些令牌,从而使每个文件与你在第 1 步导出的变量保持一致。
3c. transformations/02_silver.py
Silver 转换类型,筛选出金额为正的已完成订单,并派生出一个 amount_band 分类:
"""Silver layer: type, validate, and classify complete orders."""
from pyspark import pipelines as dp
from pyspark.sql import DataFrame, SparkSession
from pyspark.sql.functions import col, to_timestamp, trim, when

spark = SparkSession.active()


@dp.materialized_view(comment="Validated complete orders with typed values")
def silver_orders() -> DataFrame:
    typed = (
        spark.table("bronze_orders")
        .select(
            trim(col("order_id")).alias("order_id"),
            trim(col("customer_id")).alias("customer_id"),
            trim(col("region")).alias("region"),
            col("amount").cast("double").alias("amount"),
            trim(col("status")).alias("status"),
            to_timestamp("order_ts", "yyyy-MM-dd'T'HH:mm:ss'Z'").alias("order_ts"),
        )
        .filter(
            col("order_id").isNotNull()
            & col("region").isNotNull()
            & col("order_ts").isNotNull()
            & (col("status") == "COMPLETE")
            & (col("amount") > 0)
        )
    )
    return typed.select(
        "*",
        when(col("amount") >= 500, "large")
        .when(col("amount") >= 100, "medium")
        .otherwise("small")
        .alias("amount_band"),
    )
Silver 使用 spark.table("bronze_orders") 读取 bronze,因此 SDP 推断出依赖关系并首先运行 bronze。这里有两个细节很重要:
- 该
to_timestamp调用传递了显式格式"yyyy-MM-dd'T'HH:mm:ss'Z'"。源时间戳是带有Z后缀的 ISO 8601 格式。给出格式会将Z视为字面量,并产生相同的挂钟时间值,无论作业的会话时区如何,从而保持结果确定性。 - 该转换分两个投影运行:第一个进行强制转换和过滤,第二个从已转换为类型的
amount_band派生amount列。使用.select(...)而不是单独的.withColumn(...)步骤派生列,可使 SDP 对bronze_orders的引用作为管道依赖项保持可解析。这样,SDP 会一致地将 bronze 层排在 silver 层之前。顺序在这里也很重要。Spark 4.1 默认启用 ANSI 模式,因此将原始字符串amount与数字比较会失败。amount_band因此读取已转换为类型的amount。
3d. transformations/03_gold.sql
gold 层使用 SQL 按区域聚合订单指标:
CREATE MATERIALIZED VIEW gold_sales_summary
COMMENT 'Completed-order metrics by region'
AS
SELECT
  region,
  COUNT(*) AS order_count,
  CAST(ROUND(SUM(amount), 2) AS DECIMAL(10, 2)) AS total_sales,
  CAST(ROUND(AVG(amount), 2) AS DECIMAL(10, 2)) AS average_order_value
FROM silver_orders
GROUP BY region;
第 4 步 – 打包项目
将 __BUCKET__、__PREFIX__ 和 __DATABASE__ 令牌替换为你在第 1 步导出的值。然后将 spark-pipeline.yml 和 transformations/ 文件夹打包成一个 zip,两者都位于 zip 根目录。由于 AWS Glue 在运行时从 zip 中读取这些文件,替换必须现在进行,即在打包时,而不是在运行时通过 shell 变量进行:
# Render the tokens into a build/ copy, leaving your source files untouched
rm -rf build/package && mkdir -p build/package/transformations

sed -e "s|__BUCKET__|${BUCKET}|g" \
    -e "s|__PREFIX__|${PREFIX}|g" \
    -e "s|__DATABASE__|${DATABASE}|g" \
    spark-pipeline.yml > build/package/spark-pipeline.yml

sed -e "s|__BUCKET__|${BUCKET}|g" \
    -e "s|__PREFIX__|${PREFIX}|g" \
    transformations/01_bronze.py > build/package/transformations/01_bronze.py
cp transformations/02_silver.py transformations/03_gold.sql build/package/transformations/

# Zip with the spec and transformations at the zip root
(cd build/package && zip -r -q ../simple-sdp-demo.zip spark-pipeline.yml transformations)

# Upload
aws s3 cp build/simple-sdp-demo.zip "s3://${BUCKET}/${PREFIX}/pipeline/simple-sdp-demo.zip" --region "${AWS_REGION}"
只有 spark-pipeline.yml 和 01_bronze.py 带有令牌,因此其他文件按原样复制。上传的对象命名为 simple-sdp-demo.zip,这与第 6 步中作业引用的名称相同。
第 5 步 – 创建数据库
在 spark-pipeline.yml 中命名的数据库必须已在 AWS Glue Data Catalog 中存在,并具有 S3 位置 URI,然后管道才能运行。SDP 不会自动创建它:
aws glue get-database --name "${DATABASE}" --region "${AWS_REGION}" >/dev/null 2>&1 \
|| aws glue create-database \
--database-input "{\"Name\":\"${DATABASE}\",\"LocationUri\":\"s3://${BUCKET}/${PREFIX}/warehouse/\"}" \
--region "${AWS_REGION}"
第 6 步 – 配置作业
创建一个 AWS Glue 6.0 作业,将 zip 作为 ScriptLocation 并启用 SDP 标志:
aws glue create-job \
--name "${JOB_NAME}" \
--role "${ROLE_ARN}" \
--command "{\"Name\":\"glueetl\",\"ScriptLocation\":\"s3://${BUCKET}/${PREFIX}/pipeline/simple-sdp-demo.zip\",\"PythonVersion\":\"3\"}" \
--glue-version "6.0" \
--worker-type "G.1X" \
--number-of-workers 2 \
--default-arguments "{\"--enable-spark-declarative-pipeline\":\"true\",\"--enable-glue-datacatalog\":\"true\"}" \
--region "${AWS_REGION}"
关键参数:
| 参数 | 用途 |
--enable-spark-declarative-pipeline | 激活 SDP 执行器(必需) |
--enable-glue-datacatalog | 使用 AWS Glue Data Catalog 作为 Spark Hive 元存储,以便管道的输出表注册到目录中 |
ScriptLocation | 指向管道 zip,而不是 .py 文件 |
表 2:create-job 命令的关键参数。
该 create-job 命令将 ScriptLocation 设置为管道 zip。你也可以将其指向一个 Amazon S3 前缀:将解压后的 spark-pipeline.yml 和 transformations/ 上传到一个前缀,并将 ScriptLocation 设置为该前缀(带尾部 /)。无需其他更改,且 --enable-spark-declarative-pipeline 标志保持不变。zip 将上传保持为单个对象。
第 7 步 – 验证(试运行)
首先以验证模式运行作业,以在不物化数据的情况下验证依赖图:
aws glue start-job-run \
  --job-name "${JOB_NAME}" \
  --arguments '{"--conf":"spark.glue.sdp.jobMode=VALIDATE"}' \
  --region "${AWS_REGION}"
验证会分析项目结构、依赖图以及 SQL 和 Python 编译,而不创建表、执行转换或写入数据。确认验证完成后数据库中没有任何表。
在 AWS Glue 上,验证作为作业运行(jobMode=VALIDATE),因此你在第 6 步创建作业,然后在此处验证它。如果你使用开源 spark-pipelines CLI 在本地开发,你可以在打包和上传之前对其运行 dry-run。
第 8 步 – 运行管道
以正常执行模式启动管道:
aws glue start-job-run \
  --job-name "${JOB_NAME}" \
  --arguments '{"--conf":"spark.glue.sdp.jobMode=RUN"}' \
  --region "${AWS_REGION}"
运行完成后,列出物化的表:
aws glue get-tables \
  --database-name "${DATABASE}" \
  --region "${AWS_REGION}" \
  --query 'TableList[].Name' \
--output table预期表:bronze_orders、silver_orders、gold_sales_summary。
运行后,AWS Glue 控制台会在 simple_sdp_demo_db 数据库中显示这三个输出表。该数据库的 Location 是你配置的仓库路径 s3://amzn-s3-demo-bucket/simple-sdp-demo/warehouse/,每个表都将其数据存储在该前缀下。以下截图显示了数据库属性以及这三个表(bronze_orders、silver_orders 和 gold_sales_summary),每个都注册在 AWS Glue Data Catalog 中。
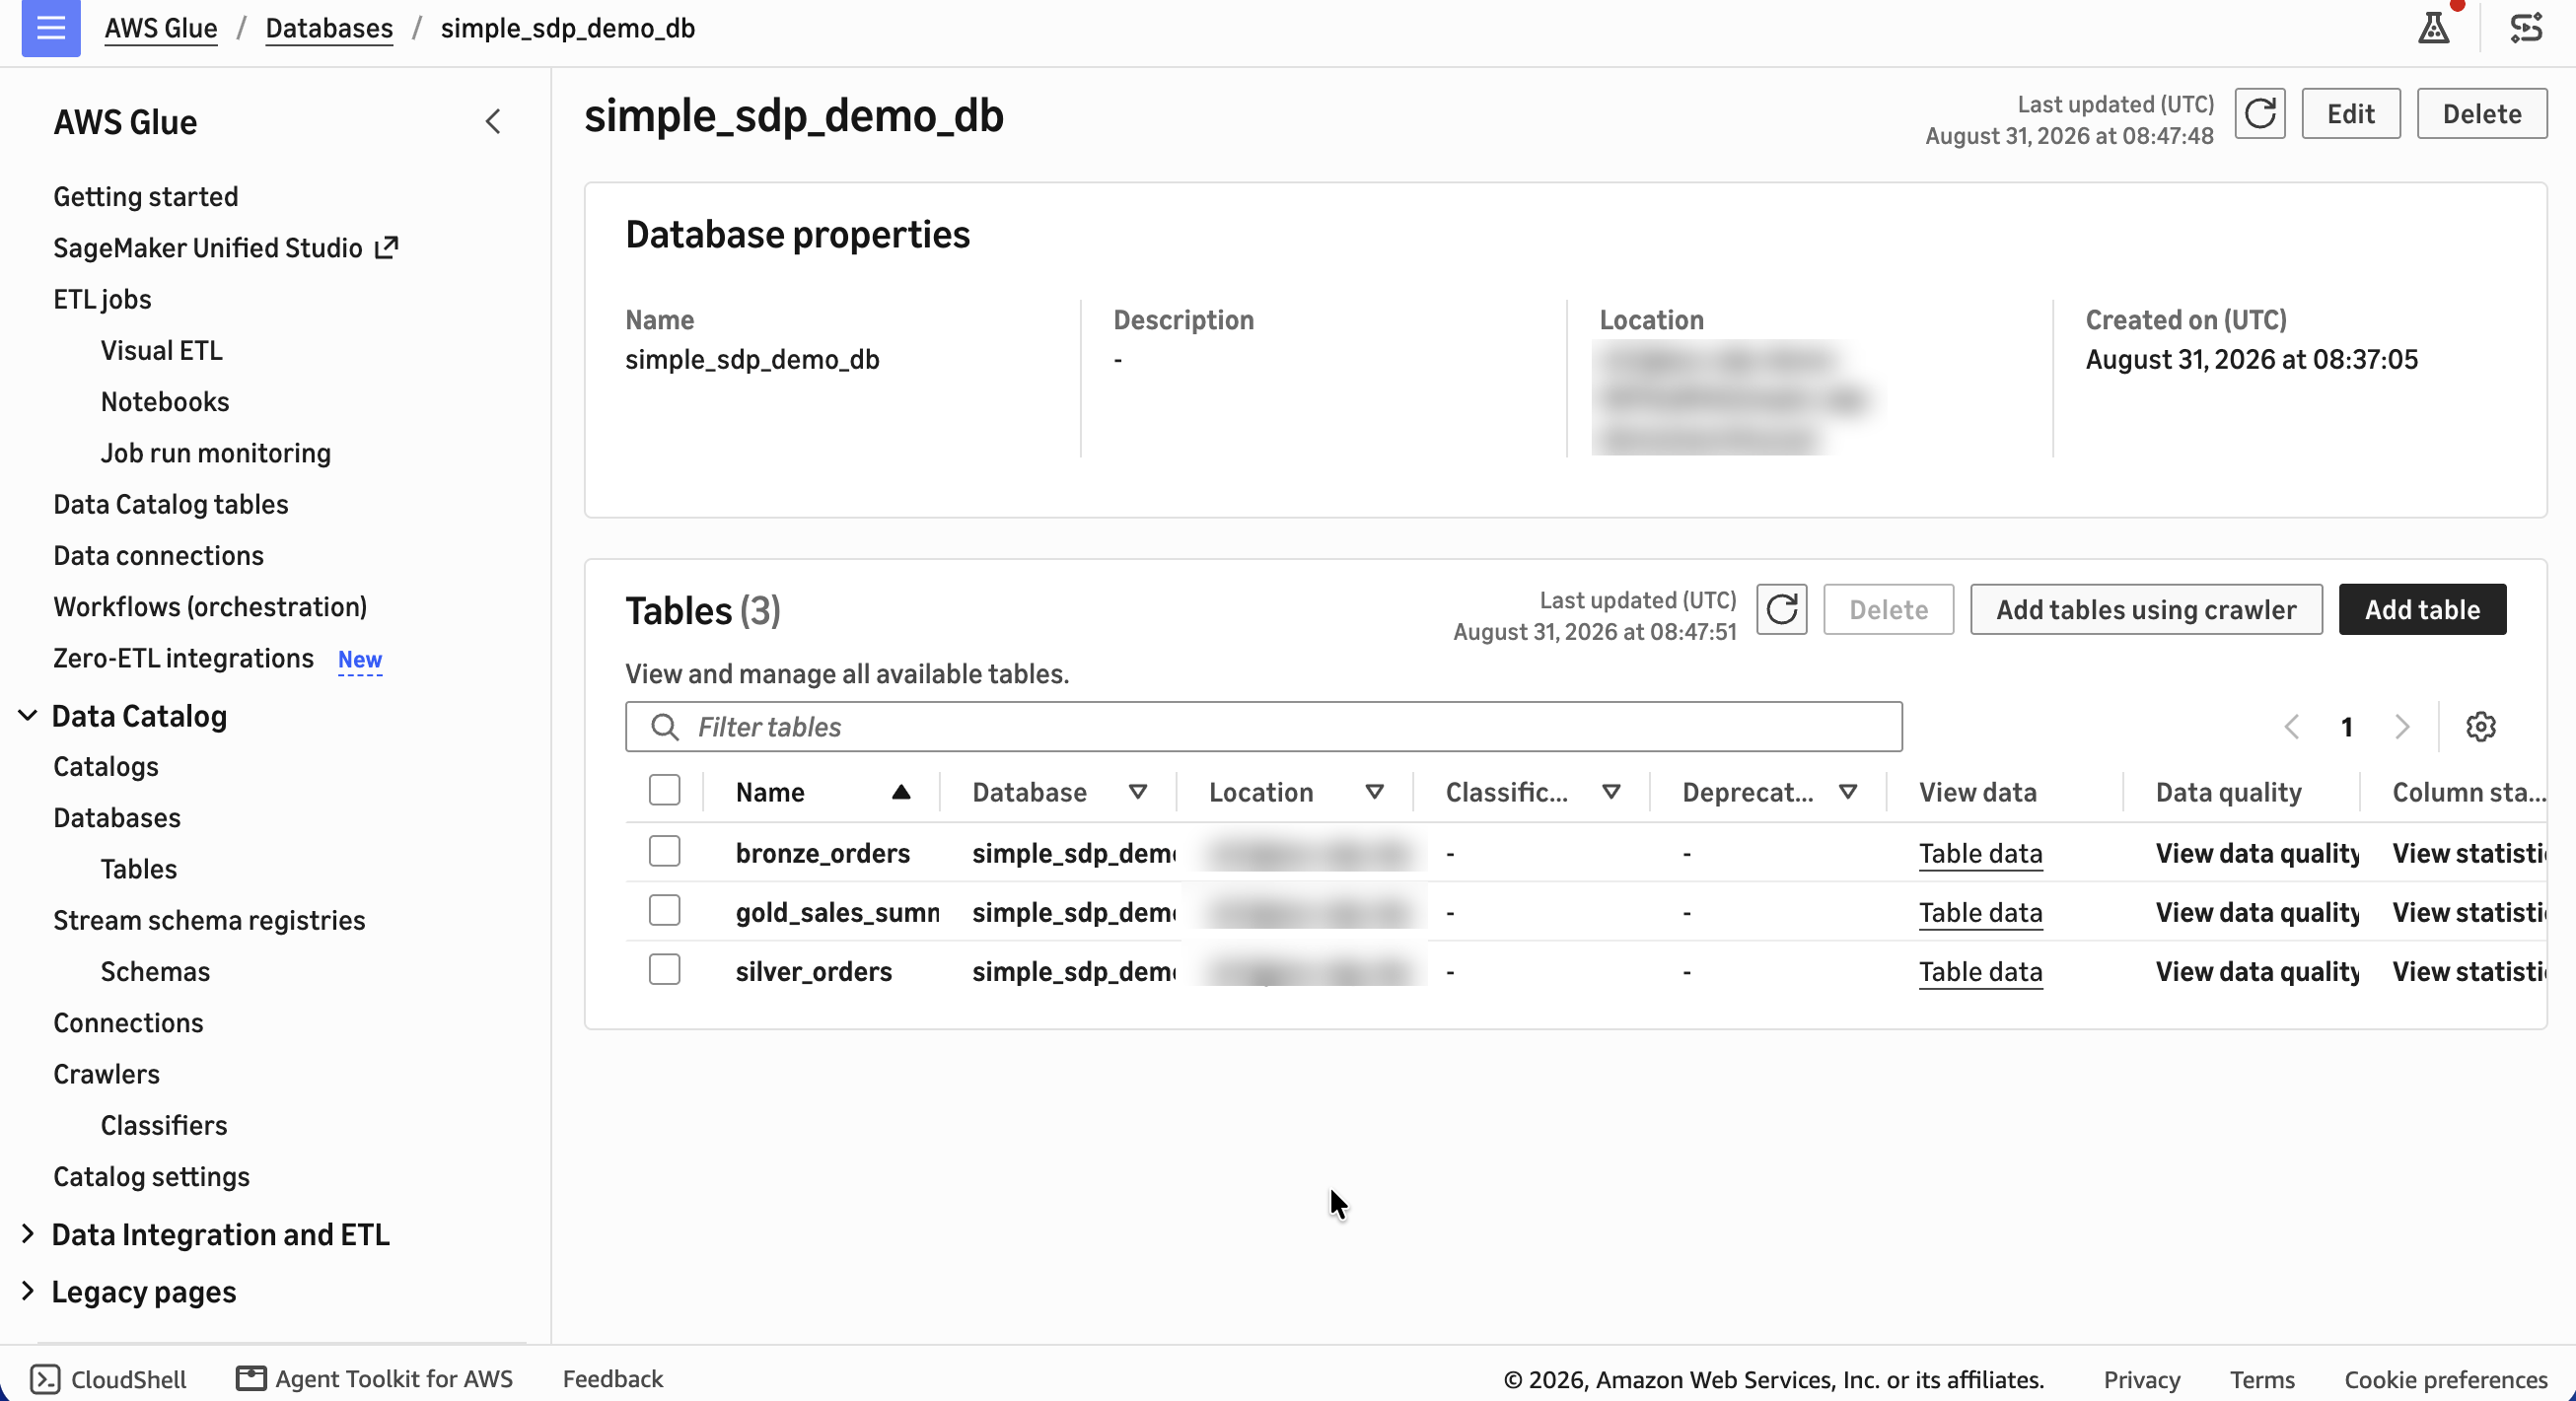
图 5:AWS Glue Data Catalog 中的三个输出表。
第 9 步 – 查询结果
使用 Amazon Athena 查询这些表。如果这是你首次在此区域使用 Athena,请先为你的工作组设置一个 Amazon S3 查询结果位置(Athena 控制台,Settings)。还要确保你的身份可以读取 Data Catalog 中的 simple_sdp_demo_db 表以及底层 S3 数据。
-- Bronze preserves all 6 source rows
SELECT * FROM simple_sdp_demo_db.bronze_orders ORDER BY order_id;

-- Silver retains the 5 complete orders with positive amounts
SELECT * FROM simple_sdp_demo_db.silver_orders ORDER BY order_id;

-- Gold aggregates by region
SELECT * FROM simple_sdp_demo_db.gold_sales_summary ORDER BY region;
预期 gold 结果:
| region | order_count | total_sales | average_order_value |
| AMER | 2 | 1000.00 | 500.00 |
| APAC | 1 | 320.25 | 320.25 |
| EMEA | 2 | 210.50 | 105.25 |
表 3:按区域划分的 gold 层聚合结果。
在 Amazon Athena 控制台中运行该查询会返回聚合结果。以下截图显示了 gold 查询及其三行结果(AMER、APAC 和 EMEA),与上表中的值一致。
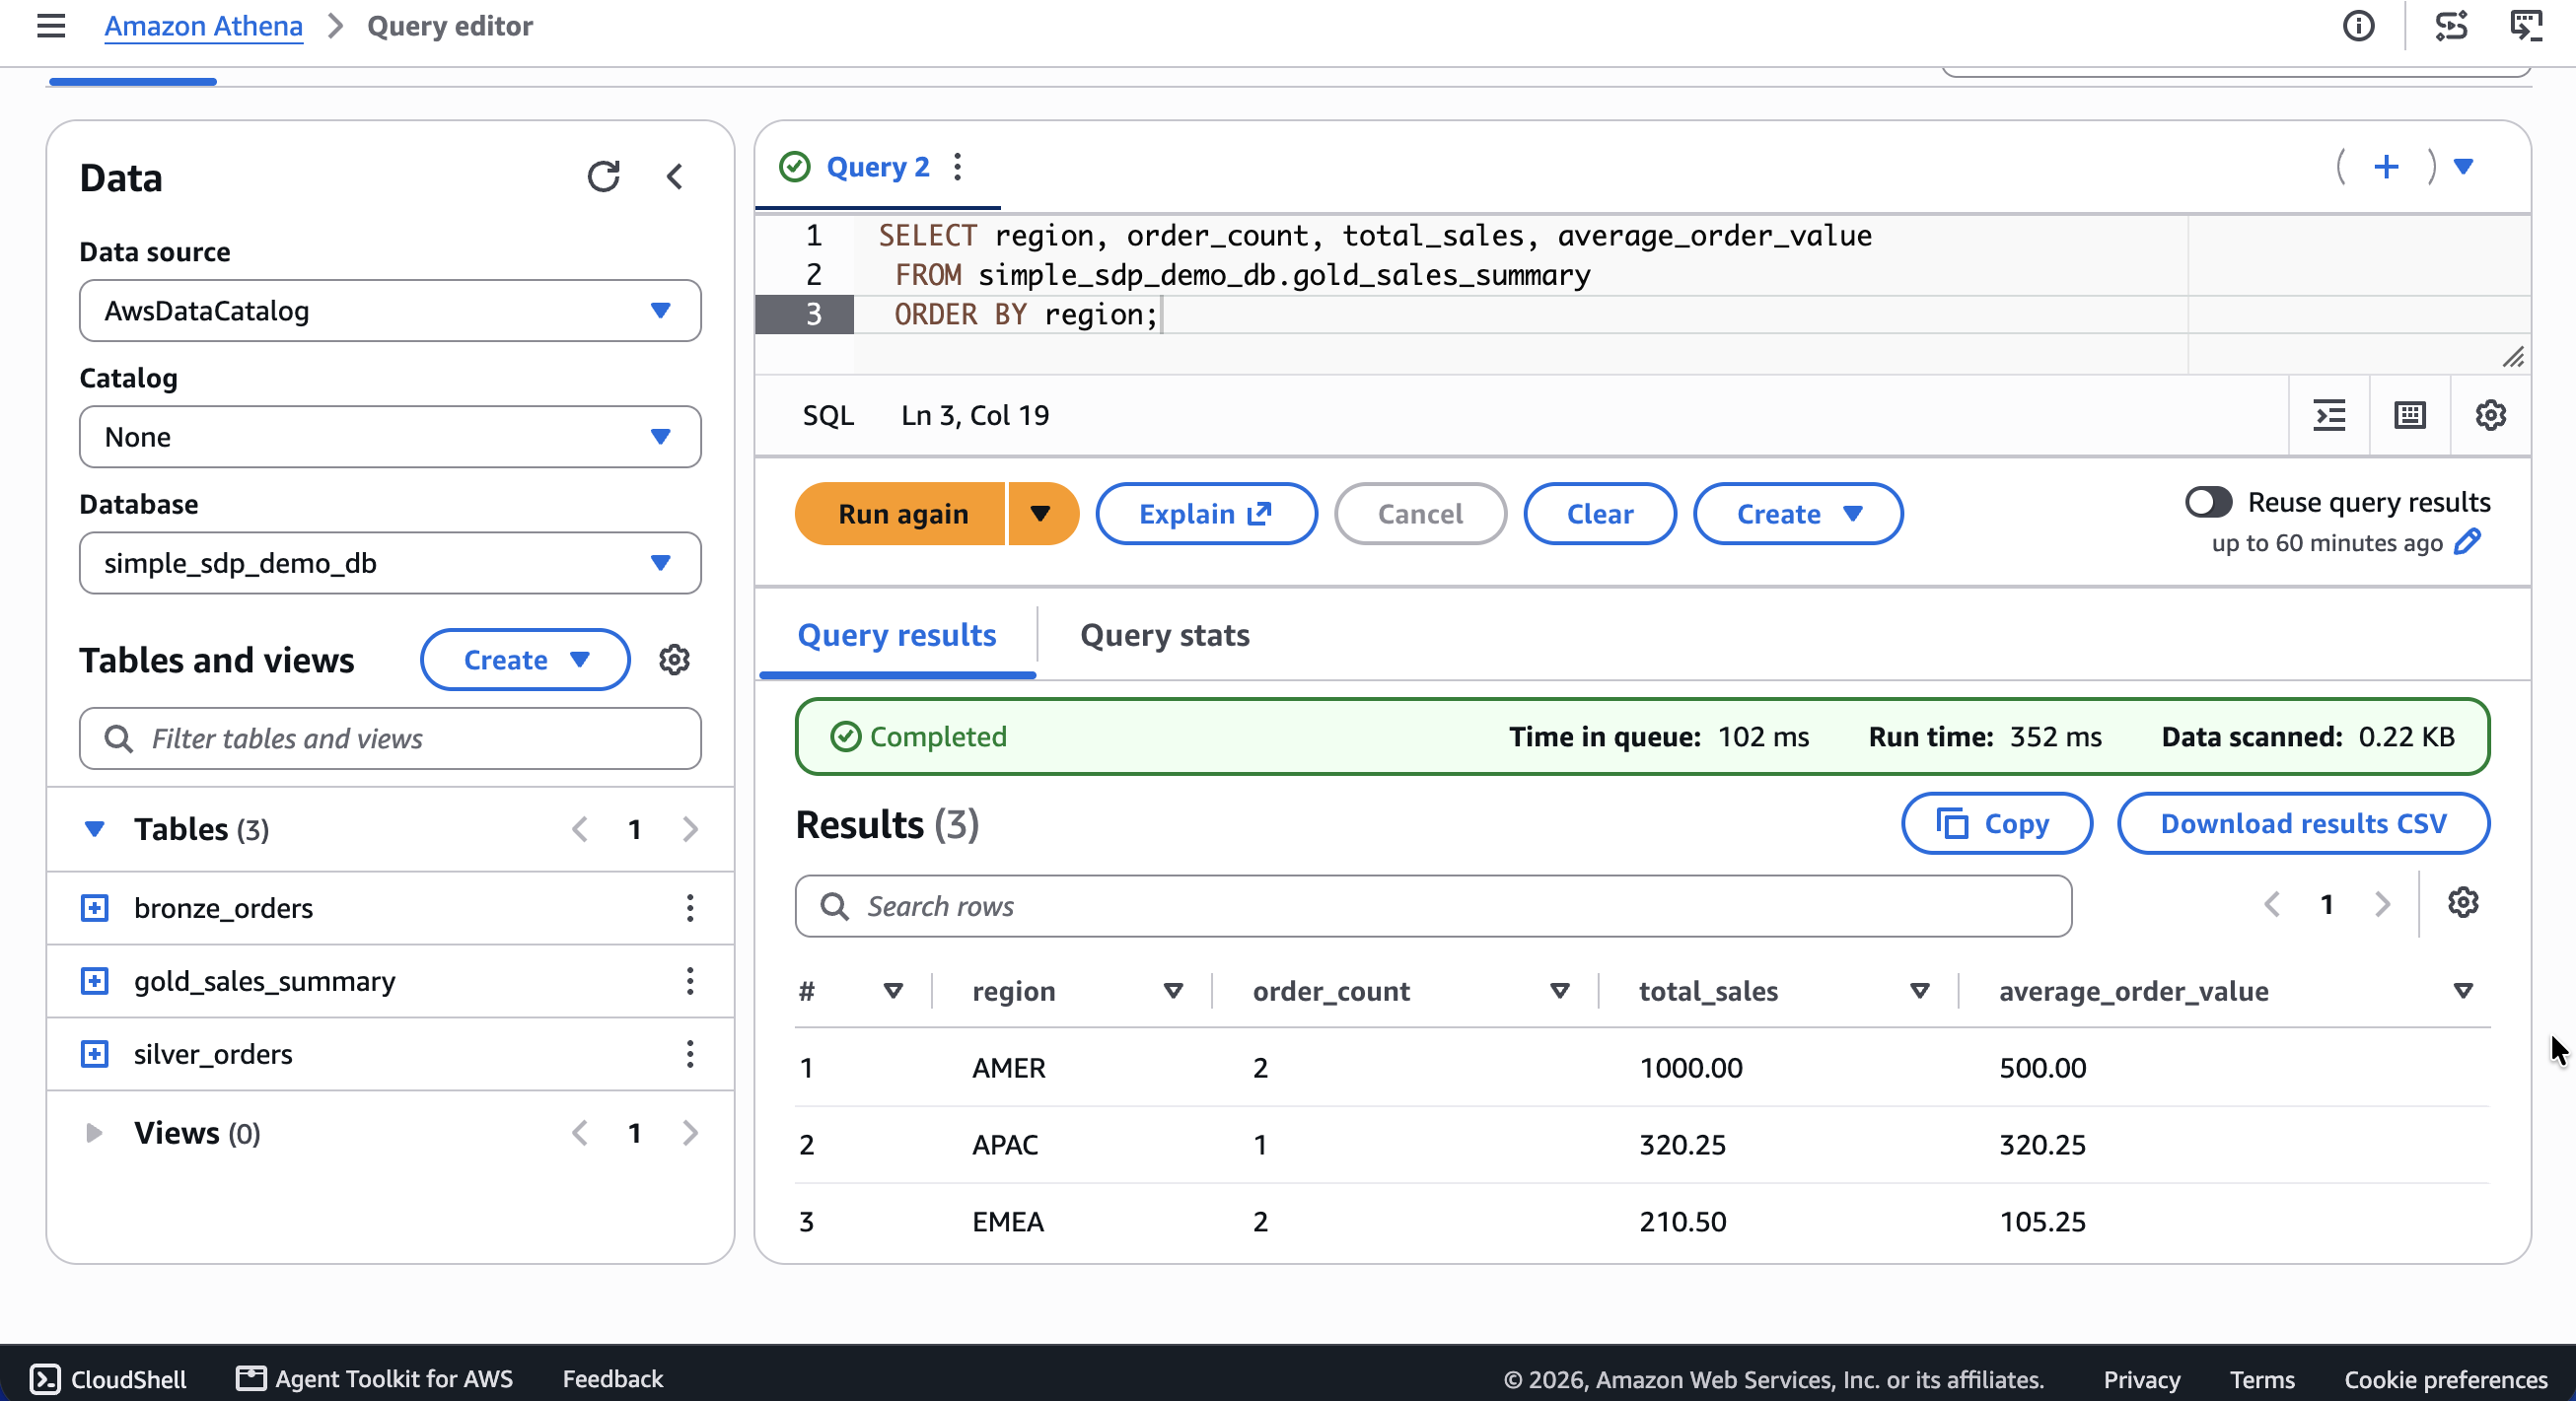
图 6:Amazon Athena 控制台中的 gold 表结果。
成本考虑
AWS Glue 6.0 按数据处理单元(DPU)-小时对 ETL 作业计费,按秒计费,每次运行最低 1 分钟。AWS Glue 6.0 的每 DPU-小时价格也比 AWS Glue 5.1 低 30%,而你的工作负载无需任何更改,因此同一作业在 6.0 上运行成本更低。本演练在 2 个 G.1X 工作节点(2 个 DPU)上运行,读取一个 6 行 CSV,每次运行约 2 分钟完成。它在一个 AWS Glue Data Catalog 数据库中生成三个表。
要估算一次运行的成本,请将 2 个 DPU 乘以运行小时数,再乘以你所在区域的 AWS Glue 6.0 DPU-小时费率。你可以在 AWS Glue 定价页面 上找到该费率,且费率因 AWS 区域而异。创建的 Amazon S3 对象包括 6 行 CSV、管道 zip 文件以及三个表的数据。要停止产生进一步费用,请在完成后删除资源,如下一步所示。
步骤 10 – 清理
为避免持续产生费用,请删除你创建的资源:
# Delete the AWS Glue job
aws glue delete-job --job-name "${JOB_NAME}" --region "${AWS_REGION}"

# Delete the Data Catalog database and its table metadata
aws glue delete-database --name "${DATABASE}" --region "${AWS_REGION}"

# Remove the S3 objects
aws s3 rm "s3://${BUCKET}/${PREFIX}/" --recursive --region "${AWS_REGION}"
后续步骤
你现在拥有一个单一管道,可将原始订单记录转换为经过验证的聚合分析表,而无需编写编排逻辑。从这里你可以:
- 扩展:添加转换阶段(额外的
@dp.materialized_view函数),并通过引用上游表将它们连接起来。管道会自动识别新的依赖关系。 - 扩展规模:本演练全程使用物化视图,因此每一层在每次运行时都会完全重新计算(物化视图不支持增量刷新)。若要仅处理到达的新数据,请将 bronze 层转换为流式表,流式表通过检查点跨运行维护状态。要使这种跨运行状态持久化,流式表的数据和检查点状态不得存储在本地。Hive 或 AWS Glue 托管表要求数据库的
LocationUri指向 Amazon S3 路径,而 Apache Iceberg 表则自行管理其表元数据。 - 治理:使用 AWS Lake Formation 细粒度访问控制 保护 SDP 生成的 Data Catalog 表。它在 AWS Glue Spark 作业(Glue 5.0 及更高版本,适用于 Hive 和 Iceberg 表)中对读取查询强制执行表级、行级、列级和单元格级权限。由于此强制执行涵盖批量读取,因此它适用于 SDP 的物化视图,但不适用于通过 Spark Structured Streaming 读取的流式表。
- 自动化:将管道项目存储在源代码管理中。让你的持续集成和持续交付(CI/CD)管道将其打包并上传到 Amazon S3,以便每次作业运行都对应一个已知构建。按对象键对 zip 文件进行版本控制,或将解压后的项目上传到 S3 前缀并开启 Amazon S3 存储桶版本控制。
- 监控:使用 Amazon CloudWatch 指标和 AWS Glue 作业运行洞察进行管道可观测性、延迟跟踪和故障告警。
结论
在本文中,你使用了 Spark 声明式管道,这是显式编排 ETL 的声明式替代方案,现已在 AWS Glue 6.0 中提供。两个带装饰器的 Python 函数和一个 SQL 文件定义了 bronze、silver 和 gold 数据集,SDP 会为你解析依赖关系并管理执行顺序。
使用 SDP,你声明每个数据集应包含什么,声明式框架负责处理顺序和执行。一个原本需要单独转换和编排逻辑的三层管道,现在作为一个作业运行,你可以发布和维护它。
要开始使用,请打开 AWS Glue 控制台 并构建演练管道,或将该模式适配到你自己的 bronze、silver 和 gold 数据集。有关完整功能集,请参阅 AWS Glue 6.0 发布公告。要将现有作业迁移到 Spark 4.1 运行时,请参阅 使用 AI 驱动的 Spark 升级将 AWS Glue 作业升级到 AWS Glue 6.0。有关作业配置详情,请参阅 AWS Glue 开发人员指南。
补充来源
1 个信源 · 2 篇报道这篇内容对你有用吗?
反馈只用于改善内容筛选,不等同于收藏